 AIREITER
Le format de prompt MiniMax H3 n’est pas un simple habillage : la fiche modèle le décrit comme « critical to the quality of the final output ». Pourtant, un fil Reddit consacré au prompting H3 et crédité de 220 votes positifs ressemble surtout à un rapport de bugs sur les dialogues incompréhensibles. Ce test confronte le format officiel aux essais de créateurs et aux retours d’échec cités : la gestion de la caméra et des références s’avère plus fiable que le dialogue ou l’audio, et les meilleurs résultats passent parfois par un écart volontaire à la syntaxe prescrite.
Le format de prompt MiniMax H3, concrètement
Un prompt MiniMax H3 officiel prend la forme d’un document structuré en trois champs — integrated_multimodal_description, overall_soundscape et non_diegetic_music — qui combine plans horodatés, identifiants persistants pour les intervenants et balises de dialogue <d>. Cette structure existe parce que H3 attend une représentation intermédiaire structurée, normalement générée par un préprocesseur hébergé, H3-Context-IR. MiniMax ne l’a pas inclus dans la version open weights : via l’API hébergée, les demandes libres sont reformulées automatiquement ; avec les poids ouverts 33B en local (SGLang, vLLM, Diffusers, ComfyUI), il faut rédiger soi-même cette structure.
MiniMax fournit aussi une compétence portable, h3-prompt-writing, dans le repo GitHub officiel. Elle se compose de deux fichiers de guide, base-en.txt et ref-en.txt, lisibles par n’importe quel agent de code sans appel d’API externe. Des créateurs l’exécutent dans Claude ou Cursor afin de transformer un brief en langage naturel en prompt complet ; @AI__TSUBAKI documente précisément ce flux de travail pour des clips cinématographiques.
Les limites techniques qui cadrent vos prompts
| Contrainte | Valeur | Conséquence pour le prompt |
|---|---|---|
| Durée du clip | 4 à 15 secondes, 24 FPS | Les horodatages doivent progresser strictement et rester dans la durée du clip |
| Audio | Stéréo 32 kHz, généré conjointement | Les champs d’ambiance et de musique sont obligatoires ; N/A est accepté |
| Résolution | 768p par défaut ; 2K via H3-Regenerate-2K (API uniquement) | Testez en 768p et ne payez la 2K qu’une fois le prompt validé |
| Types de tâche | T2VA (texte), I2VA (première image à 0.00 s), FL2VA (première + dernière image), L2VA (dernière image), Ref2VA (référence omni) | Chaque type possède sa propre phrase d’alignement |
| Limites des références | 9 images + 3 clips vidéo + 3 clips audio, 12 fichiers au total, ≤15 s au total par type de média | Davantage de références implique davantage de routage, pas forcément un meilleur résultat |
| Taille du prompt | Les exemples officiels font 300 à 700 mots ; le text-to-video pur est plafonné à ~7 000 caractères | Les prompts courts sans référence constituent un mode d’échec signalé dans le manuel officiel |
Un prompt minimal mais complet — trois champs, une instruction caméra, un locuteur visible avec dialogue entre guillemets et aucune musique — tient en dix lignes :
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
La syntaxe complète, champ par champ — balises, phrases d’alignement et modèles inclus — figure dans notre guide des prompts MiniMax H3. Ici, la question est plutôt de savoir si cette syntaxe mérite réellement l’effort demandé.
Les trois promesses du format, passées au crible
Les recommandations officielles reposent implicitement sur trois promesses. Les témoignages cités confirment davantage les deux premières que le respect des consignes audio.
Promesse n°1 : la structure rapproche du résultat attendu
C’est le point le mieux étayé. Le créateur X @AIWarper a publié une comparaison avant/après son passage au format officiel :
"I STRONGLY encourage you to adhere to the prompting guide released by Minimax. It really helps a lot with getting exactly what you expected.... My last post did not follow the suggested prompt structure." — @AIWarper, 306 likes
Le journal de tests indépendant rapporte le même constat au niveau du détail : une coupe demandée exactement à 00:05.000 a bien eu lieu, un témoignage scripté a été retranscrit mot pour mot et la composition d’une première image est restée stable sur un clip I2VA de 6 secondes. Les retours sur les storyboards vont dans le même sens : les planches de @aimikoda servent de guide séquentiel aux plans, tandis que celle de @nanyuan0412 a été suivie sans improvisation — à l’exception des champs audio oubliés, qui ont produit un résultat presque silencieux.
La limite qui revient le plus souvent relève du rythme, pas d’un refus du modèle. « Biggest problem has been pacing », écrit u/Relevant_One_2261 : un dialogue trop long pour la durée disponible et des horodatages trop rapprochés sont les échecs structurels récurrents.
Promesse n°2 : les ordres de caméra valent mieux que la description du résultat
Un problème de cadrage corrigé en fournit la démonstration. Sur r/StableDiffusion, un utilisateur demandait à H3 de garder un sujet en marche entièrement dans le cadre avec la consigne simple « entire subject remains visible throughout » : échec répété. La solution a consisté à traduire le résultat recherché dans la grammaire caméra native de H3 :
"The camera pulls out with large amplitude at the same speed as the subject walks forward, maintaining a full-body composition." — u/Powerful-Goal52, confirmé comme fonctionnel par l’auteur du post
Cette formulation correspond directement aux trois dimensions caméra de H3 — type de mouvement, amplitude et vitesse — ainsi qu’à sa règle d’une seule instruction caméra par plan. Traduction rapide :
| Résultat recherché | Commande que H3 suit |
|---|---|
| Le sujet reste entièrement visible en marchant | Pull Out avec grande amplitude, à la vitesse de marche du sujet |
| Accentuation douce sans casser le cadrage | Push In, faible amplitude, vitesse lente |
| Révéler l’environnement autour d’un sujet immobile | Truck Left ou Truck Right, amplitude moyenne |
| Changer de hauteur sans incliner la caméra | Pedestal Up / Pedestal Down à vitesse lente |
Les instructions officielles de prompting recensent 13 familles de mouvements : Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll et POV, chacune modulée par l’amplitude et la vitesse. Dans la pratique, la différence entre un zoom, qui modifie la focale, et un push, qui déplace physiquement la caméra, compte réellement : les termes ne sont pas interchangeables.
Promesse n°3 : séparer les champs audio garantit un rendu propre
C’est la couche la moins solide. Distinguer l’ambiance diégétique de la musique extradiégétique est une bonne conception, mais le respect de cette séparation reste irrégulier :
"I use this, but about 20% of the time it adds music anyway lol" — u/TheElectriking à propos de
non_diegetic_music: N/A
Le fil à 220 votes positifs dont est tirée cette citation recense le reste du problème : artefacts audio aux limites du clip, personnages prononçant du charabia et répliques dites par la mauvaise personne. u/krigeta1 indique avoir transmis trois références audio personnalisées pour obtenir « a random voice or not the audio I assign to the characters ». Un autre fil a résolu des dialogues affichés à l’écran qui étaient lus hors champ en liant explicitement l’identifiant du locuteur au personnage visible.
Le texte à l’écran souffre de la même fragilité. Le wiki communautaire prévient que le « exact text is fragile » : pour un lettrage essentiel à une marque, mieux vaut fournir une image de référence ou composer le texte en post-production. Un avis divergent vient de @web4miko, qui affirme qu’à ses essais H3 « can't even beat Seedance 2.0 » sur la compréhension du texte et du contexte. Dans les retours cités, le routage audio, le texte exact et les contextes denses restent les faiblesses récurrentes.
Quand s’écarter du format officiel
Trois écarts au format officiel apparaissent dans les comparaisons côte à côte et les témoignages directs cités. Il vaut mieux les connaître avant de s’engager dans une structure complète.
Les guillemets font parfois mieux que les balises <d>. Dans une comparaison publiée sur r/StableDiffusion (~105 votes positifs, 81 commentaires), l’auteur a constaté que retirer le balisage <d>[Language]...台词...</d> recommandé par le guide et écrire simplement le dialogue entre guillemets produisait une parole nette, là où la version balisée ajoutait de l’audio non demandé. Un commentateur ayant effectué des essais comparables est arrivé à la même conclusion :
"the official dialogue prompting is buggy as hell... quotes approach is still not nearly as buggy as the
<d></d>tagging." — u/networking_noob
En pratique : commencez par <d>, puisque c’est le chemin sur lequel le modèle a été entraîné. Mais si la parole est déformée ou générée en trop, réessayez la même réplique entre guillemets plutôt que de réécrire tout le prompt.
non_diegetic_music: N/A reste un contrôle efficace à lui seul. Selon u/Nextil, cette ligne empêche la musique « even if you ignore most of the other structure ». Si vous ne structurez qu’un seul élément, choisissez celui-ci : la musique non souhaitée revient régulièrement dans les plaintes recensées.
Les projets chargés en références demandent moins de texte, pas davantage. Lorsque les images portent l’identité et qu’une vidéo fournit le mouvement, le rôle du prompt se réduit au routage et à l’action nouvelle. Les modèles les plus partagés de @aimikoda, dont l’un a dépassé 1 300 favoris, sont volontairement minimalistes pour cette raison. De son côté, @CharaspowerAI a montré l’agent Design de MiniMax développant automatiquement une simple phrase — « act as an expert FPV director and turn this into something viral » — en prompt structuré complet. Un bloc de routage des références peut ressembler à ceci :
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
Le reste du prompt ne décrit alors que le nouveau plan. Le flux de travail qui ressort de ces témoignages est simple : verrouillez d’abord les images fixes, laissez les références faire l’essentiel et ne dépensez des mots que pour ce qui change.
Diagnostic des échecs : ce que le manuel ne résout pas
Le guide officiel s’arrête à la syntaxe. Il n’explique pas quoi faire lorsqu’une génération arrive cassée. Le tableau suivant rassemble les échecs rapportés plus haut :
| Symptôme | Cause probable | Correctif |
|---|---|---|
De la musique est ajoutée malgré N/A | Un utilisateur a observé des fuites dans environ 20 % de ses générations | Régénérez ; évitez de demander une « humeur » musicale où que ce soit dans le prompt |
| Le mauvais personnage prononce une réplique | Conflit de routage entre locuteur et audio | Liez explicitement l’identifiant du locuteur au personnage visible à l’écran |
| Une réplique à l’écran devient une voix off | Association de lip-sync absente | Indiquez que le locuteur est visible ; pour une vraie voix off, ajoutez « lips remain closed » |
| La référence audio est ignorée | Dépassement des limites de 3 clips / 15 secondes, ou référence non attribuée | Donnez un rôle à chaque clip ; réduisez la durée totale de l’audio de référence |
| Le modèle local ignore les dialogues chinois | ComfyUI a réutilisé le tokenizer Qwen ; l’encodage du shell a altéré le texte | Tokenizer du repo, exigence officielle, + soumission compatible Unicode + <d>[Chinese] 台词</d> (correctif rapporté par la communauté) |
| Un plan-séquence long (>15 s) se dégrade | Hors de la plage de conception de 4 à 15 s ; objets aplatis, continuité qui dérive | Découpez en segments de 15 secondes et planifiez la continuité entre eux |
Le cas du déploiement local mérite qu’on s’y attarde : dans le rapport de @eternityspring, le problème « H3 won't speak Chinese » venait de la réutilisation du tokenizer et de l’encodage, non du prompt lui-même.
Le coût réel : tokens, itérations et portabilité
La structure a un coût. Le repo officiel publie l’usage de tokens Context-IR pour ses trois cas reproductibles, et les chiffres grimpent rapidement avec le nombre de références :
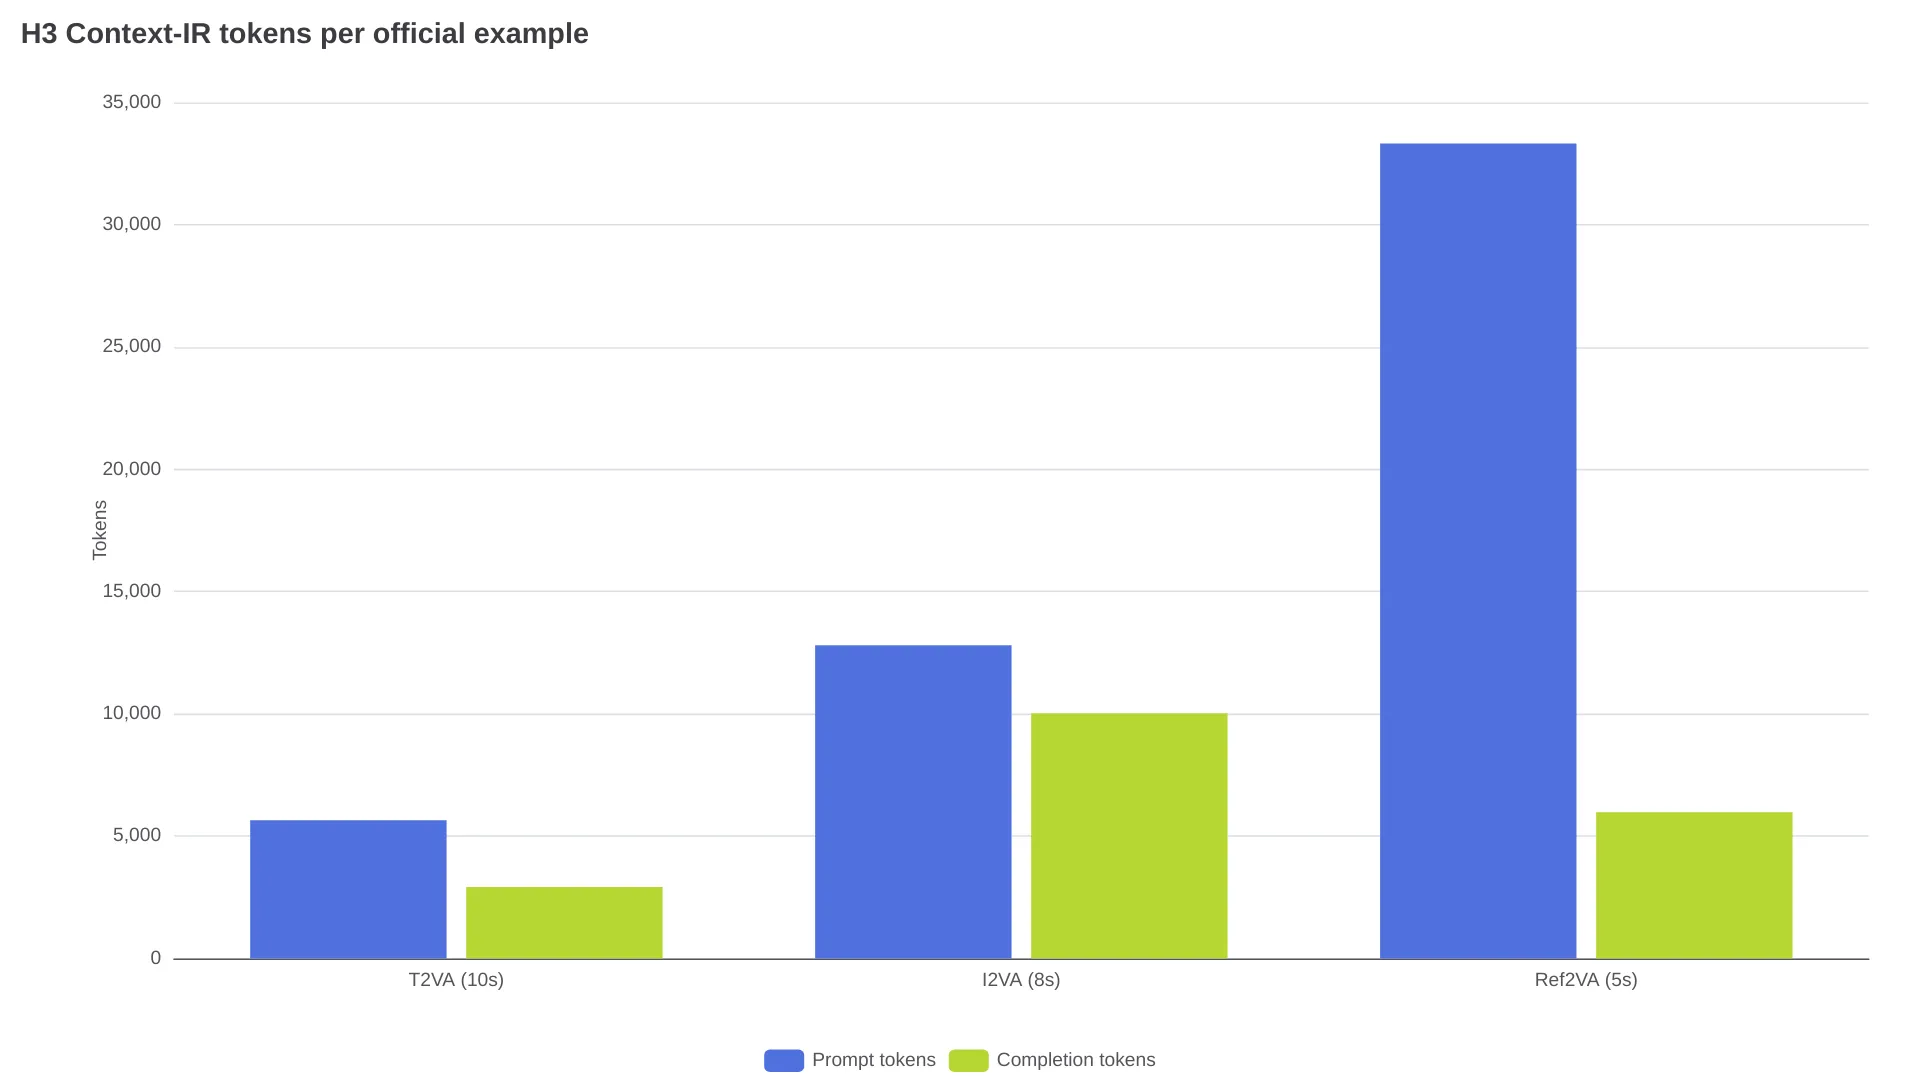
Une génération texte seul consomme 8 565 tokens de prétraitement ; une tâche multimodale avec références en consomme 39 299, dont 33 323 côté prompt. En local, ces tokens ajoutent de la latence de prétraitement ; dans les flux hébergés, ils alourdissent le traitement même lorsque le prix est annoncé par seconde générée. Le temps a lui aussi un prix : un créateur sur X a documenté 48 heures passées à peaufiner un unique prompt avec trois personnages et caméra orbitale avant d’obtenir le résultat voulu (@LoveUolanda). L’itération la moins chère consiste à préparer les essais en 768p, où un test de 6 secondes coûte environ $0.68, puis à n’envoyer le prompt verrouillé qu’en 2K. Les tarifs de $0.1125/s en 768p et $0.1825/s en 2K pour MiniMax H3 sont affichés sur la page modèle du relais.
La portabilité est le dernier coût caché. Les champs, identifiants de locuteurs et balises de H3 constituent un dialecte, pas un standard. Un guide comparatif multi-modèles relève que Veo 3.1 préfère des paragraphes simples avec des libellés SFX: intégrés, tandis que Seedance 2.0 utilise une description à six emplacements. Aucun des deux n’accepte les champs, identifiants de locuteurs ou balises de H3. Une bibliothèque de prompts H3 devra donc être réécrite, et non simplement copiée-collée, ailleurs.
FAQ sur les prompts MiniMax H3
Le format de prompt structuré est-il obligatoire avec MiniMax H3 ?
Non. Sur l’API hébergée, Context-IR transforme les demandes libres en langage naturel dans la représentation interne. La structure compte surtout avec les poids ouverts en local, ainsi que pour les coupes précises, les horodatages et le routage des locuteurs.
Comment empêcher MiniMax H3 d’ajouter une musique de fond ?
Terminez par non_diegetic_music: N/A et ne demandez aucune ambiance musicale ailleurs. Des fuites restent possibles ; régénérer fait donc partie du processus normal.
Quelle longueur doit faire un prompt MiniMax H3 ?
Les exemples de MiniMax font 300 à 700 mots, et le text-to-video pur accepte jusqu’à environ 7 000 caractères. Lorsque les références portent l’identité et le mouvement, le prompt doit raccourcir, pas s’allonger.
Puis-je réutiliser des prompts H3 avec Seedance ou Veo ?
Non. Les champs nommés, identifiants de locuteurs et balises de H3 sont spécifiques au modèle. Seedance emploie un format à six emplacements et Veo accepte des paragraphes simples : chaque modèle cible demande sa propre réécriture.
Pourquoi mon déploiement H3 local ignore-t-il les dialogues non anglais ?
Le problème vient généralement de la chaîne d’outils, pas du modèle. Les configurations qui réutilisent le tokenizer Qwen ou des shells qui altèrent l’Unicode cassent le dialogue avant la génération. Utilisez le tokenizer officiel du repo et le format de dialogue <d>[Language].
Verdict : à qui s’adresse vraiment ce format
| Votre usage | Verdict |
|---|---|
| Film multi-plans avec dialogue | Apprenez le format complet ; prévoyez des tentatives audio supplémentaires et le recours aux guillemets |
| Animation produit / image fixe (I2VA) | Apprenez la version légère : phrase d’alignement + mouvement + champs audio |
| Storyboard ou série avec cohérence des personnages | Oui : les références font le gros du travail ; gardez des prompts minimaux et faciles à router |
| Clips uniques, usage occasionnel | Ignorez l’essentiel : une description simple + non_diegetic_music: N/A suffisent |
| Création d’une bibliothèque unique de prompts multi-modèles | Non : le dialecte de chaque modèle exige sa propre version ; rédigez modèle par modèle |
Apprenez le format pour les projets multi-plans, horodatés ou pilotés par références : c’est là que son respect est documenté et reproductible. Pour un clip isolé, passez-le largement ; pour les productions riches en dialogue, attendez-vous à relancer plutôt qu’à une obéissance parfaite.
La communauté elle-même est partagée entre ces deux réalités. Le même mois a vu à la fois 48 heures de travail sur un prompt caméra et un post à 880 votes positifs où un commentaire affirmait que « reading the manual was actually exciting ». Tant que le respect des champs audio ne rejoindra pas celui des instructions caméra, la position la plus pragmatique reste la suivante : laissez un agent préparer la structure, vérifiez vous-même les champs audio et testez à faible coût en 768p avant de passer à la 2K.