 AIREITER
Un simple prompt « cinématique » d'une ligne laisse au modèle le soin d'inventer tout ce qui manque. Sans consigne caméra, les notes de prompting des fournisseurs indiquent qu'on obtient souvent un plan fixe ; sans champs audio explicites, des dialogues indésirables peuvent s'inviter. Avec MiniMax H3, il faut plutôt penser comme sur un tournage et rédiger un script compact : les guides officiels imposent un format à trois champs, des horodatages de plans, des identifiants de locuteurs stables et deux rubriques réservées au son. Le tout doit tenir dans un budget d'environ 7 000 caractères selon le fournisseur, pour un clip plafonné à 15 secondes.
Base ou référence : choisissez d'abord le bon format H3
MiniMax propose deux guides distincts de rédaction de prompts dans le dépôt MiniMax-H3 sur Hugging Face, chacun correspondant à un usage différent. Le guide base couvre quatre tâches de génération sans référence importée. Le guide référence devient nécessaire dès qu'une image, une vidéo ou un extrait audio importé intervient dans la création. Les quatre tâches du mode base correspondent aux modes suivants :
| Mode | Entrée | Instruction d'alignement à inclure dans le prompt |
|---|---|---|
| T2VA | Texte uniquement | Aucune ; commencez directement par les champs principaux |
| I2VA | Une image de première frame | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | Première et dernière frames | Picture 1 à 0.00 seconde, Picture 2 à l'heure exacte de fin |
| L2VA | Une image de dernière frame | Picture 1 s'aligne sur l'heure de fin de la vidéo et le dernier plan |
Les deux guides se terminent par des exemples complets. Le billet de lancement de MiniMax présente le modèle selon la même logique : vous décrivez les relations entre les entrées texte, image, vidéo et audio, plutôt que de sélectionner des tâches dans un menu. Les endpoints hébergés résument cela en trois workflows — minimax/h3/text-to-video, image-to-video et reference-to-video sur fal — mais la structure de prompt sous-jacente ne change pas.
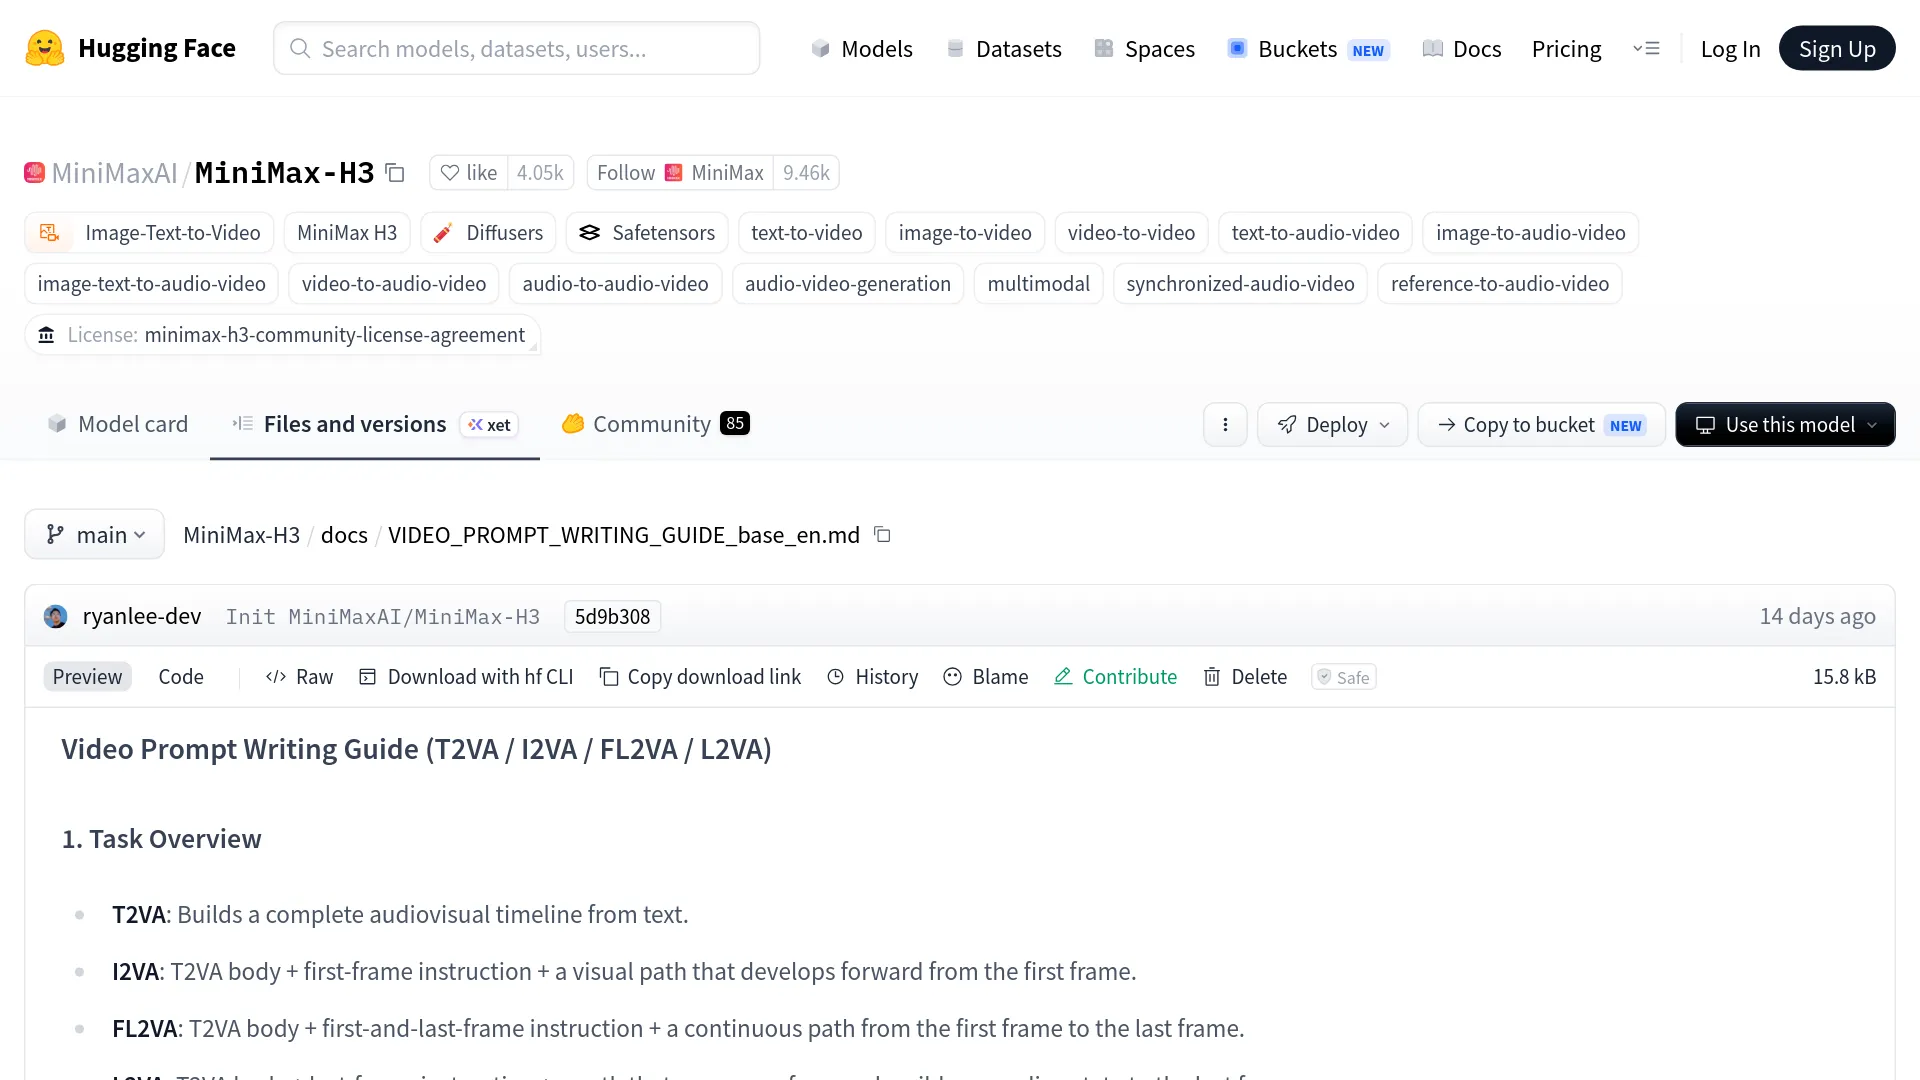
Le prompt base, champ par champ
Après l'instruction d'alignement, un prompt MiniMax H3 en mode base comporte exactement trois champs obligatoires, séparés par une ligne vide. Voici son squelette :
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptionporte toute la chronologie : style visuel, composition, actions, changements de plans, locuteurs, dialogues et son diégétique — bref, tout ce qui est vu ou entendu.overall_soundscaperésume l'ambiance et les sons physiques en 1 à 4 phrases, dans un seul paragraphe et sans dialogue.non_diegetic_musicdécrit la musique entendue uniquement par le public en 1 à 3 phrases, ou prend la valeurN/As'il n'y en a pas.
Exemple rempli, adapté du cas T2VA du guide officiel, autour d'une boulangerie avant le lever du soleil :
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
Selon les règles officielles, chaque ligne agit ainsi :
| Élément du prompt | Ce qu'il contrôle | Règle |
|---|---|---|
[Shot 1] Live-action, cinematic. | Style global | Le libellé de style ouvre Shot 1 ; parmi les exemples donnés par le guide : Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor, vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | Identité du locuteur | Les attributs d'identité précèdent l'ID, qui reste identique d'un plan à l'autre |
The camera pushes in with small amplitude at slow speed | Caméra | Type de mouvement + amplitude + vitesse, formulés comme une action naturelle |
<d>[English] First batch of the day.</d> | Dialogue | Uniquement la balise de langue et les mots exacts, textuels, jamais traduits |
At 00:05.000, the camera cuts to... | Moment de coupe | Les temps doivent être strictement croissants ; [Shot 1] ne reçoit jamais d'horodatage |
<scenetrans> continuing seamlessly across the cut | Continuité audio | Signale qu'un dialogue traverse une coupe, aux deux points de raccord |
Plans, coupes et mouvements de caméra
La syntaxe des plans dans MiniMax H3 est positionnelle : [Shot 1] n'a jamais d'horodatage, tandis que chaque plan suivant commence par un temps de coupe strictement croissant, tel que At 00:03.500,. Les formulations de coupe admises restent courtes — "the camera cuts to", "the shot transitions to", "the shot switches to" — et les fondus enchaînés, fondus au noir ou volets ne doivent être mentionnés que si vous les demandez explicitement. Si seul le cadrage évolue légèrement, le guide recommande un mouvement de caméra plutôt qu'une coupe : une coupe doit apporter une nouvelle information de sujet, d'espace, d'état ou de temps.
Décrivez le mouvement de caméra comme une action naturelle en anglais, sur trois dimensions au maximum : type, amplitude et vitesse.
| Dimension | Expressions acceptées |
|---|---|
| Type de mouvement | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| Amplitude | "with small amplitude", "with large amplitude" |
| Vitesse | "at slow speed", "at fast speed" |
Par convention, on omet l'amplitude moyenne et la vitesse normale. La nuance est importante : "Zoom In" modifie la focale depuis une position fixe, alors que "Push In" avance physiquement la caméra. Le guide maintient volontairement cette distinction.
Dialogues et identifiants de locuteurs
Chaque personnage qui parle dans un prompt MiniMax H3 reçoit un ID stable — (S1), (S2), ou une forme groupée comme (S1,S2) pour une parole synchronisée — qu'il conserve dans tous les plans. Les personnages qui ne parlent jamais n'ont aucun ID. Lors de la première apparition d'un locuteur, décrivez assez précisément son identité pour stabiliser la génération : présence à l'écran ou hors champ, tranche d'âge, genre, hauteur de voix, timbre, débit et accent.
Syntaxe exacte pour une ligne :
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
Quatre règles documentées évitent les erreurs les plus fréquentes. L'identité, l'action et l'interprétation restent hors de <d> ; à l'intérieur, ne placez que la balise de langue et les mots exacts, avec leur ponctuation. Pour une voix off, utilisez littéralement "says in an off-screen voiceover", suivi immédiatement de la mention que les lèvres du personnage visible restent fermées. Un dialogue qui se prolonge après une coupe reçoit <scenetrans> aux deux points de raccord, avec une formulation de continuité telle que "continues seamlessly across the cut" ou "carries over from the previous shot". Une phrase interrompue par la fin de la vidéo doit employer <cutoff>.
Les guillemets ont un seul usage réservé : tout texte visible dans la vidéo — bannière, panneau, étiquette, néon ou sous-titre — doit apparaître entre guillemets anglais doubles, textuellement et sans traduction. Écrire un dialogue parlé entre guillemets est précisément ce qui pousse H3 à le produire sous forme de sous-titres incrustés plutôt que de parole.
Les deux champs dédiés au son
Le billet de lancement de MiniMax précise que tout l'audio H3 est généré nativement en stéréo avec la vidéo. C'est pourquoi le son possède deux champs dédiés, plutôt que quelques adjectifs dans la description. overall_soundscape couvre l'ambiance et les sons physiques — vent, pluie, circulation, pas, mouvements de tissu, impacts, respiration, rires — en 1 à 4 phrases. La valeur N/A est réservée à une demande explicite de silence total. non_diegetic_music décrit la musique de score que les personnages n'entendent pas, par l'instrumentation, la vitesse, le rythme et les évolutions de dynamique ; les termes d'ambiance abstraits comme "epic" ou "emotional" sont explicitement déconseillés, et N/A est la valeur appropriée si vous ne voulez aucune musique.
Le son diégétique — chant, radio dans la scène ou musicien de rue — n'a sa place dans aucun de ces deux champs. Il doit figurer dans integrated_multimodal_description, là où se déroule la chronologie. Cette séparation n'est pas qu'une convention : le guide pratique APIMODELS souligne que des résultats fiables exigent des contraintes sonores explicites, et qu'un non_diegetic_music non renseigné peut laisser apparaître une musique jamais demandée.
Prompts avec références : labels et conservation
Le guide référence prend le relais dès lors que des assets importés orientent la génération. Il impose six sections, dans cet ordre : subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape, non_diegetic_music. Pour les tâches de génération, le bloc detailed_description doit généralement compter 350 à 500 mots anglais ; les prompts très chargés en dialogue doivent néanmoins couvrir toute la chronologie parlée, même si cela fait dévier ce volume.
Quatre types de labels structurent les références :
| Label | Usage |
|---|---|
<Subject N> | Contenu visible réellement utilisé dans la sortie : personne, produit, scène, tenue, style ou action abstraite depuis n'importe quel asset |
<Picture N> | Image servant d'ancrage concret à une frame : première frame, image clé, dernière frame ou ancre de composition |
<Video N> | Relation avec une vidéo entière : source de montage, point de continuation, structure caméra ou coupes, rythme |
<Audio N> | Signal audio copié ou référencé : timbre vocal, paroles, beats ou effets sonores |
La numérotation est indépendante pour chaque type. Une vidéo importée peut donc être <Video 1>, tandis que sa piste audio est <Audio 2>. Un sujet parlant combine son label et son identifiant de locuteur : <Subject 3> (S1).
La section summary s'ouvre par un préfixe de tâche entre crochets, tel que [reference generation] ou [video editing + audio reuse]. Une édition vidéo doit commencer par "The target video is an edited version of <Video 1>." La section retention_analysis attribue ensuite un marqueur à chaque label : fully_preserved, partially_preserved, attribute_transfer ou weak_reference pour le visuel ; fully_copy, partially_copy, reference ou weak_reference pour l'audio. C'est ainsi que vous indiquez à H3 qu'un visage doit être conservé, mais que la tenue peut changer.
Squelette minimal en mode référence, dans l'ordre documenté :
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
Quand H3 déraille : diagnostic et corrections
| Symptôme | Cause probable dans le prompt | Correctif |
|---|---|---|
| Charabia ou faux langage type « Sims » | Dialogue non structuré, absence d'IDs de locuteurs ou personnages silencieux non décrits | Ajoutez les IDs (S1)/(S2), encadrez les mots exacts avec <d>[Language] ...</d> et indiquez explicitement que les personnages silencieux ne parlent pas |
| Sous-titres incrustés sur les dialogues | Paroles écrites entre guillemets | Réservez les guillemets au texte visible à l'écran et placez le dialogue dans des balises <d> |
| Dialogue attribué au mauvais personnage | ID de locuteur non relié à une personne décrite | Définissez les attributs d'identité du locuteur — âge, présence à l'écran, voix — dès sa première apparition et gardez le même ID dans tous les plans |
| Musique ou score non demandé | non_diegetic_music vague ou absent | Écrivez non_diegetic_music: N/A lorsque vous n'en voulez pas : une solution que les discussions communautaires créditent pour supprimer l'audio indésirable |
| Coupes non prévues | Coupes suggérées par les changements de scène sans horodatage | Utilisez [Shot N] At 00:03.500 avec des formulations de coupe explicites ; pour un plan-séquence, demandez explicitement "no cuts" |
| Dérive du visage, de la tenue ou du produit | Rôle de la référence jamais déclaré | Ajoutez une ligne retention_analysis contenant fully_preserved pour ce label et répétez le label à chaque apparition |
Les lignes sur le charabia et les sous-titres découlent directement des règles de syntaxe officielles. Des discussions communautaires sur r/StableDiffusion rapportent indépendamment l'efficacité des mêmes correctifs, notamment non_diegetic_music: N/A, souvent cité pour éliminer l'audio non désiré.
Limites et coût des essais
L'enveloppe de génération compte : la longueur des prompts est limitée et chaque itération est facturée. Voici les limites documentées dans l'API officielle et chez les fournisseurs hébergés :
| Paramètre | Valeur | Note |
|---|---|---|
| Durée du clip | Jusqu'à 15 s, en secondes entières | Le minimum est de 5 s sur les endpoints fal/EvoLink ; certains documents API V2 indiquent 4 s |
| Résolution | 768p et 2K, 24 FPS | Selon MiniMax, le 2K est la résolution de sortie par défaut |
| Fichiers de référence | Jusqu'à 9 images, 3 vidéos, 3 audios | 12 fichiers au total ; l'audio ne peut jamais être la seule référence |
| Longueur du prompt | ~7 000 caractères | Documentation fal et API V2 ; APIMODELS indique 20 480 — vérifiez votre fournisseur |
| Ratios | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptatif | En image-to-video, le ratio suit celui de l'image source |
Les tarifs évoluent selon les fournisseurs : considérez donc ces chiffres comme des instantanés datés, non comme des prix catalogue. Sur fal, une génération 2K coûtait 0,26 $ par seconde au moment d'un relevé tarifaire du 1er août — 1,30 $ pour 5 secondes, 3,90 $ pour 15 — avec les cinq premières images de référence offertes et 0,08 $ par image supplémentaire. Sur APIMODELS, H3 est facturé 0,088 $ par seconde, soit 1,32 $ pour un clip de 15 secondes, et seules les requêtes réussies sont facturées. Pour situer ce prix, voici les tarifs par seconde sur cette même marketplace :
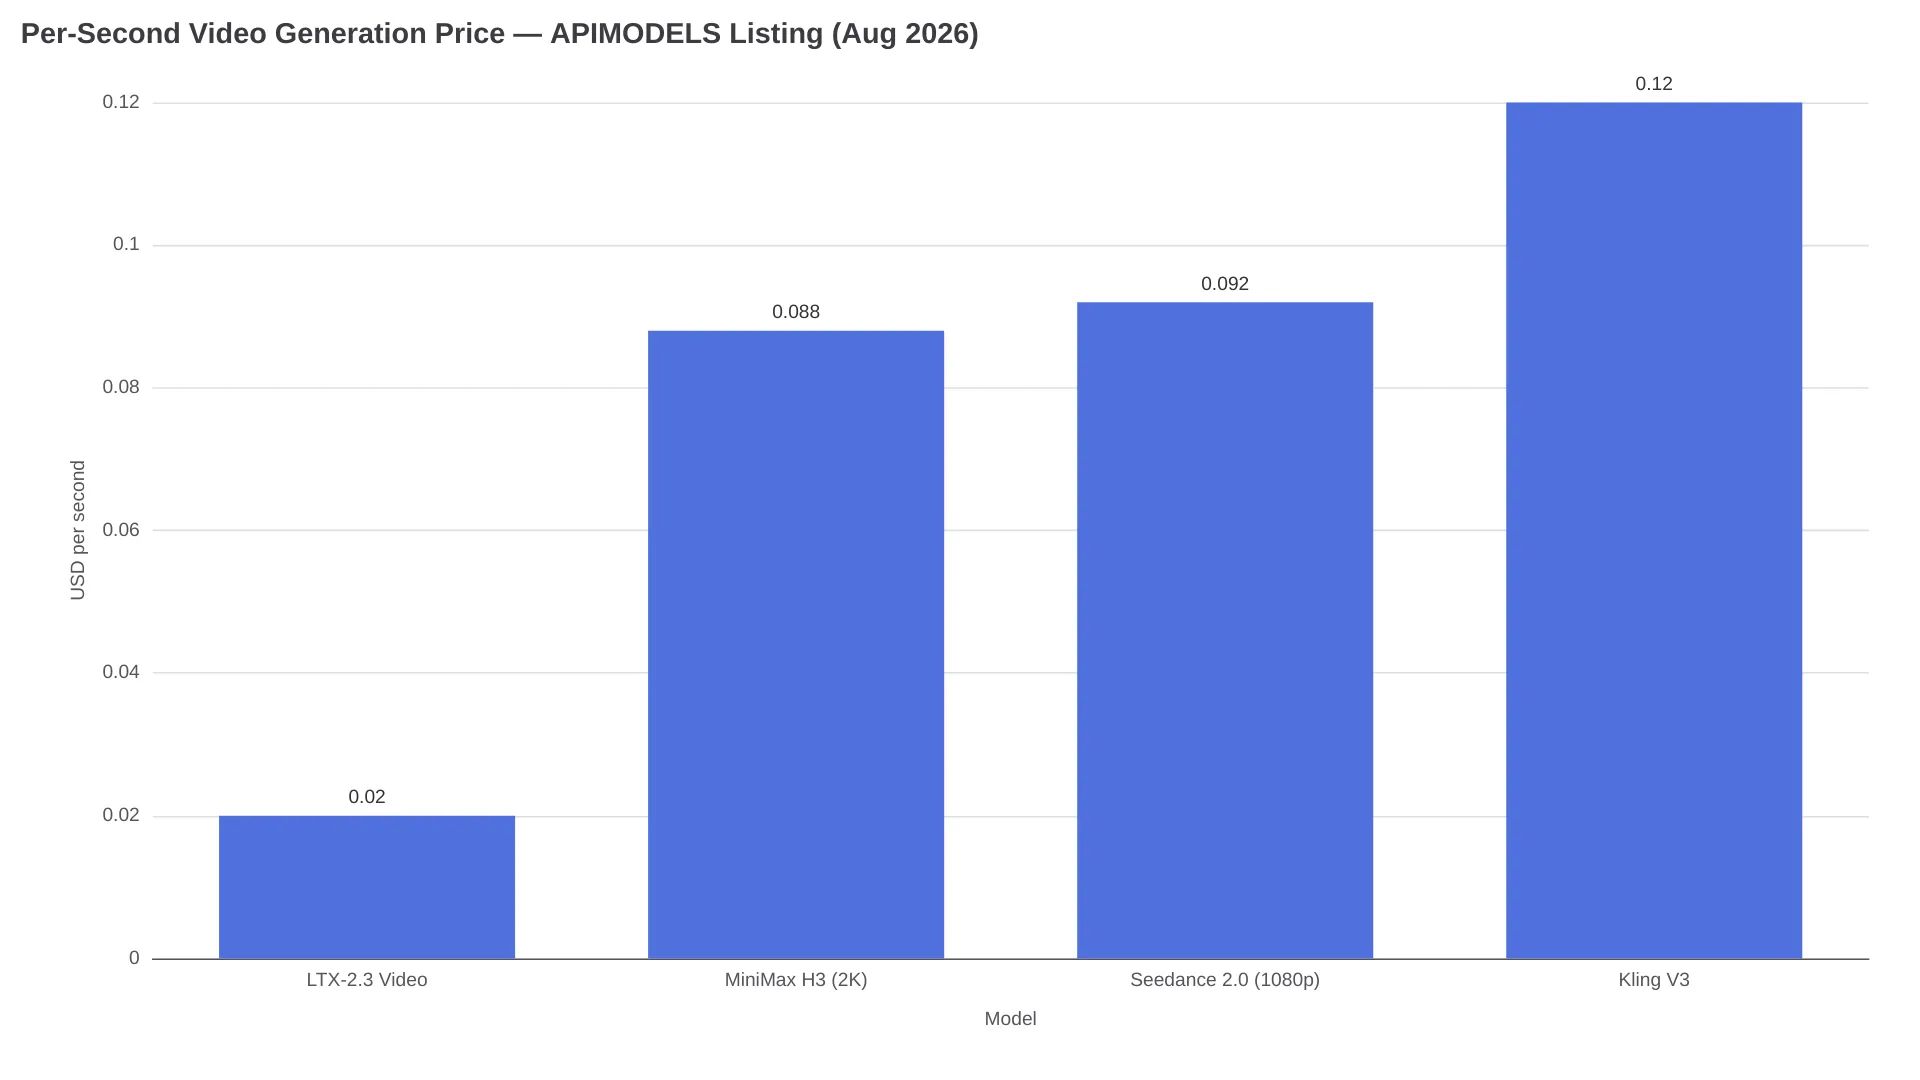
Le véritable poste budgétaire se joue dans les retouches : un prompt structuré de dialogue sur 15 secondes qui réussit à la deuxième tentative coûte 2,64 $ sur APIMODELS, tandis qu'un prompt non structuré nécessitant cinq tentatives pour obtenir une prise exploitable revient à 6,60 $. Pour itérer sur vos prompts via un endpoint H3 hébergé, la page API MiniMax H3 d'AIReiter propose le modèle avec les tarifs actuels affichés sur la page.
Modèles prêts à copier-coller
Ces deux squelettes base couvrent la plupart des créations courtes. Remplissez les crochets et conservez exactement les noms de champs ainsi que les lignes vides :
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/APour partir de prompts éprouvés plutôt que de champs vides, trois bibliothèques conservent les liens vers leurs sources. ecomimagelab/awesome-minimax-h3-prompts : 58 prompts, dont 39 officiels et 19 testés par la communauté, chacun accompagné de sa vidéo de résultat téléchargeable selon la règle "No video, no entry." imagineVid/Awesome-minimax-h3-prompts-and-skills : 28 cas vérifiés dans six workflows, de la continuité d'identité omni-référence au dialogue avec audio natif. La galerie APIMODELS : 226 prompts consultables par cas d'usage, avec clips associés ; sa règle tient en une ligne : "References carry identity, the prompt carries action."
Deux raccourcis existent aussi pour rédiger les scripts. Des utilisateurs de Reddit rapportent de bons résultats en collant un guide officiel dans un LLM puis en indiquant le mode cible — par exemple "rewrite this idea as T2VA using the base guide". Une extension ComfyUI, MiniMax H3 Prompt Writer v0.3, génère quant à elle le format structuré directement dans un workflow à nœuds.
FAQ
Quelle est la différence entre les guides de prompts base et référence de MiniMax H3 ?
Le guide base couvre quatre modes sans référence — T2VA, I2VA, FL2VA et L2VA — construits autour de trois champs principaux. Le guide référence ajoute six sections obligatoires et les labels <Subject>/<Picture>/<Video>/<Audio> dès que des images, vidéos ou audios importés guident la génération.
Comment identifier les locuteurs dans un prompt MiniMax H3 ?
Attribuez des IDs stables (S1), (S2) dans l'ordre de la première prise de parole, conservez-les d'un plan à l'autre, utilisez (S1,S2) pour une parole simultanée et placez seulement la balise de langue ainsi que les mots exacts dans les balises <d>.
Comment éviter l'audio incompréhensible dans MiniMax H3 ?
Structurez les dialogues avec des IDs de locuteurs et des balises <d> textuelles, indiquez que les personnages qui ne parlent pas restent silencieux et définissez non_diegetic_music: N/A lorsqu'aucune musique de score n'est souhaitée : ce sont les correctifs documentés et confirmés par la communauté.
Faut-il mettre les dialogues MiniMax H3 entre guillemets ?
Non. Les guillemets sont réservés au texte visible dans la vidéo ; les paroles doivent se trouver dans <d>[Language] ...</d>, sans quoi H3 peut les rendre sous forme de sous-titres à l'écran.
Quelle longueur peut atteindre un prompt MiniMax H3 ?
Environ 7 000 caractères sur fal et dans la documentation officielle de l'API V2, même si APIMODELS indique 20 480. Vérifiez la limite de votre endpoint avant de rédiger un script de 10 000 caractères.
Ce que la syntaxe ne résout toujours pas
Une structure solide améliore le taux de réussite, sans rendre la génération déterministe. La fidélité exacte d'une identité, d'un logo ou d'un produit reste probabiliste : des wrappers d'API maintenus par la communauté refusent explicitement de promettre une cohérence frame par frame, et les meilleurs exemples de bibliothèques de prompts contraignent l'identité avec de longs blocs de règles plutôt qu'avec des garanties mesurées. Les <tags> en ligne destinés aux sons non verbaux relèvent de l'expérimentation communautaire et leurs résultats varient selon la génération. Évaluez vos sorties au coût par seconde validée, non au coût par requête, et gardez les guides officiels base et référence ouverts dans un onglet pendant l'écriture.
À lire aussi : la présentation de la sortie de MiniMax H3 explique le modèle, tandis que MiniMax H3 vs LTX 2.3 le compare à l'alternative la moins chère à la seconde.