 AIREITER
On voit parfois la requête « 3-5 », mais les identifiants officiels de Google sont bien gemini-3.5-transcribe et gemini-3.5-transcribe-live. L’API existe et reste abordable. Le vrai choix dépend toutefois de votre priorité : obtenir un texte propre, conserver chaque mot prononcé ou afficher des sous-titres en direct.
Gemini 3.5 Transcribe API : le verdict en un tableau
Gemini 3.5 Transcribe mérite clairement un prototype pour les fichiers enregistrés, la dictée et les courtes expériences de sous-titrage en direct. En revanche, ce n’est pas le choix par défaut pour produire une transcription strictement fidèle ou conserver un enregistrement live de longue durée : le mode Smart réécrit le discours, le direct ne fournit ni identification des intervenants ni horodatage mot à mot, et le service est encore en préversion publique.
| Si vous avez besoin de… | Utilisez… | Verdict du test |
|---|---|---|
| D’une transcription de réunion, d’appel ou de podcast téléversé | gemini-3.5-transcribe | À utiliser ; choisissez le mode verbatim si la formulation compte |
| D’une dictée nettoyée ou de notes de réunion lisibles | Le modèle pour fichiers enregistrés avec le mode Smart | À utiliser avec relecture si la réécriture est acceptable |
| De sous-titres pendant qu’une personne parle | gemini-3.5-transcribe-live | À prototyper pour de courtes sessions interactives |
| De noms d’intervenants et d’un horodatage mot à mot | Le modèle pour fichiers enregistrés avec annotations verbatim | À utiliser avec réserves ; 30 minutes et 3 intervenants ou plus sont expérimentaux |
| D’une source de référence juridique, médicale, réglementaire ou archivistique | Un pipeline verbatim avec relecture humaine | À ne pas utiliser comme source unique |
Il s’agit d’un test d’API fondé sur les éléments disponibles, pas d’un benchmark WER réalisé dans un environnement contrôlé. Le guide de configuration et de tarification de Gemini 3.5 Transcribe API détaille le flux de requête ; ce test s’intéresse surtout à ce que ces compromis impliquent une fois le premier appel réussi.
Deux modèles, deux contrats d’API bien distincts
gemini-3.5-transcribe traite les fichiers audio téléversés ou préenregistrés via l’Interactions API, tandis que gemini-3.5-transcribe-live prend en charge l’audio diffusé en continu avec la Live API.
Transcription enregistrée : gemini-3.5-transcribe
La version dédiée aux fichiers enregistrés est la plus complète pour produire des transcriptions durables. Google documente la détection automatique de la langue dans plus de 85 langues, le vocabulaire personnalisé, les sorties Smart ou verbatim, la diarisation et les horodatages au niveau du mot dans la documentation sur la transcription audio.
La limite habituelle est fixée à une heure d’audio. L’activation de la diarisation ou des horodatages mot à mot ramène cette limite à 30 minutes. Google précise par ailleurs que l’attribution à trois intervenants ou plus reste expérimentale, même si la référence du modèle mentionne jusqu’à huit intervenants.
Cette route convient à la dictée, aux entretiens et aux appels courts. Pour les réunions plus longues qui nécessitent d’identifier les participants et d’aligner le texte sur l’audio, l’application devra découper puis recoller les segments.
Transcription en direct : gemini-3.5-transcribe-live
La route live vise les sous-titres générés progressivement, pas la reproduction exacte du modèle enregistré derrière un WebSocket. La documentation de Google sur la transcription en direct décrit les événements de transcription intermédiaires et finalisés, la détection automatique de la langue, le vocabulaire personnalisé, le mode Smart et les modes de détection d’activité vocale automatique, hybride ou manuelle.
Une session live continue dure 10 minutes. Le streaming en direct ne prend en charge ni la diarisation ni les horodatages mot à mot. L’audio doit être fourni en PCM brut 16 bits, 16 kHz, mono, little-endian. Ces contraintes conviennent à un aperçu de sous-titres, mais l’enregistrement d’un long appel dépendra de la reconnexion, de l’assemblage des sessions et de la gestion du texte provisoire.
Le compromis fonctionnel qui fait toute la différence
La particularité de Gemini 3.5 Transcribe tient à son nettoyage « intelligent », mais cette fonction modifie aussi le sens que l’on donne à la précision. Un texte plus fluide peut être idéal pour une dictée et beaucoup moins adapté à la conservation littérale d’un échange.
Le mode Smart réécrit le discours : ce n’est pas une source brute
Le mode Smart de Google supprime les mots de remplissage, les hésitations et les faux départs. Il corrige aussi les rectifications orales et met en forme la ponctuation, les nombres, les listes et les paragraphes. Ainsi, « On se retrouve mardi, non, mercredi » peut devenir « mercredi », sans conserver le faux départ.
C’est pratique pour préparer un e-mail, une note vocale ou des comptes rendus lisibles. En revanche, c’est risqué lorsque l’hésitation, l’erreur initiale ou l’ordre exact des mots a une valeur probante.
Le guide officiel de transcription fixe clairement la limite : le mode Smart ne peut pas être combiné à la diarisation ni aux horodatages mot à mot. L’API oblige donc à choisir entre un texte propre et des annotations permettant de retracer précisément l’échange.
Conservez une transcription verbatim comme source de référence, puis générez une copie nettoyée en mode Smart ou via un traitement en aval. Inutile d’essayer de contourner cette incompatibilité avec un prompt : elle relève du contrat de sortie de l’API.
Horodatages et intervenants renforcent la traçabilité, au prix de limites plus strictes
Avec l’audio enregistré, le mode verbatim peut renvoyer des annotations word_info contenant le texte de chaque mot, ses offsets et l’identifiant de l’intervenant, si la fonctionnalité est configurée. Ces données permettent de générer des sous-titres, de naviguer vers un passage précis, de calculer la durée de parole de chacun et de faciliter la vérification des éléments importants.
| Besoin | Route enregistrée | Route live |
|---|---|---|
| Diarisation | Prise en charge ; jusqu’à 8 intervenants selon la documentation, 3 ou plus en expérimental | Non prise en charge |
| Horodatage au niveau du mot | Pris en charge | Non pris en charge |
| Sortie Smart avec annotations | Non prise en charge | Non prise en charge avec les annotations mot à mot |
| Limite de durée | 1 heure en temps normal ; 30 minutes avec diarisation ou horodatage mot à mot | 10 minutes par session continue |
| Réserve sur la précision | Google avertit que les horodatages mot à mot peuvent réduire la précision | Le texte intermédiaire peut changer avant sa finalisation |
Dire que l’API « prend en charge les horodatages » ne suffit donc pas pour prendre une décision. La fonction existe, mais elle réduit la durée maximale des fichiers et peut dégrader la reconnaissance. Testez l’attribution des propos au lieu de considérer la limite théorique comme une garantie de fiabilité pour les grandes réunions.
Vocabulaire personnalisé et détection de la langue
Les deux routes prennent en charge la détection automatique de la langue et le vocabulaire personnalisé. Google documente plus de 85 langues ainsi que le changement de langue en cours de conversation, et recommande d’ajouter des indications comme en-US lorsque l’application connaît déjà la langue utilisée.
Le vocabulaire personnalisé accepte jusqu’à 1 000 termes, mais les recommandations pratiques de Google indiquent que les résultats sont généralement meilleurs avec 100 termes au maximum. Réservez cette liste aux noms de produits, acronymes, noms propres et termes techniques, plutôt qu’aux mots courants.
Le fait qu’une langue soit « prise en charge » ne garantit pas le même niveau de qualité selon les accents, les dialectes, le bruit ambiant ou les changements de langue au milieu d’une phrase. Une discussion Reddit publiée peu après le lancement demandait notamment si la route live pouvait gérer plusieurs langues mélangées. C’est un cas de test intéressant, pas la preuve d’un dysfonctionnement.
« Je préférerais que la vidéo ait un léger décalage et que les sous-titres soient synchronisés avec les paroles. » — u/WaterObjective5107, Reddit
Ce commentaire met le doigt sur un problème propre aux produits live que le WER ne mesure pas : des sous-titres peuvent être linguistiquement corrects tout en donnant une mauvaise impression s’ils ne sont pas synchronisés avec la vidéo.
Ce que les chiffres de précision permettent réellement d’affirmer
Les chiffres publiés par Google sont encourageants, mais ils correspondent à plusieurs contextes d’évaluation, pas à un score universel de Gemini 3.5 Transcribe. Ils justifient un pilote sérieux, pas l’abandon des tests sur vos microphones, vos accents, votre vocabulaire et les profils de vos intervenants.
| Contexte d’évaluation | WER annoncé | Ce que cela indique |
|---|---|---|
| Artificial Analysis, streaming | 4.0% | Une moyenne citée en streaming, pas un score de latence ou de diarisation |
| Artificial Analysis, non-streaming | 2.6% | Une moyenne citée sur de l’audio enregistré dans ses conditions de test |
| FLEURS, streaming | 5.50% | Un résultat multilingue en streaming sur certaines langues |
| FLEURS, non-streaming | 5.04% | Un autre résultat multilingue sur de l’audio enregistré |
Ces chiffres figurent dans l’annonce de lancement de Google, qui revendique également une amélioration de 70 % du délai avant transcription finale par rapport à Chirp 3. Il s’agit d’une affirmation de Google, pas d’un test indépendant réalisé sur votre flux de travail.
L’écart entre 2.6% et 5.50% n’est pas contradictoire. Les routes, les jeux de données, la répartition des langues et les conditions de streaming diffèrent. Évaluez plutôt les erreurs qui ont un coût concret — noms, numéros de commande, dates, montants, termes produit et attribution des propos — au lieu de vous fier uniquement au WER global.
Les premiers retours de la communauté citent notamment le changement de langue, l’attribution des intervenants, le comportement des horodatages et la finalisation des longs enregistrements comme cas à tester ; un utilisateur de X a décrit un fichier de 20 minutes dont seules cinq minutes avaient été retournées. Ces témoignages donnent des pistes, mais ne constituent pas des faits produit établis dans un environnement contrôlé. (Témoignage sur X)
Les difficultés de production que le guide de démarrage ne montre pas
Un téléversement réussi ou une connexion WebSocket établie prouve que le transport fonctionne, pas que le produit est prêt pour la production. Les vrais risques apparaissent ensuite : texte live mutable, limites propres à chaque route, gestion des identifiants, statut de préversion et règles de conservation d’une transcription fiable.
Les sous-titres live exigent une vraie gestion d’état
Les réponses live ont deux fonctions. interim_input_transcription fournit une hypothèse évolutive destinée à l’aperçu des sous-titres ; input_transcription correspond au segment finalisé qui peut être ajouté à l’état durable de la transcription.
Adoptez le modèle d’état suivant :
- Remplacez le sous-titre visible à chaque mise à jour intermédiaire.
- Ajoutez au transcript validé uniquement le texte finalisé.
- Renouvelez la session ou reconnectez-vous avant la limite de 10 minutes.
- Assemblez les sessions avec un marqueur de séparation explicite et une logique de déduplication.
- N’effectuez aucune action irréversible à partir du texte intermédiaire.
Dans les clients web et mobiles, utilisez des jetons éphémères afin de ne pas exposer une clé API longue durée dans le code frontend. Un backend est nécessaire pour générer et restreindre ces jetons ; l’audio peut ensuite circuler directement du client vers la Live API si cette architecture convient à l’application. Surveillez les erreurs de connexion, le délai de finalisation et les segments dupliqués.
Les flux enregistrés doivent définir une source de référence
Définissez le contrat de sortie avant de choisir le mode. Le mode Smart convient à la prose lisible ; le mode verbatim s’impose lorsque les mots exacts, l’identité des intervenants ou les offsets sont importants.
Stockez le résultat verbatim et ses annotations, puis générez une transcription nettoyée distincte pour la recherche, les résumés ou les notes destinées aux clients. Cette approche ajoute une étape de traitement, mais elle reste plus sûre que d’essayer de reconstituer ensuite les mots de remplissage supprimés ou les corrections réécrites.
Le statut de préversion pèse dans la décision de déploiement
Google a annoncé Gemini 3.5 Transcribe le 26 août 2026 comme une famille de modèles en préversion publique. La référence des modèles Google documente les fonctionnalités et les limites, mais le statut de préversion impose de vérifier à nouveau les tarifs, les quotas, le comportement et la disponibilité avant toute migration.
Commencez par un petit jeu d’évaluation non sensible accompagné de transcriptions de référence enregistrées. Mesurez séparément la précision des entités critiques, l’attribution des intervenants, le délai de finalisation, le comportement lors des reconnexions et le taux de corrections apportées par les relecteurs. Fixez des seuils de validation écrits avant les tests et ne passez à l’étape suivante que lorsque chacun est atteint.
Le prix ne dit pas tout : calculez le coût d’une transcription validée
Les estimations affichées pour Gemini 3.5 Transcribe sont faibles, mais la facturation repose sur les tokens et non sur un tarif forfaitaire garanti à la minute. Le tableau tarifaire officiel de Google indique environ 0,003 $ par minute pour l’audio en entrée sur les fichiers enregistrés, auxquels s’ajoutent 0,002 $ pour la sortie texte, soit environ 0,005 $ par minute en estimation combinée ; le mode Live revient à environ 0,009 $ par minute.
| Route | Estimation audio en entrée | Estimation sortie texte | Estimation combinée | 100 heures |
|---|---|---|---|---|
Enregistrée gemini-3.5-transcribe | 0,003 $/min | 0,002 $/min | 0,005 $/min | Environ 30 $ |
Live gemini-3.5-transcribe-live | Environ 0,005 $/min | Environ 0,004 $/min | 0,009 $/min | Environ 54 $ |
Le premier budget à prévoir est donc d’environ 30 $ pour 100 heures enregistrées, ou 54 $ en direct, avant de compter les nouvelles tentatives, le stockage, la conversion audio, la correction humaine et la génération de résumés. La longueur de la sortie et le contexte ajouté peuvent modifier la facture : conservez des journaux d’utilisation.
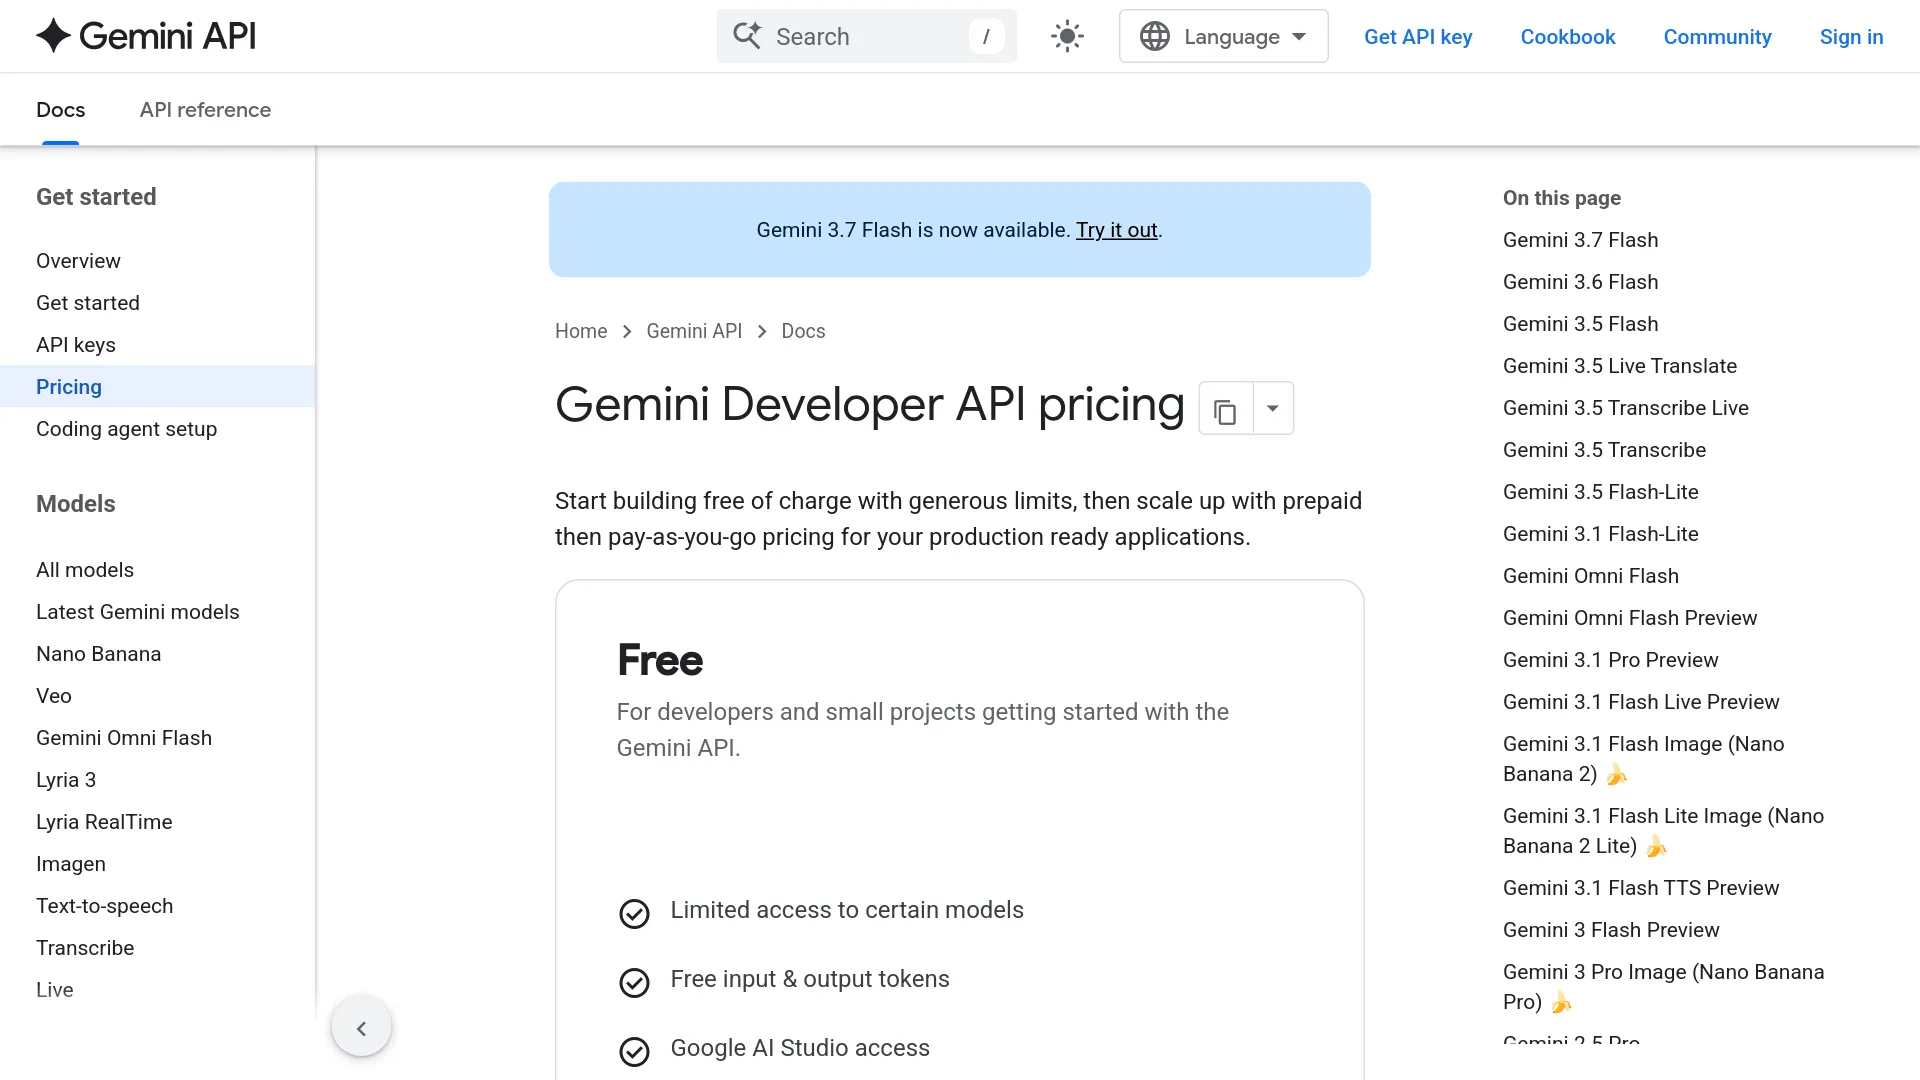
Capture réalisée à partir de la page tarifaire publique de Google ; vérifiez le tableau actuel avant de vous engager sur un volume important. Consultez la documentation officielle sur les tarifs de Gemini API.
Le coût d’une transcription acceptée doit inclure l’usage de l’API, le temps de relecture, le tarif du correcteur, les nouvelles tentatives, le stockage, la conversion et les traitements en aval. Les corrections du mode Smart ou une seconde passe d’annotation peuvent rendre une API plus chère globalement moins coûteuse si elles réduisent le temps de correction manuelle.
FAQ sur Gemini 3.5 Transcribe API
La transcription Smart peut-elle conserver exactement les mots prononcés ?
Non. Le mode Smart modifie les hésitations et les autocorrections. Utilisez donc le mode verbatim comme source de référence lorsque chaque mot compte.
La Live API fournit-elle les intervenants ou des horodatages mot à mot ?
Non. Utilisez la route enregistrée lorsque vous avez besoin de diarisation ou d’horodatages au niveau du mot.
Gemini 3.5 Transcribe peut-il traiter une longue réunion ?
La limite habituelle des fichiers enregistrés est d’une heure, ou de 30 minutes avec la diarisation ou les horodatages mot à mot. En direct, la limite est de 10 minutes par session continue.
Le service convient-il aux transcriptions juridiques, médicales ou réglementaires ?
Utilisez-le uniquement comme outil d’assistance, avec une sortie verbatim, des contrôles sur les champs critiques et une relecture humaine. Ne faites pas du résultat Smart l’unique trace pour un contenu à forts enjeux.
Le verdict : prototypez-le, mais ne le laissez pas devenir la référence par accident
Gemini 3.5 Transcribe est un candidat solide lorsque l’objectif est une transcription multilingue, peu coûteuse et sensible au contexte, plutôt qu’une reproduction littérale parfaite. Commencez par la route enregistrée, comparez les sorties Smart et verbatim sur vos propres fichiers audio et n’ajoutez les annotations que si la limite de 30 minutes reste acceptable.
Passez au mode Live pour les sous-titres ou une interface vocale une fois que le client sait diffuser le format PCM requis de manière sécurisée et distinguer le texte intermédiaire du texte finalisé. Pour les contenus sensibles, conservez la sortie brute et faites de la relecture humaine un critère d’acceptation à part entière — pas une réparation de dernière minute après la réécriture de la source par le mode Smart.