 AIREITER
Vous voulez transformer un enregistrement en texte exploitable ou générer des sous-titres depuis un micro ? Gemini 3.5 Transcribe mérite le détour grâce au nettoyage automatique, aux suggestions de vocabulaire et à sa gestion multilingue. Mais ses deux modes d'accès à l'API n'ont pas du tout les mêmes limites : l'API fichier convient aux transcriptions durables, tandis que l'API Live vise les sessions courtes à faible latence.
Le choix le plus simple : l'API fichier, sauf pour les sous-titres en direct
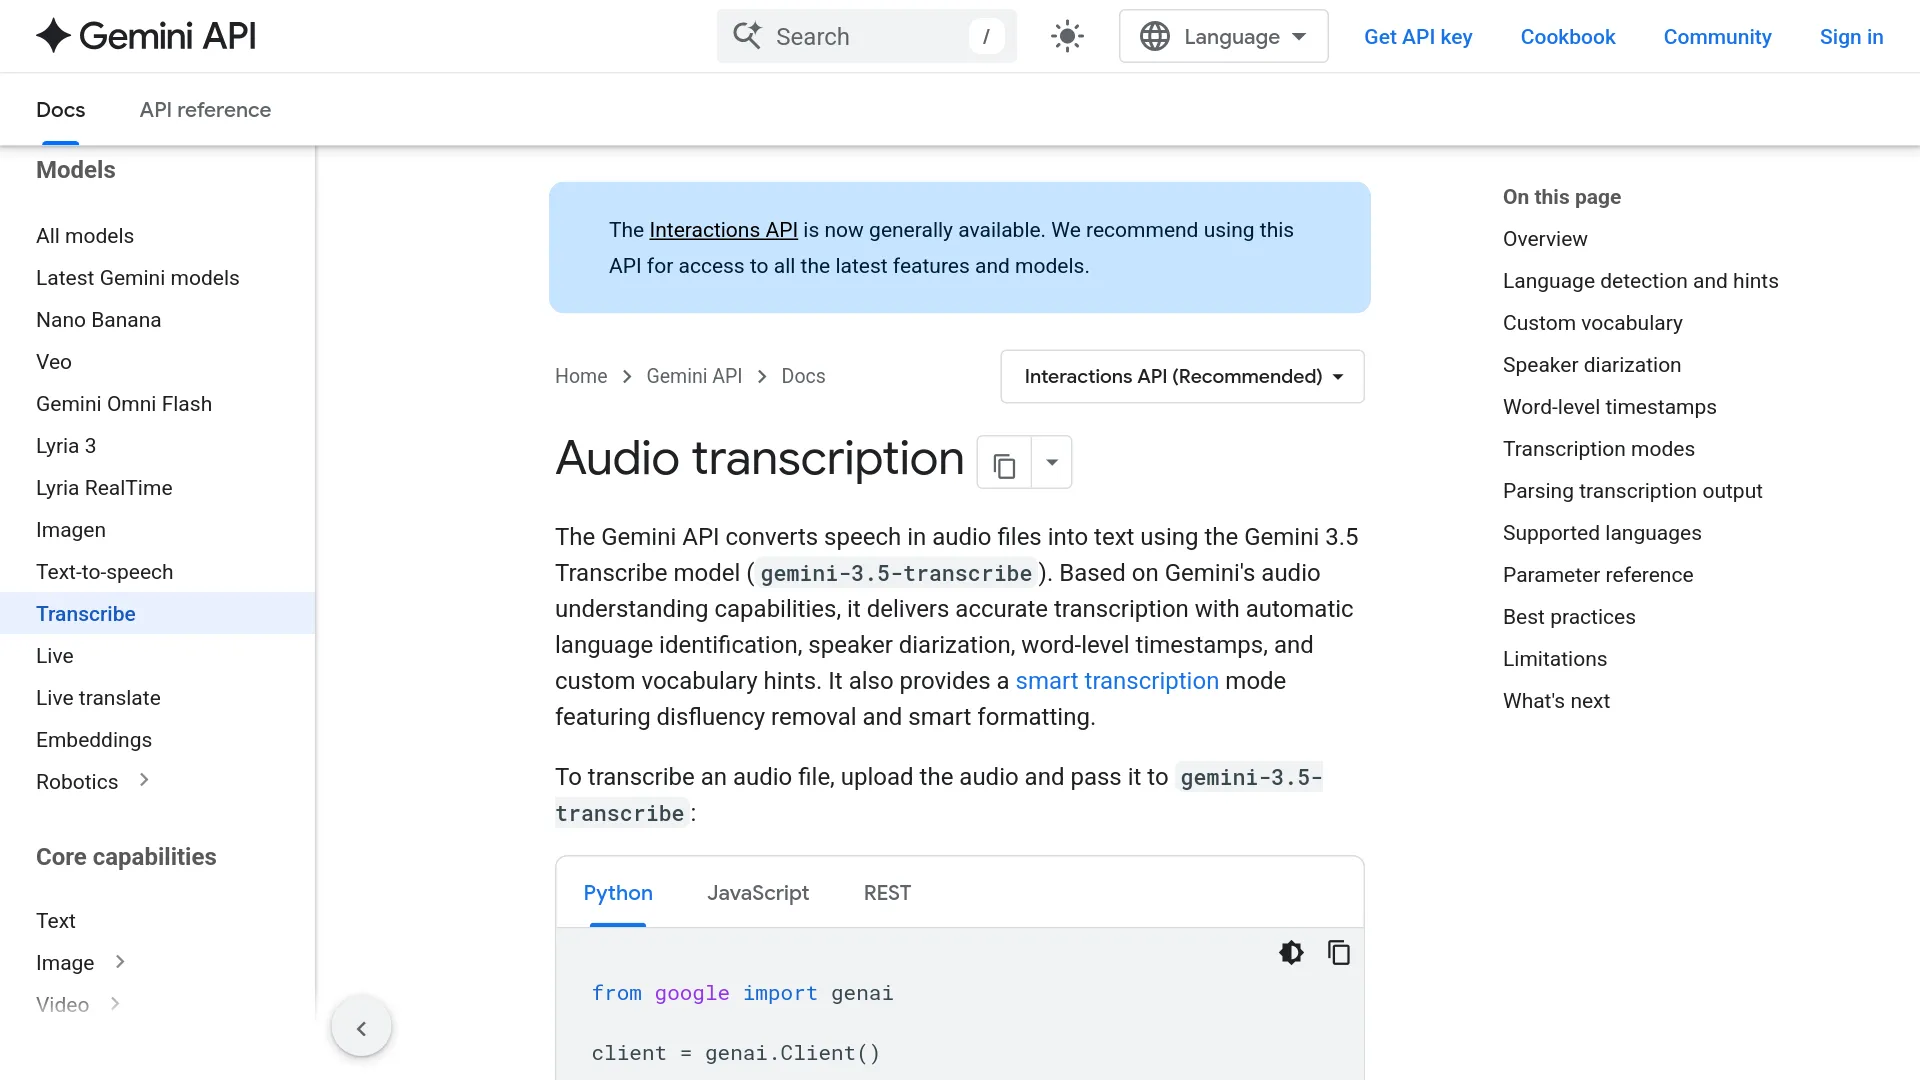
Gemini 3.5 Transcribe est la famille de modèles de reconnaissance vocale dédiée de Google, proposée en préversion publique depuis le 26 août 2026. Google documente des identifiants de modèles, des transports, des événements de sortie et des contraintes distincts pour l'audio enregistré et l'audio en temps réel.
| Besoin | Identifiant du modèle | Chemin d'API | Contrainte importante |
|---|---|---|---|
| Réunions, appels, enregistrements importés | gemini-3.5-transcribe | Interactions API | Jusqu'à 1 heure pour une requête unaire standard ; 30 minutes avec diarisation ou horodatage des mots |
| Sous-titres en direct, entrée micro, interface vocale | gemini-3.5-transcribe-live | Live API | Session continue de 10 minutes ; pas de diarisation ni d'horodatage mot à mot en direct |
Pour archiver une réunion, analyser des appels ou préparer des sous-titres, commencez par gemini-3.5-transcribe. Pour un aperçu des sous-titres ou une interface push-to-talk, choisissez gemini-3.5-transcribe-live. Le guide Google consacré à la transcription audio enregistrée et le guide de la Live API décrivent ces workflows séparément.
Une disponibilité encore limitée à la préversion
Google a annoncé Gemini 3.5 Transcribe le 26 août 2026 et indique que l'API développeur est disponible en préversion publique via Google AI Studio et Google Antigravity. L'accès entreprise est lui aussi proposé en préversion via Gemini Enterprise Agent Platform. Ce statut implique que la couverture régionale, les quotas et la stabilité peuvent différer de ceux d'un service vocal généralement disponible. Testez donc des fichiers représentatifs avant d'y transférer un volume important.
Les tarifs de Gemini 3.5 Transcribe ramenés à des unités concrètes
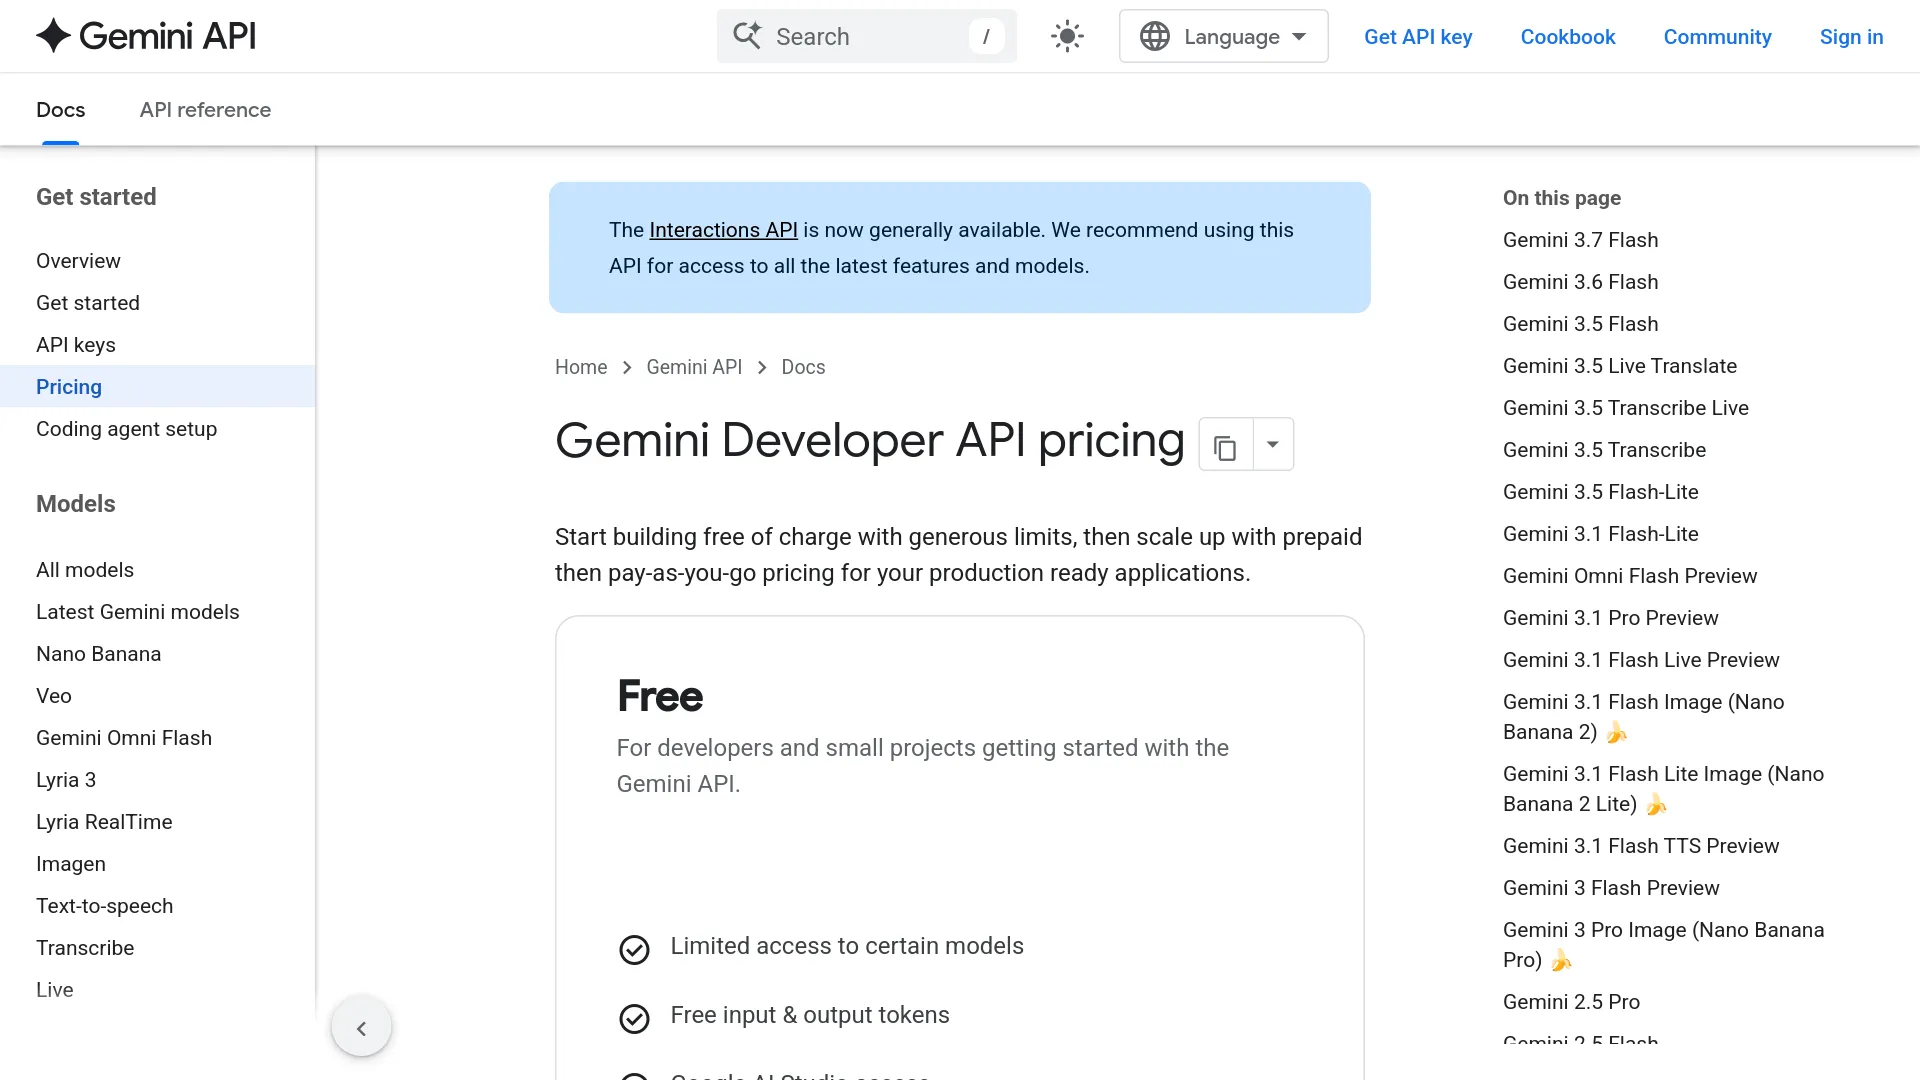
La page tarifaire de Gemini API de Google présente des prix fondés sur les tokens, plutôt qu'un forfait fixe à la transcription. Selon les tarifs actuellement affichés, gemini-3.5-transcribe coûte 2 $ par million de tokens audio en entrée et 12 $ par million de tokens texte en sortie.
La documentation audio de Google indique que l'audio est représenté à raison de 32 tokens par seconde, soit 1 920 tokens audio par minute. La seule partie correspondant à l'audio en entrée revient donc à environ 0,00384 $ par minute au tarif de 2 $ par million de tokens, avant de prendre en compte la sortie texte et les autres tokens facturables.
| Modèle | Base tarifaire publiée | Estimation indicative combinée | Estimation indicative pour 1 heure |
|---|---|---|---|
gemini-3.5-transcribe | 2 $/M de tokens audio en entrée + 12 $/M de tokens texte en sortie | Environ 0,005 $/min | Environ 0,30 $/heure |
gemini-3.5-transcribe-live | Traitement audio et texte en direct facturé aux tokens | Environ 0,009 $/min | Environ 0,54 $/heure |
Ces montants combinés dépendent du volume de texte produit par la transcription. Il s'agit donc d'estimations utiles pour préparer un budget, pas de tarifs garantis à la minute. Une sortie dense, un contexte répété ou des instructions supplémentaires peuvent modifier la facture. Consultez la grille tarifaire en vigueur avant de vous engager, car les tarifs d'une préversion peuvent évoluer.
Les arbitrages fonctionnels à connaître avant la mise en production
Transcription verbatim ou transcription intelligente
VERBATIM est le mode par défaut dans la documentation de transcription de Google. Il conserve les mots de remplissage, les répétitions, les pauses, les débuts de phrase interrompus et les corrections formulées à l'oral. C'est le mode à privilégier lorsque la transcription sert de compte rendu fidèle, de pièce justificative, de source pour des sous-titres ou de support au contrôle qualité.
SMART transforme la parole pour la rendre plus lisible. Le mode supprime les hésitations, résout les autocorrections, ajoute la ponctuation et structure le contenu. Il peut aussi mettre en forme les dates, les devises, les nombres, les listes et les paragraphes. Ainsi, « mardi — non, mercredi » peut devenir « mercredi » dans le résultat nettoyé.
Le mode Smart n'est pas compatible avec la diarisation ni avec l'horodatage au niveau des mots. Si votre application doit produire des notes lisibles tout en garantissant une piste d'audit, demandez d'abord une sortie verbatim et nettoyez-en une copie séparément.
Vocabulaire personnalisé et alternance de langues
Google documente la détection automatique de la langue pour plus de 85 variantes régionales, y compris l'alternance entre plusieurs langues. Lorsque la langue est connue, indiquez un code BCP-47 tel que en-US ou es-ES pour orienter la reconnaissance.
Le vocabulaire personnalisé accepte jusqu'à 1 000 termes, mais les recommandations pratiques de Google indiquent que les résultats sont généralement meilleurs avec 100 termes ou moins. Ajoutez des noms de produits distinctifs, des acronymes, des noms propres, des termes médicaux ou du vocabulaire technique, plutôt qu'une liste de mots courants.
Identification des locuteurs et horodatage des mots
L'audio enregistré peut fournir l'attribution des locuteurs ainsi que le minutage de chaque mot. La documentation de l'API indique un maximum de huit locuteurs, tandis que l'article de lancement de Google met en avant l'attribution pour trois locuteurs maximum et qualifie de fonctionnalité expérimentale la prise en charge de trois locuteurs ou plus.
L'horodatage des mots s'active en mode verbatim et fournit un décalage de début et de fin pour chaque mot. Google prévient que ces horodatages peuvent réduire la précision globale de la transcription. La diarisation et l'horodatage ramènent également la limite audio standard d'une heure à 30 minutes.
| Besoin | Pris en charge ? | Précaution |
|---|---|---|
| Étiquettes de locuteurs sur un audio enregistré | Oui | Jusqu'à 8 selon la documentation ; l'attribution à partir de 3 locuteurs est expérimentale |
| Horodatage mot à mot sur un audio enregistré | Oui | Mode verbatim uniquement ; peut réduire la précision |
| Étiquettes de locuteurs en transcription en direct | Non | Utilisez un audio enregistré lorsque l'attribution est importante |
| Horodatage mot à mot en transcription en direct | Non | La sortie Live est incrémentale et organisée autour des énoncés |
| Mode Smart avec étiquettes ou horodatage | Non | Choisissez le mode verbatim pour obtenir ces annotations |
Envoyer un fichier enregistré via Gemini 3.5 Transcribe API
Le guide Google consacré à l'audio enregistré décrit trois étapes : importer le fichier, transmettre l'URI renvoyée à l'Interactions API, puis récupérer la transcription terminée dans interaction.output_text.
- Importez l'audio avec la Files API. Cette méthode convient aux enregistrements de plus de quelques secondes ou aux fichiers que vous comptez réutiliser.
- Conservez l'URI du fichier renvoyée ainsi que son type MIME, par exemple
audio/mp3. - Envoyez l'URI à
gemini-3.5-transcribevia l'Interactions API. - Lisez la sortie texte et, si nécessaire, consultez les annotations
word_infopour récupérer les données de locuteur et de minutage.
Avec le SDK officiel, le workflow d'import et de transcription peut se résumer à cet exemple :
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Une requête REST minimale ressemble à ceci une fois que l'import via la Files API a renvoyé FILE_URI :
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
Pour obtenir une transcription nettoyée, ajoutez une configuration de transcription avec le mode Smart :
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
Pour obtenir les étiquettes de locuteurs et le minutage des mots, utilisez plutôt le mode verbatim :
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Ne combinez pas la configuration Smart avec la diarisation ou les horodatages. Les règles de compatibilité documentées pour les modes de l'API en font un choix d'architecture, pas une simple préférence de mise en forme.
Le fonctionnement de la transcription en direct
La Live API ouvre une connexion de streaming bidirectionnelle avec gemini-3.5-transcribe-live. Le client envoie un flux audio continu et reçoit deux types d'événements texte :
interim_input_transcription: une hypothèse évolutive à faible latence, adaptée aux sous-titres ou à l'aperçu dans l'interface.input_transcription: le texte finalisé à enregistrer dans la transcription ou dans l'état de l'application.
Le guide Live de Google demande un flux audio PCM 16 bits, 16 kHz, mono et little-endian. Il recommande des paquets d'environ 100 millisecondes, avec environ 1 024 à 2 048 frames par paquet. Les clients web et mobiles doivent utiliser des jetons éphémères restreints plutôt que d'exposer une clé API classique ; les exemples de Google utilisent un jeton à usage unique avec une expiration de 30 minutes.
L'endpoint Live prend en charge la détection automatique de la langue, les indications BCP-47, le vocabulaire personnalisé et les sorties VERBATIM ou SMART. En revanche, il ne gère ni la diarisation des locuteurs ni l'horodatage mot à mot en direct. Une session continue est limitée à 10 minutes : les flux plus longs nécessitent donc une gestion des sessions au niveau de l'application et un assemblage des transcriptions.
Pour détecter les limites entre les prises de parole, la Live API propose trois approches :
- VAD automatique : le serveur détecte les débuts et fins de parole.
- VAD hybride : un détecteur côté client signale la fin de la parole, tandis que la détection serveur reste disponible en secours.
- VAD manuel : une interface push-to-talk envoie explicitement les événements de début et de fin d'activité.
Ce que les premiers résultats montrent — et ce qu'ils ne prouvent pas
Google rapporte, via Artificial Analysis, des taux moyens de WER de 4,0 % en streaming et de 2,6 % sans streaming. Son article de lancement mentionne également des résultats FLEURS de 5,50 % de WER en streaming et de 5,04 % sans streaming, ainsi qu'une amélioration de 70 % du délai avant transcription finale par rapport à Chirp 3.
Ces chiffres proviennent de Google ou de sources citées par Google pour le lancement ; ils ne constituent pas un test comparatif indépendant de Gemini 3.5 Transcribe. Le benchmark STT public de koedesk a mesuré Gemini 3.5 Flash et d'autres moteurs, mais pas directement Gemini 3.5 Transcribe.
Les premiers utilisateurs s'interrogent notamment sur les limites de durée des modes fichier et Live, les transcriptions de référence utilisées pour calculer le WER et la fiabilité des numéros de téléphone ou de commande dans les passages sans bruit. Testez les noms, identifiants, chiffres, changements de locuteur, timings et latence sur des fichiers représentatifs, plutôt que de vous fier uniquement à un WER moyen.
Quand choisir Gemini 3.5 Transcribe — et quand patienter
| Situation | Adéquation | Configuration de départ recommandée |
|---|---|---|
| Notes de réunion ou dictée nettoyées | Très adaptée | API fichier, SMART, indication explicite de la langue si elle est connue |
| Compte rendu juridique, réglementaire ou archivistique | À évaluer au cas par cas | API fichier, VERBATIM ; relire manuellement les passages critiques |
| Appels enregistrés avec plusieurs locuteurs | À évaluer au cas par cas | API fichier, VERBATIM + diarisation ; limiter les sessions à 30 minutes |
| Sous-titres synchronisés mot à mot | À évaluer au cas par cas | API fichier, VERBATIM + horodatage des mots ; valider le timing et la précision |
| Sous-titres en direct | Très adaptée aux sessions courtes | Live API, utiliser uniquement les événements finaux pour le texte conservé |
| Agent vocal fonctionnant sur une longue durée | Nécessite du développement | Segmenter les sessions avant la limite de 10 minutes et gérer les reconnexions |
| Traitement local hors ligne ou confidentiel | Peu adaptée | Le workflow documenté envoie l'audio au service Google ; envisagez une solution ASR auto-hébergée |
Gemini 3.5 Transcribe est surtout pertinent lorsque la transcription constitue la première étape d'un workflow plus large : nettoyer la parole, préserver le vocabulaire technique, identifier les locuteurs, puis transmettre un texte structuré. Le modèle est moins indiqué si le seul objectif est une transcription littérale bon marché ou si le traitement hors ligne est obligatoire.
FAQ sur Gemini 3.5 Transcribe API
Gemini 3.5 Transcribe est-il gratuit ?
Google propose un niveau gratuit pour l'utilisation de Gemini API, mais les quotas et la disponibilité des modèles peuvent évoluer. L'utilisation payante est facturée aux tokens ; la page tarifaire affiche actuellement des estimations combinées indicatives d'environ 0,005 $ par minute pour la transcription enregistrée et de 0,009 $ par minute pour le modèle Live.
Quelle différence entre les modèles fichier et Live ?
gemini-3.5-transcribe traite des enregistrements importés via l'Interactions API et prend en charge la diarisation ainsi que l'horodatage des mots sur les fichiers enregistrés. gemini-3.5-transcribe-live diffuse du PCM brut via la Live API, renvoie des événements intermédiaires et finaux, et se limite à des sessions de 10 minutes sans diarisation ni horodatage mot à mot en direct.
Puis-je traiter un enregistrement de trois heures en une seule requête ?
Pas avec la configuration dédiée à la transcription enregistrée. La limite standard d'une requête unaire est d'une heure, et la diarisation ou l'horodatage des mots la ramènent à 30 minutes. Un workflow plus long doit donc découper l'audio au niveau de l'application et gérer soigneusement le contexte ainsi que la continuité des locuteurs.
Puis-je utiliser Gemini 3.5 Transcribe hors ligne ?
Le workflow documenté importe ou diffuse l'audio vers le service de Google. Google ne décrit pas de version hors ligne ou auto-hébergée de Gemini 3.5 Transcribe.
La première intégration la plus sûre
Commencez par un petit échantillon issu de votre véritable usage, pas par un extrait de démonstration parfaitement propre. Faites passer le même audio deux fois : d'abord en mode verbatim pour mesurer la fidélité, puis en mode Smart pour évaluer la lisibilité. Mesurez séparément les noms propres, les chiffres, les changements de locuteur, la dérive des horodatages et le coût.
Conservez la transcription brute comme source de référence, utilisez la sortie Smart pour les notes destinées aux utilisateurs et prévoyez un mécanisme de secours en cas d'échec d'import ou de modification du modèle en préversion. Ne passez à la Live API qu'une fois le client capable de gérer les paquets PCM de 100 millisecondes, les événements intermédiaires et finaux, les jetons éphémères et la limite de session de 10 minutes.