 AIREITER
Un correctif déployé à 3 heures du matin n’a d’intérêt que s’il n’entraîne pas une panne à 3 h 15. Cette analyse de Replit Monitoring Agent arrive à une conclusion nuancée : Auto-fix est pertinent pour trier et traiter un incident de production sous supervision, mais Auto-republish, encore expérimental, reste trop peu documenté pour les parcours de production critiques.
Replit a officiellement lancé Monitoring Agent le 22 octobre 2026. L’outil peut examiner les métriques et le code d’une application en production, tenter un correctif, le valider, puis éventuellement republier l’application. Replit sépare les contrôles de détection, de modification du code et de déploiement : les équipes ne sont donc pas obligées d’accorder ces trois autorisations en bloc.
Verdict pour la production : choisissez le réglage intermédiaire
La configuration la plus sûre tout en restant utile est la suivante : alertes Monitoring activées, Auto-fix activé, Auto-republish désactivé. Replit peut ainsi enquêter sur l’incident et préparer un correctif, tandis qu’une validation humaine reste nécessaire avant toute modification de la production.
| Type de charge | Alertes | Auto-fix | Auto-republish | Recommandation |
|---|---|---|---|---|
| Démo jetable ou outil interne à faible impact | Activées | Activé | Facultatif | Acceptable après un exercice de rollback |
| Application destinée aux clients | Activées | Activé | Désactivé | Meilleur réglage par défaut |
| Paiements, authentification, données réglementées ou processus irréversibles | Activées | Facultatif | Désactivé | Imposer les procédures normales de revue et de mise en production |
| Application sans procédure de récupération testée | Activées | Désactivé | Désactivé | Mettre en place la récupération avant de déléguer des modifications |
Cette recommandation s’appuie sur la documentation de Replit elle-même. Auto-republish est expérimental, et Replit précise que les migrations et les opérations sur les index peuvent être risquées. La même page ne documente ni déploiement canary, ni rollback automatique, ni seuil d’erreur post-déploiement lié à l’error budget, ni suite de validation exacte qu’un correctif doit réussir.
Cela ne signifie pas que les correctifs automatiques échoueront. En revanche, un opérateur ne peut pas encore auditer suffisamment la politique de mise en production pour confier à l’outil des incidents à fort impact.
Suivez un incident à travers toute la chaîne de contrôle
L’annonce de lancement décrit un parcours allant des données de production au diagnostic, puis à la modification du code, à sa validation et au compte rendu.
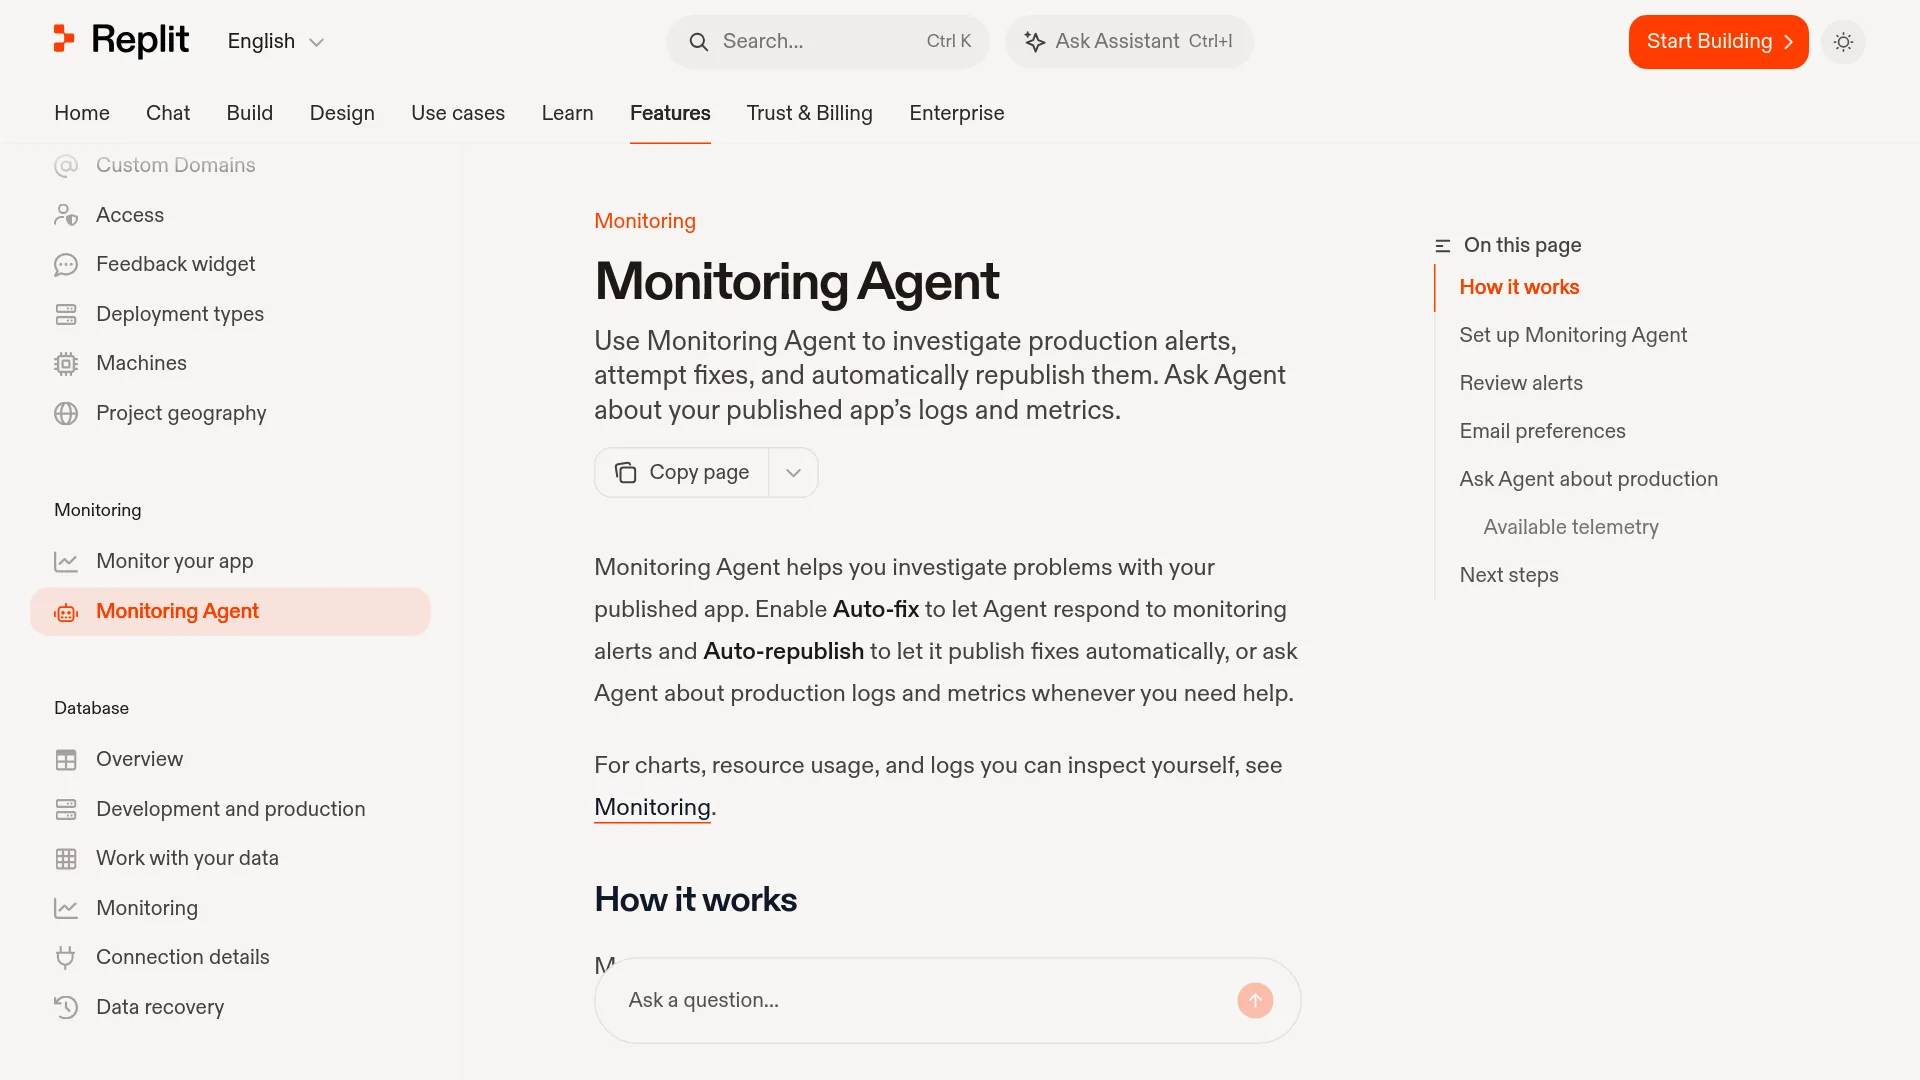
- Monitoring détecte une erreur applicative, une erreur HTTP ou un problème de latence des requêtes.
- Auto-fix autorise Agent à examiner les métriques de production, les journaux d’exécution, le code source et l’alerte concernée.
- Agent tente de modifier le code, puis valide le résultat.
- Si Auto-republish est désactivé, le correctif reste dans la conversation Agent, en attente d’une revue humaine et d’une publication manuelle.
- Si Auto-republish est activé, Agent peut publier le correctif validé sans cette étape de revue.
- La documentation de Monitoring Agent indique que les alertes résolues restent dans le tableau pendant 30 jours. Replit envoie par ailleurs les e-mails aux destinataires selon leurs préférences de gravité.
Une alerte ne garantit pas qu’une réparation soit possible. Replit cite les pannes de services externes parmi les situations qui peuvent nécessiter une intervention en dehors de l’application. La documentation de supervision précise également que les journaux de déploiement sont conservés pendant 30 jours.
La détection couvre moins de signaux que ceux qu’Agent peut interroger
Les alertes automatiques surveillent seulement trois familles de signaux : les journaux d’erreurs applicatives, les erreurs HTTP et la latence des requêtes. Elles ne couvrent donc pas toutes les conditions susceptibles de provoquer une panne.
À la demande, Agent peut interroger un ensemble de données plus large, selon le type de déploiement et le fournisseur cloud : nombre de requêtes, disponibilité, volumes d’erreurs 4xx et 5xx, latence par endpoint, latence moyenne et p50/p95/p99, CPU, mémoire, instances actives, latence au démarrage, disponibilité, disque, trafic réseau sortant et journaux d’exécution filtrés par révision. Replit ne publie pas, sur la page Monitoring Agent, les seuils d’alerte, les intervalles d’interrogation, la durée de conservation de toutes les métriques ni de SLA de disponibilité pour Monitoring Agent.
Cette différence compte lorsqu’un incident vient de la profondeur d’une file d’attente, de timeouts chez un tiers, d’une corruption de données, d’une dépendance régionale ou d’un invariant métier. Agent peut examiner davantage de données lorsqu’on le lui demande, mais ses déclencheurs automatiques ne constituent pas un système d’observabilité complet.
« Validé » ne signifie pas qu’un garde-fou de production est défini
Replit indique que Monitoring Agent valide un correctif avant que celui-ci puisse être pris en compte par Auto-republish. La documentation ne précise toutefois pas quels tests sont exécutés, si la validation s’appuie sur des données proches de la production, quel seuil de réussite s’applique ni si une publication doit rester saine pendant une durée définie.
On ne trouve pas non plus de pourcentage de canary documenté, de déploiement progressif, d’arrêt automatique après plusieurs réparations ou de rollback automatique lorsque le taux d’erreur de production remonte. Ces contrôles manquants sont déterminants pour les applications à haut risque : un test peut réussir alors qu’une nouvelle régression se trouve en dehors du parcours testé.
Le jour du lancement, un utilisateur, @_ItsmeJJ_9, a posé directement la question centrale :
« Quand Monitoring Agent corrige un problème et le publie automatiquement, comment s’assure-t-il que le correctif est sûr, et que se passe-t-il s’il aggrave la situation ? » — @_ItsmeJJ_9 sur X
La fonctionnalité n’avait qu’un jour au moment de la préparation de cette analyse. La recommandation repose donc sur les contrôles documentés, et non sur un historique de terrain établi sur la durée.
Les trois interrupteurs constituent le véritable modèle de sécurité
| Réglage | Détecte les problèmes | Modifie le code | Modifie la production en ligne |
|---|---|---|---|
| Alertes Monitoring | Oui | Non | Non |
| Auto-fix | Oui | Oui | Non |
| Auto-republish | Oui | Via Auto-fix | Oui |
Auto-republish nécessite Auto-fix. Désactiver les e-mails ne désactive ni Monitoring ni Auto-fix, et la supervision doit être configurée séparément pour chaque application publiée. Ces détails permettent d’adapter les autorisations aux conséquences potentielles d’une mauvaise modification.
Pourquoi Auto-fix est le meilleur réglage par défaut
Auto-fix peut réduire le temps consacré à rassembler les journaux, les métriques, le contexte du code et un correctif candidat. En laissant Auto-republish désactivé, on conserve entre les mains d’une personne la revue du diff proposé et la décision de publication.
Ce réglage intermédiaire s’intègre à une procédure classique de validation. L’opérateur peut examiner les fichiers modifiés, vérifier que le correctif répond bien au problème observé, lancer les tests propres à l’application, contrôler les migrations, puis publier volontairement. Les instructions de configuration de Replit prennent explicitement en charge ce mode de fonctionnement.
À partir de quand Auto-republish devient risqué
Auto-republish transforme un outil de diagnostic en acteur du processus de mise en production. La fonctionnalité devient dangereuse dès lors qu’une mauvaise version peut débiter de l’argent, modifier l’identité ou les autorisations, écrire un état externe irréversible ou imposer une récupération coordonnée de la base de données.
Replit cite explicitement les migrations et les opérations sur les index parmi les opérations risquées. Sa documentation n’indique pas que Monitoring Agent bloque les modifications du code de facturation ou d’authentification, limite le nombre de déploiements autonomes par incident ou exige une approbation pour certains répertoires ou types de changements.
Un utilisateur a résumé très concrètement le contrôle de politique qui fait défaut :
« J’activerais Auto-republish si je pouvais le plafonner : par exemple quelques déploiements automatiques par nuit au maximum, et toute modification touchant à la facturation ou à l’authentification devrait attendre ma validation. » — @_AdityaSriv sur X
Pour des applications internes à faible impact, ce risque peut être acceptable. Pour des systèmes sensibles au chiffre d’affaires ou soumis à une réglementation, une validation sans mécanisme documenté de confinement des mises en production ne suffit pas.
La tarification transforme chaque incident en compteur ouvert
Les exécutions de Monitoring Agent peuvent générer des frais liés à l’utilisation d’Agent, mais Replit ne publie aucun tarif spécifique à Monitoring par alerte, investigation, correctif ou republication. Le coût dépend du travail effectué par Agent, plutôt que d’un forfait fixe de réponse aux incidents.
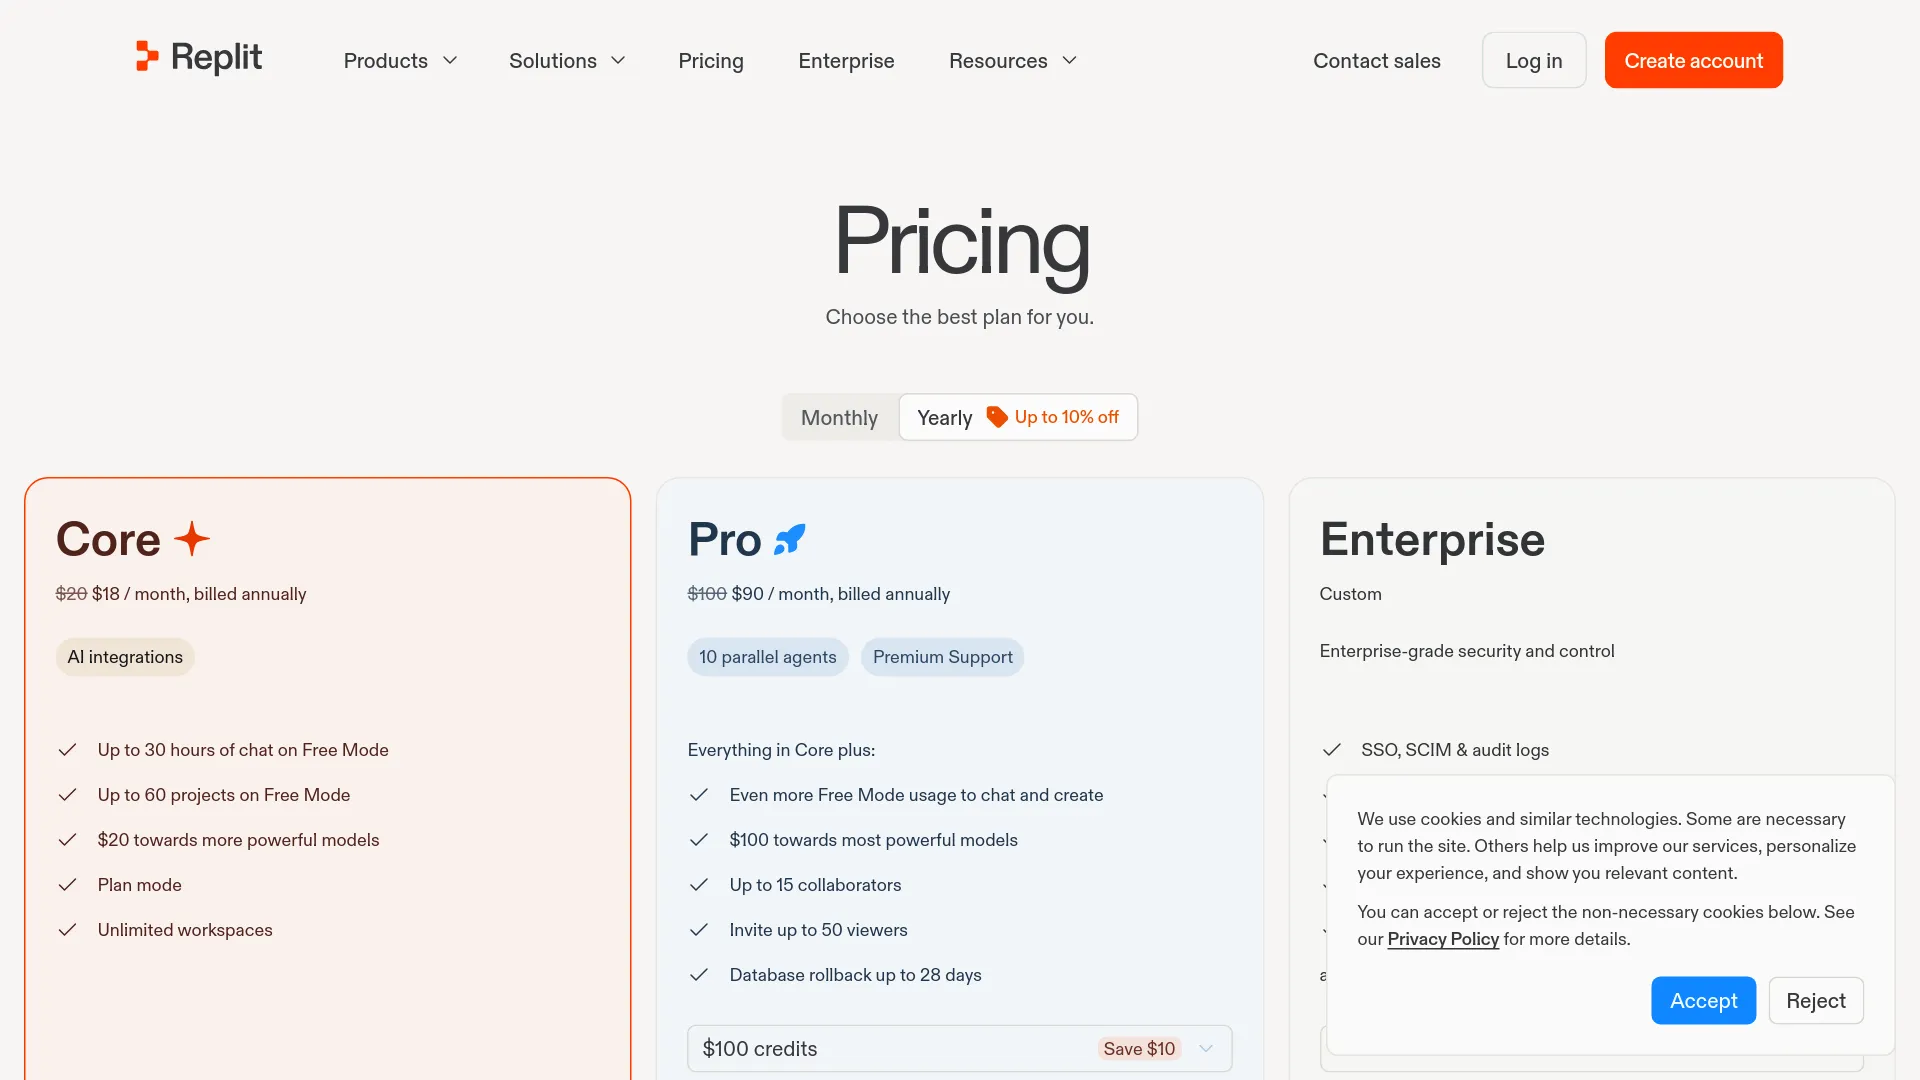
| Offre | Prix mensuel | Équivalent avec facturation annuelle | Valeur incluse affichée | Contrôle pertinent |
|---|---|---|---|---|
| Core | $20/month | $18/month | $20 pour des modèles plus puissants | 1 tâche d’arrière-plan active dans la documentation de l’offre |
| Pro | $100/month | $90/month | $100 pour des modèles plus puissants | 10 tâches parallèles et rollback de base de données sur 28 jours |
| Enterprise | Custom | Custom | Non public | SSO/SAML, confidentialité avancée, instance dédiée |
Ces chiffres proviennent de la page tarifaire actuelle de Replit. Les crédits d’abonnement peuvent aussi couvrir la publication, le stockage, les bases de données, le transfert réseau et les intégrations d’IA. L’allocation affichée ne doit donc pas être considérée comme un budget réservé à Monitoring Agent.
La documentation de Monitoring Agent ne fournit ni tarif par exécution, ni coût maximal d’une investigation, ni nombre d’actions automatiques incluses. Un budget de production doit donc prévoir une consommation variable, en plus du coût sous-jacent de l’application publiée.
Ce que les contrôles de dépenses garantissent — et ce qu’ils ne garantissent pas
La documentation de gestion des dépenses de Replit permet de définir des limites d’utilisation du compte ainsi qu’une limite d’arrêt des services. Atteindre une limite bloque ou suspend les services facturés selon l’usage jusqu’au cycle suivant, ou jusqu’à ce que la limite soit relevée. Replit décrit l’utilisation comme étant suivie presque en temps réel, tandis que sa documentation sur la facturation de l’IA précise que les données du tableau de bord peuvent mettre jusqu’à 30 minutes à apparaître.
Il s’agit de freins financiers appliqués au niveau du compte, pas d’une politique de gestion des incidents. Replit ne documente aucun contrôle Monitoring Agent du type « dépenser au maximum $5 », « tenter un seul correctif » ou « s’arrêter après 15 minutes » pour chaque alerte. Une limite d’arrêt des services peut également interrompre des services, ce qui peut être particulièrement malvenu pendant une panne.
Définissez une limite de compte prudente, mais ne la confondez pas avec un budget borné de remédiation autonome.
Le rollback est une procédure de récupération, pas un filet de sécurité
Un checkpoint Replit peut restaurer les fichiers du projet, les packages, la configuration, le contexte d’Agent et, en option, l’état de la base de données. La documentation des checkpoints précise également que chaque checkpoint crée un commit Git et qu’il est possible de naviguer vers l’avant ou vers l’arrière.
Cela ne correspond pas à un rollback automatique de la production. L’aide actuelle de Replit pour les projets indique qu’une application publiée ne peut pas être restaurée directement vers une version précédemment déployée. La procédure prise en charge consiste à restaurer le projet vers un checkpoint antérieur, puis à republier cet état. La récupération de la base de données de production est une opération distincte, et la restauration de la base via un checkpoint est facultative, pas automatique.
Un rollback ne peut pas non plus annuler un e-mail déjà envoyé, un paiement capturé par un prestataire externe, un webhook déjà distribué ou un appel irréversible à une API tierce. Ces effets de bord nécessitent de l’idempotence au niveau de l’application et des actions compensatoires.
Réalisez cet exercice de rollback avant d’activer l’automatisation
- Notez la révision actuellement déployée et identifiez le checkpoint qui lui correspond.
- Créez une mauvaise version contrôlée dans une application hors production et vérifiez que Monitoring détecte bien le signal attendu.
- Restaurez le checkpoint du projet sans sélectionner de restauration de base de données ; vérifiez le code, les références aux secrets, la configuration de build et le contexte d’Agent.
- Testez séparément la procédure de récupération de la base de données de production et documentez la personne habilitée à l’autoriser.
- Republiez le projet restauré et mesurez le temps nécessaire pour que les contrôles de santé et les tests fonctionnels métier réussissent.
- Vérifiez séparément les effets de bord externes, notamment les paiements, les e-mails, les webhooks et les tâches en file d’attente.
- Désignez un responsable de l’escalade pour les incidents qu’Agent ne peut pas corriger ou pour les problèmes de publication côté plateforme.
Si l’équipe ne peut pas mener cet exercice à bien, Auto-republish doit rester désactivé. Un bouton de rollback jamais testé ne constitue pas un plan de réponse aux incidents.
Une politique d’adoption en production cohérente avec les faits
Utilisez les garde-fous supplémentaires suivants en complément des réglages par type de charge présentés au début de cette analyse :
| Exigence | Application interne à faible impact | Application destinée aux clients | Application critique ou réglementée |
|---|---|---|---|
| Approbation humaine | Acceptable après coup | Avant publication | Avant publication, avec contrôle des changements |
| Exercice de récupération | Avant Auto-republish | Avant Auto-fix | Obligatoire, avec tests de la base de données et des effets de bord |
| Observabilité externe | Facultative | Recommandée | Obligatoire |
Avant d’assouplir cette politique, attendez cinq avancées : des critères de validation publiés, des plafonds de coût et de tentatives par incident, un déploiement canary ou progressif, des contrôles de santé automatiques après publication et un rollback automatique précisant clairement le traitement du code, de l’état du déploiement, des bases de données et des effets de bord externes.
FAQ sur Replit Monitoring Agent
Replit Monitoring Agent est-il disponible maintenant ?
Oui. Replit a officiellement annoncé Monitoring Agent le 22 octobre 2026 et publié une documentation de configuration pour les alertes Monitoring, Auto-fix et Auto-republish.
Auto-fix publie-t-il automatiquement les modifications ?
Non. Auto-fix peut enquêter, modifier le code et valider un correctif proposé, mais la publication en production reste manuelle tant qu’Auto-republish n’est pas activé.
Auto-republish est-il sûr pour la production ?
Auto-republish est expérimental. Il peut convenir à des applications à faible impact disposant d’une procédure de récupération testée, mais les systèmes de production critiques ne bénéficient pas encore de déploiement canary documenté, de rollback automatique, de seuils de validation ni de contrôles d’approbation pour les parcours sensibles.
Combien coûte Monitoring Agent ?
Replit indique que les exécutions de Monitoring Agent peuvent entraîner des frais d’utilisation d’Agent, mais ne publie aucun tarif fixe par incident. Core coûte actuellement $20 monthly et Pro $100 monthly, avant la consommation dépassant les crédits inclus et les autres frais liés au cloud.
Monitoring Agent peut-il restaurer automatiquement un mauvais déploiement ?
Aucun rollback automatique n’est documenté. La récupération actuelle nécessite de restaurer un checkpoint antérieur du projet, puis de le republier. La récupération de la base de données de production est traitée séparément.
Quelles données de production Monitoring Agent peut-il examiner ?
Selon le type de déploiement et le fournisseur, Agent peut examiner les métriques de production, les journaux d’exécution, le code source, le trafic HTTP, la latence des endpoints, le CPU, la mémoire, les instances, le disque, le réseau et les données d’erreurs applicatives. Les alertes automatiques ne se déclenchent toutefois qu’à partir des journaux d’erreurs applicatives, des erreurs HTTP et de la latence des requêtes.