 AIREITER
Una descripción cinematográfica de una sola línea deja demasiados huecos para que el modelo los rellene por su cuenta. Si no especificas la cámara, las guías del proveedor avisan de que es fácil acabar con un plano fijo; si omites los campos de sonido, pueden aparecer voces no deseadas. Crear prompts para MiniMax H3 se parece más a redactar un guion técnico compacto: la documentación oficial exige un formato fijo de tres campos, marcas de tiempo para los planos, identificadores de hablante estables y dos campos de sonido independientes. Además, el guion debe caber en un límite aproximado de 7.000 caracteres —según el proveedor— y cada clip tiene un máximo de 15 segundos.
Dos guías y cuatro modos: elige primero el formato de tu prompt para H3
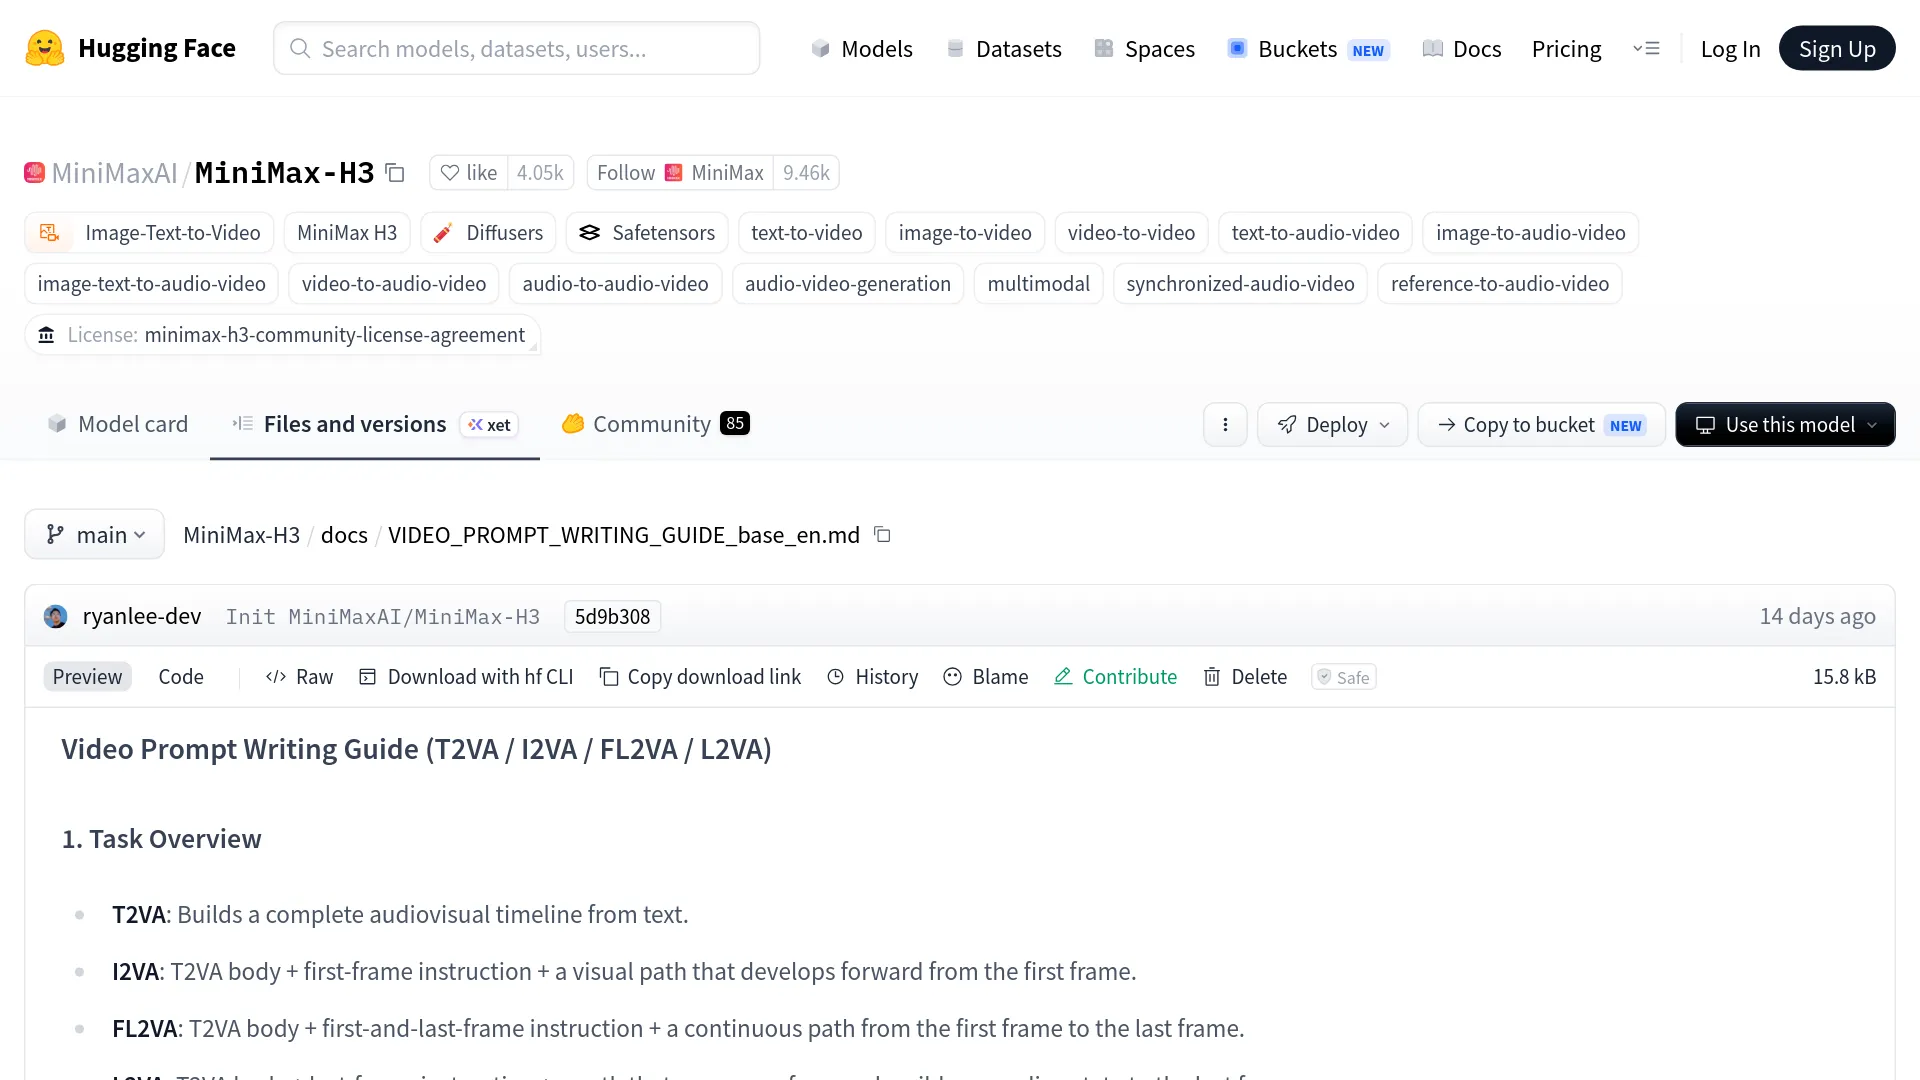
MiniMax publica dos guías distintas para escribir prompts dentro del repositorio de MiniMax-H3 en Hugging Face, y cada una está pensada para un flujo de trabajo diferente. La guía base cubre cuatro tareas de generación sin referencias subidas; la guía de referencias entra en juego cuando interviene cualquier imagen, vídeo o clip de audio cargado. Los cuatro casos de la guía base son estos:
| Modo | Entrada | Instrucción de alineación necesaria en el prompt |
|---|---|---|
| T2VA | Solo texto | Ninguna; empieza directamente con los campos principales |
| I2VA | Una imagen del primer fotograma | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | Primer y último fotograma | Picture 1 en 0.00 segundos y Picture 2 exactamente al final |
| L2VA | Una imagen del último fotograma | Picture 1 se alinea con el final del vídeo y con el plano final |
Las dos guías terminan con ejemplos completos, y la publicación de lanzamiento de MiniMax presenta el modelo de la misma manera: no eliges una tarea en un menú, sino que describes las relaciones entre las entradas de texto, imagen, vídeo y audio. Los servicios alojados lo simplifican en tres flujos —minimax/h3/text-to-video, image-to-video y reference-to-video en fal—, pero la estructura del prompt sigue siendo la misma.
El prompt base, línea a línea
En el modo base, un prompt de MiniMax H3 tiene exactamente tres campos obligatorios después de la instrucción de alineación, separados por una línea en blanco. Esta es la estructura:
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptioncontiene la línea temporal completa: estilo visual, composición, acciones, cambios de plano, hablantes, diálogos y sonido diegético; es decir, todo lo que se ve o se escucha.overall_soundscaperesume el ambiente y los sonidos físicos en 1–4 frases, dentro de un único párrafo y sin diálogos.non_diegetic_musicdescribe la música que solo escucha el público en 1–3 frases, o usaN/Asi no quieres incluirla.
Este ejemplo completo está adaptado del caso T2VA de la guía oficial, ambientado en una panadería antes del amanecer:
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
Esto es lo que controla cada línea según las reglas oficiales:
| Elemento del prompt | Qué controla | Regla |
|---|---|---|
[Shot 1] Live-action, cinematic. | Estilo global | La etiqueta de estilo abre el plano 1; algunos ejemplos de la lista de la guía son Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor y vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | Identidad del hablante | Los atributos de identidad van antes del identificador, que debe mantenerse estable entre planos |
The camera pushes in with small amplitude at slow speed | Cámara | Tipo de movimiento + amplitud + velocidad, redactados como una acción natural |
<d>[English] First batch of the day.</d> | Diálogo | Etiqueta de idioma y únicamente las palabras exactas, de forma literal y sin traducir |
At 00:05.000, the camera cuts to... | Momento del corte | Debe avanzar estrictamente; [Shot 1] nunca lleva marca de tiempo |
<scenetrans> continuing seamlessly across the cut | Continuidad del audio | Indica que un diálogo atraviesa un corte y debe aparecer en los dos puntos de conexión |
Planos, cortes y movimientos de cámara
La sintaxis de los planos en MiniMax H3 depende de su posición: [Shot 1] nunca lleva marca de tiempo, y todos los planos posteriores comienzan con una hora de corte estrictamente creciente, como At 00:03.500,. La documentación recomienda fórmulas breves para los cortes, como «the camera cuts to», «the shot transitions to» o «the shot switches to». Los fundidos cruzados, desvanecimientos y barridos solo deben aparecer si los pides explícitamente. Si únicamente cambia un poco el encuadre, la guía aconseja usar movimiento de cámara en lugar de un corte: un corte debería introducir información nueva sobre el sujeto, el espacio, el estado o el momento.
Describe el movimiento de cámara como una acción natural en inglés y, como máximo, con tres dimensiones: tipo de movimiento, amplitud y velocidad.
| Dimensión | Expresiones admitidas |
|---|---|
| Tipo de movimiento | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| Amplitud | «with small amplitude», «with large amplitude» |
| Velocidad | «at slow speed», «at fast speed» |
Por convención, la amplitud media y la velocidad normal se omiten. También conviene distinguir entre ambos movimientos: «Zoom In» cambia la distancia focal desde una posición fija, mientras que «Push In» desplaza físicamente la cámara hacia delante. La guía mantiene esta diferencia de forma deliberada.
Diálogos e identificadores de hablante
Cada personaje que habla en un prompt de MiniMax H3 recibe un identificador estable —(S1), (S2) o uno compuesto como (S1,S2) para el habla sincronizada— y debe conservarlo en todos los planos. Los personajes que no hablan no llevan identificador. En su primera aparición, define suficientes rasgos para facilitar una generación estable: si está dentro o fuera de plano, rango de edad, género, tono, timbre, velocidad y acento de la voz.
La sintaxis exacta para una línea es esta:
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
Cuatro reglas documentadas evitan los fallos más habituales. La identidad, la acción y la forma de hablar se quedan fuera de <d>; dentro solo van la etiqueta de idioma y las palabras exactas, con la puntuación intacta. Para una voz en off hay que usar literalmente la frase «says in an off-screen voiceover» y añadir justo después que los labios del personaje en pantalla permanecen cerrados. Si el diálogo cruza un corte, coloca <scenetrans> en los dos puntos de conexión junto con una frase de continuidad como «continues seamlessly across the cut» o «carries over from the previous shot». Si el vídeo termina mientras alguien está hablando, usa <cutoff>.
Las comillas tienen una única función reservada: cualquier texto visible en el vídeo —pancartas, carteles, etiquetas, neones o subtítulos— debe aparecer entre comillas dobles inglesas, literalmente y sin traducir. Según la documentación, poner el diálogo hablado entre comillas hace que H3 lo renderice como subtítulos incrustados en lugar de interpretarlo como voz.
Los dos campos de sonido
La publicación de lanzamiento de MiniMax afirma que todo el audio de H3 se genera de forma nativa en estéreo junto con el vídeo. Por eso el sonido tiene dos campos propios, en lugar de quedar reducido a adjetivos dentro de la descripción. overall_soundscape cubre el ambiente y los sonidos físicos —viento, lluvia, tráfico, pasos, movimiento de la ropa, impactos, respiración o risas— en 1–4 frases. N/A se reserva para pedir silencio absoluto. non_diegetic_music describe la música que los personajes no pueden oír, especificando instrumentos, velocidad, ritmo y cambios dinámicos. La guía desaconseja expresiones abstractas como «épico» o «emocional», y recomienda N/A cuando no quieres música.
El sonido diegético, como un personaje cantando, una radio dentro de la escena o un músico callejero, no debe ir en ninguno de esos dos campos. Se incluye en integrated_multimodal_description, donde se desarrolla la línea temporal. No es una distinción meramente estética: el tutorial de APIMODELS señala que los resultados fiables requieren restricciones de sonido explícitas, y dejar sin especificar non_diegetic_music puede hacer que aparezca música que nunca pediste.
Prompts con referencias: etiquetas y elementos que deben conservarse
La guía de referencias se utiliza cuando los recursos subidos dirigen la generación. Exige seis secciones en un orden fijo: subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape y non_diegetic_music. Para tareas de generación, el cuerpo de detailed_description suele tener entre 350 y 500 palabras en inglés. En prompts con mucho diálogo, debe caber toda la línea temporal hablada aunque eso obligue a salirse de ese recuento.
El trabajo se organiza con cuatro tipos de etiquetas:
| Etiqueta | Uso |
|---|---|
<Subject N> | Contenido visible que realmente se utilizará en el resultado: una persona, producto, escena, vestuario, estilo o acción abstraída de cualquier recurso |
<Picture N> | Imagen que funciona como ancla concreta de un fotograma: primer fotograma, fotograma clave, último fotograma o referencia de composición |
<Video N> | Relación con un vídeo completo: fuente de edición, punto de continuación, estructura de cámara o cortes y ritmo |
<Audio N> | Señal de audio que se copia o se toma como referencia: timbre de voz, letra, ritmo o efectos de sonido |
La numeración es independiente para cada tipo. Por eso un vídeo subido puede ser <Video 1> y su pista de audio <Audio 2>. Si un sujeto habla, combina la etiqueta con el identificador: <Subject 3> (S1).
La sección summary empieza con un prefijo entre corchetes que indica la tarea, como [reference generation] o [video editing + audio reuse]. En una edición de vídeo, además, debe comenzar con «The target video is an edited version of <Video 1>.» Después, retention_analysis asigna un marcador a cada etiqueta. Para la imagen se usan fully_preserved, partially_preserved, attribute_transfer o weak_reference; para el audio, fully_copy, partially_copy, reference o weak_reference. Así le indicas a H3, por ejemplo, que debe conservar el rostro aunque pueda cambiar la ropa.
Esta es una estructura mínima para el modo de referencias, en el orden documentado:
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
Cuando H3 falla: tabla de síntomas y soluciones
| Síntoma | Causa probable en el prompt | Solución |
|---|---|---|
| Galimatías o «habla de los Sims» inventada | Diálogo sin estructura, ausencia de identificadores de hablante o personajes que no hablan pero no están descritos | Añade identificadores (S1)/(S2), encierra las palabras exactas en <d>[Language] ...</d> y describe explícitamente como silenciosos a los personajes que no hablan |
| Subtítulos incrustados en los diálogos | Las palabras habladas están entre comillas | Reserva las comillas para el texto visible en pantalla y mueve el diálogo a las etiquetas <d> |
| El diálogo se asigna al personaje equivocado | El identificador no está vinculado a una persona descrita | Define los atributos del hablante —edad, presencia en pantalla y voz— en su primera aparición y mantén el identificador en todos los planos |
| Música que nunca pediste | non_diegetic_music se ha dejado ambiguo o se ha omitido | Escribe non_diegetic_music: N/A cuando no quieras música; los hilos de la comunidad consideran que esta solución elimina el audio no deseado |
| Cortes no previstos | Hay cambios de escena implícitos sin marcas de tiempo | Usa [Shot N] At 00:03.500 con frases de corte explícitas; para un plano secuencia, pide que no haya cortes |
| El rostro, la ropa o el producto cambian | No se ha declarado el papel de la referencia | Añade en retention_analysis una línea con fully_preserved para esa etiqueta y repite la etiqueta cada vez que aparezca |
Las filas sobre el galimatías y los subtítulos proceden directamente de las reglas de sintaxis oficiales. Los hilos de la comunidad en r/StableDiffusion informan por separado de los mismos resultados en la práctica, incluida non_diegetic_music: N/A como una de las soluciones más citadas para eliminar el audio no deseado.
Límites y coste de probar un prompt
El margen de generación importa porque la longitud del prompt es limitada y cada iteración se factura. Estos son los límites documentados en la API oficial y en los proveedores alojados:
| Parámetro | Valor | Nota |
|---|---|---|
| Duración del clip | Hasta 15 s, en segundos enteros | El mínimo es de 5 s en los endpoints de fal/EvoLink; algunos documentos de la API V2 indican 4 s |
| Resolución | 768p y 2K, 24 FPS | Según MiniMax, 2K es la resolución de salida predeterminada |
| Archivos de referencia | Hasta 9 imágenes, 3 vídeos y 3 audios | 12 archivos en total; el audio nunca puede ser la única referencia |
| Longitud del prompt | ~7.000 caracteres | Documentos de fal y de la API V2; APIMODELS indica 20.480: compruébalo con tu proveedor |
| Relaciones de aspecto | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptive | La conversión de imagen a vídeo sigue la proporción de la imagen de entrada |
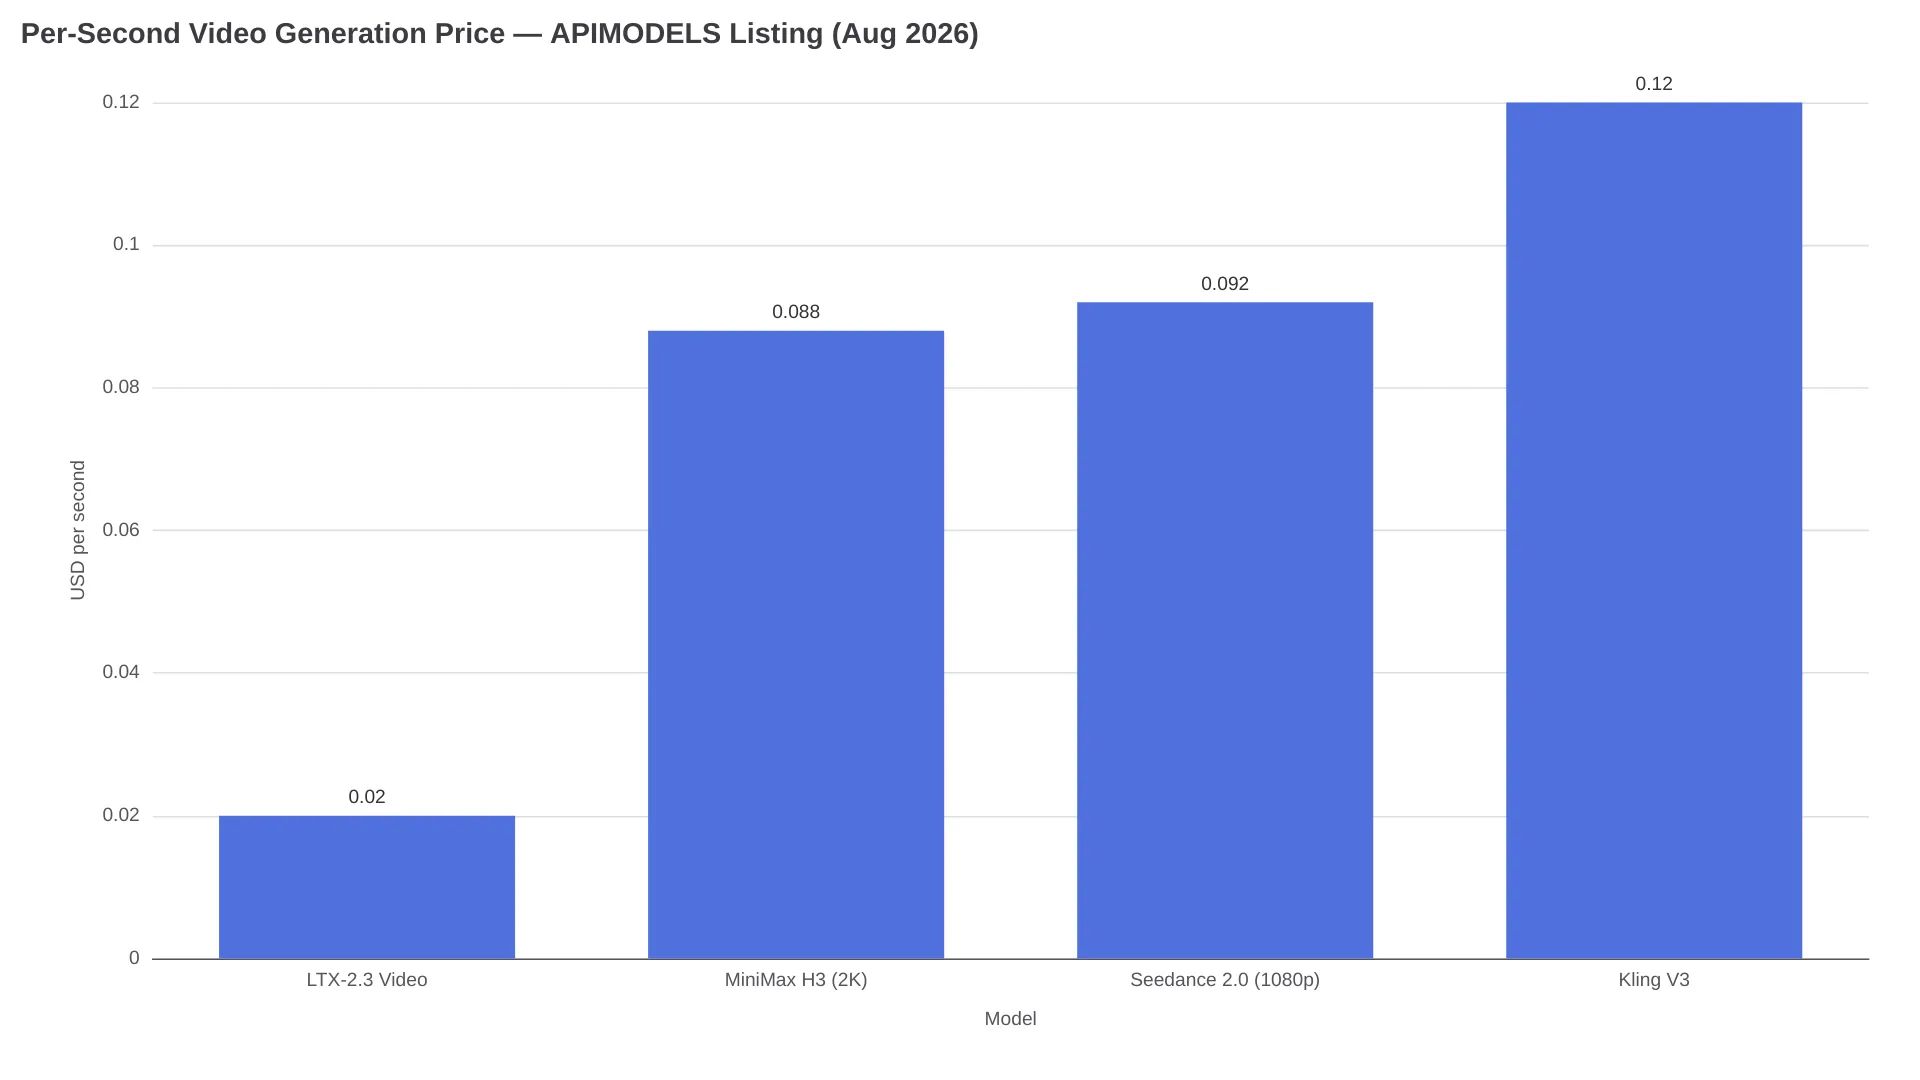
El precio cambia según el proveedor, así que conviene tratar estas cifras como instantáneas fechadas y no como tarifas universales. En fal, una generación en 2K costaba $0.26 por segundo según una instantánea de precios del 1 de agosto ($1.30 por 5 segundos y $3.90 por 15), con las cinco primeras imágenes de referencia gratis y las adicionales a $0.08 cada una. En APIMODELS, H3 funciona a $0.088 por segundo ($1.32 por un clip de 15 segundos) y solo cobra las solicitudes que terminan correctamente. Como referencia, estos son los precios por segundo de ese mismo marketplace:
La verdadera partida presupuestaria está en los reintentos: un prompt estructurado de diálogo de 15 segundos que sale bien al segundo intento cuesta $2.64 en APIMODELS, mientras que uno sin estructura que necesita cinco intentos para conseguir una toma utilizable asciende a $6.60. Para iterar prompts contra un endpoint alojado de H3, la página de API de MiniMax H3 de AIReiter ejecuta el modelo con el precio vigente indicado en la propia página.
Plantillas listas para copiar y pegar
Dos estructuras base cubren la mayoría de los trabajos cortos. Completa los corchetes y conserva exactamente los nombres de los campos y las líneas en blanco:
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/ASi prefieres prompts probados en lugar de plantillas vacías, estas tres bibliotecas conservan los enlaces originales. ecomimagelab/awesome-minimax-h3-prompts: 58 prompts —39 oficiales y 19 probados por la comunidad—, cada uno con su vídeo de resultado descargable bajo la regla «Sin vídeo, no hay entrada». imagineVid/Awesome-minimax-h3-prompts-and-skills: 28 casos verificados en seis flujos de trabajo, desde la continuidad de identidad con omni-reference hasta el diálogo con audio nativo. La galería de APIMODELS: 226 prompts navegables por caso de uso, con clips adjuntos; su regla de una línea es «Las referencias llevan la identidad; el prompt lleva la acción».
También hay dos atajos para redactar los propios guiones. Usuarios de Reddit informan de buenos resultados al pegar una guía oficial en un LLM e indicar el modo objetivo («rewrite this idea as T2VA using the base guide»). Y la extensión para ComfyUI MiniMax H3 Prompt Writer v0.3 construye el formato estructurado dentro de un flujo de nodos.
Preguntas frecuentes
¿Cuál es la diferencia entre las guías de prompts base y de referencias de MiniMax H3?
La guía base cubre cuatro modos sin referencias —T2VA, I2VA, FL2VA y L2VA— construidos sobre tres campos principales. La guía de referencias añade seis secciones obligatorias y las etiquetas <Subject>/<Picture>/<Video>/<Audio> cuando las imágenes, vídeos o audios subidos dirigen la generación.
¿Cómo etiqueto a los hablantes en un prompt de MiniMax H3?
Asigna identificadores estables (S1) y (S2) siguiendo el orden del primer evento vocal, conserva el mismo identificador entre planos, usa (S1,S2) para el habla simultánea y coloca dentro de las etiquetas <d> únicamente la etiqueta de idioma y las palabras exactas.
¿Cómo evito el audio ininteligible en MiniMax H3?
Estructura el diálogo con identificadores de hablante y etiquetas <d> literales, describe como silenciosos a los personajes que no hablan y establece non_diegetic_music: N/A cuando no quieras música. Son las soluciones documentadas y confirmadas por la comunidad.
¿El diálogo de MiniMax H3 debe ir entre comillas?
No. Las comillas están reservadas para el texto visible en el vídeo. El diálogo hablado debe ir en <d>[Language] ...</d>; de lo contrario, H3 puede convertirlo en subtítulos en pantalla.
¿Qué longitud puede tener un prompt de MiniMax H3?
Alrededor de 7.000 caracteres en fal y en la documentación oficial de la API V2, aunque APIMODELS indica 20.480. Comprueba el límite de tu endpoint concreto antes de redactar un guion de 10.000 caracteres.
Lo que la sintaxis todavía no puede solucionar
Una buena estructura aumenta la probabilidad de acertar, pero no vuelve determinista la generación. La fidelidad exacta de la identidad, los logotipos y los productos sigue siendo probabilística: los wrappers de API desarrollados por la comunidad se niegan explícitamente a prometer consistencia fotograma a fotograma, y los ejemplos más sólidos de las bibliotecas de prompts fuerzan la identidad con bloques de restricciones extensos, no mediante garantías cuantificadas. Las <tags> insertadas para sonidos no verbales son experimentales y comunitarias, y su resultado cambia según la generación. Evalúa el resultado por el coste de cada segundo aprobado, no por solicitud, y mantén abiertas en una pestaña las guías oficiales base y de referencias mientras escribes.
Para seguir leyendo: el análisis del lanzamiento de MiniMax H3 explica qué es el modelo, y MiniMax H3 frente a LTX 2.3 lo compara con la alternativa más barata por segundo.