 AIREITER
La búsqueda suele hacerse con «3-5», pero los identificadores de modelo de Google son gemini-3.5-transcribe y gemini-3.5-transcribe-live. La API existe y cuesta poco, pero la decisión depende de si necesitas prosa limpia, palabras trazables o subtítulos en directo.
El veredicto de Gemini 3.5 Transcribe API, de un vistazo
Gemini 3.5 Transcribe merece una prueba inicial con archivos grabados, dictado y experiencias breves de subtitulado en directo. No es una opción predeterminada segura para obtener una transcripción exacta ni para mantener un registro en directo de larga duración: Smart transcription edita el habla, las sesiones Live no incluyen etiquetas de hablantes ni tiempos por palabra y el servicio sigue en vista previa pública.
| Si necesitas… | Usa… | Conclusión del análisis |
|---|---|---|
| Una transcripción de una reunión, llamada o pódcast subido | gemini-3.5-transcribe | Úsalo; elige el modo literal si las palabras importan |
| Dictado limpio o notas de reunión fáciles de leer | Modelo grabado con Smart mode | Úsalo con revisión si aceptas la edición |
| Subtítulos mientras alguien habla | gemini-3.5-transcribe-live | Haz un prototipo para sesiones interactivas breves |
| Etiquetas de hablantes y tiempos por palabra | Modelo grabado con anotaciones literales | Úsalo con límites; 30 minutos y 3+ hablantes son funciones experimentales |
| Una fuente de verdad legal, médica, de cumplimiento o archivística | Pipeline literal con revisión humana | No lo uses como única fuente |
Este es un análisis de API basado en evidencias, no una prueba WER controlada. La guía de configuración y precios de Gemini 3.5 Transcribe API explica el flujo de las solicitudes; aquí nos centramos en lo que implican sus compromisos documentados después de completar la primera llamada.
En realidad, la familia de modelos ofrece dos contratos de API
gemini-3.5-transcribe procesa audio subido o pregrabado mediante la Interactions API, mientras que gemini-3.5-transcribe-live trabaja con audio en streaming a través de la Live API.
Transcripción grabada: gemini-3.5-transcribe
La opción grabada es la más completa para crear transcripciones duraderas. Google documenta detección automática del idioma en más de 85 idiomas, vocabulario personalizado, salida Smart o literal, diarización de hablantes y marcas de tiempo por palabra en la documentación de transcripción de audio.
El límite habitual de audio es de hasta una hora. Si activas la diarización de hablantes o las marcas de tiempo por palabra, el límite baja a 30 minutos. Google considera experimental la atribución de tres o más hablantes, aunque la referencia del modelo enumera hasta ocho.
Esta ruta encaja bien con dictados, entrevistas y llamadas breves; las reuniones más largas que necesiten atribución y sincronización deberán dividirse y recomponerse desde la aplicación.
Transcripción en directo: gemini-3.5-transcribe-live
La ruta Live está pensada para subtítulos incrementales, no para replicar por WebSocket el comportamiento de la opción grabada. La documentación de transcripción en directo de Google describe eventos de transcripción provisionales y finales, detección automática del idioma, vocabulario personalizado, Smart mode y detección de actividad de voz automática, híbrida o manual.
Una sesión continua en directo dura 10 minutos; el streaming en directo no ofrece diarización de hablantes ni marcas de tiempo por palabra. Además, el audio debe ser PCM de 16 bits sin procesar, 16 kHz, mono y little-endian. Son límites adecuados para previsualizar subtítulos, pero obligan a gestionar reconexiones, unión de sesiones y texto provisional cuando se graban llamadas largas.
El equilibrio de funciones que define el análisis
El elemento diferencial de Gemini 3.5 Transcribe es su limpieza «inteligente», pero esa función cambia el significado de precisión. Un texto pulido puede resultar más útil para dictar, aunque sea menos apropiado como registro literal.
Smart mode edita; no es un registro de origen
Smart mode elimina muletillas, tartamudeos y comienzos fallidos; resuelve autocorrecciones habladas y da formato a la puntuación, los números, las listas y los párrafos. «Quedamos el martes, no, el miércoles» puede convertirse en «el miércoles» en lugar de conservar el comienzo corregido.
Eso resulta práctico para redactar un correo, una nota de voz o unas notas de reunión legibles. En cambio, es arriesgado cuando una vacilación, el error original o la secuencia exacta de palabras tiene importancia.
La guía oficial de transcripción marca claramente el límite: Smart mode no se puede combinar con la diarización de hablantes ni con las marcas de tiempo por palabra. La API obliga a elegir entre texto limpio y anotaciones trazables.
Conserva una transcripción literal como fuente de verdad y crea después una copia depurada con Smart mode o mediante otro proceso para los lectores. No intentes resolver esta incompatibilidad con un prompt: es una restricción del contrato de salida.
Las marcas de tiempo y las etiquetas de hablantes mejoran la trazabilidad, pero limitan la ruta
El audio grabado puede devolver anotaciones word_info con el texto de cada palabra, sus desplazamientos y los identificadores de hablante cuando se configura el modo literal. Estas anotaciones sirven para subtítulos, reproducción con búsqueda por posición, cálculos de duración por hablante y revisión de evidencias.
| Requisito | Ruta grabada | Ruta Live |
|---|---|---|
| Diarización de hablantes | Compatible; hasta 8 documentados, 3+ experimental | No compatible |
| Marcas de tiempo por palabra | Compatible | No compatible |
| Salida Smart con anotaciones | No compatible | No compatible con anotaciones por palabra |
| Límite de duración | 1 hora en condiciones normales; 30 minutos con diarización o marcas de tiempo por palabra | 10 minutos por sesión continua |
| Advertencia sobre precisión | Google avisa de que las marcas de tiempo por palabra pueden reducir la precisión | El texto provisional puede cambiar antes de confirmarse |
Por tanto, decir que «admite marcas de tiempo» ofrece una visión incompleta de la compra. La función existe, pero reduce el límite de duración de los archivos y puede sacrificar precisión de reconocimiento. Prueba la atribución en la práctica; no trates el máximo documentado como una promesa de fiabilidad para reuniones más grandes.
Vocabulario personalizado y detección del idioma
Ambas rutas admiten detección automática del idioma y vocabulario personalizado. Google documenta más de 85 idiomas y cambios de idioma dentro de una misma conversación, y recomienda indicaciones como en-US cuando la aplicación ya conoce el idioma.
El vocabulario personalizado acepta hasta 1.000 términos, aunque las recomendaciones prácticas de Google indican que los resultados suelen ser mejores con hasta 100. Usa la lista para nombres de productos, siglas, nombres propios y términos técnicos, no para palabras corrientes.
Que una función esté «admitida» no significa que ofrezca la misma calidad con todos los acentos, dialectos, salas ruidosas y cambios de idioma a mitad de frase. Una de las primeras conversaciones en Reddit preguntaba específicamente si la ruta Live podía manejar idiomas mezclados; es un caso de prueba útil, no una prueba de que la función falle.
«Preferiría que retrasara un poco el vídeo y que los subtítulos quedaran sincronizados con las palabras habladas». — u/WaterObjective5107, Reddit
El comentario refleja un problema de producto en directo que el WER no mide: un subtítulo puede ser lingüísticamente correcto y, aun así, sentirse incorrecto si no está sincronizado con el vídeo.
Qué respaldan realmente las cifras de precisión
Las cifras publicadas por Google son alentadoras, pero proceden de varios contextos de evaluación, no de una puntuación universal de Gemini 3.5 Transcribe. Justifican un piloto serio, no sustituyen las pruebas con tus micrófonos, acentos, terminología y patrones de conversación.
| Contexto de evaluación | WER comunicado | Qué te indica |
|---|---|---|
| Artificial Analysis, streaming | 4.0% | Un promedio de streaming citado, no una puntuación de latencia o diarización |
| Artificial Analysis, sin streaming | 2.6% | Un promedio citado de audio grabado en sus condiciones de prueba |
| FLEURS, streaming | 5.50% | Un resultado multilingüe de streaming en una selección de idiomas y regiones |
| FLEURS, sin streaming | 5.04% | Un resultado multilingüe independiente para audio grabado |
Estas cifras aparecen en el anuncio de lanzamiento de Google, que también afirma una mejora del 70% en el tiempo hasta la transcripción final frente a Chirp 3. Es una afirmación de Google, no una prueba independiente de tu flujo de trabajo.
La diferencia entre el 2.6% y el 5.50% no es una contradicción. Cambian las rutas, los conjuntos de datos, la mezcla de idiomas y las condiciones de streaming. En lugar de apoyarte únicamente en el WER agregado, mide los errores que cuestan dinero: nombres, identificadores de pedido, fechas, cantidades, términos de producto y turnos de palabra.
Los primeros informes de la comunidad señalan como casos de prueba los cambios de idioma, la atribución de hablantes, el comportamiento de las marcas de tiempo y la finalización de grabaciones largas; un usuario de X describió un clip de 20 minutos cuya respuesta solo contenía cinco minutos. Son anécdotas orientativas, no hechos controlados sobre el producto. (Informe en X)
La fricción en producción que la guía de configuración no resuelve
Una subida correcta o una conexión WebSocket estable demuestran que el transporte funciona, no que el producto esté listo para producción. Los riesgos aparecen después de la demo: texto Live mutable, límites específicos de cada ruta, gestión de credenciales, estado de vista previa y política para conservar una transcripción fiable.
Los subtítulos en directo necesitan gestión de estado
Las respuestas Live cumplen dos funciones. interim_input_transcription es una hipótesis cambiante para la previsualización del subtítulo; input_transcription es el segmento final que se puede añadir al estado persistente de la transcripción.
Usa este modelo de estado:
- Sustituye el subtítulo visible con cada actualización provisional.
- Añade texto al registro confirmado solo cuando llegue una actualización final.
- Renueva la sesión o vuelve a conectarte antes del límite de 10 minutos.
- Une las sesiones con un marcador de límite explícito y lógica para eliminar duplicados.
- Mantén las acciones irreversibles alejadas del texto provisional.
Usa tokens efímeros en clientes web y móviles para no exponer una clave de API de larga duración en el código del frontend. Necesitarás un backend que genere y limite esos tokens; después, el audio puede fluir directamente del cliente a la Live API si esa arquitectura encaja con la aplicación. Supervisa los errores de conexión, el retraso hasta la confirmación y los segmentos duplicados.
Los flujos grabados necesitan una política de fuente de verdad
Elige primero el contrato de salida y después el modo. Usa Smart mode para obtener prosa legible; usa el modo literal cuando importen las palabras exactas, los hablantes o los desplazamientos temporales.
Almacena el resultado literal y sus anotaciones, y genera después una transcripción independiente y depurada para búsquedas, resúmenes o notas destinadas a clientes. Añade un paso de procesamiento, pero es más seguro que intentar reconstruir muletillas eliminadas o correcciones sobrescritas.
El estado de vista previa cambia la decisión de despliegue
Google anunció Gemini 3.5 Transcribe el 26 de agosto de 2026 como una familia de modelos en vista previa pública. La referencia de modelos de Google documenta sus capacidades y límites, pero el estado de vista previa obliga a volver a comprobar precios, cuotas, comportamiento y disponibilidad antes de migrar.
Empieza con un conjunto de evaluación pequeño y no sensible, acompañado de transcripciones de referencia guardadas. Mide por separado la precisión de entidades críticas, la atribución de hablantes, el retraso hasta la confirmación, el comportamiento tras una reconexión y la tasa de correcciones del revisor; fija por escrito los umbrales de aprobación antes de probar y pasa a la siguiente fase solo cuando se cumplan todos.
Precio frente al coste de una transcripción aceptada
Gemini 3.5 Transcribe resulta económico según las estimaciones mostradas, pero la facturación se basa en tokens y no en una tarifa plana garantizada por minuto. La tabla oficial de precios de Google indica aproximadamente $0.003 por minuto de entrada de audio grabado más $0.002 por la salida de texto, es decir, unos $0.005 por minuto en conjunto; Live cuesta aproximadamente $0.009 por minuto en conjunto.
| Ruta | Estimación de entrada de audio | Estimación de salida de texto | Estimación conjunta para planificar | 100 horas |
|---|---|---|---|---|
Grabada gemini-3.5-transcribe | $0.003/min | $0.002/min | $0.005/min | Aproximadamente $30 |
Live gemini-3.5-transcribe-live | Aproximadamente $0.005/min | Aproximadamente $0.004/min | $0.009/min | Aproximadamente $54 |
El primer presupuesto sería de unos $30 por 100 horas grabadas o $54 en directo, antes de contar reintentos, almacenamiento, conversión de audio, corrección humana y generación de resúmenes posterior. La longitud de la salida y el contexto añadido pueden cambiar la factura, así que registra el uso.
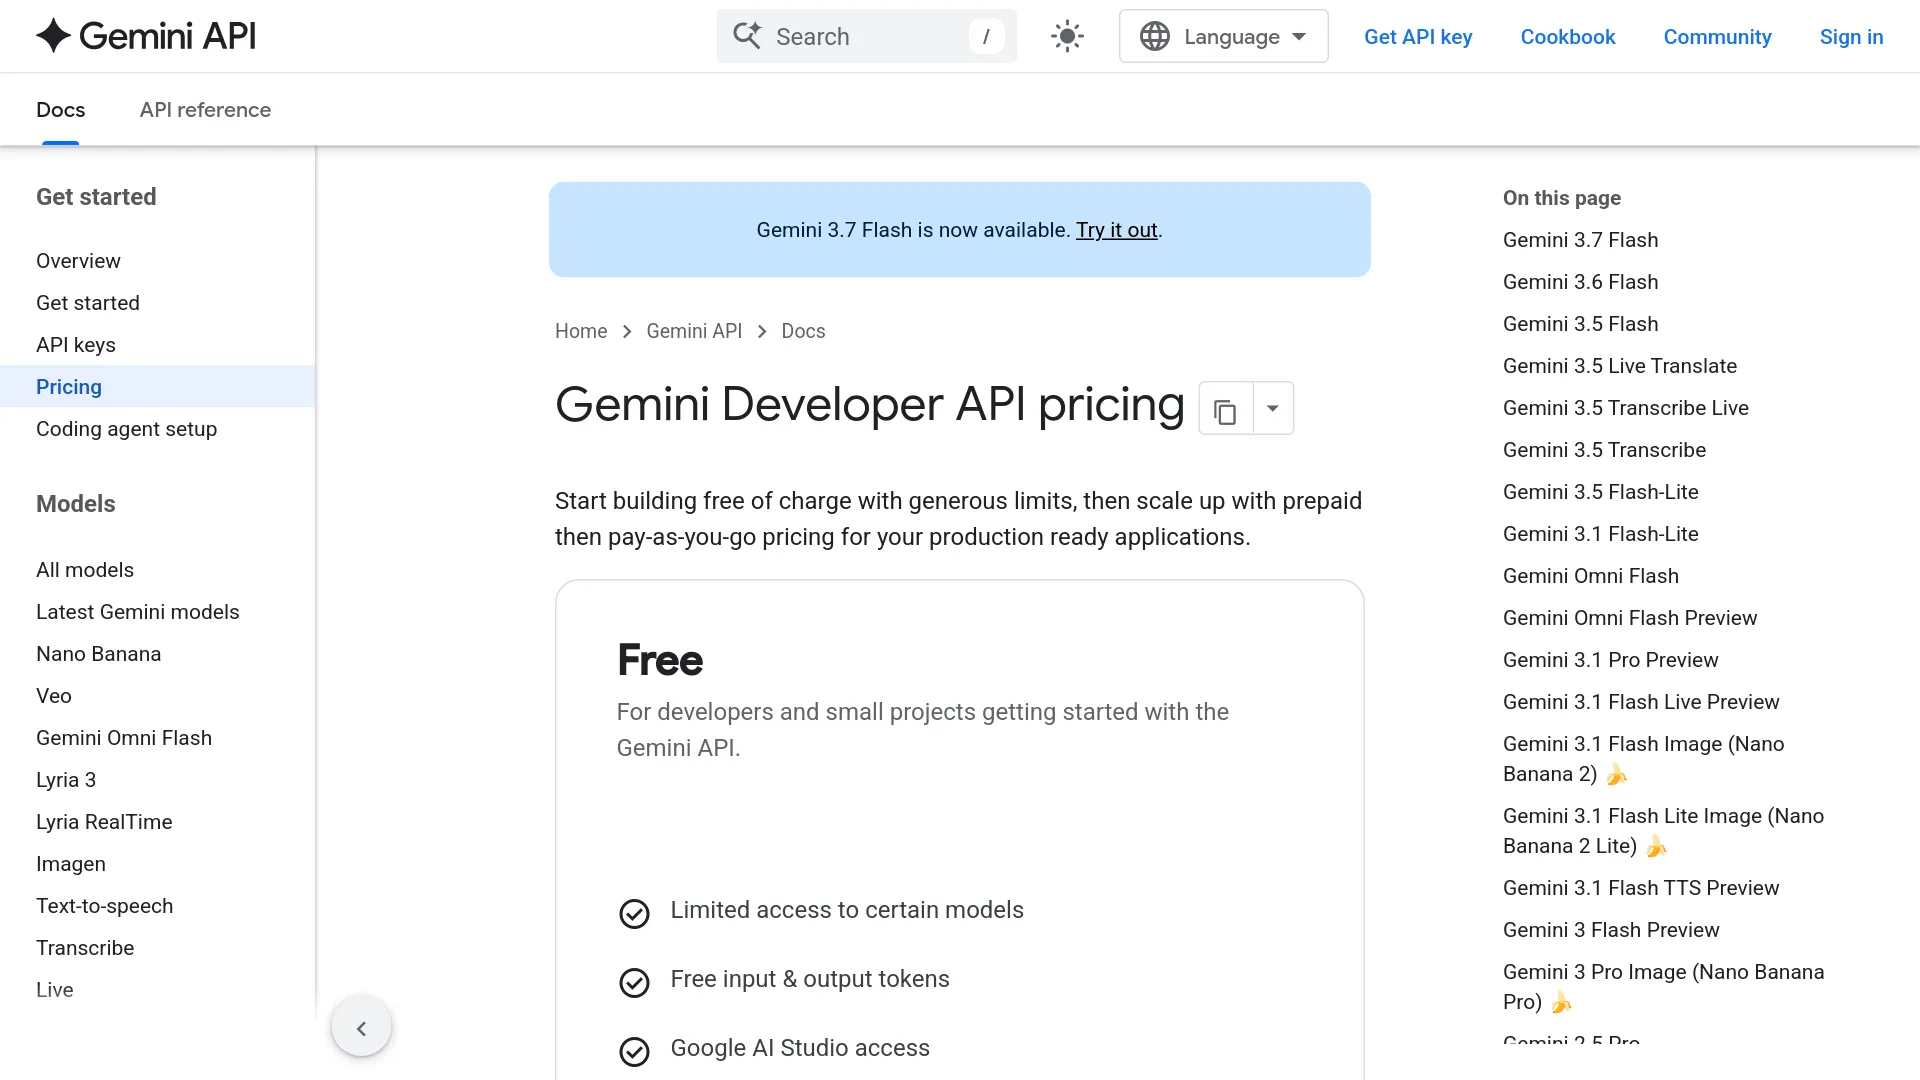
Captura realizada en la página pública de precios de Google; verifica la tabla vigente antes de comprometer volumen. Consulta la documentación oficial de precios de Gemini API.
Calcula el coste de una transcripción aceptada sumando el uso de la API, el tiempo de revisión, la tarifa del revisor, los reintentos, el almacenamiento, la conversión y el procesamiento posterior. Las correcciones de Smart mode o una segunda pasada de anotación pueden hacer que una API más cara resulte más económica en conjunto si reducen la corrección manual.
Preguntas frecuentes sobre Gemini 3.5 Transcribe API
¿Smart transcription puede conservar exactamente las palabras pronunciadas?
No. Smart mode edita las disfluencias y las autocorrecciones, así que debes conservar el modo literal como fuente cuando las palabras exactas sean importantes.
¿La Live API ofrece etiquetas de hablantes o marcas de tiempo por palabra?
No. Usa la ruta grabada cuando necesites diarización o marcas de tiempo por palabra.
¿Gemini 3.5 Transcribe puede procesar una reunión larga?
El límite normal de la ruta grabada es de una hora, o de 30 minutos con diarización o marcas de tiempo por palabra; Live está limitado a 10 minutos por sesión continua.
¿Es adecuada para transcripciones legales, médicas o de cumplimiento?
Úsala únicamente como capa de asistencia, con salida literal, comprobaciones de campos críticos y revisión humana; no utilices la salida de Smart mode como único registro en contextos de alto riesgo.
La decisión: haz un prototipo, pero no dejes que se convierta accidentalmente en el registro
Gemini 3.5 Transcribe es una opción sólida cuando el valor está en una transcripción económica, multilingüe y sensible al contexto, no en capturar cada palabra de forma perfecta. Empieza con la ruta grabada, compara las salidas Smart y literal usando tu propio audio y añade anotaciones solo si el límite de 30 minutos resulta aceptable.
Pasa a Live para subtítulos o interfaces de voz cuando el cliente pueda transmitir de forma segura el formato PCM requerido y separar el texto provisional del texto final. En registros sensibles, conserva la salida literal y convierte la revisión humana en un criterio de aceptación, no en una reparación de emergencia después de que Smart mode haya reescrito la fuente.