 AIREITER
Una corrección a las 3 de la madrugada solo merece la pena si no provoca una caída a las 3:15. Este análisis de Replit Monitoring Agent concluye que Auto-fix es útil para investigar incidentes de producción bajo supervisión, pero Auto-republish, todavía experimental, está demasiado poco definido para rutas críticas.
Replit lanzó oficialmente Monitoring Agent el 22 de octubre de 2026. La función puede revisar la telemetría y el código en producción, intentar aplicar una corrección, validarla y, opcionalmente, volver a publicar la aplicación. Replit ofrece controles independientes para la detección, los cambios de código y el despliegue, de modo que los equipos no tienen que conceder los tres permisos a la vez.
Veredicto para producción: mejor la configuración intermedia
La configuración más segura que sigue siendo práctica es alertas de Monitoring activadas, Auto-fix activado y Auto-republish desactivado. Así, Replit puede investigar un incidente y preparar una corrección, pero se mantiene la aprobación humana antes de modificar producción.
| Carga de trabajo | Alertas | Auto-fix | Auto-republish | Recomendación |
|---|---|---|---|---|
| Demo desechable o herramienta interna de bajo impacto | Activadas | Activado | Opcional | Razonable después de probar el rollback |
| Aplicación orientada a clientes | Activadas | Activado | Desactivado | La mejor configuración predeterminada |
| Pagos, autenticación, datos regulados o flujos irreversibles | Activadas | Opcional | Desactivado | Exigir revisión y controles de publicación normales |
| Aplicación sin un procedimiento de recuperación probado | Activadas | Desactivado | Desactivado | Establecer la recuperación antes de delegar cambios |
Esta conclusión se basa en la propia documentación de Replit. Auto-republish es experimental, y Replit advierte específicamente de que las migraciones y las operaciones sobre índices pueden ser arriesgadas. En esa misma página no se documentan un despliegue canario, un rollback automático, un bloqueo por presupuesto de errores después del despliegue ni la batería exacta de validaciones que debe superar una corrección.
Eso no demuestra que las correcciones automáticas vayan a fallar. Significa que, por ahora, un operador no puede auditar la política de publicación con el detalle suficiente como para confiarle incidentes de alto impacto.
Seguir un incidente a través de toda la cadena de control
El anuncio de lanzamiento describe un flujo que parte de la telemetría de producción y continúa con el diagnóstico, un cambio de código, la validación y el informe del resultado.
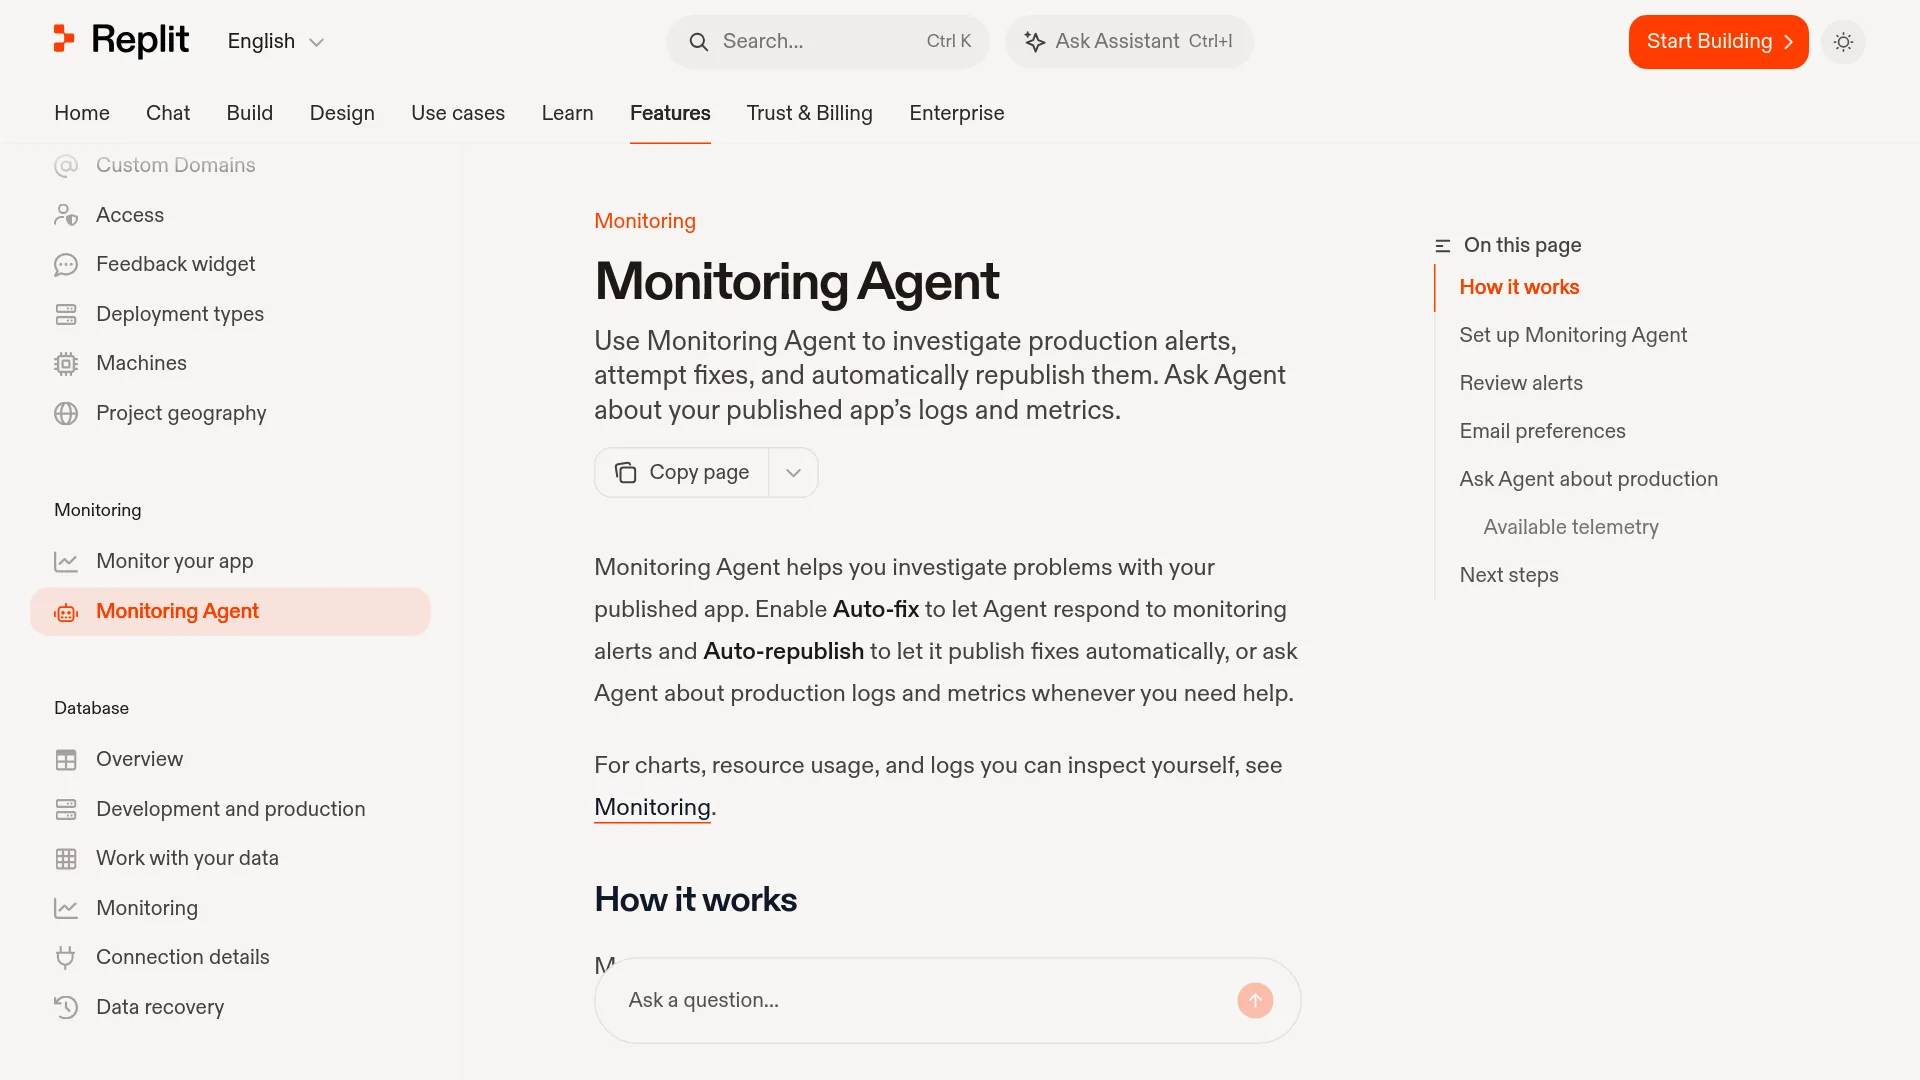
- Monitoring detecta un error de la aplicación, un error HTTP o un problema de latencia de las solicitudes.
- Auto-fix permite que Agent consulte las métricas de producción, los registros de ejecución, el código fuente y la alerta correspondiente.
- Agent intenta modificar el código y valida el resultado.
- Con Auto-republish desactivado, la corrección queda en el chat de Agent a la espera de revisión humana y publicación manual.
- Con Auto-republish activado, Agent puede publicar la corrección validada sin ese paso de revisión.
- La documentación de Monitoring Agent indica que las alertas resueltas permanecen 30 días en la tabla, mientras que Replit envía correos a los destinatarios según sus preferencias de severidad.
Una alerta no garantiza que exista una reparación. Replit menciona los fallos de servicios externos como una de las situaciones que pueden requerir acciones fuera de la aplicación, y la documentación de monitorización indica que los registros de despliegue se conservan durante 30 días.
La detección cubre menos señales que las que Agent puede consultar
Las alertas automáticas solo vigilan tres grupos de señales: registros de errores de la aplicación, errores HTTP y latencia de las solicitudes. No representan todas las condiciones de producción capaces de romper una aplicación.
Bajo demanda, Agent puede consultar un conjunto de telemetría más amplio, según el tipo de despliegue y el proveedor cloud: número de solicitudes, disponibilidad, recuento de errores 4xx y 5xx, latencia por endpoint, latencia media y p50/p95/p99, CPU, memoria, instancias activas, latencia de arranque, tiempo de actividad, disco, tráfico de salida de red y registros de ejecución filtrados por revisión. Replit no publica los umbrales de alerta, los intervalos de consulta, la retención de telemetría para todas las métricas ni un SLA de disponibilidad en la página de Monitoring Agent.
La diferencia importa cuando el incidente se debe a la profundidad de una cola, timeouts de terceros, corrupción de datos, una dependencia regional o una regla de negocio incumplida. El agente puede consultar más información cuando se le pide, pero su conjunto de activadores automáticos no constituye un sistema completo de observabilidad.
“Validada” no significa que exista un bloqueo de producción definido públicamente
Replit afirma que Monitoring Agent valida una corrección antes de que pueda pasar a Auto-republish. Sin embargo, la documentación no especifica qué pruebas se ejecutan, si la validación utiliza datos similares a los de producción, qué umbral debe superarse ni si una publicación correcta debe mantenerse saludable durante un intervalo determinado.
Tampoco se documentan un porcentaje de despliegue canario, un rollout por fases, una detención automática después de varias reparaciones ni un rollback automático si la tasa de errores de producción vuelve a subir. Estas carencias son decisivas en aplicaciones de alto riesgo: una prueba puede pasar y, aun así, una regresión puede quedar fuera de la ruta comprobada.
El usuario @_ItsmeJJ_9 planteó directamente la pregunta clave el día del lanzamiento:
“Cuando Monitoring Agent soluciona un problema y lo publica automáticamente, ¿cómo se asegura de que la corrección es segura y qué ocurre si empeora las cosas?” — @_ItsmeJJ_9 en X
La función apenas llevaba un día disponible cuando se preparó este análisis, así que la recomendación se apoya en los controles documentados y no en un historial prolongado de uso real.
Los tres interruptores son el verdadero modelo de seguridad
| Configuración | Detecta problemas | Cambia el código | Cambia producción activa |
|---|---|---|---|
| Alertas de Monitoring | Sí | No | No |
| Auto-fix | Sí | Sí | No |
| Auto-republish | Sí | A través de Auto-fix | Sí |
Auto-republish requiere Auto-fix. Desactivar el correo electrónico no desactiva Monitoring ni Auto-fix, y la monitorización debe configurarse por separado para cada aplicación publicada. Estos detalles permiten ajustar los permisos a las consecuencias que tendría un cambio defectuoso.
Por qué Auto-fix es la opción predeterminada más útil
Auto-fix puede reducir el tiempo dedicado a recopilar registros, métricas, contexto del código y una posible corrección. Mantener Auto-republish desactivado deja en manos de una persona tanto la revisión del diff propuesto como la decisión de publicar.
Esta configuración intermedia encaja con un proceso de revisión convencional. Un operador puede inspeccionar los archivos modificados, confirmar que la corrección responde al fallo observado, ejecutar las pruebas específicas de la aplicación, revisar las migraciones y publicar de forma deliberada. Las instrucciones de configuración de Replit contemplan explícitamente este modo.
Cuándo Auto-republish cruza la línea roja
Auto-republish convierte una herramienta de diagnóstico en un agente capaz de publicar cambios. La función deja de ser segura para una carga de trabajo cuando una publicación defectuosa puede cobrar dinero, modificar identidades o permisos, escribir estados externos irreversibles o exigir una recuperación coordinada de la base de datos.
Replit señala expresamente que las migraciones y las operaciones sobre índices son arriesgadas. Su documentación no indica que Monitoring Agent bloquee cambios en código de facturación o autenticación, limite el número de despliegues autónomos por incidente o exija aprobación para determinados directorios o tipos de cambio.
Un usuario resumió la carencia de control de políticas de forma muy práctica:
“Activaría auto-republish si pudiera limitarlo: por ejemplo, un máximo de un par de despliegues automáticos por noche, y que cualquier cambio relacionado con facturación o autenticación tuviera que esperar mi aprobación” — @_AdityaSriv en X
En aplicaciones internas de bajo impacto, ese riesgo puede ser aceptable. En sistemas sensibles para los ingresos o sujetos a regulación, la validación sin controles de contención de publicación documentados no basta.
El precio convierte cada incidente en un contador abierto
Las ejecuciones de Monitoring Agent pueden generar cargos por uso de Agent, pero Replit no publica un precio específico por alerta, investigación, corrección o republicación; el coste depende del trabajo que realice Agent en lugar de una tarifa fija por respuesta a incidentes.
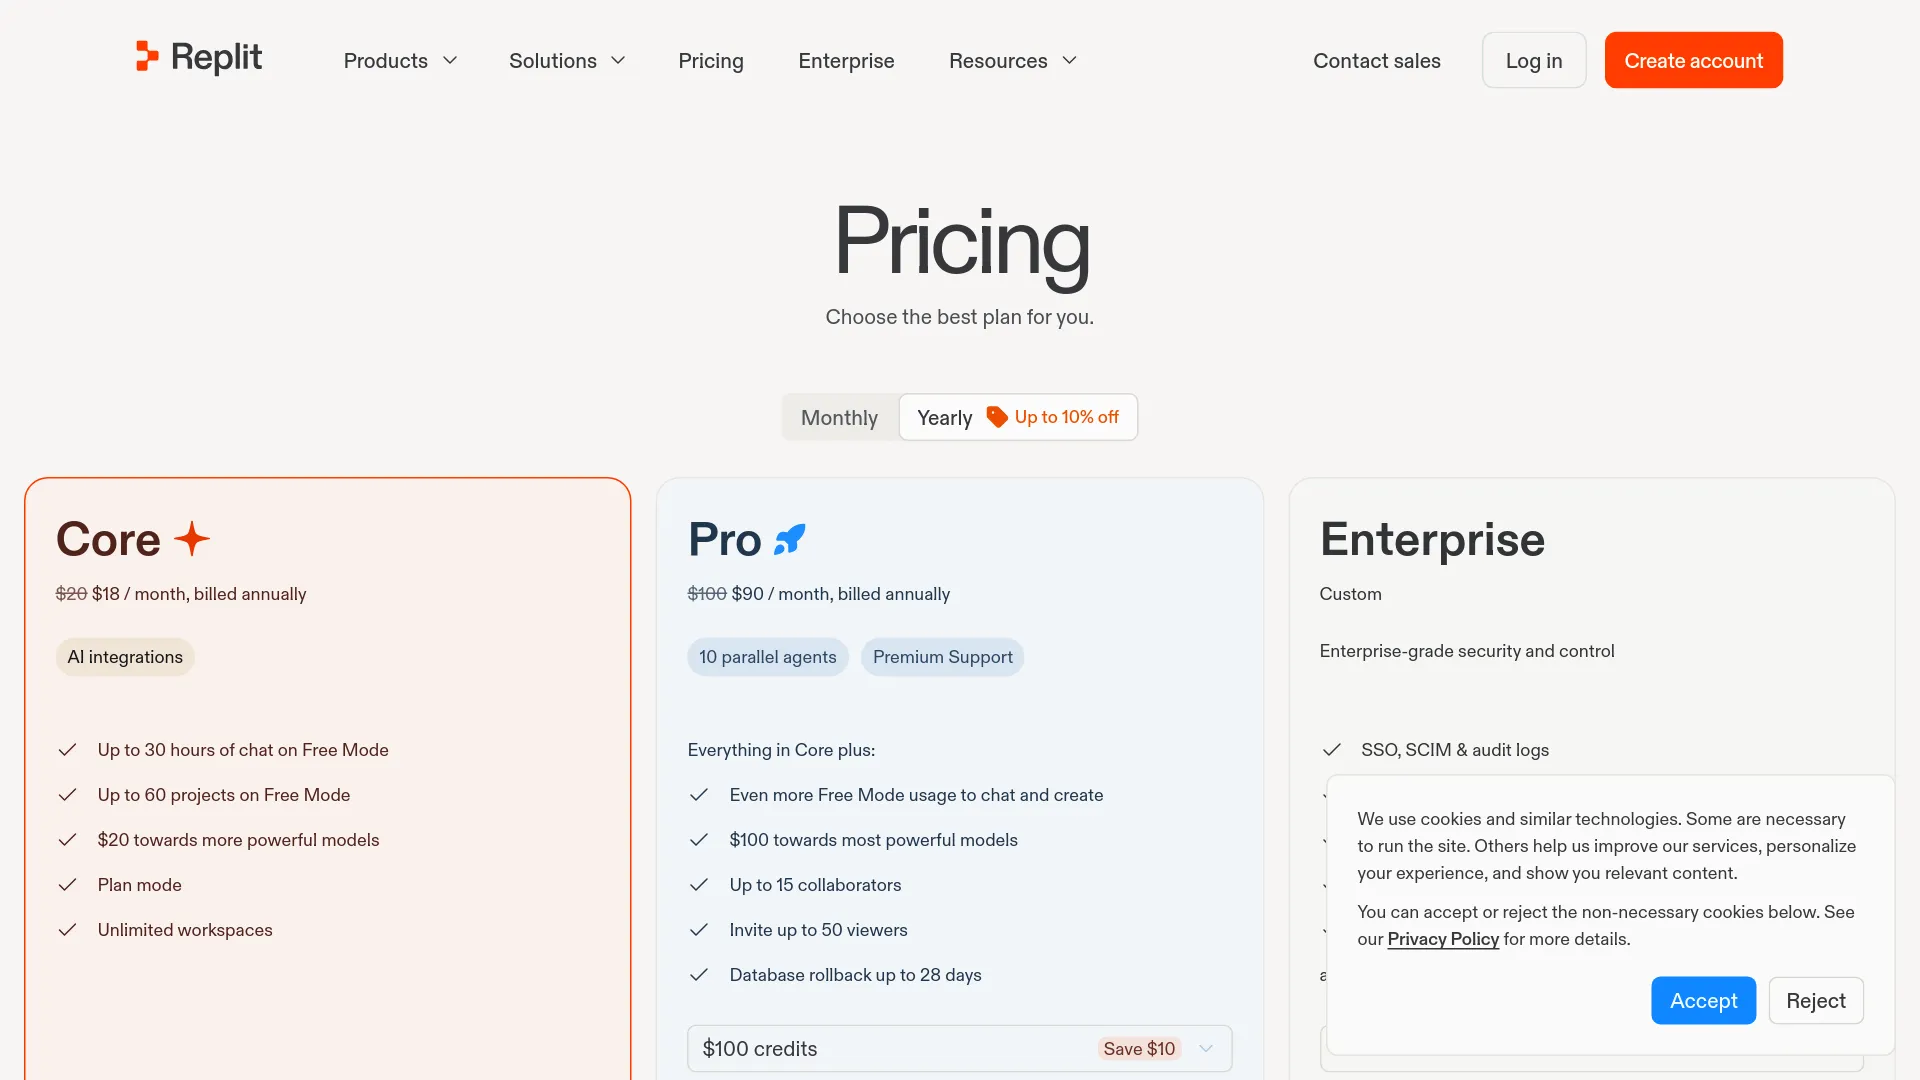
| Plan | Precio mensual | Equivalente con facturación anual | Valor incluido mostrado | Control relevante |
|---|---|---|---|---|
| Core | $20/mes | $18/mes | $20 para modelos más potentes | 1 tarea en segundo plano activa según la documentación del plan |
| Pro | $100/mes | $90/mes | $100 para modelos más potentes | 10 tareas paralelas y rollback de base de datos de 28 días |
| Enterprise | A medida | A medida | No público | SSO/SAML, privacidad avanzada, tenancy único |
Estas cifras proceden de la página de precios actual de Replit. Los créditos de la suscripción también pueden cubrir publicación, almacenamiento, bases de datos, transferencia de red e integraciones de IA, por lo que la cantidad mostrada no debe interpretarse como un presupuesto exclusivo para Monitoring Agent.
La documentación de Monitoring Agent no ofrece una tarifa por ejecución, un coste máximo de investigación ni un número de correcciones automáticas incluido. Por tanto, un presupuesto de producción debe contemplar un uso variable, además del coste subyacente de la aplicación publicada.
Qué garantizan y qué no los controles de gasto
La documentación de gestión del gasto de Replit permite establecer límites de uso para la cuenta y un límite de apagado del servicio. Al alcanzar un límite, los servicios basados en uso se bloquean o suspenden hasta el siguiente ciclo o hasta que se eleva el límite. Replit describe el uso como casi en tiempo real, mientras que su documentación de facturación de IA indica que los datos del panel pueden tardar hasta 30 minutos en aparecer.
Son frenos financieros a nivel de cuenta, no una política para incidentes. Replit no documenta un control de Monitoring Agent del tipo “gasta como máximo $5”, “intenta una sola corrección” o “detente después de 15 minutos” para cada alerta. Además, un límite de apagado del servicio puede suspender servicios, algo que quizá no convenga durante una caída.
Configura un límite de cuenta conservador, pero no lo confundas con un presupuesto acotado para la remediación autónoma.
El rollback es trabajo de recuperación, no una red de seguridad
Un checkpoint de Replit puede restaurar archivos del proyecto, paquetes, configuración, contexto de Agent y, opcionalmente, el estado de la base de datos. La documentación de checkpoints también indica que cada checkpoint crea un commit de Git y que se puede navegar hacia atrás o hacia delante.
Eso no equivale a un rollback automático de producción. La ayuda actual de proyectos de Replit indica que una aplicación publicada no puede volver directamente a una versión desplegada anterior; el procedimiento compatible consiste en restaurar el proyecto a un checkpoint anterior y publicar de nuevo ese estado. La recuperación de la base de datos de producción es una operación separada, y la restauración de la base de datos desde un checkpoint es opcional, no automática.
El rollback tampoco puede deshacer un correo ya enviado, un pago capturado por un procesador externo, un webhook entregado ni una llamada irreversible a una API de terceros. Para esos efectos secundarios hacen falta idempotencia a nivel de aplicación y acciones compensatorias.
Haz esta prueba de rollback antes de activar la automatización
- Registra la revisión desplegada actualmente e identifica el checkpoint que la representa.
- Crea una publicación defectuosa controlada en una aplicación que no sea de producción y confirma que Monitoring detecta la señal prevista.
- Restaura el checkpoint del proyecto sin seleccionar la restauración de la base de datos; verifica el código, las referencias a secretos, la configuración de compilación y el contexto de Agent.
- Prueba por separado el procedimiento de recuperación de la base de datos de producción y documenta quién puede autorizarlo.
- Vuelve a publicar el proyecto restaurado y mide cuánto se tarda en superar las comprobaciones de salud y las pruebas básicas de negocio.
- Verifica por separado los efectos externos, incluidos pagos, correos, webhooks y trabajos en cola.
- Asigna un responsable de escalado para los fallos que Agent no pueda solucionar o para los problemas de publicación del lado de la plataforma.
Si el equipo no puede completar esta prueba, Auto-republish debe permanecer desactivado. Un botón de rollback que nadie ha probado no es un plan de respuesta a incidentes.
Una política de adopción en producción acorde con la evidencia
Aplica los siguientes controles adicionales junto con las configuraciones por tipo de carga de trabajo del principio de este análisis:
| Requisito | Aplicación interna de bajo impacto | Aplicación orientada a clientes | Aplicación crítica o regulada |
|---|---|---|---|
| Aprobación humana | Puede hacerse después | Antes de publicar | Antes de publicar y con control de cambios |
| Prueba de recuperación | Antes de Auto-republish | Antes de Auto-fix | Obligatoria, con pruebas de base de datos y efectos secundarios |
| Observabilidad externa | Opcional | Recomendada | Obligatoria |
Antes de modificar esta política, busca cinco incorporaciones: criterios de validación publicados, límites de coste e intentos por incidente, despliegue canario o por fases, comprobaciones automáticas de salud después de publicar y un rollback automático que explique claramente cómo se gestionan el código, el estado del despliegue, las bases de datos y los efectos secundarios externos.
Preguntas frecuentes sobre Replit Monitoring Agent
¿Replit Monitoring Agent está disponible?
Sí. Replit anunció oficialmente Monitoring Agent el 22 de octubre de 2026 y publicó documentación de configuración para las alertas de monitorización, Auto-fix y Auto-republish.
¿Auto-fix publica los cambios automáticamente?
No. Auto-fix puede investigar, modificar el código y validar una corrección propuesta, pero la publicación en producción sigue siendo manual salvo que se active Auto-republish.
¿Auto-republish es seguro para producción?
Auto-republish es experimental. Puede encajar en aplicaciones de bajo impacto con un proceso de recuperación probado, pero carece de despliegue canario documentado, rollback automático, umbrales de validación y controles de aprobación para rutas sensibles en sistemas críticos de producción.
¿Cuánto cuesta Monitoring Agent?
Replit afirma que las ejecuciones de Monitoring Agent pueden generar cargos por uso de Agent, pero no publica una tarifa fija por incidente. Core cuesta actualmente $20 al mes y Pro $100 al mes, antes de cualquier uso que supere los créditos incluidos y de otros consumos cloud.
¿Monitoring Agent puede hacer rollback automático de una publicación defectuosa?
No hay ningún rollback automático documentado. La recuperación actual requiere restaurar un checkpoint anterior del proyecto y volver a publicarlo; la recuperación de la base de datos de producción se gestiona por separado.
¿Qué datos de producción puede consultar Monitoring Agent?
Según el tipo de despliegue y el proveedor, Agent puede consultar métricas de producción, registros de ejecución, código fuente, tráfico HTTP, latencia por endpoint, CPU, memoria, instancias, disco, red y datos de errores de la aplicación. Las alertas automáticas solo se activan por registros de errores de la aplicación, errores HTTP y latencia de las solicitudes.