 AIREITER
¿Necesitas convertir una grabación en texto utilizable o generar subtítulos desde un micrófono en tiempo real? Gemini 3.5 Transcribe destaca por la limpieza del texto, las sugerencias de vocabulario y el manejo multilingüe, pero sus dos vías de API tienen límites muy distintos. La API de archivos encaja mejor con transcripciones que quieras conservar; la Live API está pensada para sesiones cortas y con poca latencia.
La respuesta práctica: usa la API de archivos salvo que necesites subtítulos en directo
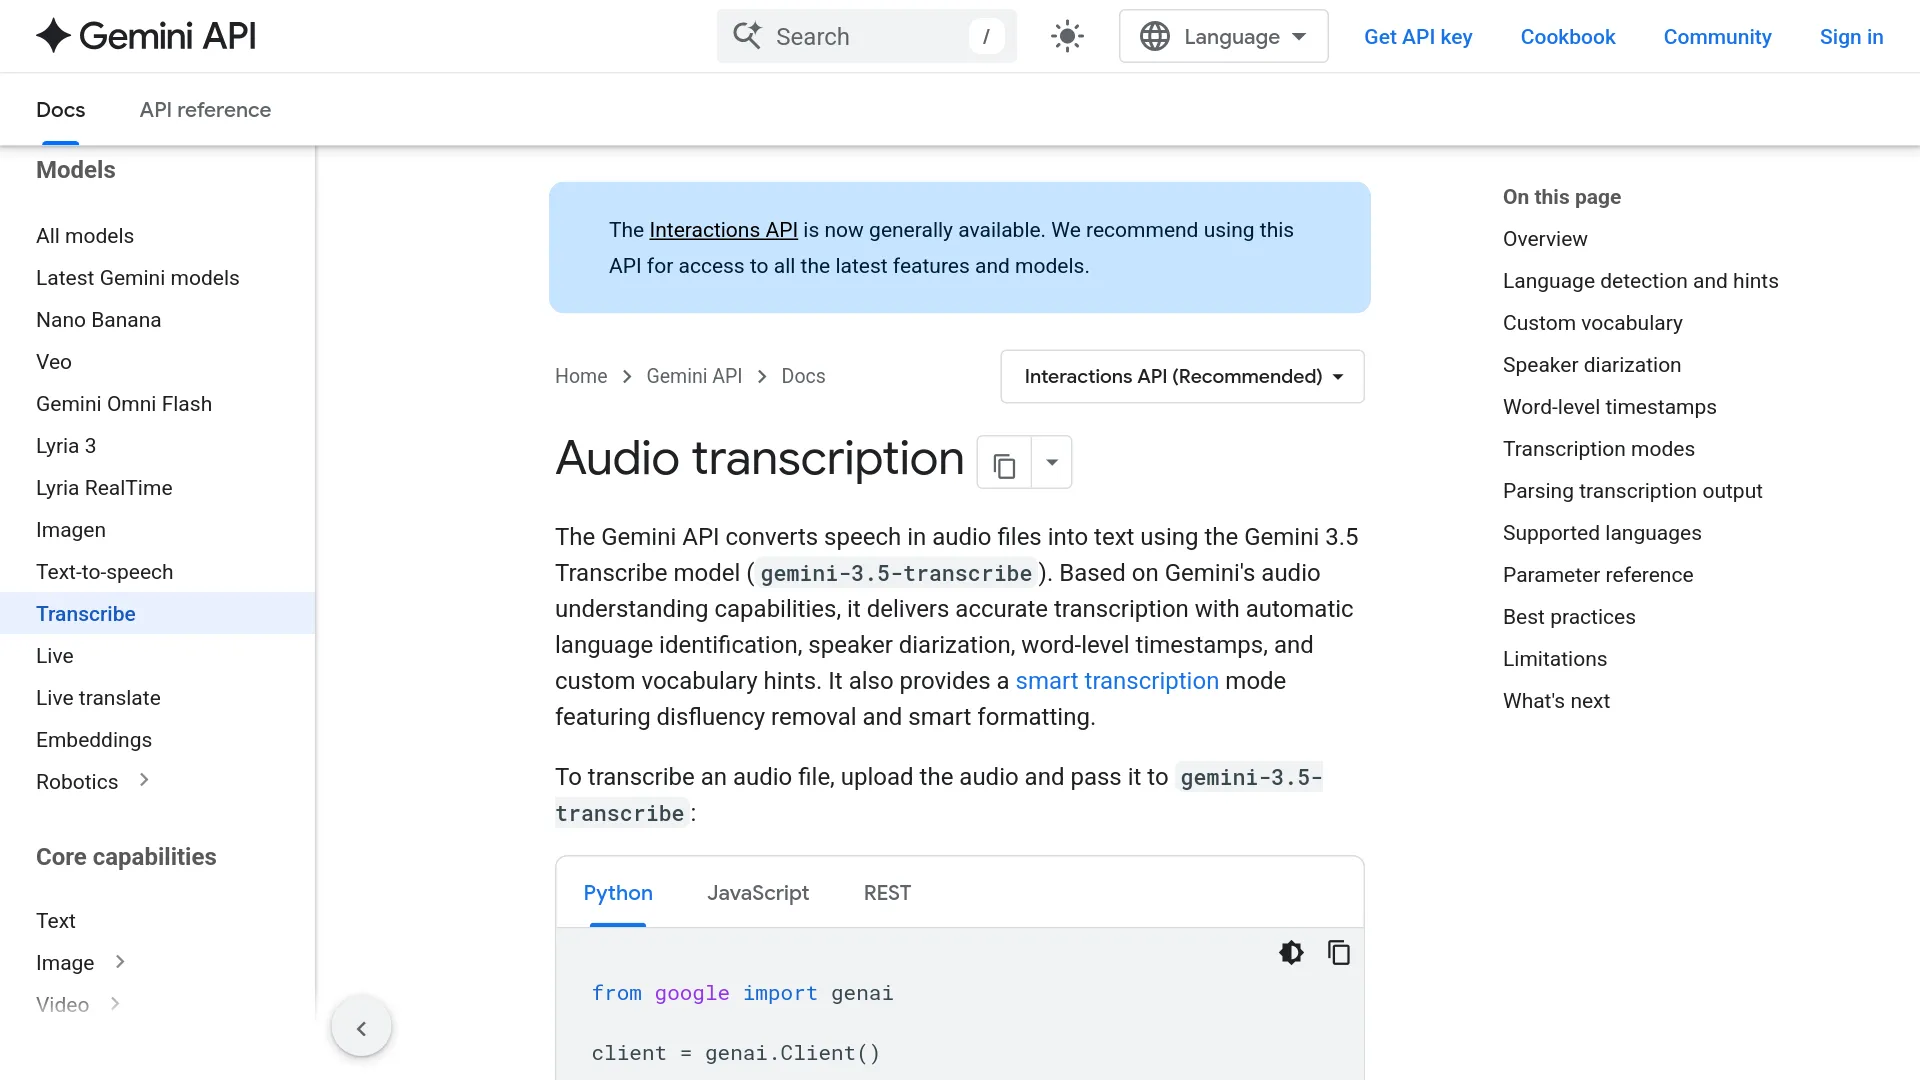
Gemini 3.5 Transcribe es la familia de modelos de Google dedicada a convertir voz en texto y está disponible en preview pública desde el 26 de agosto de 2026. Google documenta identificadores de modelo, transportes, eventos de salida y restricciones diferentes para el audio grabado y el audio en tiempo real.
| Necesidad | Identificador de modelo | Vía de API | Restricción importante |
|---|---|---|---|
| Reuniones, llamadas y grabaciones subidas | gemini-3.5-transcribe | Interactions API | Hasta 1 hora en una solicitud unary estándar; 30 minutos con diarización o marcas de tiempo por palabra |
| Subtítulos en directo, entrada de micrófono e interfaces de voz | gemini-3.5-transcribe-live | Live API | Sesiones continuas de 10 minutos; sin diarización en directo ni marcas de tiempo por palabra |
Para archivar reuniones, analizar llamadas o preparar subtítulos, empieza con gemini-3.5-transcribe. Si quieres mostrar una previsualización de subtítulos o crear una interfaz de pulsar para hablar, utiliza gemini-3.5-transcribe-live. La guía de transcripción de audio grabado y la guía de Live API de Google explican ambos flujos por separado.
La disponibilidad sigue limitada a la preview
Google anunció Gemini 3.5 Transcribe el 26 de agosto de 2026 y ofrece la API para desarrolladores en preview pública a través de Google AI Studio y Google Antigravity. El acceso empresarial también aparece en preview mediante Gemini Enterprise Agent Platform. Al estar en preview, la cobertura regional, las cuotas y la estabilidad pueden diferir de las de un servicio de voz con disponibilidad general. Conviene probar audio representativo antes de trasladar un volumen importante.
Precios de Gemini 3.5 Transcribe en unidades prácticas
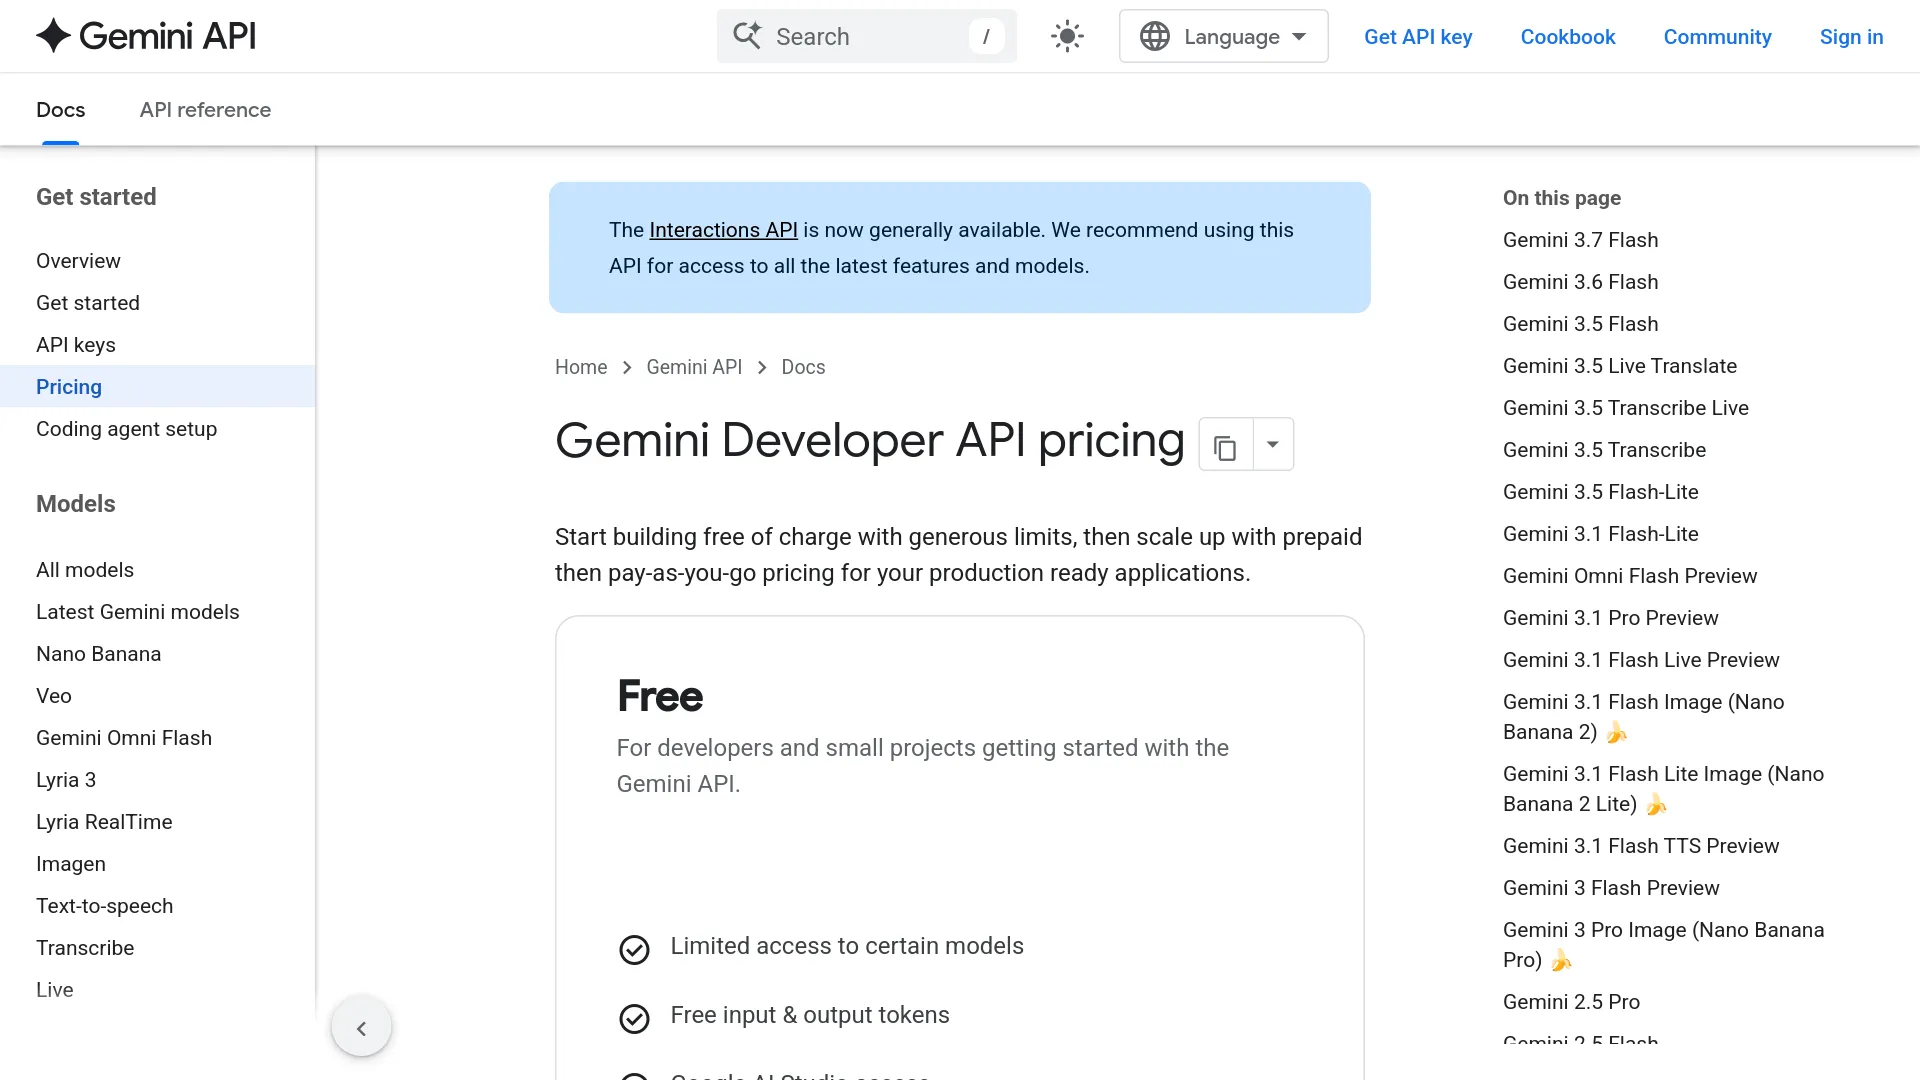
La página de precios de Gemini API de Google muestra tarifas basadas en tokens, no una tarifa fija por transcripción. La referencia actual indica 2 $ por millón de tokens de entrada de audio y 12 $ por millón de tokens de salida de texto para gemini-3.5-transcribe.
La documentación de audio de Google indica que el audio se representa con 32 tokens por segundo, es decir, 1.920 tokens de audio por minuto. Por tanto, la parte correspondiente a la entrada de audio equivale aproximadamente a 0,00384 $ por minuto con una tarifa de 2 $ por millón de tokens, sin contar la salida de texto ni otros tokens facturables.
| Modelo | Base de precios publicada | Estimación combinada orientativa | Estimación orientativa por 1 hora |
|---|---|---|---|
gemini-3.5-transcribe | 2 $/M de tokens de entrada de audio + 12 $/M de tokens de salida de texto | Aproximadamente 0,005 $/min | Aproximadamente 0,30 $/hora |
gemini-3.5-transcribe-live | Procesamiento de audio y texto en directo basado en tokens | Aproximadamente 0,009 $/min | Aproximadamente 0,54 $/hora |
Las cifras combinadas dependen del volumen de texto generado, así que son estimaciones para planificar y no tarifas garantizadas por minuto. Una salida más densa, el contexto repetido o instrucciones adicionales pueden modificar la factura. Comprueba la tabla de precios actual antes de comprometer un volumen importante, ya que los precios de la preview pueden cambiar.
Las diferencias de funciones que importan en producción
Transcripción literal frente a transcripción inteligente
VERBATIM es el modo predeterminado en la documentación de transcripción de Google. Conserva las muletillas, repeticiones, pausas, arranques en falso y correcciones tal como se pronunciaron. Es la opción adecuada cuando la transcripción debe servir como registro, prueba, fuente para subtítulos o entrada para controles de calidad.
SMART transforma el texto para facilitar su lectura. Elimina disfluencias, resuelve autocorrecciones, añade puntuación y estructura, y puede dar formato a fechas, monedas, números, listas y párrafos. La frase hablada «martes… no, miércoles» puede convertirse en «miércoles» en el resultado limpio.
El modo inteligente no es compatible con la diarización de hablantes ni con las marcas de tiempo por palabra. Si la aplicación necesita notas legibles y trazabilidad, solicita primero una salida literal y limpia después una copia.
Vocabulario personalizado y cambios de idioma
Google documenta la detección automática de idiomas en más de 85 configuraciones regionales, incluidos los cambios de idioma dentro de una misma conversación. Si conoces el idioma, proporciona un código BCP-47 como en-US o es-ES para orientar el reconocimiento.
El vocabulario personalizado admite hasta 1.000 términos, aunque las recomendaciones prácticas de Google indican que los resultados suelen ser mejores con 100 términos o menos. Incluye nombres de productos distintivos, acrónimos, nombres propios, términos médicos o palabras técnicas, no una lista de vocabulario común.
Etiquetas de hablante y marcas de tiempo por palabra
El audio grabado puede devolver la atribución de hablantes y la temporización de cada palabra. La documentación de la API establece un máximo de ocho hablantes, mientras que la publicación de lanzamiento de Google destaca la atribución de hasta tres y califica como experimental la compatibilidad con tres o más hablantes.
Las marcas de tiempo por palabra se activan en el modo literal e incluyen los desplazamientos inicial y final de cada palabra. Google advierte de que las marcas de tiempo pueden reducir la precisión general de la transcripción. La diarización y las marcas de tiempo también reducen de una hora a 30 minutos el límite estándar de duración del audio.
| Requisito | ¿Compatible? | Particularidad |
|---|---|---|
| Etiquetas de hablante en audio grabado | Sí | Hasta 8 según la documentación; la atribución de 3 o más es experimental |
| Marcas de tiempo por palabra en audio grabado | Sí | Solo en modo literal; pueden reducir la precisión |
| Etiquetas de hablante en transcripción en directo | No | Usa audio grabado cuando la atribución sea importante |
| Marcas de tiempo por palabra en transcripción en directo | No | La salida en directo es incremental y está orientada a enunciados |
| Modo inteligente con etiquetas o marcas de tiempo | No | Elige el modo literal para obtener estas anotaciones |
Cómo enviar un archivo grabado a Gemini 3.5 Transcribe API
La guía de audio grabado de Google describe tres pasos: subir el archivo, pasar el URI del archivo devuelto a la Interactions API y leer la transcripción completa desde interaction.output_text.
- Sube el audio con la Files API. Utiliza esta vía para grabaciones de más de unos segundos o archivos que vayas a reutilizar.
- Conserva el URI del archivo y su tipo MIME, por ejemplo
audio/mp3. - Envía el URI a
gemini-3.5-transcribemediante la Interactions API. - Lee la salida de texto y, si lo has solicitado, consulta las anotaciones
word_infopara obtener datos de hablantes y tiempos.
El flujo con el SDK oficial puede resumirse en este ejemplo de subida y transcripción:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Una solicitud REST compacta tendría este aspecto después de que la subida mediante Files API haya devuelto FILE_URI:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
Para obtener una transcripción limpia, añade una configuración de transcripción con el modo inteligente:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
Para las etiquetas de hablante y la temporización de palabras, utiliza en su lugar el modo literal:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
No combines la configuración inteligente con la diarización o las marcas de tiempo. Las reglas de modo documentadas por la API lo convierten en una decisión de diseño, no solo en una preferencia de formato.
Cómo funciona la transcripción en directo
La Live API abre una conexión bidireccional de streaming mediante gemini-3.5-transcribe-live. El cliente envía audio de forma continua y recibe dos eventos de texto:
interim_input_transcription: una hipótesis cambiante y de baja latencia para subtítulos o previsualizaciones en la interfaz.input_transcription: texto finalizado que se puede guardar en la transcripción o confirmar en el estado de la aplicación.
La guía de Live API de Google especifica audio PCM de 16 bits, 16 kHz, mono y little-endian. Recomienda fragmentos de unos 100 milisegundos, con aproximadamente 1.024–2.048 frames por fragmento. Los clientes web y móviles deberían utilizar tokens efímeros restringidos en lugar de exponer una clave de API normal; los ejemplos de Google emplean un token de un solo uso con una caducidad de 30 minutos.
El endpoint en directo admite detección automática de idioma, sugerencias BCP-47, vocabulario personalizado y salida VERBATIM o SMART. No admite diarización de hablantes ni marcas de tiempo por palabra en directo. Una sesión continua está limitada a 10 minutos, por lo que las emisiones más largas requieren gestionar las sesiones y unir las transcripciones desde la aplicación.
Para detectar los límites entre turnos, la Live API ofrece tres opciones:
- VAD automático: el servidor detecta cuándo empieza y termina el habla.
- VAD híbrido: un detector en el cliente señala el final del habla, mientras la detección del servidor permanece como respaldo.
- VAD manual: una interfaz de pulsar para hablar envía explícitamente los eventos de inicio y final de actividad.
Qué demuestra la evidencia inicial —y qué no
Google comunica cifras medias de WER del 4,0 % en streaming y del 2,6 % sin streaming a través de Artificial Analysis. Su publicación de lanzamiento también recoge resultados de FLEURS de 5,50 % de WER en streaming y 5,04 % de WER sin streaming, además de una mejora del 70 % en el tiempo hasta la transcripción final frente a Chirp 3.
Estas cifras proceden de Google o de fuentes citadas por Google; no son una comparación independiente cara a cara de Gemini 3.5 Transcribe. El benchmark STT de koedesk midió Gemini 3.5 Flash y otros motores, pero no evaluó directamente Gemini 3.5 Transcribe.
Los primeros usuarios están preguntando por los límites de duración de archivos y sesiones en directo, las transcripciones de referencia para WER y la fiabilidad al reconocer números de teléfono o identificadores de pedido en fragmentos con poco ruido. Prueba nombres, identificadores, números, cambios de hablante, tiempos y latencia con audio representativo en lugar de confiar únicamente en el WER medio.
Cuándo elegir Gemini 3.5 Transcribe y cuándo esperar
| Situación | Adecuación | Configuración inicial recomendable |
|---|---|---|
| Notas de reuniones limpias o dictado | Alta | File API, SMART e indicación explícita del idioma si se conoce |
| Registro legal, de cumplimiento o archivado | Condicional | File API, VERBATIM; revisa manualmente los pasajes críticos |
| Llamadas grabadas con varios hablantes | Condicional | File API, VERBATIM + diarización; limita las sesiones a 30 minutos |
| Subtítulos sincronizados por palabra | Condicional | File API, VERBATIM + marcas de tiempo por palabra; valida los tiempos y la precisión |
| Subtítulos en directo | Alta para sesiones cortas | Live API; utiliza solo los eventos finales para confirmar el texto |
| Agente de voz de larga duración | Requiere trabajo de ingeniería | Divide las sesiones antes del límite de 10 minutos y gestiona las reconexiones |
| Procesamiento local, sin conexión o confidencial | Poca adecuación | El flujo documentado envía el audio al servicio de Google; considera una vía ASR autoalojada |
Gemini 3.5 Transcribe encaja especialmente bien cuando la transcripción es el primer paso de un flujo más amplio: limpiar el habla, conservar el vocabulario técnico, identificar a los hablantes y pasar el texto estructurado a la siguiente etapa. Es menos apropiado cuando el único requisito es una transcripción literal barata o el procesamiento obligatorio sin conexión.
Preguntas frecuentes sobre Gemini 3.5 Transcribe API
¿Gemini 3.5 Transcribe es gratis?
Google ofrece un nivel gratuito para el uso de Gemini API, pero las cuotas y la disponibilidad de los modelos pueden cambiar. El uso de pago se factura por tokens; la página de precios muestra actualmente estimaciones combinadas orientativas de unos 0,005 $ por minuto para transcripción grabada y 0,009 $ por minuto para el modelo en directo.
¿Cuál es la diferencia entre los modelos de archivos y directo?
gemini-3.5-transcribe procesa grabaciones subidas mediante la Interactions API y admite diarización y marcas de tiempo por palabra en audio grabado. gemini-3.5-transcribe-live transmite PCM sin procesar mediante la Live API, devuelve eventos provisionales y finales, y está limitado a sesiones de 10 minutos sin diarización en directo ni marcas de tiempo por palabra.
¿Puede procesar una grabación de tres horas en una sola solicitud?
No con la configuración de transcripción grabada específica. El límite unary estándar es de una hora, y la diarización o las marcas de tiempo por palabra lo reducen a 30 minutos. Un flujo más largo necesita dividir el audio desde la aplicación y gestionar con cuidado el contexto y la continuidad de los hablantes.
¿Puedo usar Gemini 3.5 Transcribe sin conexión?
El flujo documentado sube o transmite el audio al servicio de Google. Google no describe una versión de Gemini 3.5 Transcribe para uso sin conexión o autoalojado.
La integración inicial más segura
Empieza con una muestra real de tu carga de trabajo, no con un clip de demostración limpio. Ejecuta el mismo audio dos veces: una en modo literal para comprobar la fidelidad y otra en modo inteligente para evaluar la legibilidad. Mide por separado los nombres propios, los números, los cambios de hablante, la desviación de las marcas de tiempo y el coste.
Conserva la transcripción original como fuente de verdad, utiliza la salida inteligente para las notas destinadas al usuario y añade una alternativa para los fallos de subida o los cambios del modelo en preview. Pasa a la Live API solo cuando el cliente pueda gestionar fragmentos PCM de 100 milisegundos, eventos provisionales y finales, tokens efímeros y el límite de sesión de 10 minutos.