 AIREITER
DeepSeek lanzó oficialmente V4 Pro GA el 13 de agosto de 2026 con resultados completos de benchmarks, pesos abiertos bajo licencia MIT y tres niveles de esfuerzo de razonamiento. Para quienes usan la API, el dato clave está en la página oficial de precios: el cobro en horario punta y valle empezará el 16 de agosto de 2026 a las 16:00 UTC. Desde entonces, los tokens de salida de V4 Pro pasarán de 0,87 $ a 1,98 $ por millón en horario valle, o a 3,96 $ en horario punta.
Qué incluye el lanzamiento: V4-Pro-0813, benchmarks y pesos abiertos
El modelo que utiliza el alias de API deepseek-v4-pro es ahora DeepSeek-V4-Pro-0813, disponible en la aplicación, la web y la API de DeepSeek. La compañía anunció el lanzamiento el 13 de agosto y destacó unas capacidades de agente «significativamente mejoradas» frente a la versión preliminar del 24 de abril.
Arquitectura y especificaciones:
| Elemento | DeepSeek-V4-Pro-0813 |
|---|---|
| Tamaño publicado del modelo | 1,7 T de parámetros (tarjeta del modelo; la versión preliminar tenía 1,6 T) |
| Longitud de contexto | 1 millón de tokens |
| Salida máxima | 384 K tokens |
| Modos de razonamiento | Sin razonamiento y con razonamiento (este último es el modo predeterminado) |
| Niveles de esfuerzo de razonamiento | low, high, max |
| Nuevo módulo de decodificación | Decodificación especulativa DSpark (7 tokens especulativos) |
| Compatibilidad de API | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| Límite de concurrencia | 500 |
| Licencia | MIT |
La tarjeta del modelo recomienda usar temperature = 1.0 y top_p = 0.95 en escenarios con agentes. También fija una salida máxima de 384 K tokens cuando se utiliza un esfuerzo high o max.
Benchmarks oficiales de la versión GA
DeepSeek publicó diez comparativas de rendimiento en la tarjeta del modelo. Las tareas de agentes de código se ejecutaron con DeepSeek Harness en modo minimal y un esfuerzo de razonamiento max. Las dos últimas filas, correspondientes a DSBench, son conjuntos de pruebas internos de DeepSeek. Todos los resultados proceden de esa tarjeta del modelo.
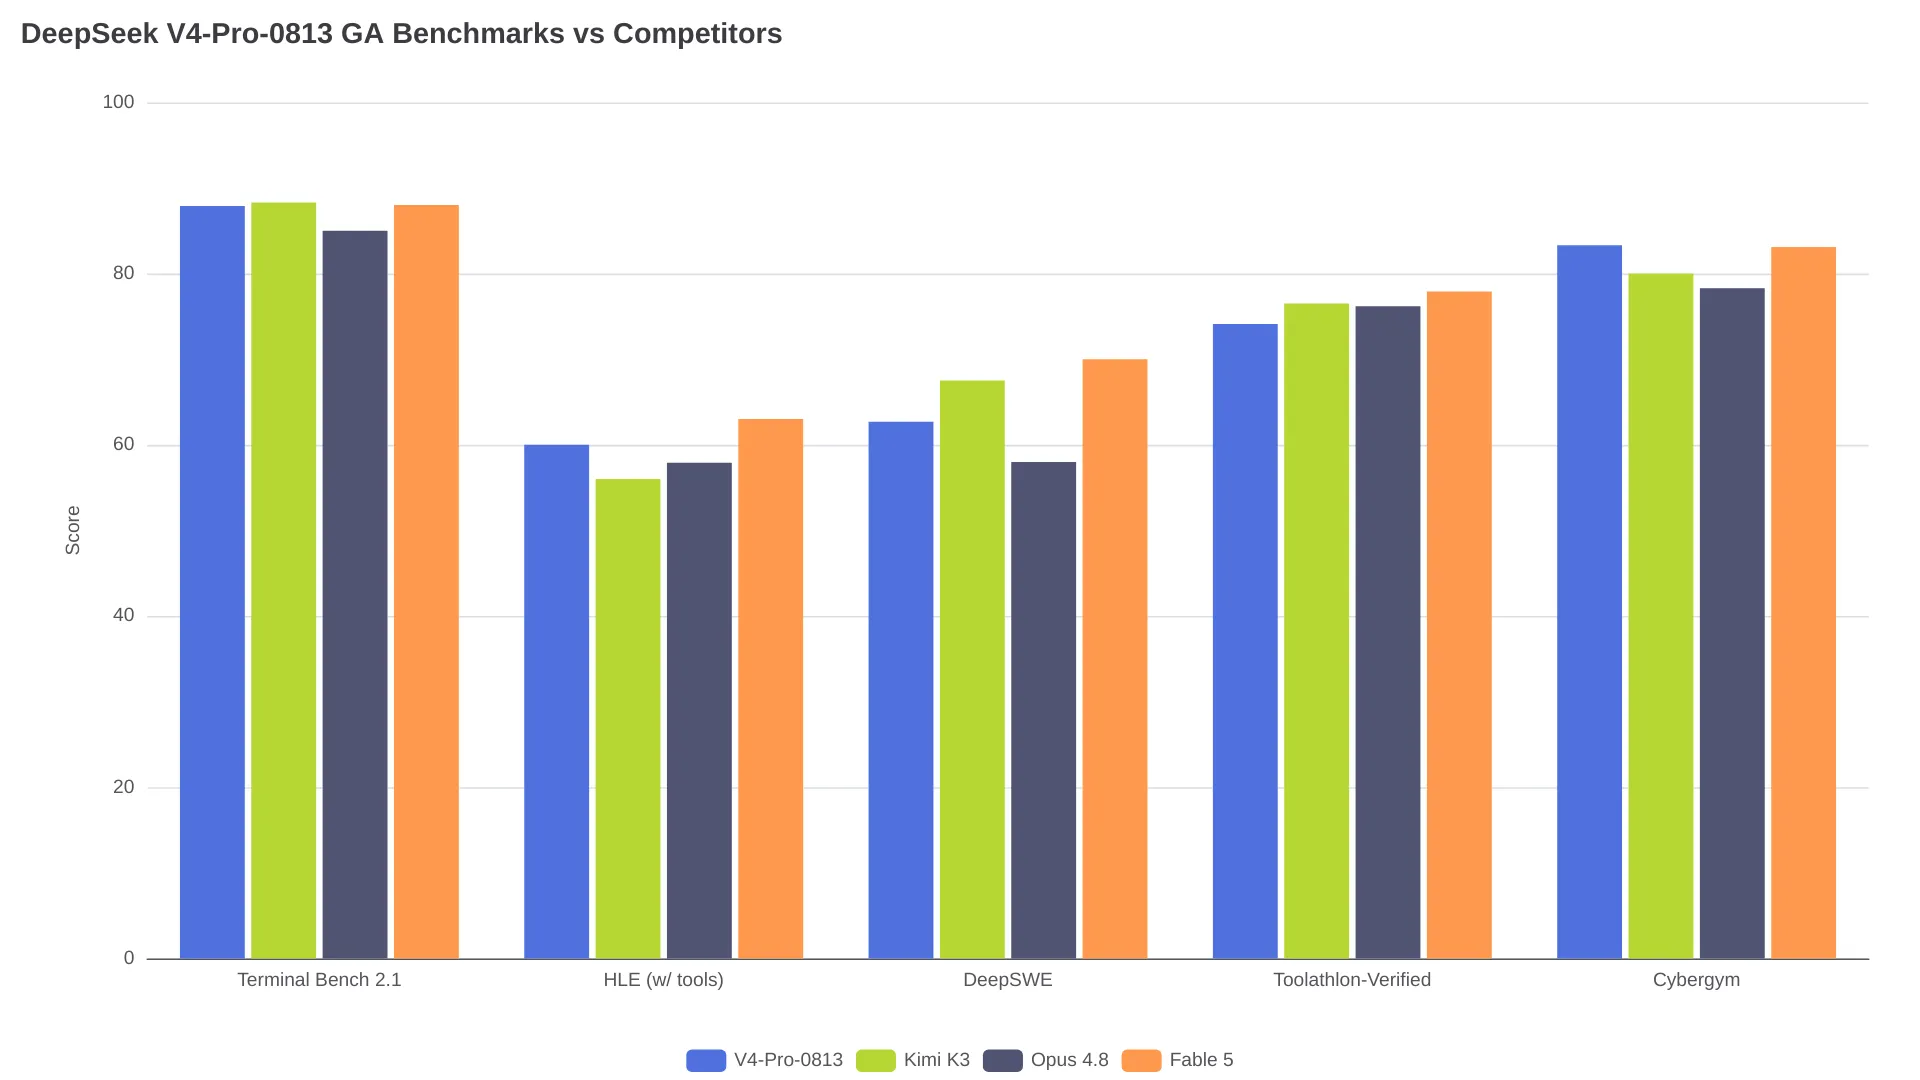
| Benchmark | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE (sin herramientas / con herramientas) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (público) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (interno) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (interno) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
El salto respecto a la versión preliminar es enorme: DeepSWE pasa de 12.8 a 62.7 y AutomationBench, de 12.8 a 31.8. Frente a la competencia, Pro-0813 lidera en HLE con herramientas, con 60.0 puntos frente a los 56.0 de Kimi K3 y los 57.9 de Opus 4.8. Sin embargo, queda por detrás de Kimi K3 y Fable 5 en DeepSWE, Terminal Bench y Toolathlon-Verified. Las dos filas de DSBench son pruebas internas del proveedor, así que no deberían ponderarse igual que los benchmarks mantenidos de forma independiente.
Pesos abiertos para desplegarlo por tu cuenta
Los pesos de la versión 0813 ya están disponibles en Hugging Face con licencia MIT y rutas de despliegue para vLLM y SGLang. La tarjeta del modelo incluye un ejemplo de servicio con vLLM que utiliza decodificación especulativa DSpark, caché KV en FP8 y un único nodo 4x GB300.
«Ampliamente competitivo con los modelos propietarios más potentes disponibles.» — Tarjeta del modelo DeepSeek V4-Pro, Hugging Face
Precios al detalle: cuánto pagarás antes y después del 16 de agosto
La página de precios muestra una tarifa plana actual y otra tarifa programada para horas punta y valle, que entrará en vigor el 16 de agosto de 2026 a las 16:00 UTC. Las horas punta son 01:00–04:00 UTC y 06:00–10:00 UTC (09:00–12:00 y 14:00–18:00 en Pekín). El resto del día se considera horario valle. La tarifa valle es exactamente la mitad de la tarifa punta.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| Categoría de cobro | Tarifa plana actual | Valle (16 de agosto) | Punta (16 de agosto) | Cambio en punta |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| Entrada, fallo de caché | $0.435/M | $0.66/M | $1.32/M | +203% |
| Salida | $0.87/M | $1.98/M | $3.96/M | +355% |
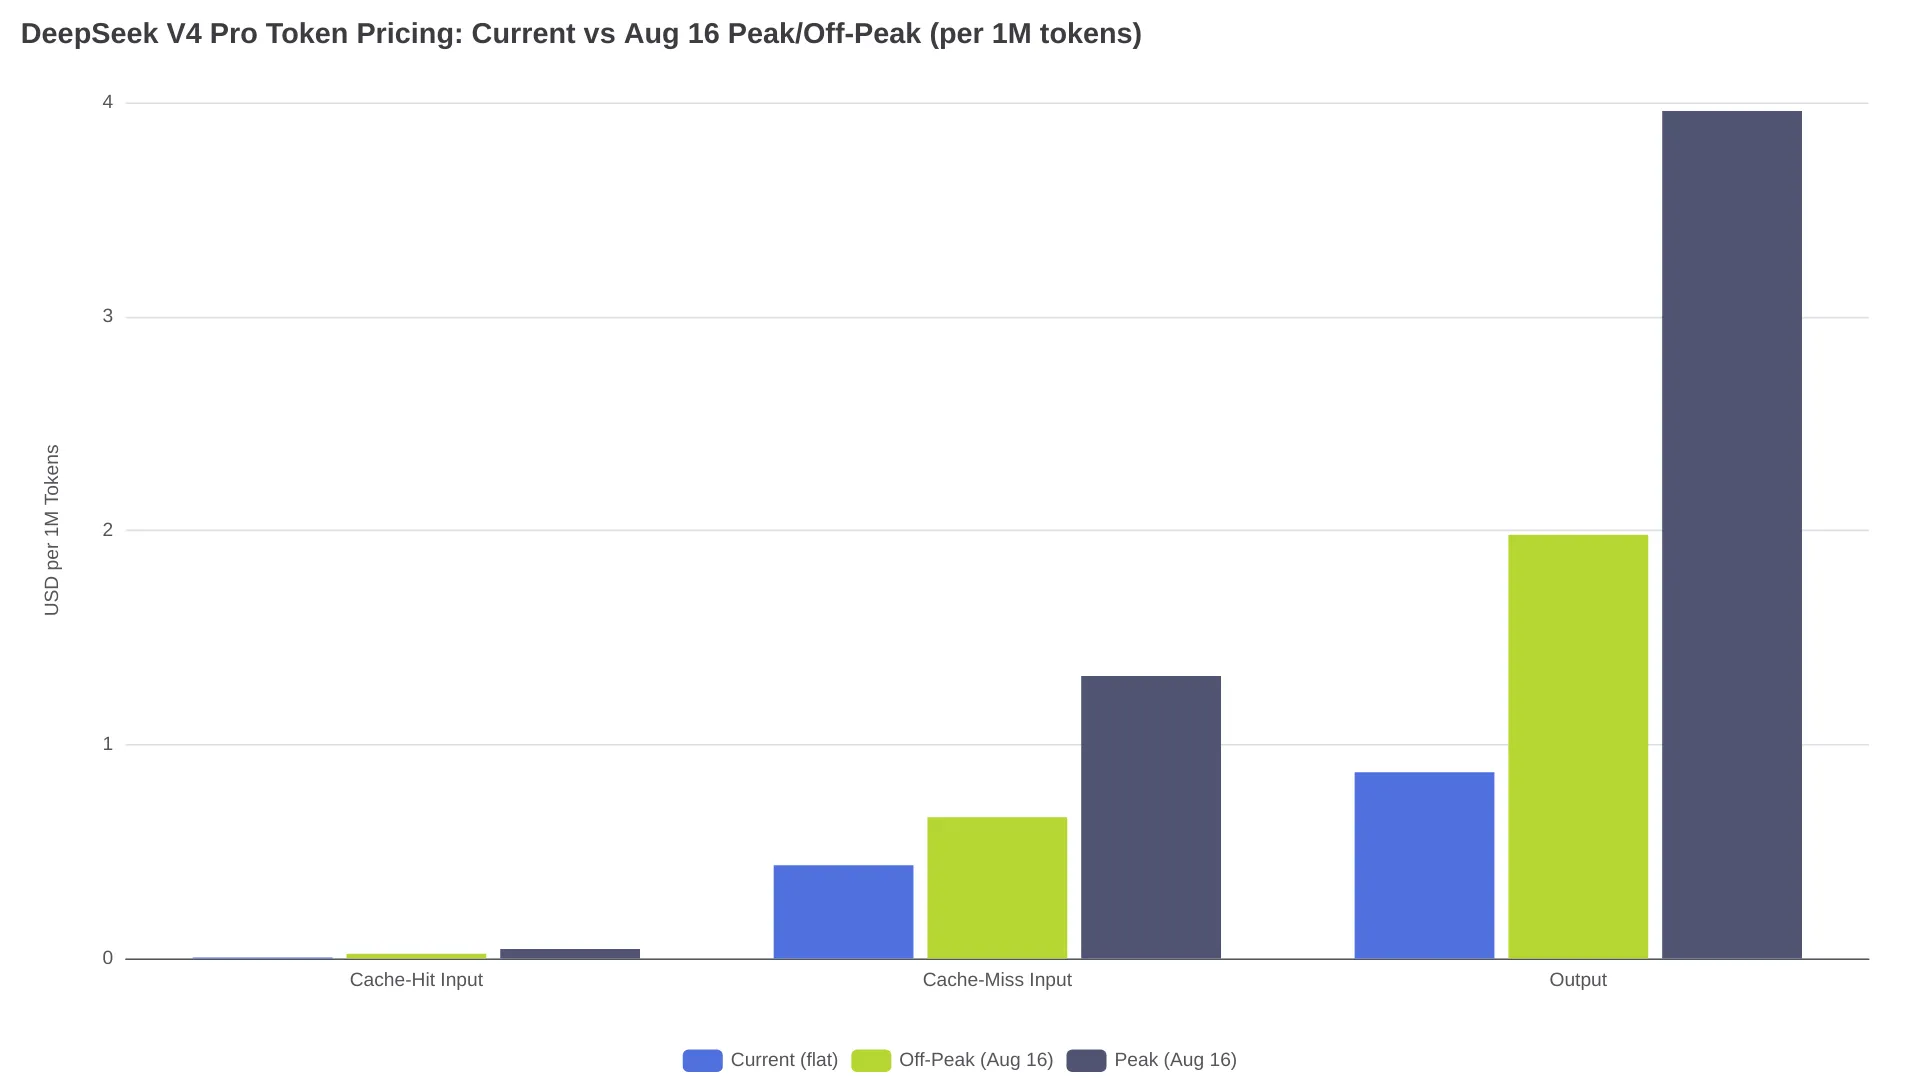
La salida en horario punta se multiplica por 4,6. Para los agentes en producción, el cambio más delicado está en los aciertos de caché: antes, la tarifa de $0.003625/M era aproximadamente 120 veces menor que la de un fallo de caché. Después del 16 de agosto, la diferencia será de 30 veces en ambos tramos (0.022 frente a 0.66 en valle y 0.044 frente a 1.32 en punta), mientras que el coste absoluto de los aciertos subirá entre 6 y 12 veces.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| Categoría de cobro | Tarifa plana actual | Valle (16 de agosto) | Punta (16 de agosto) | Cambio en punta |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.0028/M | $0.007/M | $0.014/M | +400% |
| Entrada, fallo de caché | $0.14/M | $0.22/M | $0.44/M | +214% |
| Salida | $0.28/M | $0.66/M | $1.32/M | +371% |
Límite de concurrencia: 2.500 solicitudes simultáneas, cinco veces más que la asignación de Pro.
Cuándo empiezan las horas punta según tu zona horaria
| Zona horaria | Franja punta 1 | Franja punta 2 |
|---|---|---|
| Pekín (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| Londres (UTC+1) | 02:00–05:00 | 07:00–11:00 |
| Nueva York (UTC-4) | 21:00–00:00 (día anterior) | 02:00–06:00 |
| San Francisco (UTC-7) | 18:00–21:00 | 23:00–03:00 |
Para los equipos de Estados Unidos, las franjas punta se concentran sobre todo durante la noche y la tarde. En China y Asia Oriental coinciden con el horario laboral habitual.
El coste real: Pro con 10.000 llamadas al día
Imaginemos un agente en producción que envía en cada llamada un prefijo almacenado en caché de 50 K tokens y genera una respuesta de 2 K tokens.
| Componente del coste | Tarifa plana actual | Valle | Punta |
|---|---|---|---|
| Entrada con acierto de caché (500 M tokens) | $1.81 | $11.00 | $22.00 |
| Salida (20 M tokens) | $17.40 | $39.60 | $79.20 |
| Total diario | $19.21 | $50.60 | $101.20 |
| Total en 30 días | $576 | $1,518 | $3,036 |
En la práctica, las cargas de trabajo mezclan llamadas en horario punta y valle, por lo que el coste quedará entre estos extremos. La misma carga con Flash cuesta 7,00 $ al día con la tarifa plana actual, aproximadamente 16,70 $ al día en valle y aproximadamente 33,40 $ al día en punta. Los 33,40 $ diarios de Flash en punta superan los 19,21 $ diarios de Pro con la tarifa plana actual, pero los 16,70 $ de Flash en valle quedan por debajo.
Migración: IDs de modelo, control del razonamiento y fijación de versiones
Retirada de endpoints y nuevos IDs
El anuncio de la versión preliminar del 24 de abril indicaba que deepseek-chat y deepseek-reasoner quedarían «completamente retirados e inaccesibles después del 24 de julio de 2026 a las 15:59 (hora UTC)». Cualquier código que siga utilizando esas cadenas debe actualizarse.
| Endpoint antiguo | A qué dirigía las solicitudes | Reemplazo |
|---|---|---|
deepseek-chat | V4 Flash, sin razonamiento | deepseek-v4-flash |
deepseek-reasoner | V4 Flash, con razonamiento | deepseek-v4-flash (con razonamiento) o deepseek-v4-pro |
Muchos equipos daban por hecho que deepseek-reasoner ofrecía razonamiento de nivel Pro, pero en realidad dirigía las peticiones a Flash con el modo de razonamiento activado. Migrar a deepseek-v4-pro cambia la calidad de las respuestas y eleva la factura.
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
La URL base sigue siendo https://api.deepseek.com. No cambia ninguna otra parte de la estructura de la petición.
Niveles de esfuerzo de razonamiento
V4-Pro-0813 incorpora tres niveles de esfuerzo de razonamiento: low para tareas sencillas, high para el trabajo habitual con agentes y max para problemas complejos. El modo de razonamiento viene activado por defecto, y los tokens de razonamiento cuentan como salida facturable. Si una petición genera 3.000 tokens de razonamiento antes de producir una respuesta de 200 tokens, pagarás 3.200 tokens de salida con la tarifa punta: 0,0127 $ por llamada, frente a 0,0008 $ si solo se facturase la respuesta. El nivel low es el que DeepSeek recomienda para tareas sencillas en las que el razonamiento prolongado añade coste, pero no valor.
Fijar una versión para producción
El alias deepseek-v4-pro apunta a la compilación actual y puede cambiar cuando DeepSeek publique futuras versiones. Para mantener un comportamiento reproducible en producción, comprueba si tu proveedor admite identificadores de modelo fechados. Algunos gateways de terceros ofrecen rutas fijadas; antes de utilizarlas en producción, verifica en la documentación del proveedor qué compilación sirve cada ruta.
Compatibilidad con protocolos de API
Los dos modelos admiten los formatos OpenAI ChatCompletions y Anthropic API. El endpoint de Anthropic es https://api.deepseek.com/anthropic. La compatibilidad con Responses API y Codex es nueva en la versión GA. Si aparecen errores después de la migración, prueba ambos protocolos.
Pro frente a Flash: ¿cuál conviene después de la subida de precios?
V4-Pro-0813 supera a V4-Flash-0731 en las diez métricas publicadas. La diferencia depende de la complejidad de la tarea:
| Benchmark | Pro 0813 | Flash 0731 | Diferencia |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 puntos |
| DeepSWE | 62.7 | 54.4 | 8.3 puntos |
| AutomationBench | 31.8 | 25.1 | 6.7 puntos |
| Cybergym | 83.3 | 76.7 | 6.6 puntos |
Elige V4 Pro si:
- El ciclo de tu agente reutiliza constantemente un prefijo grande y estable. Los ahorros por aciertos de caché siguen aplicándose, aunque sobre una tarifa base más alta
- Necesitas la mayor cantidad de parámetros de Pro para razonamiento complejo, uso de herramientas en varios pasos o generación de código a gran escala
- Tu carga de trabajo puede funcionar con el límite de 500 solicitudes simultáneas
Elige V4 Flash si:
- Tus tareas son sencillas, de gran volumen o sensibles a la latencia
- Necesitas el límite de 2.500 solicitudes simultáneas para cargas con muchas ramificaciones
- La diferencia de calidad no justifica pagar tres veces más por la salida
Para una comparativa más amplia entre ambos modelos, consulta nuestro análisis de DeepSeek V4 Flash frente a Pro. Si quieres probar el modelo sin gestionar claves de API, puedes acceder directamente a la página de chat de V4 Pro y a la página de chat de V4 Flash.
Preguntas frecuentes
¿Están disponibles los pesos de V4-Pro-0813 para alojarlo por cuenta propia?
Sí: tienen licencia MIT y están disponibles en Hugging Face, con rutas para vLLM y SGLang. Consulta la sección anterior sobre pesos abiertos para conocer los detalles de despliegue.
¿Debería pasar de V4 Flash a V4 Pro con el lanzamiento GA?
Para la mayoría de las cargas sensibles al coste, Flash sigue ofreciendo una mejor relación calidad-precio. En los benchmarks queda por detrás de Pro entre 0,5 puntos, en Agents' Last Exam, y 8,5 puntos, en HLE con herramientas, pero la salida cuesta tres veces menos. Da el salto a Pro si tu carga necesita toda su cantidad de parámetros para razonamiento complejo en varios pasos o generación de código a gran escala.
¿Cómo puedo reducir el impacto de la subida de precios?
Hay tres palancas: programa los trabajos por lotes y los agentes que puedan esperar fuera de las horas punta (01:00–04:00 y 06:00–10:00 UTC); maximiza los aciertos de caché manteniendo estables los prefijos de las peticiones; y deriva las tareas sencillas a Flash o utiliza el nivel de razonamiento low en Pro.
¿Las tarifas punta y valle también se aplican a la aplicación y la web de DeepSeek?
La página oficial de precios solo documenta la facturación de tokens de la API. El calendario indicado se aplica a las llamadas directas a la API; los proveedores gateway pueden repercutirlo, añadir su propio margen o utilizar tarifas independientes. Consulta la página de precios para conocer la información vigente.