 AIREITER
Die auffälligsten Werte von Qwen-UI-Agent stammen aus dem mobilen Einsatz: 92.2% bei MobileWorld-Real auf echten Geräten und 97.5% bei AndroidDaily. Doch das 27B-Modell hinter diesen Ergebnissen ist bislang weder als öffentliches Gewicht noch per API bestätigt verfügbar. Aktuell gibt es den technischen Report, Demos und die kleineren MAI-UI-Vorgänger zum Download. Genau diese Lücke zwischen Spitzenplatz auf den Bestenlisten und praktischer Verfügbarkeit prägt den Release – hier folgen daher sämtliche offiziellen Werte und eine klare Bestandsaufnahme dessen, was tatsächlich zugänglich ist.
Alle Benchmark-Ergebnisse von Qwen-UI-Agent
Qwen-UI-Agent ist ein grundlegender GUI-Agent des Tongyi-MAI-Teams von Alibaba, veröffentlicht als technischer Report am 30. Juli 2026 (arXiv 2607.28227). Ein Modell deckt mobile Geräte, Computersteuerung, Web und DeepSearch ab. Der einheitliche Aktionsraum umfasst GUI-Operationen, CLI-Ausführung und gebündelte Aktionsfolgen. Auf der offiziellen Ergebnisseite führt Qwen-UI-Agent alle gezeigten Mobile- und Grounding-Benchmarks an, liegt bei OSWorld-Verified auf Platz zwei und beim Langzeittest OSWorld-v2 auf Platz drei. Der Report bewertet Varianten mit 27B, 35B-A3B und 4B; die folgenden Werte gehören zum 27B-Flaggschiff.
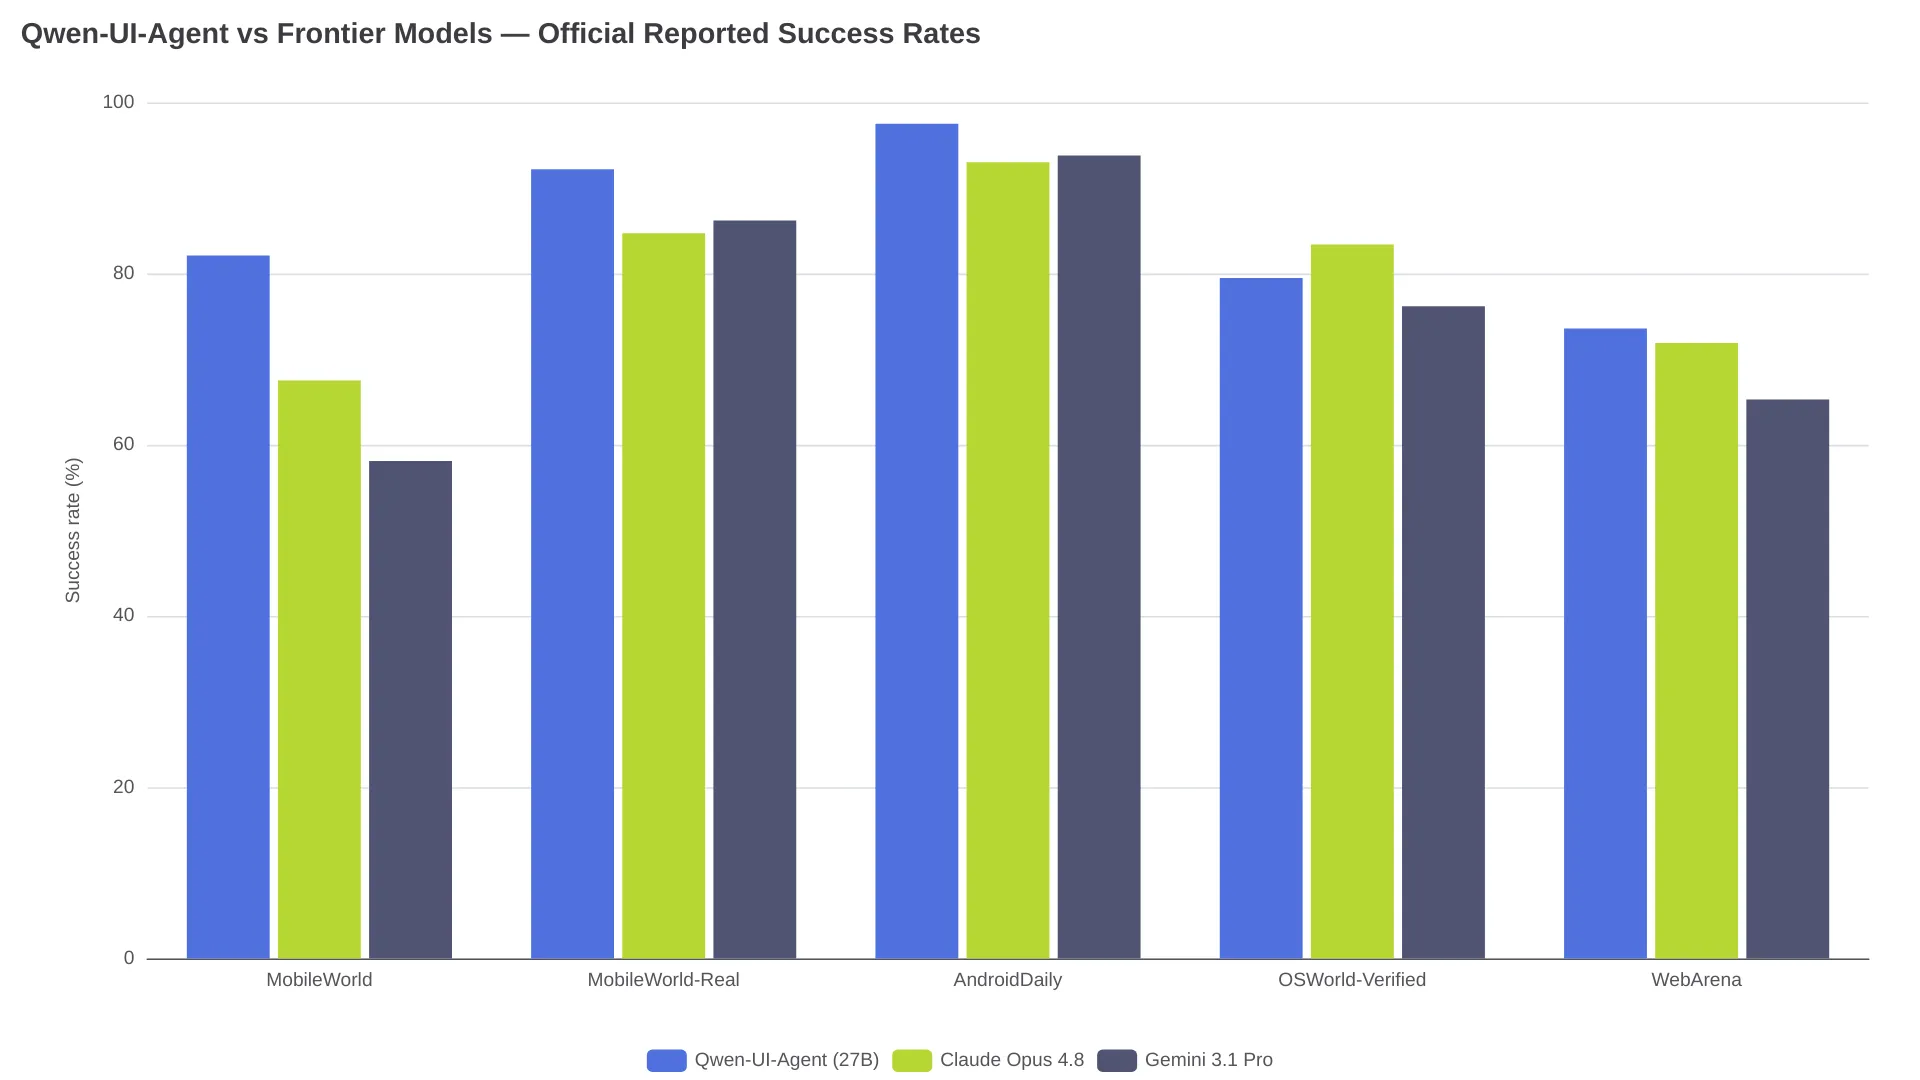
Mobil: Hier liegt der Anspruch auf Platz eins
Im mobilen Bereich beansprucht der Report den Stand der Technik – und der Vorsprung ist deutlich. Beim reinen GUI-Split von MobileWorld erreicht Qwen-UI-Agent 82.1%: 8.9 Punkte mehr als das nächstbeste Generalistenmodell, Seed 2.1 Pro mit 73.2%, und 38.2 Punkte vor dem stärksten spezialisierten GUI-Agenten, GUI-Owl-1.5-32B-Instruct mit 43.9%.
| Modell | MobileWorld (nur GUI) | MobileWorld-Real | AndroidDaily |
|---|---|---|---|
| Qwen-UI-Agent (Alibaba) | 82.1 | 92.2 | 97.5 |
| Seed 2.1 Pro (ByteDance) | 73.2 | 88.7 | 95.2 |
| Claude Opus 4.8 (Anthropic) | 67.5 | 84.7 | 93.0 |
| Gemini 3.1 Pro (Google) | 58.1 | 86.2 | 93.8 |
| Qwen 3.7 Plus (Alibaba) | 62.3 | 72.7 | 79.8 |
In den offiziellen Tabellen steht bei den mobilen Zeilen GPT-5.6 Sol mit 70.1 / 85.4 / 92.6, bei den Desktop-Zeilen hingegen GPT-5.5. Wer einzelne „GPT“-Werte zitiert, sollte diese Unterscheidung im Blick behalten.
MobileWorld-Real ist der zentrale Benchmark und stammt von den Autoren selbst: 409 End-to-End-Aufgaben über 104 reale Android-Apps aus sieben Alltagsbereichen. Die Tests laufen auf echten Geräten, mit realen Konten und Störungen aus der Praxis; bewertet wird per Mehrheitsentscheidung von fünf VLMs.
Computersteuerung: stark, aber nicht führend
Auf dem Desktop wirkt die Formulierung „competitive“ im Report bewusst zurückhaltend. Mit 79.5% bei OSWorld-Verified landet Qwen-UI-Agent auf Rang zwei, 3.9 Punkte hinter Claude Opus 4.8. Im Langzeitszenario OSWorld-v2 sind die 40.0% ein Wert für Teilerfolg, nicht für vollständige Aufgabenerledigung; binär gemessen liegt das Modell bei 13.9%. Claude Opus 4.8 mit 54.8 und GPT-5.5 mit 49.5 liegen dort klar davor.
| Modell | OSWorld-Verified | OSWorld-v2 (Teilerfolg) | OSWorld-v2 (binär) |
|---|---|---|---|
| Claude Opus 4.8 | 83.4 | 54.8 | nicht berichtet |
| Qwen-UI-Agent | 79.5 | 40.0 | 13.9 |
| Seed 2.1 Pro | 78.8 | nicht berichtet | nicht berichtet |
| GPT-5.5 | 78.7 | 49.5 | 13.0 |
| MiniMax M3 | nicht berichtet | 22.3 | nicht berichtet |
Der Effizienzvorteil ist allerdings messbar: Gebündelte Aktionen senken den Durchschnitt auf 135.8 Schritte pro Aufgabe, gegenüber 326.7 bei MiniMax M3 und 173.5 bei Qwen 3.7 Plus. Gleichzeitig schlägt das Modell beim Teilerfolg jedes Modell mit offenen Gewichten um mindestens 17 Punkte. Bei OSWorld-v2 entfallen mehr als 50% der Agentenoperationen auf CLI-Befehle – das hybride GUI- und CLI-Konzept trägt hier nachweislich zum Ergebnis bei.
Browser und DeepSearch
Bei WebArena liegt Qwen-UI-Agent mit 73.6% vorn, vor Claude Opus 4.8 mit 71.9, GPT-5.5 mit 69.5 und Gemini 3.1 Pro mit 65.3. Bei Rechercheaufgaben erreicht das Modell auf BrowseComp 64.1 gegenüber 61.0 für die Qwen3.5-27B-Basis und auf BrowseComp-ZH 75.0 gegenüber 62.1. Das DeepSearch-Training verbessert also nicht nur das gezielte Klicken.
GUI-Grounding: überall auf Rang eins
Auch beim Grounding – also dem Treffen des richtigen Pixels anhand einer visuellen Anweisung – ist die Bilanz eindeutig: Laut offizieller Ergebnisseite liegt Qwen-UI-Agent bei jedem dort aufgeführten Grounding-Benchmark an erster Stelle.
| Benchmark | Qwen-UI-Agent | Bester Wettbewerber |
|---|---|---|
| ScreenSpot-Pro (ohne Zoom) | 76.6 | 72.9 (GUI-Owl-1.5) |
| ScreenSpot-Pro (Zoom-in) | 81.5 | 80.7 (Seed 2.1 Pro) |
| SS-V2 | 97.5 | 96.6 (Seed 2.1 Pro / Qwen 3.7 Plus) |
| MM-GUI-L2 | 92.6 | 91.3 (MAI-UI) |
| OSW-G-R | 78.5 | 78.2 (Qwen 3.7 Plus) |
| UI-Vision | 70.0 | 68.0 (Qwen 3.7 Plus) |
Der Preis für den Generalisten ist gering
Auf GUI-Aufgaben spezialisierte Modelle verlieren häufig ihre allgemeinen Sprachfähigkeiten. Bei Qwen-UI-Agent ist das weitgehend nicht der Fall: MMLU-Pro liegt bei 86.5 gegenüber 86.0 für Qwen3.5-27B, IFEval bei 90.2 gegenüber 90.4. Gegenüber dem spezialisierten Feld ist der Abstand dagegen massiv.
| Benchmark | Qwen-UI-Agent | Qwen3.5-27B | UI-Venus 30B-A3B | GUI-Owl 32B | OpenCUA-72B |
|---|---|---|---|---|---|
| Tau2-Bench | 89.9 | 89.2 | 22.7 | 6.1 | 14.4 |
| Terminal-Bench 2.0 | 50.1 | 41.1 | 3.2 | 0.0 | 9.0 |
| BFCL-v4 | 74.2 | 71.3 | 19.8 | 32.7 | 28.3 |
| BrowseComp | 64.1 | 61.0 | nicht berichtet | nicht berichtet | nicht berichtet |
| QwenClawBench | 44.2 | 48.5 | 6.4 | 5.1 | 11.4 |
Die einzige sichtbare Niederlage gegen die eigene Basis gibt es bei QwenClawBench: 44.2 gegenüber 48.5. Außerdem kennzeichnet die offizielle Seite diese breiteren Fähigkeitswerte als in der Evaluierungsumgebung der Autoren reproduziert.
So wurde Qwen-UI-Agent trainiert
Laut technischem Report stammen die Trainingsdaten von einer Flotte realer Geräte: mehr als 100 physische Smartphones mit über 150 Apps speisen einen agentengesteuerten Daten-Flywheel, der eigene Aufgaben konstruiert und analysiert. Auf das Supervised Fine-Tuning folgt mehrstufiges RL auf Trajektorien mit mehr als 100 Turns, ausgerollt über mehr als 10,000 parallele Umgebungen.
Wie belastbar ist die Bestenliste?
Drei Einschränkungen auf der offiziellen Seite sollten bei jeder zitierten Zahl mitgenannt werden. Erstens ist MobileWorld-Real ein Benchmark der Autoren selbst. Zweitens wurden mit einem Dolch markierte Basiswerte von den Autoren in ihrer eigenen Umgebung reproduziert – Harness, Judge, Simulator und Aufgabenauswahl können von den offiziellen Auswertungen anderer Anbieter abweichen. Drittens steht die 40.0%-Angabe für OSWorld-v2 für Teilerfolg, nicht für die Erfolgsquote. (Quelle: Anmerkungen auf der offiziellen Ergebnisseite und der technische Report.)
„Alibabas neuer GUI-Agent gewinnt auf dem Smartphone und kommt auf dem Desktop ins Stocken.“ – @Daily_AI_Brief auf X, mit dem zusätzlichen Hinweis: „Alibaba scored every baseline in its own environment.“
Auch unabhängige Einordnungen auf X kommen zu diesem Schluss. Eine japanischsprachige Analyse von @itarutomy hebt die Führung auf echten Mobilgeräten hervor, betont aber zugleich die zweiten Plätze bei den Desktop-Werten. Der offizielle Ankündigungs-Thread von Pengxiang Li aus Tongyi Lab (@oliverlee1999) ist die Primärquelle für den Release. Unterm Strich ist MobileWorld-Real ein starkes, aber noch zu reproduzierendes Ergebnis; OSWorld-Verified eignet sich besser für übertragbare Vergleiche, da dieser Benchmark nicht von den Autoren eingeführt wurde.
So ist Qwen-UI-Agent heute verfügbar
Qwen-UI-Agent ist derzeit ein Forschungsrelease: Paper, Projektseite und Code-Repositories sind öffentlich, ein öffentlich bestätigter Modell-Checkpoint fehlt jedoch. Das enthalten die einzelnen öffentlich verfügbaren Artefakte.
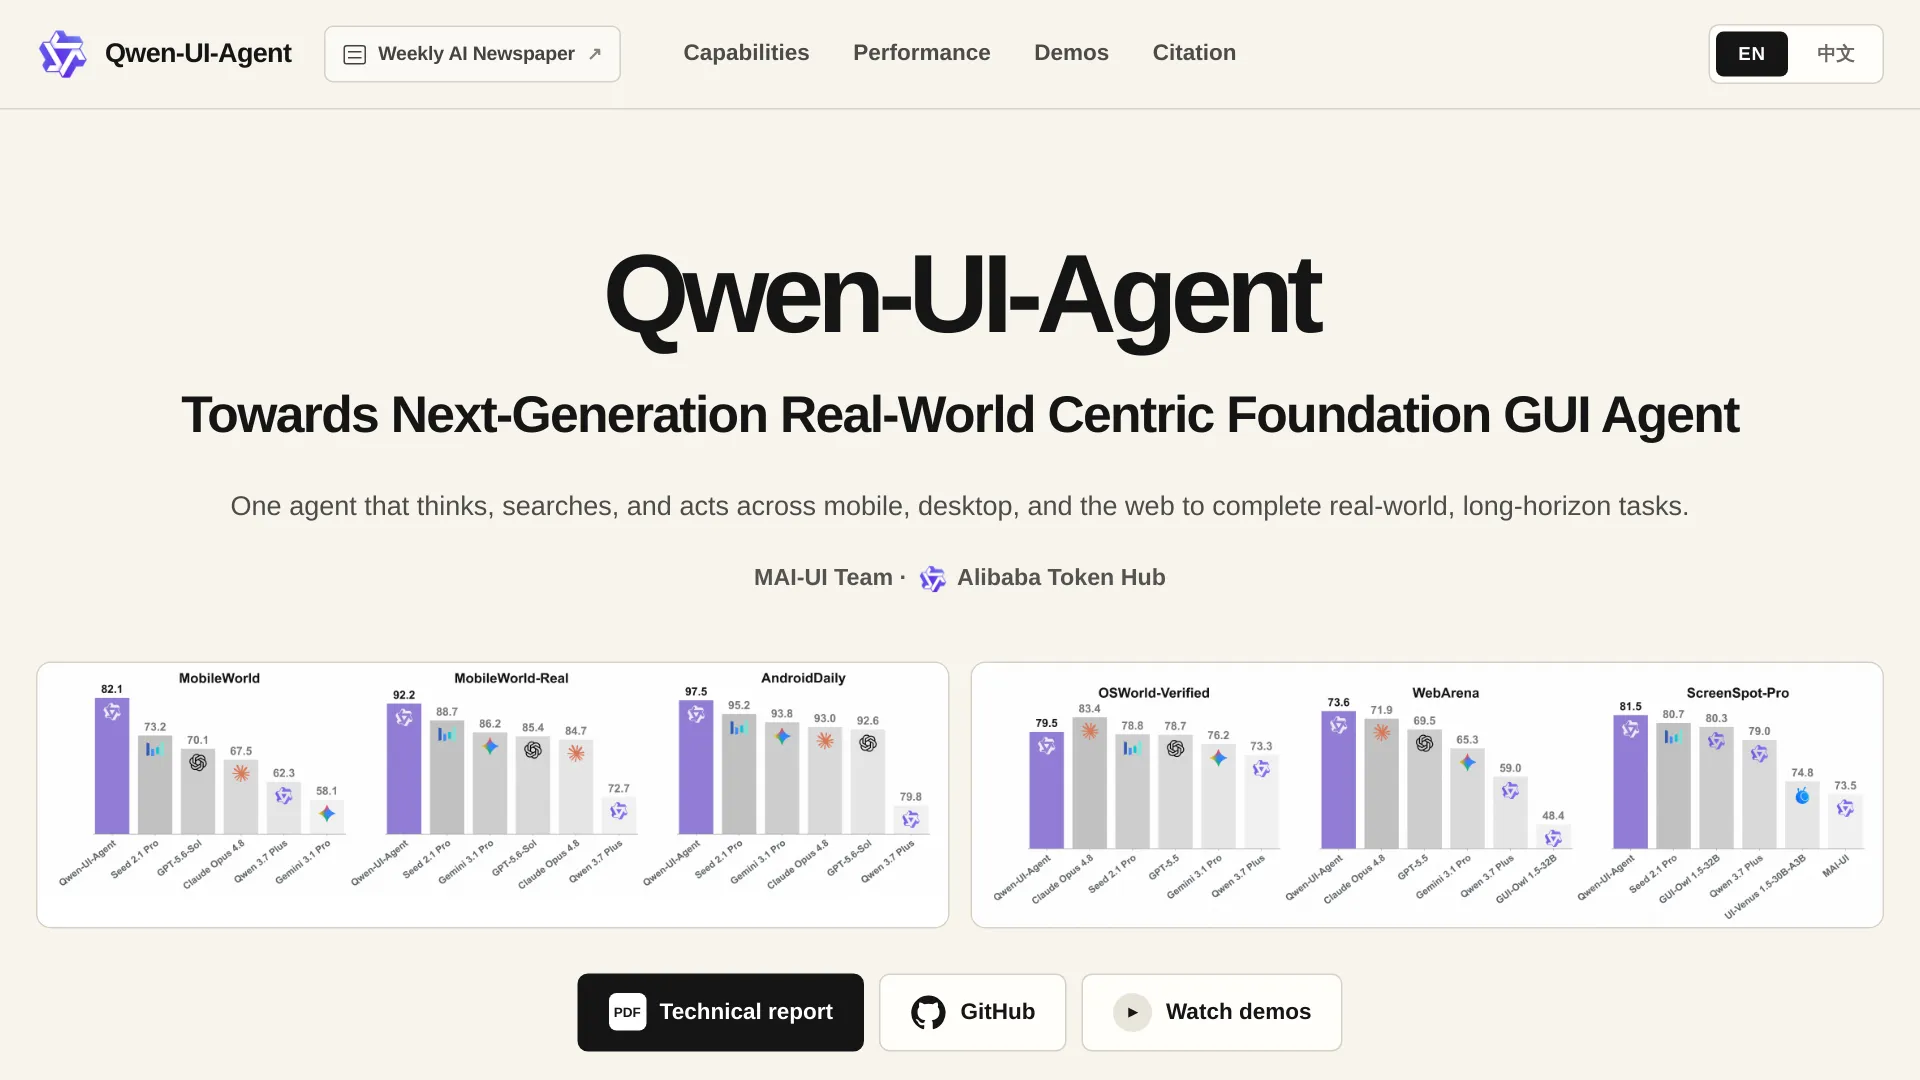
Bestandsaufnahme der Artefakte
| Artefakt | Link | Inhalt |
|---|---|---|
| Technischer Report | arxiv.org/abs/2607.28227 | Vollständiges Paper, eingereicht am 30. Juli 2026; PDF, HTML und TeX-Quelle |
| Projektseite | tongyi-mai.github.io/Qwen-UI-Agent | Fähigkeitsdemos, vollständige Benchmark-Charts, Zitierinformationen |
| MAI-UI-Repository | github.com/Tongyi-MAI/MAI-UI | Apache-2.0-Repository, für Qwen-UI-Agent umbenannt; verweist auf die im Dezember 2025 veröffentlichten Hugging-Face-Checkpoints MAI-UI-8B und MAI-UI-2B |
| Qwen-UI-Agent-Repository | github.com/Tongyi-MAI/Qwen-UI-Agent | Nur Quellcode der Website – laut Repository enthält es weder Modell, Trainingscode noch Agentenimplementierung |
Das MAI-UI-Repository ist die offizielle Fortsetzung dieser Linie: Es kündigte Qwen-UI-Agent am 30. Juli 2026 an und verlinkt derzeit die einzigen herunterladbaren Checkpoints dieser Modellfamilie.
Die Lage bei den Gewichten
Herunterladbar sind ausschließlich MAI-UI-8B und MAI-UI-2B, die Vorgänger vom Dezember 2025, verlinkt über die Hugging-Face-Verweise im MAI-UI-Repository. Für Qwen-UI-Agent 27B, 35B-A3B oder 4B ist kein öffentlich verfügbarer Checkpoint bestätigt. Der Verfügbarkeitsstatus wurde Ende August 2026 anhand der offiziellen Repositories und der Projektseite geprüft; keine davon wies auf einen Release hin. Links zu MAI-UI-Checkpoints oder zum Website-Quellcode-Repository sind nicht mit Qwen-UI-Agent-Modellgewichten gleichzusetzen.
Noch keine API und kein Self-Hosting
In keinem offiziellen Kanal findet sich derzeit ein öffentlicher Qwen-UI-Agent-API-Endpunkt, ein gehostetes Produkt oder ein vLLM-/Ollama-Paket. Praktisch bedeutet das: Für Desktop-Workflows, die produktiv ausgeliefert werden müssen, sprechen die berichteten OSWorld-Ergebnisse für Claude Opus 4.8. Für GUI-Experimente mit offenen Gewichten bleibt MAI-UI 2B/8B mit eigenem Harness der verfügbare Weg – und das ist MAI-UI, nicht Qwen-UI-Agent. Release-Ankündigungen erscheinen in den offiziellen Tongyi-MAI-Repositories und Qwen-Kanälen. Für die allgemeine Qwen-Modellreihe, die per API verfügbar ist, listet der AIReiter Qwen model catalog aktuelle Endpunkte und Preise.
Qwen-UI-Agent im Stammbaum der Modellfamilie
Qwen-UI-Agent ist die dritte Generation von Alibabas GUI-Agentenlinie: UI-TARS etablierte 2025 den Qwen-Ansatz für GUI-Aufgaben. MAI-UI (arXiv 2512.22047, Dezember 2025) führte den auf reale Nutzung ausgerichteten Daten-Flywheel ein und veröffentlichte Gewichte mit 2B und 8B offen. Qwen-UI-Agent skaliert dieses Rezept auf 27B und kombiniert GUI- mit CLI-Ausführung. In beiden OSWorld-Metriken der obigen Tabellen liegt Claude Opus 4.8 vorn.
Qwen-UI-Agent: Häufige Fragen
Ist Qwen-UI-Agent Open Source?
Die Code-Repositories stehen unter Apache-2.0, und der Report ist öffentlich. Für das Modell selbst sind jedoch keine offenen Gewichte bestätigt. Downloadbar sind nur die Vorgänger-Checkpoints MAI-UI-8B und MAI-UI-2B von Hugging Face aus dem Dezember 2025. Für keinen Qwen-UI-Agent-Checkpoint mit 27B, 35B-A3B oder 4B war zum Zeitpunkt dieses Artikels ein öffentlicher Release bestätigt.
Lässt sich Qwen-UI-Agent heute lokal ausführen?
Nein. Es gibt kein verifiziertes lokales Setup: keinen Checkpoint, kein GGUF- oder Ollama-Paket und keine vLLM-Anleitung. Lokale Experimente beschränken sich auf MAI-UI 2B/8B mit eigenem Harness.
Gibt es eine Qwen-UI-Agent-API?
Nein, ein öffentlicher Endpunkt oder ein gehostetes Produkt wurde nicht angekündigt. Für Release-Ankündigungen sollten die offiziellen Tongyi-MAI-GitHub-Repositories und die Kanäle des Qwen-Teams beobachtet werden.
Wie schneidet Qwen-UI-Agent bei Computersteuerung gegen Claude Opus 4.8 ab?
Claude Opus 4.8 führt bei OSWorld-Verified mit 83.4 gegenüber 79.5 und bei OSWorld-v2-Teilerfolg mit 54.8 gegenüber 40.0. Qwen-UI-Agent liegt dagegen bei WebArena mit 73.6 gegenüber 71.9 sowie bei jedem gezeigten mobilen Benchmark vorn. Für langfristige Desktop-Aufgaben spricht der aktuelle Stand für Claude; bei Mobile-First-Szenarien sind die berichteten Werte von Qwen-UI-Agent am stärksten.
Was ist MobileWorld-Real?
Ein von den Qwen-UI-Agent-Autoren entwickelter Android-Benchmark auf echten Geräten: 409 Aufgaben über 104 laufende Apps aus sieben Alltagsbereichen, bewertet per Mehrheitsentscheidung von fünf VLMs. Die Resultate sind selbst berichtet und warten auf unabhängige Reproduktion.
Was die Bewertung verändern würde
Drei Signale würden diese Einschätzung substanziell verändern:
| Signal | Warum es wichtig ist |
|---|---|
| Ein Qwen-UI-Agent-Checkpoint unter der Tongyi-MAI-Präsenz auf Hugging Face | Macht aus dem Forschungsrelease eine umsetzbare Option und ermöglicht Zahlen von Dritten |
| Eine OSWorld-Verified-Reproduktion außerhalb von Alibabas Harness | Klärt, ob 79.5% auch jenseits der Umgebung der Autoren Bestand haben |
| Jede Produktoberfläche: API, Qwen-App-Integration oder Preview | Verlagert den Vergleich von Paper-Tabellen hin zu Abwägungen für den Produktiveinsatz |
Bis dahin bleibt der zentrale Zielkonflikt bestehen: Die mobilen Spitzenwerte in den bisher veröffentlichten Vergleichen sind selbst berichtet und stammen aus einem Benchmark, den dasselbe Team entwickelt hat.
Weiterführende Artikel: Alibabas neueres Generalisten-Flaggschiff und der Status seiner offenen Gewichte werden in Qwen3.8-Max open weights behandelt; die Endpoint-Kosten finden sich im Qwen3.8-Max API pricing guide.