 AIREITER
Nach drei Wochen mit dem Status „kommt bald“ sind die Gewichte von Qwen3.8-2.4T-A95B am 12. August 2026 auf ModelScope veröffentlicht worden. Die beeindruckende Zahl: 2,4 Billionen Parameter insgesamt. Pro Token werden davon allerdings nur 95 Milliarden aktiviert. Der Haken: Selbst in 4-Bit-Quantisierung belegt das Modell rund 1,2 TB VRAM. Lokal lässt es sich damit außerhalb eines Rechenzentrums kaum betreiben. Wir zeigen, was genau veröffentlicht wurde, welche Kosten anfallen und wann die API schlicht die vernünftigere Lösung ist.
Qwen3.8-2.4T-A95B steht zum Download bereit
Die Gewichte sind da: Alibabas Qwen-Team hat den Checkpoint für Qwen3.8-2.4T-A95B am späten 12. August über seinen ModelScope-Account veröffentlicht. Damit ist es das erste Modell aus der Qwen-Max-Klasse mit offenen Gewichten. Die drei Vorgänger – Qwen3.5-Max, Qwen3.6-Max und Qwen3.7-Max – blieben ausschließlich per API zugänglich.
Wichtig ist dabei eine Namensfrage, denn „Qwen3.8“ bezeichnet zwei unterschiedliche Dinge:
| Name | Was dahintersteckt | Bezugsquelle |
|---|---|---|
| Qwen3.8-2.4T-A95B | Basismodell mit offenen Gewichten | ModelScope (downloadbarer Checkpoint) |
| Qwen3.8-Max | Cloud-Version mit zusätzlichen Funktionen für den Produktiveinsatz | Alibaba Token Plan, Qoder, QoderWork |
Qwen3.8-Max basiert auf dem Open-Weights-Modell A95B, bringt aber zusätzliche Verbesserungen aus dem Post-Training mit. Alibaba beschreibt dafür ein dreistufiges System aus Skalierung in realen Umgebungen, einheitlichen Reward-Signalen und einem Online-Ausgleich der Trainingsdaten. Wer die Gewichte herunterlädt, erhält also das Basismodell – nicht den kompletten Produktions-Stack von Max.
Anleitungen, die noch von „versprochenen, aber nicht verfügbaren“ Gewichten sprechen, sind inzwischen überholt. Die Veröffentlichung erfolgte innerhalb des von Alibaba angekündigten Zeitfensters in der „Woche vom 10. August“.
Die bestätigten Specs: 95B aktive Parameter und 256K nativer Kontext
Seit dem Preview-Start am 19. Juli war vor allem eine Angabe offen: Wie viele Parameter werden tatsächlich pro Token aktiviert? Mehrere Drittanbieter-Guides führten den Wert ausdrücklich als „nicht veröffentlicht“. Jetzt gibt es die Bestätigung: 95 Milliarden aktive Parameter pro Token bei insgesamt 2,4 Billionen Parametern.
| Spezifikation | Bestätigter Wert |
|---|---|
| Parameter insgesamt | 2.4T |
| Aktive Parameter pro Token | 95B |
| Architektur | MoE (Weiterentwicklung von Qwen3.5s Hybrid-Design) |
| Experten pro MoE-Schicht | 512 |
| Geroutete Experten pro Token | 10 |
| Geteilte Experten pro Token | 1 |
| Nativer Kontext | 262,144 Tokens (256K) |
| Erweiterbarer Kontext | 1,010,000 Tokens (1.01M) |
| Trainingsmethode | Multi-Token Prediction (MTP) |
| Erstes Qwen-Max-Modell mit offenen Gewichten | Ja (12. August 2026) |
Zwei Punkte sind besonders relevant. Erstens beträgt das native Kontextfenster 256K und nicht, wie vielfach angenommen, eine Million Tokens. Die Angabe von 1.01M bezieht sich auf einen erweiterbaren Modus, zu dessen Qualitätseinbußen Alibaba bisher keine Details genannt hat. Zweitens arbeitet das MoE-Routing extrem sparsam: Pro Token werden nur 11 der 512 Experten aktiviert – 10 geroutete plus 1 geteilter Experte. Dieses Aktivierungsverhältnis von rund 4 Prozent (95B von 2.4T) macht einen Preis von 2 US-Dollar pro Million Input-Tokens wirtschaftlich interessant, obwohl das Modell insgesamt 2,4 Billionen Parameter umfasst.
Durch das MTP-Training (Multi-Token Prediction) können kompatible Inferenz-Engines mehrere Tokens pro Forward-Pass vorhersagen und damit möglicherweise den Durchsatz erhöhen. Welche Engines das unterstützen, hat Alibaba bislang nicht spezifiziert.
Self-Hosting in der Praxis: Was 2,4 Billionen Parameter kosten
Auf dem Papier klingen die Specs beeindruckend. Beim Laden des Modells wird jedoch schnell klar, wie hoch die Hardware-Anforderungen sind.
In 4-Bit-Quantisierung benötigen die 2,4 Billionen Parameter ungefähr 1,2 TB Speicher – noch ohne KV-Cache, Aktivierungsspeicher und Laufzeit-Overhead. Eine NVIDIA H200 verfügt über 141 GB Speicher. Acht H200 kommen zusammen auf 1.128 GB und reichen damit nicht aus, um die Gewichte zu laden und gleichzeitig ein brauchbares Kontextfenster bereitzustellen.
| Einsatzszenario | Benötigter VRAM (geschätzt) | Hardware | Praxistauglich? |
|---|---|---|---|
| Volle Präzision (16-Bit) | ~4.8 TB | 34+ H200-GPUs | Nur Rechenzentrum |
| 4-Bit-Quantisierung | ~1.2 TB | 9+ H200-GPUs | Nur Rechenzentrum |
| 1.5-Bit-Quantisierung | ~450 GB | 4+ H200-GPUs | Knapp; Qualitätsverlust unklar |
| Qwen3.8-27B (Alternative) | ~27 GB bei 4-Bit | 1 Consumer-GPU | Ja |
Die 95 Milliarden aktiven Parameter helfen beim Inferenzdurchsatz pro Token, weil bei jedem Forward-Pass nur ein Teil der Experten durchlaufen wird. Den Speicherbedarf für alle 512 Expertengruppen senkt das jedoch nicht. Oder, wie es GEO Toolbox formuliert: „Sparse Activation macht das Modell im großen Maßstab günstig im Betrieb – nicht günstig in der Anschaffung.“
Für den lokalen Betrieb oder einen einzelnen Server ist die Qwen3.8-27B-Variante die realistische Wahl. Sie stammt aus derselben Qwen3.8-Trainingslinie, passt in 4-Bit aber auf eine einzelne Consumer-GPU. Das 2.4T-Modell ist dagegen primär für Forschung und Rechenzentren gedacht.
Wann die API die bessere Lösung ist
Da sich ein MoE-Modell mit 2,4 Billionen Parametern für fast jedes Team nicht selbst hosten lässt, führt der praktische Weg über die API. Alibabas Model Studio listet Qwen3.8 Max mit 2 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens. Damit ist das Modell günstiger als sein Vorgänger und auch als der engste chinesische Konkurrent.
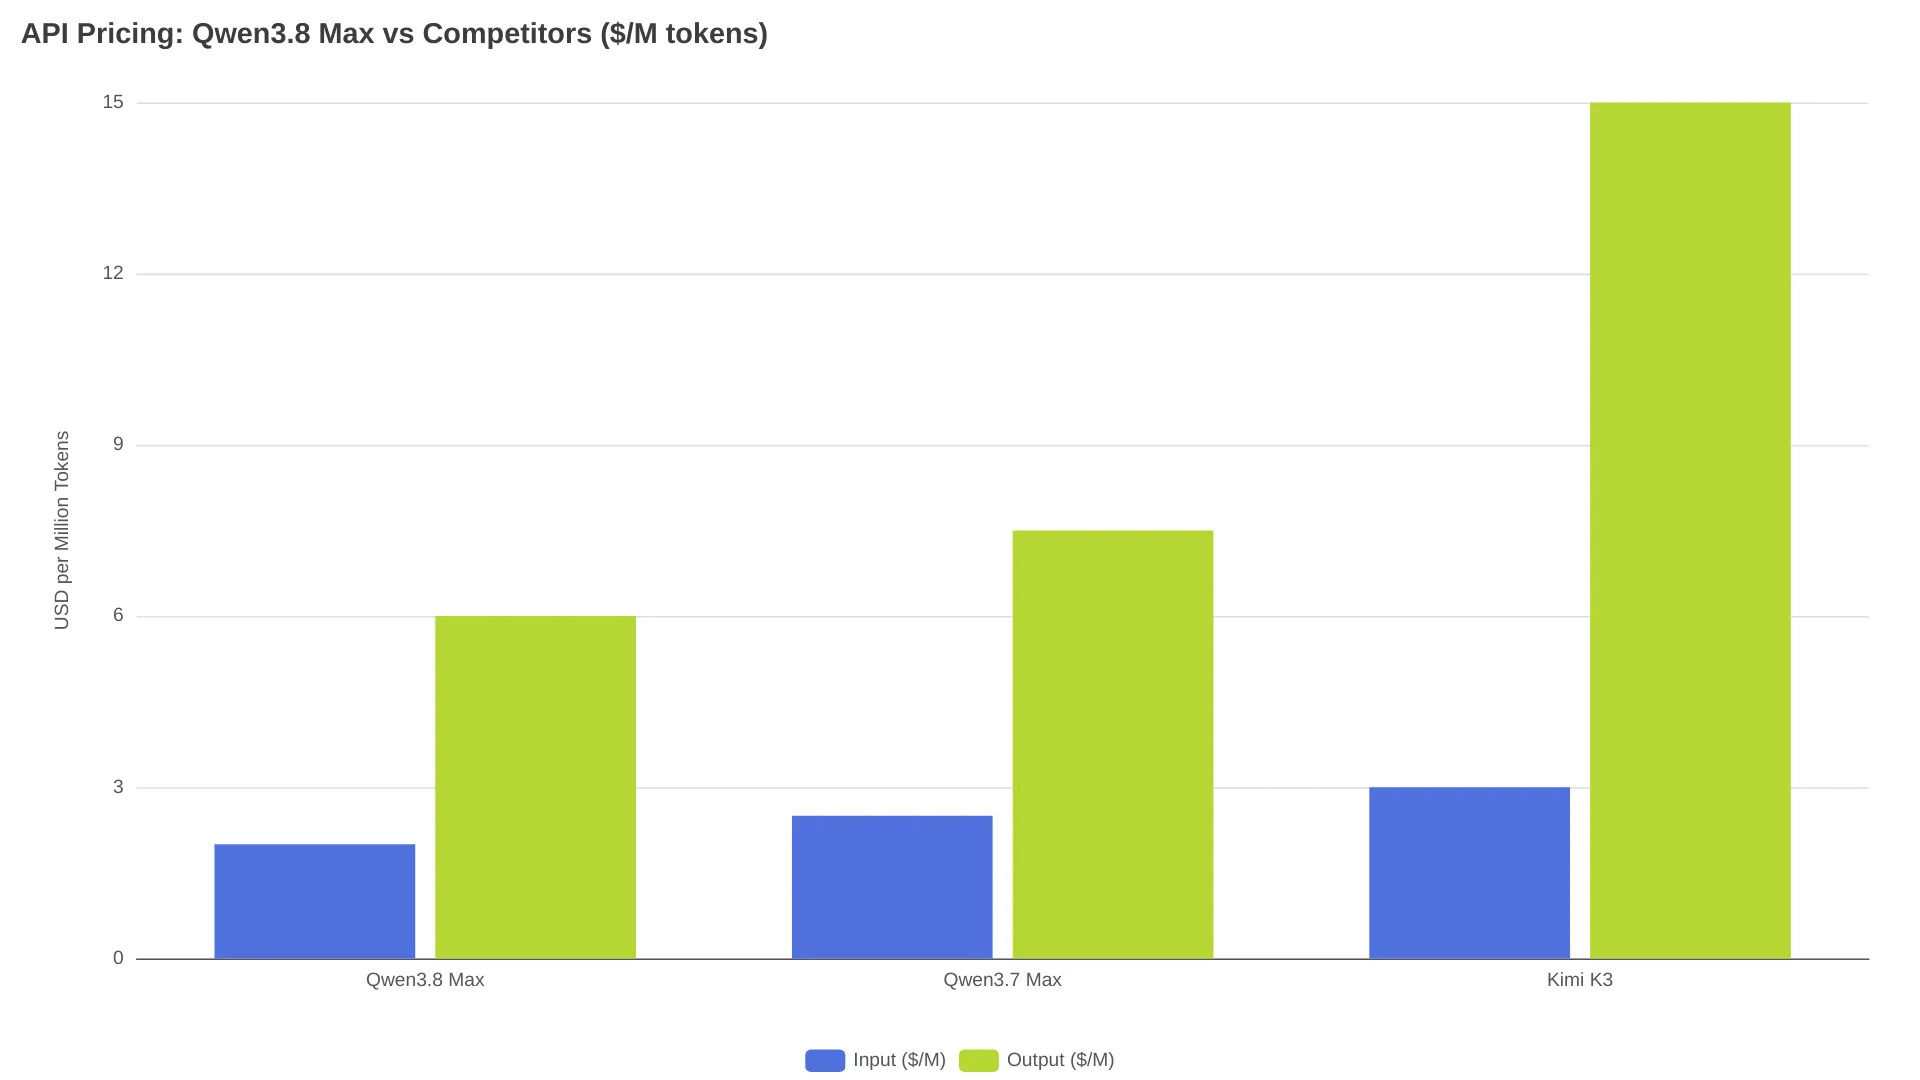
| Modell | Input ($/M) | Output ($/M) | Kontext |
|---|---|---|---|
| Qwen3.8 Max | $2.00 | $6.00 | 256K nativ (1.01M erweiterbar) |
| Qwen3.7 Max | $2.50 | $7.50 | 1M |
| Kimi K3 | $3.00 | $15.00 | 1M |
Neben der Abrechnung pro Token bietet Alibaba drei Abo-Stufen:
- Lite: 6 US-Dollar/Monat (~10.000 Credits)
- Standard: 18 US-Dollar/Monat (~40.000 Credits)
- Pro: 68 US-Dollar/Monat (~160.000 Credits)
Der Token-Plan-Endpunkt unterstützt sowohl OpenAI- als auch Anthropic-kompatible API-Formate. Tools wie Claude Code, Cursor und OpenCode funktionieren dadurch ohne Änderungen am Client. Qoder, Alibabas Coding-Produkt, bietet zu Nebenzeiten (14:00–00:00 UTC) zeitweise Credit-Preise von nur 0.01x des Standardtarifs. Das sind allerdings Startaktionen und keine dauerhaft gesicherten Preise.
Das Abo-Modell hat einen entscheidenden Nachteil: Der Reasoning-Modus von Qwen3.8 Max produziert ausführliche Ausgaben. Entsprechend häufen sich Berichte aus der Community über schnell schwindende Kontingente:
„Qwen denkt wirklich SEHR viel zu lange nach.“ – u/darko, r/Qwen_AI
Im selben Reddit-Thread berichtete ein Lite-Abonnent, sein Wochenkontingent bei ungefähr 50 Millionen Tokens in weniger als zwei Tagen aufgebraucht zu haben. Ein Pro-Nutzer kam mit sieben parallel arbeitenden Agents an einem einzigen Tag auf 500 Millionen Tokens – trotz einer Cache-Trefferquote von 94 Prozent. Der Parameter reasoning_effort lässt sich auf low, medium oder xhigh setzen und steuert direkt, wie viel Reasoning-Output das Modell erzeugt. Davon hängt auch ab, wie schnell die Credits verschwinden. In einem Test sank die Denkzeit mit low auf ungefähr 10 Sekunden pro Anfrage.
Eine ausführliche Kostenaufstellung gibt es in unserem Qwen3.8-Max-API-Preisguide.
Benchmarks: Wo Qwen3.8 Max überzeugt – und wo nicht
Alibaba hat Qwen3.8 Max mit Fable 5 und GPT-5.6 Sol verglichen und dazu eigene Benchmark-Werte veröffentlicht. Das Ergebnis ist durchwachsen. Vor allem die deutliche Differenz zwischen Herstellerangaben und unabhängigen Messungen sollte man im Blick behalten.
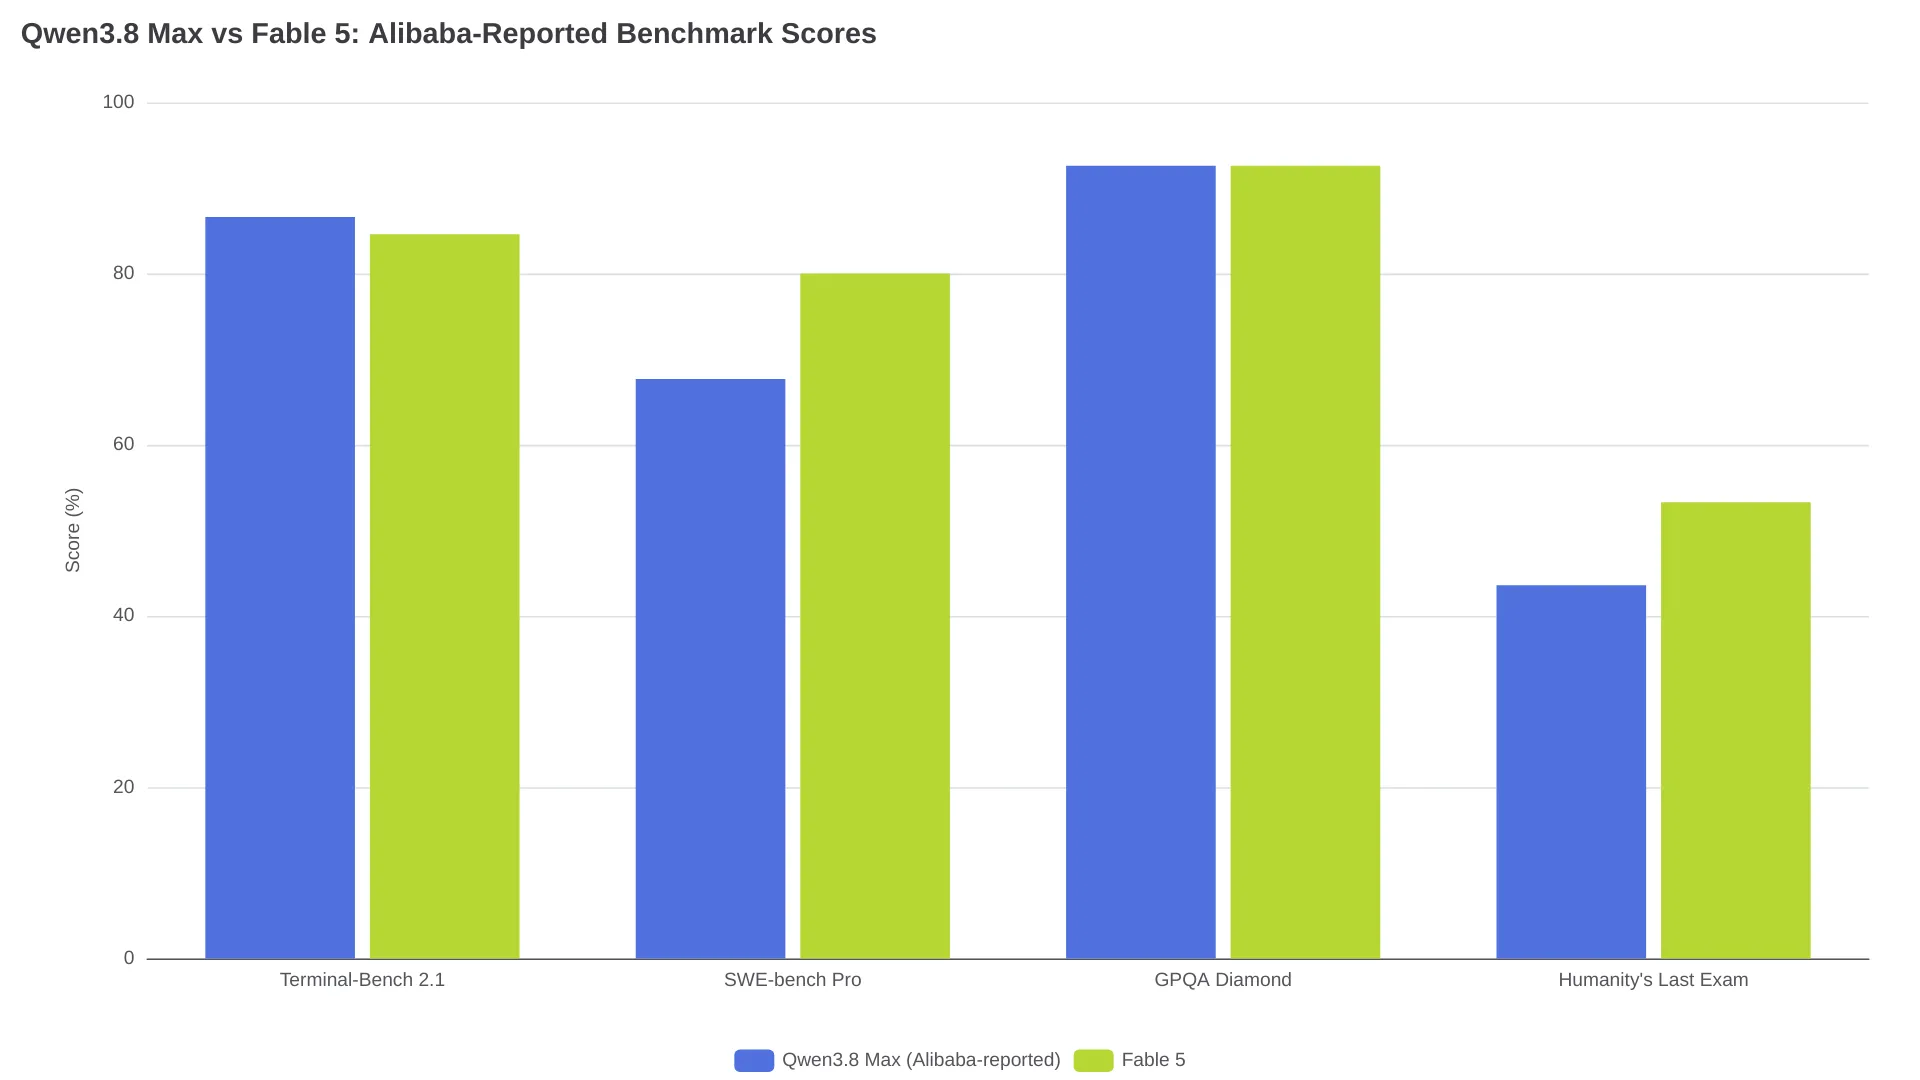
| Benchmark | Qwen3.8 Max (Alibaba) | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | Höher als Qwen (genauer Wert nicht veröffentlicht) |
| SWE-bench Pro | 67.7 | 80.0 | 64.6 |
| GPQA Diamond | 92.6 | 92.6 | Höher als Qwen |
| Humanity's Last Exam | 43.6 | 53.3 | Nicht veröffentlicht |
Unabhängige Messungen zeichnen ein anderes Bild. Artificial Analysis kam bei Qwen3.8 Max im Terminal-Bench 2.1 auf 81,3 Prozent – 5,3 Punkte weniger als Alibabas Angabe von 86.6. Mit diesem unabhängigen Ergebnis landet Qwen ungefähr auf Platz zehn der Gesamtwertung, hinter Fable 5 (84.6 Prozent) und Kimi K3 (85.0 Prozent).
Seine Stärken zeigt Qwen3.8 Max unter anderem im SWE-bench Pro: Mit 67.7 Prozent liegt es vor GPT-5.6 Sol mit 64.6 Prozent. Auch die multimodalen Ergebnisse sind stark: MathVision erreicht 95.2 gegenüber 92.7 bei Fable 5, LogicVista 91.9 gegenüber 85.7. Beim DeepSWE 1.1 legte das Modell gegenüber Qwen3.7 Max außerdem deutlich von 21.6 auf 56.6 zu. Das deutet auf echte Fortschritte bei Agentenaufgaben rund um Softwareentwicklung hin.
Auch die Stimmung in der Community ist entsprechend geteilt. Im selben Reddit-Thread, in dem sich Nutzer über das ausufernde Nachdenken beschwerten, hieß es auch:
„Die Ausgabe war allerdings absolute Spitzenklasse.“ – u/TangerineLogical9779, r/Qwen_AI
Die Geschwindigkeit soll je nach Auslastung und Tageszeit stark schwanken – von 8 bis 60 Tokens pro Sekunde. Einen direkten Vergleich mit Kimi K3 gibt es in unserem Qwen3.8 Max vs. Kimi K3 Vergleich.
FAQ
Sind die Gewichte von Qwen3.8-Max zum Download verfügbar?
Ja. Alibaba hat den Checkpoint Qwen3.8-2.4T-A95B am 12. August 2026 auf ModelScope veröffentlicht. Es ist das erste Modell der Qwen-Max-Klasse mit offenen Gewichten. Die cloudbasierte Version Qwen3.8-Max bietet darauf aufbauend zusätzliche Funktionen für den Produktiveinsatz.
Unter welcher Lizenz stehen die offenen Gewichte?
Zum Zeitpunkt der Veröffentlichung war die genaue Lizenz noch nicht bestätigt. Die bisherige Praxis deutet auf Apache 2.0 hin, da Qwen3.6 unter dieser Lizenz erschien. Qwen3.7 Max blieb allerdings geschlossen. Vor einem kommerziellen Einsatz sollte daher unbedingt die tatsächliche Lizenzdatei im ModelScope-Repository geprüft werden.
Wie unterscheidet sich Qwen3.8-2.4T-A95B von Qwen3.8-Max?
Qwen3.8-2.4T-A95B ist das Basismodell mit offenen Gewichten: 2.4T Parameter, 95B aktive Parameter, MoE-Architektur und 256K nativer Kontext. Qwen3.8-Max ist Alibabas Cloud-Version auf Basis dieses Modells. Sie wurde durch Post-Training für Produktionsumgebungen ergänzt, darunter einheitliche Reward-Systeme und Online-Datenbalancing. Die offenen Gewichte liefern das Basismodell, die API die erweiterte Variante.
Lässt sich Qwen3.8-Max lokal ausführen?
Nicht sinnvoll. In 4-Bit-Quantisierung benötigt das Modell ungefähr 1,2 TB VRAM – allein für die Gewichte also neun oder mehr H200-GPUs, ohne zusätzlichen Platz für den Kontext-Cache. Selbst mit 1.5-Bit-Quantisierung bleiben mehrere hundert Gigabyte. Die Qwen3.8-27B-Variante ist die realistische Alternative für den lokalen Einsatz und passt auf eine einzelne Consumer-GPU.
Was kostet die Qwen3.8-Max-API?
Die Model-Studio-API berechnet 2 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens. Die Abos beginnen bei 6 US-Dollar pro Monat (Lite) und reichen bis 68 US-Dollar pro Monat (Pro). Qoder bietet zu Nebenzeiten Aktionsrabatte von bis zu 98 Prozent auf Credits. Dabei handelt es sich jedoch um Einführungspreise, die sich ändern können.