 AIREITER
Ein einzelner Satz wie „cinematic scene“ überlässt dem Modell zu viele Entscheidungen: Fehlen Kameravorgaben, resultiert laut Prompting-Hinweisen der Anbieter oft eine statische Einstellung. Bleiben Sound-Felder offen, schleichen sich schnell unerwünschte Stimmen ein. Für MiniMax H3 braucht es deshalb eher ein kompaktes Drehbuch als eine Bildbeschreibung. Die offiziellen Guides definieren ein festes Format mit drei Feldern, Zeitstempeln für Einstellungen, stabilen Sprecher-IDs und zwei separaten Audiofeldern. Das gesamte Skript muss zudem in ein Prompt-Limit von ungefähr 7.000 Zeichen passen, abhängig vom Provider, während Clips maximal 15 Sekunden lang sein dürfen.
Base oder Reference: Welches H3-Promptformat passt?
Im MiniMax-H3-Repository auf Hugging Face stellt MiniMax zwei getrennte Anleitungen für Prompts bereit. Der Base Guide richtet sich an vier Generierungsaufgaben ohne hochgeladene Referenzen. Sobald Bilder, Videos oder Audioclips als Eingabe dienen, ist der Reference Guide zuständig. Die vier Base-Aufgaben entsprechen diesen Modi:
| Modus | Eingabe | Erforderliche Alignment-Anweisung im Prompt |
|---|---|---|
| T2VA | Nur Text | Keine; direkt mit den Kernfeldern beginnen |
| I2VA | Ein Bild als erstes Frame | "Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1]" |
| FL2VA | Erstes und letztes Frame | Picture 1 bei 0.00 Sekunden, Picture 2 zum exakten Endzeitpunkt |
| L2VA | Ein Bild als letztes Frame | Picture 1 wird mit dem Videoende und der letzten Einstellung ausgerichtet |
Beide Guides schließen mit ausgearbeiteten Beispielen. Auch der MiniMax-Launchbeitrag beschreibt das Modell entsprechend: Statt Aufgaben aus einem Menü auszuwählen, formulierst du Beziehungen zwischen Text-, Bild-, Video- und Audioeingaben. Gehostete Endpunkte reduzieren das auf drei Workflows – minimax/h3/text-to-video, image-to-video und reference-to-video auf fal – doch die zugrunde liegende Prompt-Struktur bleibt identisch.
Der Base Prompt im Aufbau
Nach einer gegebenenfalls nötigen Alignment-Anweisung besteht ein MiniMax-H3-Prompt im Base-Modus aus exakt drei Pflichtfeldern, getrennt durch Leerzeilen. Das Grundgerüst sieht so aus:
[alignment instruction if I2VA/FL2VA/L2VA]

integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...integrated_multimodal_descriptionenthält die Timeline: visuellen Stil, Bildaufbau, Aktionen, Einstellungswechsel, Sprecher, Dialog und diegetischen Ton – also alles, was zu sehen oder innerhalb der Szene zu hören ist.overall_soundscapefasst Atmosphäre und physische Geräusche in 1–4 Sätzen und einem Absatz zusammen, ohne Dialog.non_diegetic_musicbeschreibt die Filmmusik, die nur das Publikum hört, in 1–3 Sätzen – oder enthältN/A, wenn keine Musik gewünscht ist.
Ein ausgefülltes Beispiel, angelehnt an den T2VA-Fall aus dem offiziellen Guide: eine Bäckerei vor Sonnenaufgang.
integrated_multimodal_description: [Shot 1] Live-action, cinematic. A medium-wide
shot of a small bakery interior before sunrise; warm tungsten light, flour dust in
the air. A middle-aged baker (S1), grey apron, rolled sleeves, lifts the security
shutter. The camera pushes in with small amplitude at slow speed as he places
fresh bread on a wooden counter. (S1) says in a warm, mid-pitch voice <d>[English]
First batch of the day.</d> At 00:05.000, the camera cuts to a close-up of his
hands slicing a loaf; (S1)'s words carry over from the previous shot, <scenetrans>
continuing seamlessly across the cut.

overall_soundscape: The rattling shutter, metal trays set down on stone, a doorbell
chime, footsteps on tile, and the crusty sound of a knife slicing bread.

non_diegetic_music: Acoustic guitar and upright bass at a slow tempo, gentle
dynamics fading out before the final shot.
Diese Elemente steuern laut offiziellen Regeln jeweils Folgendes:
| Prompt-Element | Steuert | Regel |
|---|---|---|
[Shot 1] Live-action, cinematic. | Globalen Stil | Das Stil-Label eröffnet Shot 1; Beispiele aus der Guide-Liste: Cinematic, live-action, 2D-animated, 3D CG, claymation, watercolor, vintage film |
A middle-aged baker (S1), grey apron, rolled sleeves | Sprecheridentität | Identitätsmerkmale stehen vor der ID; die ID bleibt über alle Shots hinweg gleich |
The camera pushes in with small amplitude at slow speed | Kamera | Bewegungsart + Intensität + Geschwindigkeit, als natürliche Handlungsbeschreibung formuliert |
<d>[English] First batch of the day.</d> | Dialog | Nur Sprach-Tag und exakter Wortlaut, unverändert und niemals übersetzt |
At 00:05.000, the camera cuts to... | Schnittzeitpunkt | Muss strikt ansteigen; [Shot 1] selbst erhält keinen Zeitstempel |
<scenetrans> continuing seamlessly across the cut | Audio-Kontinuität | Markiert Dialog, der über einen Schnitt hinweg weiterläuft, an beiden Verbindungsstellen |
Schnittfolge und Kamerabewegung korrekt beschreiben
Die Shot-Syntax von MiniMax H3 ist positionsbasiert: [Shot 1] bekommt nie einen Zeitstempel. Jede spätere Einstellung beginnt dagegen mit einem strikt steigenden Schnittzeitpunkt wie At 00:03.500,. Die vorgesehenen Schnittformulierungen bleiben knapp: „the camera cuts to“, „the shot transitions to“ oder „the shot switches to“. Cross-Dissolves, Blenden und Wipes sollten nur auftauchen, wenn du sie ausdrücklich verlangst. Ändert sich das Framing nur leicht, empfiehlt der Guide eine Kamerabewegung statt eines Schnitts. Ein Schnitt sollte neue Informationen zu Motiv, Ort, Zustand oder Zeit einführen.
Kamerabewegungen werden als natürliche englische Handlung formuliert und können bis zu drei Dimensionen enthalten: Bewegungsart, Intensität und Geschwindigkeit.
| Dimension | Zulässige Ausdrücke |
|---|---|
| Bewegungsart | Zoom In/Out, Push In/Pull Out, Pan Left/Right, Truck Left/Right, Tilt Up/Down, Pedestal Up/Down, Arc Shot, Tracking Shot, Static Shot, Shake Slightly/Strongly, POV, Roll Clockwise/Counterclockwise |
| Intensität | "with small amplitude", "with large amplitude" |
| Geschwindigkeit | "at slow speed", "at fast speed" |
Mittlere Intensität und normale Geschwindigkeit werden konventionsgemäß nicht angegeben. Wichtig ist auch die Bedeutung: „Zoom In“ verändert die Brennweite bei fester Kameraposition, während „Push In“ die Kamera physisch nach vorn bewegt. Der Guide unterscheidet das bewusst.
Dialoge und Sprecher-IDs
Jede sprechende Figur in einem MiniMax-H3-Prompt erhält eine feste ID: (S1), (S2) oder bei synchron gesprochenem Text eine Kombination wie (S1,S2). Dieselbe ID bleibt in allen Shots erhalten. Figuren ohne Sprachanteil brauchen überhaupt keine ID. Beim ersten Auftreten eines Sprechers sollte die Beschreibung ausreichend Merkmale für eine stabile Generierung festlegen: ob die Person im oder außerhalb des Bildes ist, Altersgruppe, Geschlecht, Stimmlage, Timbre, Sprechtempo und Akzent.
Die exakte Syntax für eine Dialogzeile:
A woman in her 30s (S2), on-screen, mid-pitch voice, says with quiet anger
<d>[English] You promised me the 15th.</d>
Vier dokumentierte Regeln vermeiden die typischen Fehler: Identität, Handlung und Vortragsweise stehen außerhalb von <d>. Innerhalb von <d> stehen ausschließlich das Sprach-Tag und der exakte Wortlaut mit unveränderter Zeichensetzung. Für Voiceover wird die feste Formulierung „says in an off-screen voiceover“ verwendet, direkt gefolgt von dem Hinweis, dass die Lippen der sichtbaren Figur geschlossen bleiben. Läuft Dialog über einen Schnitt hinweg, braucht es an beiden Anschlusspunkten <scenetrans> sowie eine Kontinuitätsformulierung wie „continues seamlessly across the cut“ oder „carries over from the previous shot“. Wird Sprache vom Videoende abgeschnitten, kommt <cutoff> zum Einsatz.
Anführungszeichen haben genau eine reservierte Funktion: Sichtbarer Text im Video – Banner, Schilder, Labels, Neon-Schrift oder Untertitel – wird wortgetreu und nicht übersetzt in englische doppelte Anführungszeichen gesetzt. Gesprochener Dialog in Anführungszeichen ist laut Dokumentation der Grund, weshalb H3 daraus eingebrannte Untertitel statt Sprache erzeugt.
Die zwei Sound-Felder
Der MiniMax-Launchbeitrag erklärt, dass der gesamte H3-Audioausgang nativ in Stereo direkt mit dem Video generiert wird. Deshalb gibt es zwei eigene Sound-Felder, statt Audio nur mit Adjektiven in der Szenenbeschreibung anzudeuten. overall_soundscape umfasst Atmosphäre und physische Geräusche wie Wind, Regen, Verkehr, Schritte, Stoffbewegungen, Einschläge, Atmen oder Lachen in 1–4 Sätzen. N/A ist hier ausschließlich für die explizite Anforderung völliger Stille vorgesehen. non_diegetic_music beschreibt Musik, die die Figuren nicht hören können, über Instrumentierung, Tempo, Rhythmus und dynamische Veränderungen. Abstrakte Stimmungswörter wie „epic“ oder „emotional“ werden ausdrücklich nicht empfohlen. Wenn keine Musik erwünscht ist, lautet der korrekte Wert N/A.
Diegetischer Ton – etwa Gesang, ein Radio in der Szene oder ein Straßenmusiker – gehört in keines der beiden Felder. Er steht in integrated_multimodal_description, also dort, wo die Timeline beschrieben wird. Die Trennung ist mehr als Kosmetik: Das APIMODELS-Tutorial weist darauf hin, dass zuverlässige Ergebnisse explizite Audio-Vorgaben brauchen. Wer non_diegetic_music offenlässt, riskiert Musik, die nie bestellt war.
Reference Prompts: Labels und Retention
Sobald hochgeladene Assets die Generierung steuern, greift der Reference Guide. Er verlangt sechs Abschnitte in fester Reihenfolge: subject_definitions, summary, retention_analysis, detailed_description, overall_soundscape und non_diegetic_music. Der Bereich detailed_description umfasst bei Generierungsaufgaben normalerweise 350–500 englische Wörter. Bei dialoglastigen Prompts darf die Länge abweichen, wenn es nötig ist, um die komplette gesprochene Timeline unterzubringen.
Vier Label-Typen übernehmen dabei die Zuordnung:
| Label | Einsatz |
|---|---|
<Subject N> | Sichtbarer Inhalt, der tatsächlich im Ergebnis verwendet wird: Person, Produkt, Szene, Outfit, Stil oder eine aus beliebigen Assets abstrahierte Handlung |
<Picture N> | Ein Bild als konkreter Frame-Anker – erstes Frame, Keyframe, letztes Frame oder Kompositionsanker |
<Video N> | Beziehung zu einem kompletten Video: Schnittquelle, Fortsetzungspunkt, Kamera- oder Schnittstruktur, Rhythmus |
<Audio N> | Ein kopiertes oder referenziertes Audiosignal: Stimmtimbre, Songtext, Beats oder Soundeffekte |
Jeder Label-Typ wird unabhängig nummeriert. Ein hochgeladenes Video kann also <Video 1> sein, während seine Audiospur als <Audio 2> bezeichnet wird. Bei sprechenden Subjects wird das Label mit der Sprecher-ID kombiniert: <Subject 3> (S1).
Der Abschnitt summary beginnt mit einem Aufgabenpräfix in eckigen Klammern, etwa [reference generation] oder [video editing + audio reuse]. Bei einem Video-Edit muss der Text mit „The target video is an edited version of <Video 1>.“ beginnen. Anschließend weist retention_analysis jedem Label einen Marker zu: Für visuelle Inhalte stehen fully_preserved, partially_preserved, attribute_transfer oder weak_reference bereit; für Audio fully_copy, partially_copy, reference oder weak_reference. So teilst du H3 etwa mit, dass ein Gesicht erhalten bleiben muss, während sich das Outfit ändern darf.
Ein minimales Reference-Mode-Gerüst in der dokumentierten Reihenfolge:
subject_definitions:
<Subject 1>: the woman from Picture 1, long blonde hair, light-pink shirt
<Picture 1>: first frame of [Shot 1], café window seat
<Audio 1>: voice-timbre reference for <Subject 1> (S1)

summary: [reference generation + audio reference] One short paragraph naming the
task, the target video, and each reference relationship.

retention_analysis:
<Subject 1> (appears in [Shot 1], [Shot 2]): fully_preserved, same face, hair, outfit
<Picture 1> ([Shot 1] first frame): fully_preserved
<Audio 1> (S1 voice): reference, timbre only, no copied words

detailed_description: [1–2 style sentences.] [Shot 1] ... [350–500 words, dialogue
in <d> tags, <scenetrans> across cuts]

overall_soundscape: [Ambience and physical sounds.]

non_diegetic_music: N/A
Wenn H3 aus dem Takt kommt: Ursachen und Lösungen
| Symptom | Wahrscheinliche Prompt-Ursache | Lösung |
|---|---|---|
| Kauderwelsch oder erfundene „Sims-Sprache“ | Unstrukturierter Dialog, fehlende Sprecher-IDs oder nicht beschriebene stumme Figuren | (S1)/(S2)-IDs ergänzen, exakten Wortlaut in <d>[Language] ...</d> setzen und stumme Figuren ausdrücklich als nicht sprechend beschreiben |
| Eingebrannte Untertitel bei Dialogen | Gesprochener Text steht in Anführungszeichen | Anführungszeichen nur für sichtbaren Text im Bild reservieren; Dialog in <d>-Tags verschieben |
| Dialog wird der falschen Figur zugeordnet | Sprecher-ID ist nicht mit einer beschriebenen Person verknüpft | Beim ersten Auftreten Identitätsmerkmale angeben – Alter, on-screen, Stimme – und die ID über alle Shots stabil halten |
| Ungewollter Score oder Musik | non_diegetic_music bleibt vage oder fehlt | Bei gewünschter Stille non_diegetic_music: N/A schreiben; Community-Threads nennen das als wirksamen Fix gegen unerwünschtes Audio |
| Nicht geplante Schnitte | Szenenwechsel implizieren Schnitte ohne Zeitstempel | [Shot N] At 00:03.500 mit eindeutigen Schnittformulierungen verwenden; für One-Take-Shots explizit „no cuts“ verlangen |
| Gesicht, Outfit oder Produkt driften | Die Rolle der Referenz wurde nicht deklariert | Eine retention_analysis-Zeile mit fully_preserved für das Label ergänzen und das Label bei jedem Auftreten wiederholen |
Die Zeilen zu Kauderwelsch und Untertiteln folgen direkt aus den offiziellen Syntaxregeln. Community-Threads auf r/StableDiffusion berichten unabhängig davon, dass dieselben Maßnahmen in der Praxis helfen. Dazu zählt auch non_diegetic_music: N/A, einer der am häufigsten genannten Fixes gegen unerwünschtes Audio.
Limits und Kosten pro Prompt-Test
Das Generierungsfenster ist relevant, weil die Prompt-Länge begrenzt ist und jeder Versuch Kosten verursacht. Die dokumentierten Limits der offiziellen API und gehosteter Provider:
| Parameter | Wert | Hinweis |
|---|---|---|
| Clip-Dauer | Bis zu 15 s, nur volle Sekunden | Minimum: 5 s bei fal-/EvoLink-Endpunkten; einige V2-API-Dokumentationen nennen 4 s |
| Auflösung | 768p und 2K, 24 FPS | 2K ist laut MiniMax die Standard-Ausgabeauflösung |
| Referenzdateien | Bis zu 9 Bilder, 3 Videos, 3 Audiodateien | 12 Dateien insgesamt; Audio darf nie die einzige Referenz sein |
| Prompt-Länge | ~7.000 Zeichen | fal- und V2-API-Dokumentation; APIMODELS nennt 20.480 – beim jeweiligen Provider prüfen |
| Seitenverhältnisse | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptiv | Image-to-Video übernimmt das Seitenverhältnis des Eingabebilds |
Die Preise unterscheiden sich je nach Provider; betrachte diese Werte daher als datierte Momentaufnahmen, nicht als Listenpreise. Auf fal kostete eine 2K-Generierung laut einem Preis-Snapshot vom 1. August $0.26 pro Sekunde – $1.30 für 5 Sekunden und $3.90 für 15 Sekunden. Die ersten fünf Referenzbilder waren kostenlos, weitere Bilder kosteten jeweils $0.08. Bei APIMODELS liegt H3 bei $0.088 pro Sekunde, also $1.32 für einen 15-Sekunden-Clip; abgerechnet werden dort nur erfolgreiche Anfragen. Zum Vergleich die Sekundenpreise auf demselben Marktplatz:
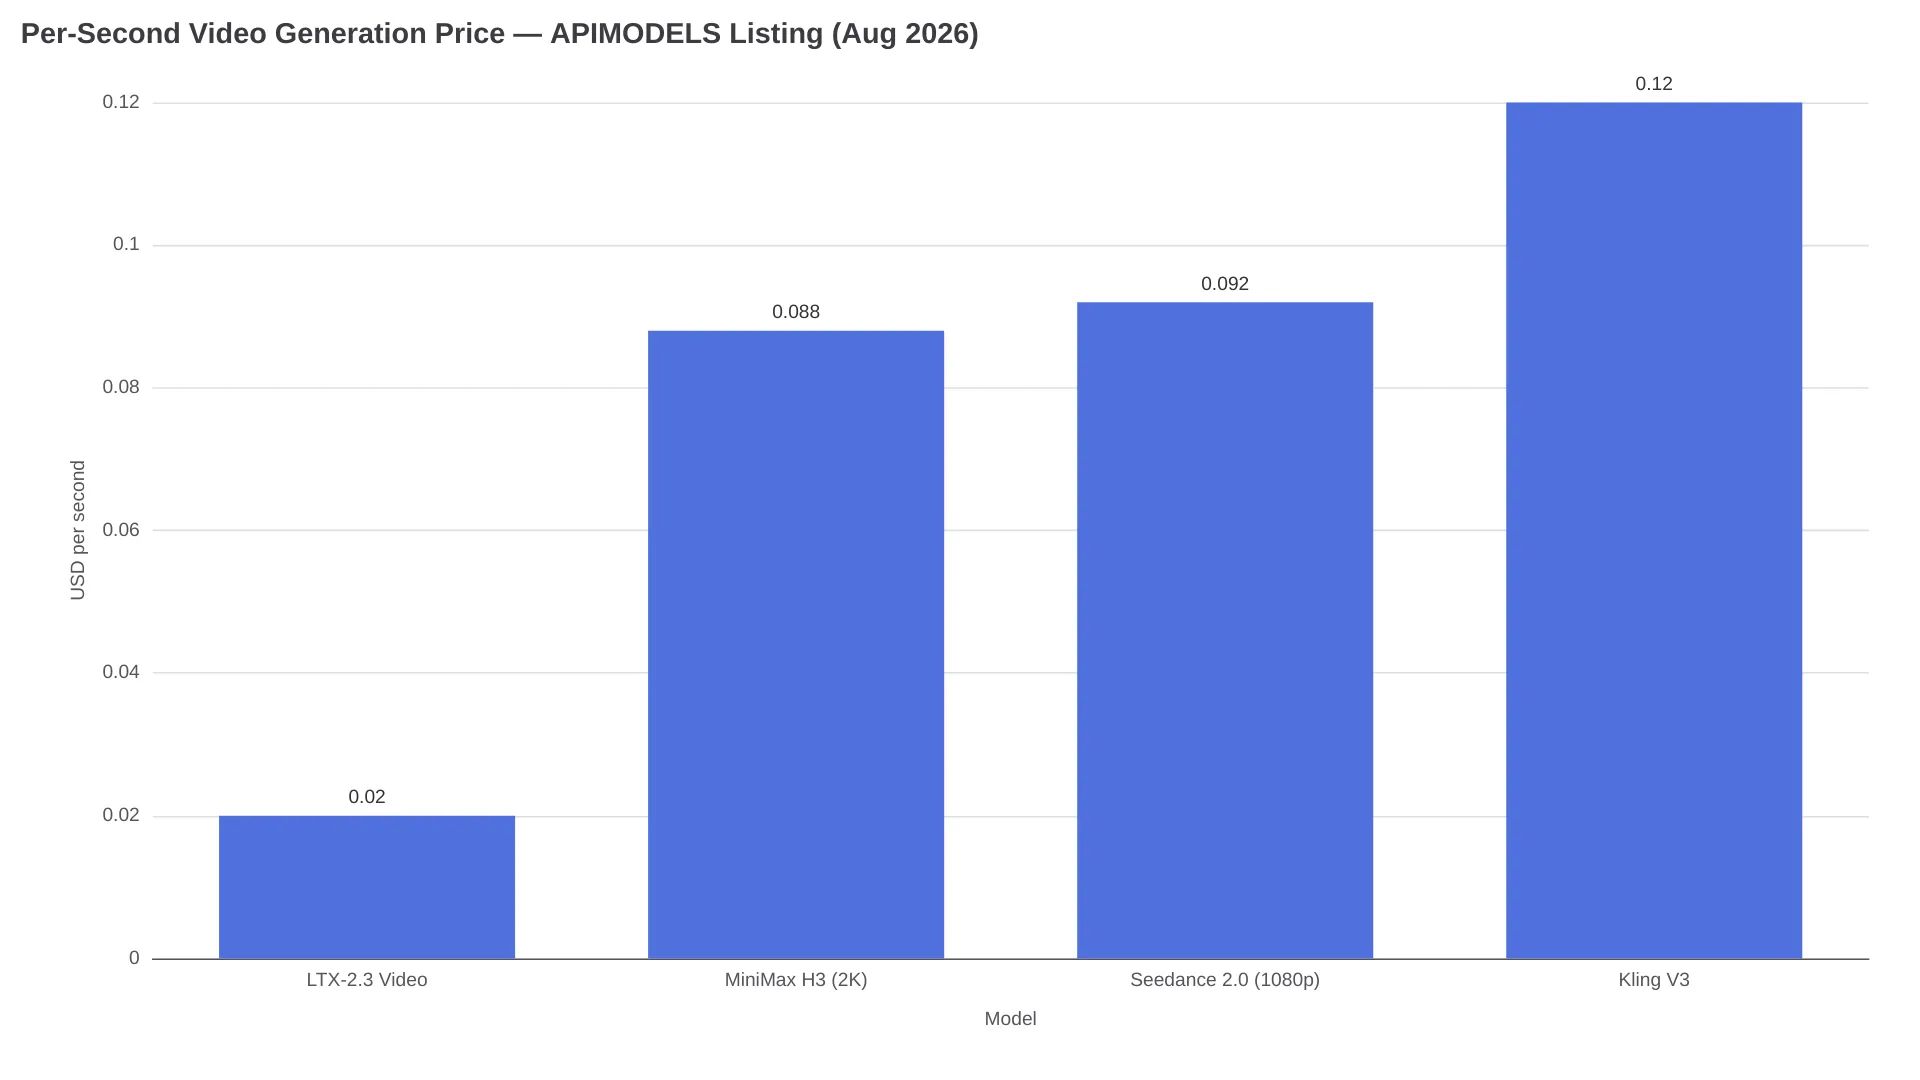
Entscheidend fürs Budget ist die Rechnung bei Wiederholungen: Ein strukturierter 15-Sekunden-Dialogprompt, der beim zweiten Versuch gelingt, kostet bei APIMODELS $2.64. Ein unstrukturierter Prompt, der fünf Versuche für eine brauchbare Aufnahme braucht, kommt auf $6.60. Um Prompts über einen gehosteten H3-Endpunkt zu iterieren, führt die MiniMax-H3-API-Seite von AIReiter das Modell mit den aktuellen Preisen direkt auf der Seite aus.
Vorlagen zum Kopieren und Ausfüllen
Mit diesen zwei Base-Gerüsten lässt sich der Großteil kurzer Formate abdecken. Fülle die Klammern aus und lass Feldnamen sowie Leerzeilen exakt unverändert:
integrated_multimodal_description: [Shot 1] [style label]. [Composition and
subject with 1–2 identity details]. [One primary action with physically
plausible pacing]. The camera [motion type] with [amplitude] at [speed].
[Character description] (S1) says in [voice description] <d>[Language]
[exact line]</d>. At [MM:SS.mmm], the camera cuts to [new subject or space],
[continuity phrase if dialogue crosses the cut].

overall_soundscape: [Ambience + physical action sounds, 1–4 sentences.]

non_diegetic_music: [Instrumentation, tempo, dynamics] or N/A
Picture 1 is fully referenced at 0.00 seconds and belongs to [Shot 1].
integrated_multimodal_description: [Shot 1] [Style consistent with Picture 1].
The scene, subject, colors, and spatial relationships of Picture 1 remain
consistent. [Action developing forward from the first frame → result or
reaction]. The camera [motion type] with [amplitude] at [speed].
overall_soundscape: [Ambience and action sounds grounded in the image.]
non_diegetic_music: N/AWer lieber bewährte Prompts statt leerer Vorlagen sucht, findet in drei Bibliotheken Quellenlinks. ecomimagelab/awesome-minimax-h3-prompts bietet 58 Prompts, davon 39 offizielle und 19 von der Community getestete. Jeder Eintrag enthält das herunterladbare Ergebnisvideo und folgt der Regel „No video, no entry.“ imagineVid/Awesome-minimax-h3-prompts-and-skills sammelt 28 verifizierte Fälle aus sechs Workflows – von Omni-Reference für konsistente Identität bis zu Dialog mit nativem Audio. Die APIMODELS-Galerie enthält 226 nach Anwendungsfall durchsuchbare Prompts mit zugehörigen Clips. Ihre Kurzregel lautet: „References carry identity, the prompt carries action.“
Für das Schreiben der Skripte selbst gibt es zwei Abkürzungen. Reddit-Nutzer berichten von guten Ergebnissen, wenn sie einen offiziellen Guide in ein LLM einfügen und den Zielmodus nennen, etwa „rewrite this idea as T2VA using the base guide“. Außerdem erzeugt die ComfyUI-Erweiterung MiniMax H3 Prompt Writer v0.3 das strukturierte Format direkt in einem Node-Workflow.
FAQ
Was unterscheidet den MiniMax H3 Base Guide vom Reference Guide?
Der Base Guide deckt vier Modi ohne Referenzen ab – T2VA, I2VA, FL2VA und L2VA – und basiert auf drei Kernfeldern. Der Reference Guide ergänzt sechs Pflichtabschnitte sowie <Subject>-, <Picture>-, <Video>- und <Audio>-Labels, sobald hochgeladene Bilder, Videos oder Audiodateien die Generierung steuern.
Wie kennzeichne ich Sprecher in einem MiniMax H3 Prompt?
Vergib stabile IDs wie (S1) und (S2) in der Reihenfolge des ersten gesprochenen Ereignisses und behalte sie in allen Shots bei. Für gleichzeitige Sprache nutzt du (S1,S2). Innerhalb der <d>-Tags stehen nur das Sprach-Tag und der exakte Wortlaut.
Wie stoppe ich Kauderwelsch-Audio in MiniMax H3?
Strukturiere den Dialog mit Sprecher-IDs und wortgetreuen <d>-Tags, beschreibe nicht sprechende Figuren ausdrücklich als stumm und setze non_diegetic_music: N/A, wenn keine Filmmusik gewünscht ist. Das sind dokumentierte und von der Community bestätigte Fixes.
Sollte MiniMax-H3-Dialog in Anführungszeichen stehen?
Nein. Anführungszeichen sind für sichtbaren Text im Video reserviert. Gesprochener Dialog gehört in <d>[Language] ...</d>; andernfalls kann H3 ihn als Untertitel im Bild ausgeben.
Wie lang darf ein MiniMax H3 Prompt sein?
Bei fal und laut offizieller V2-API-Dokumentation ungefähr 7.000 Zeichen. APIMODELS nennt dagegen 20.480. Prüfe daher das Limit deines konkreten Endpunkts, bevor du ein Skript mit 10.000 Zeichen schreibst.
Was auch perfekte Syntax nicht löst
Struktur erhöht die Trefferquote, macht die Generierung aber nicht deterministisch. Exakte Identitäten, Logos und Produkte bleiben probabilistisch: Community-API-Wrapper versprechen ausdrücklich keine Frame-genaue Konsistenz. Selbst die stärksten Beispiele aus Prompt-Bibliotheken erzwingen Identität mit umfangreichen Einschränkungsblöcken, nicht mit messbaren Garantien. Inline-<tags> für nonverbale Geräusche sind ein Community-Experiment und können sich von Generierung zu Generierung unterschiedlich verhalten. Bewerte Ergebnisse deshalb nach Kosten pro freigegebener Sekunde statt nach Kosten pro Anfrage – und halte beim Schreiben die offiziellen Base- und Reference-Guides in einem Tab geöffnet.
Weiterführende Artikel: Der MiniMax-H3-Release-Überblick erklärt, was das Modell ist. Der Vergleich MiniMax H3 vs LTX 2.3 stellt es der günstigsten Alternative nach Preis pro Sekunde gegenüber.