 AIREITER
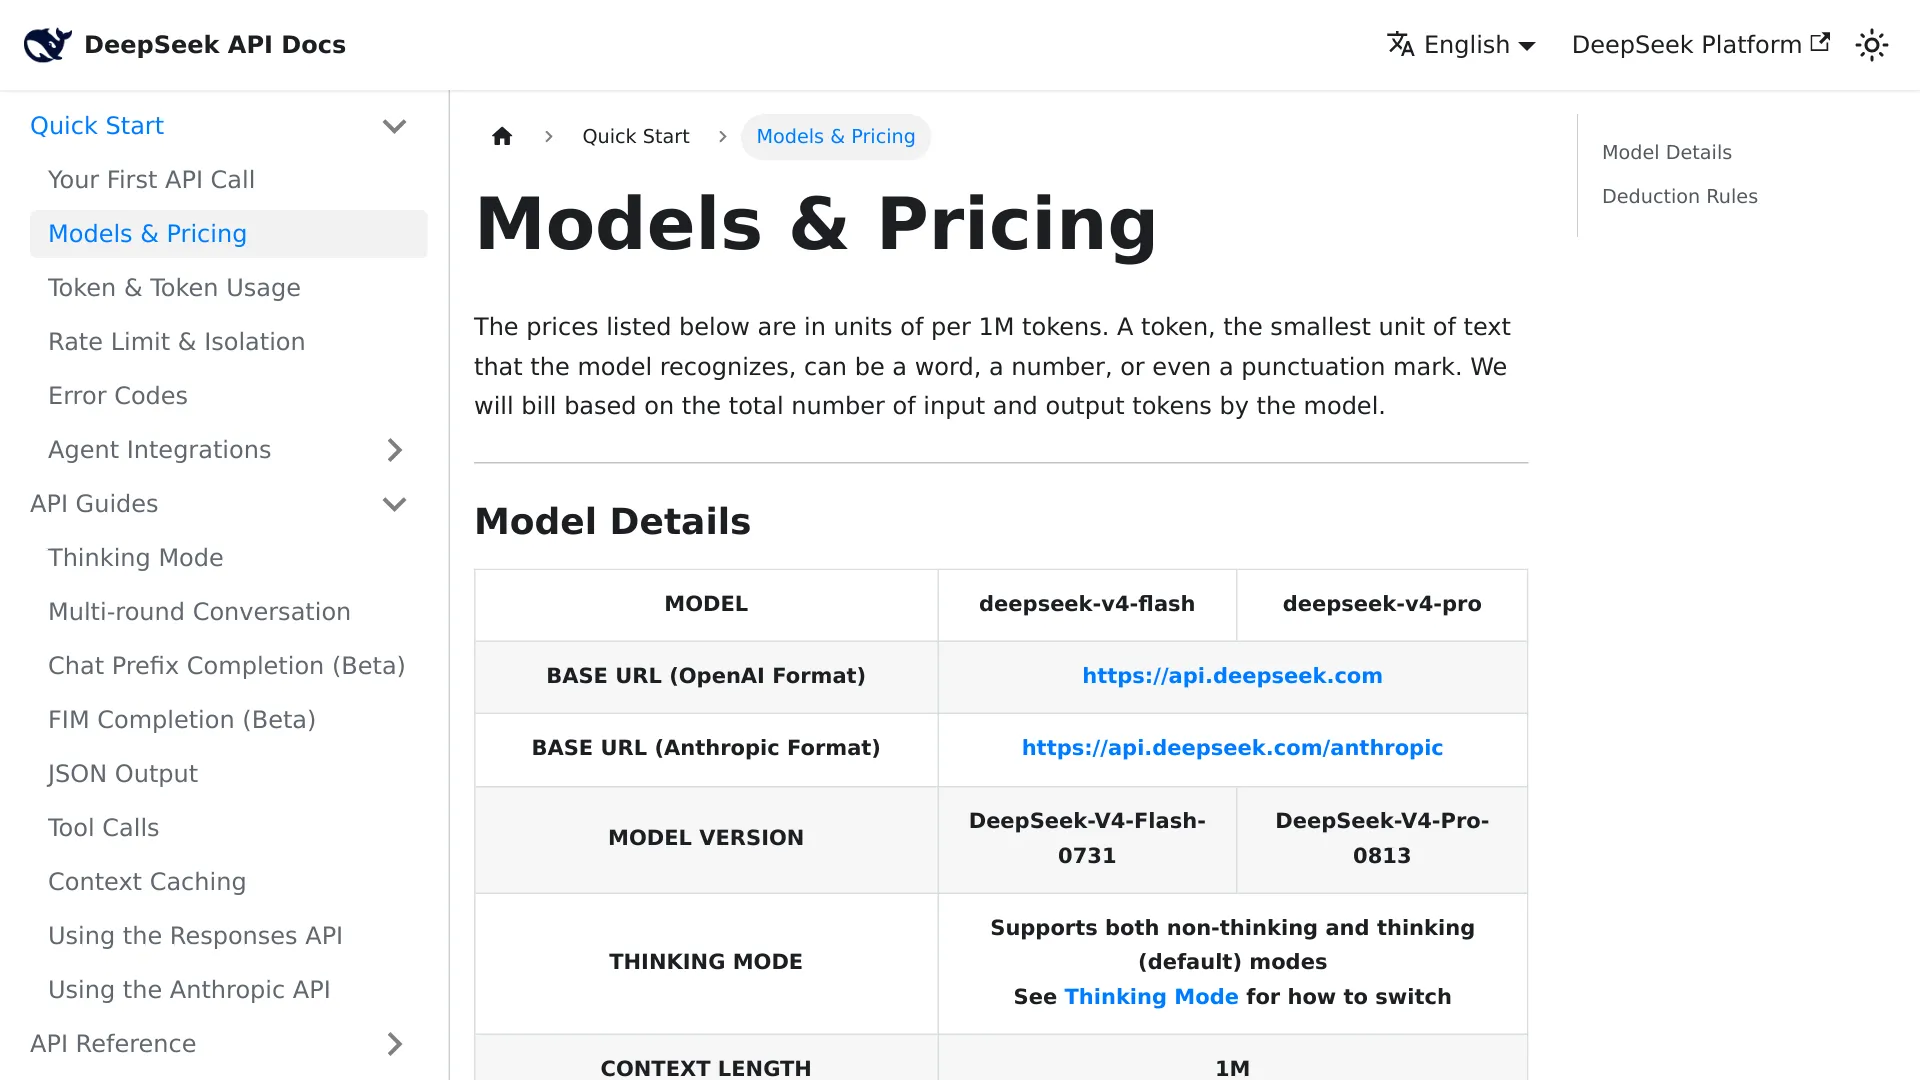
Mit DeepSeek V4 Pro GA ist das finale Modell jetzt offiziell verfügbar: DeepSeek veröffentlichte es am 13. August 2026 zusammen mit vollständigen Benchmark-Ergebnissen, offenen Gewichten unter MIT-Lizenz und drei Stufen für den Reasoning-Aufwand. Für API-Nutzer ist vor allem eines relevant: Laut offizieller Preisseite beginnt am 16. August 2026 um 16:00 UTC die Peak-/Off-Peak-Abrechnung. Eine Million Pro-Output-Tokens kosten dann statt 0,87 $ entweder 1,98 $ im Off-Peak oder 3,96 $ zu Peak-Zeiten.
DeepSeek-V4-Pro-0813: Das steckt in der GA-Version
Hinter dem API-Alias deepseek-v4-pro steht nun DeepSeek-V4-Pro-0813. Das Modell ist über die DeepSeek-App, das Web und die API verfügbar. DeepSeek kündigte den Start am 13. August an und spricht gegenüber dem Preview-Build vom 24. April von „deutlich verbesserten Agent-Fähigkeiten“.
Architektur und technische Daten:
| Merkmal | DeepSeek-V4-Pro-0813 |
|---|---|
| Veröffentlichte Modellgröße | 1,7 T Parameter (Model Card; das Preview hatte 1,6 T) |
| Kontextlänge | 1 Million Tokens |
| Maximale Ausgabe | 384K Tokens |
| Thinking-Modi | Ohne Thinking und mit Thinking (Thinking ist Standard) |
| Stufen für den Reasoning-Aufwand | low, high, max |
| Neues Decoding-Modul | DSpark Speculative Decoding (7 spekulative Tokens) |
| API-Kompatibilität | OpenAI ChatCompletions, Responses API, Anthropic API, Codex |
| Concurrency-Limit | 500 |
| Lizenz | MIT |
Für agentische Szenarien empfiehlt die Model Card temperature = 1.0 und top_p = 0.95. Bei den Aufwandstufen high und max liegt die maximale Ausgabelänge bei 384K Tokens.
Die offiziellen GA-Benchmarks
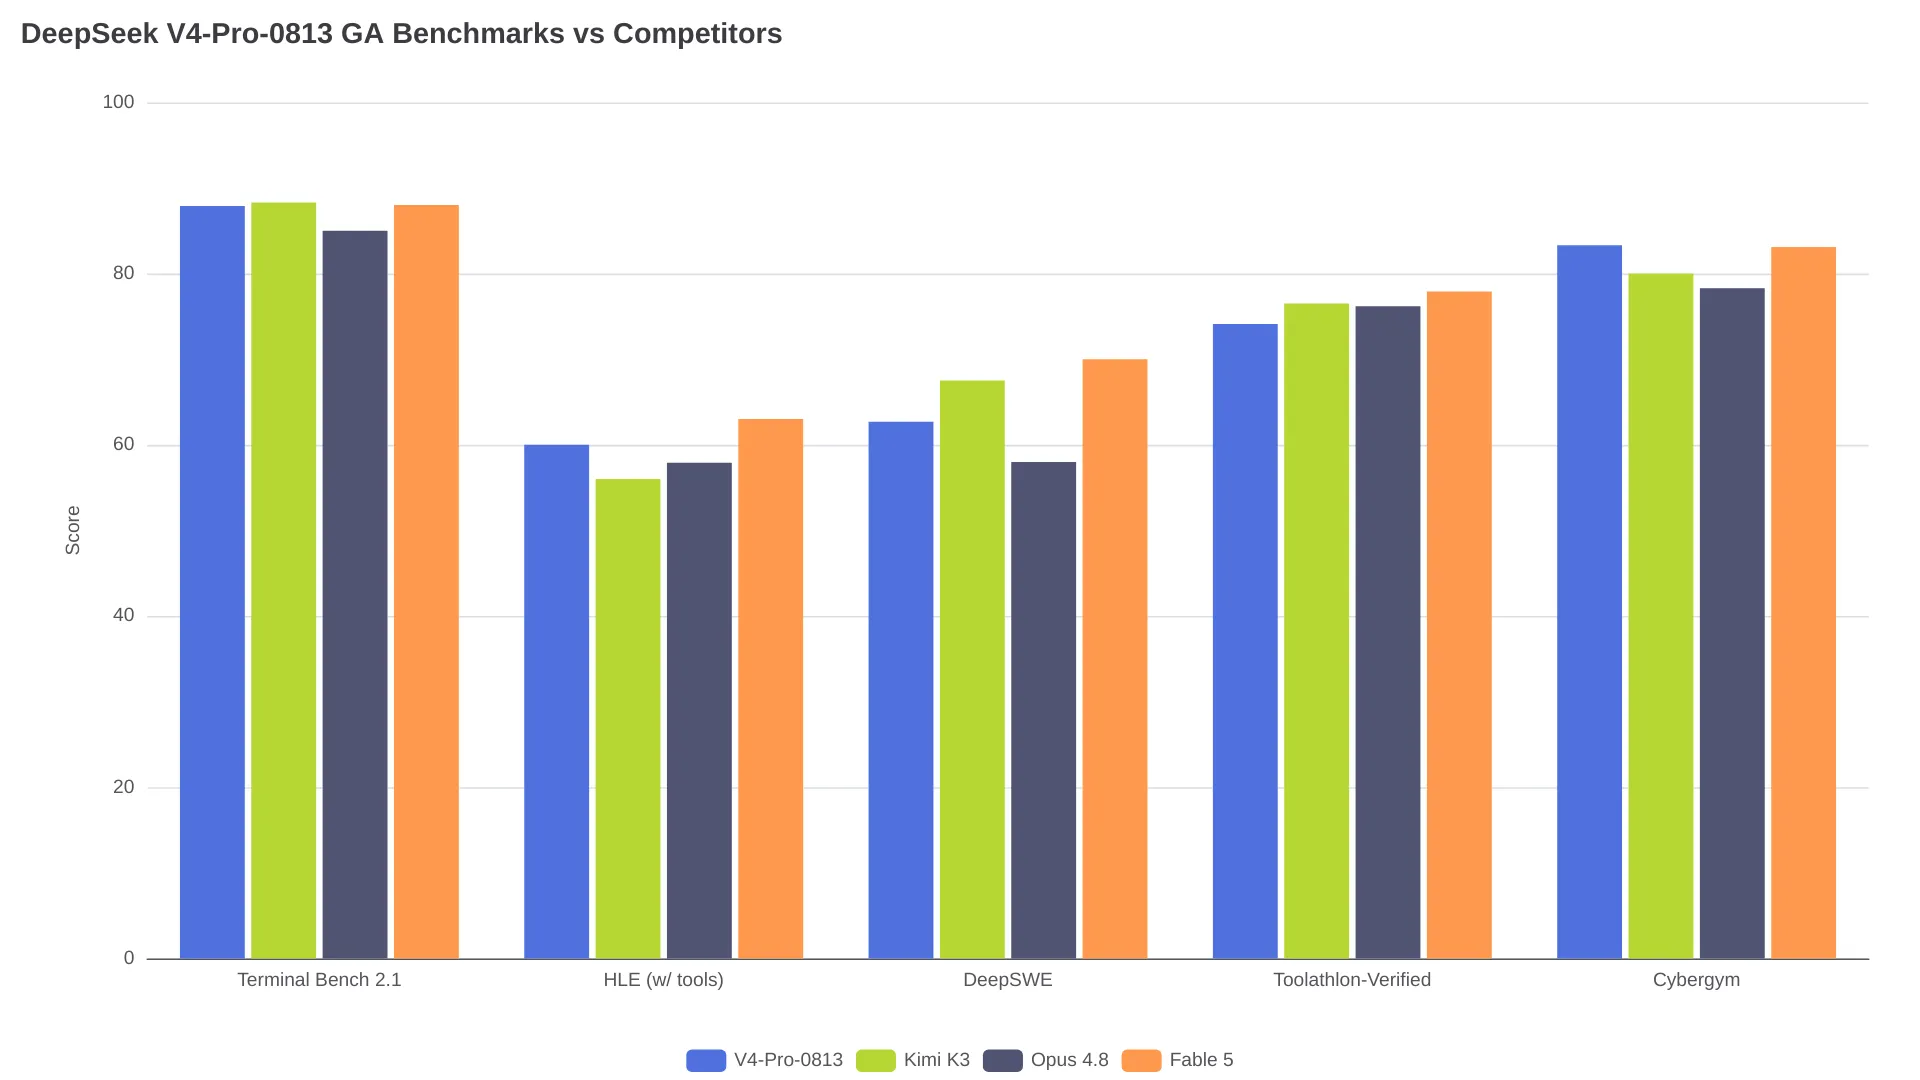
In der Model Card veröffentlicht DeepSeek zehn Benchmark-Vergleiche. Bei Code-Agent-Aufgaben kam DeepSeek Harness im Minimalmodus mit Reasoning-Aufwand max zum Einsatz. Die letzten beiden Zeilen, DSBench, sind interne DeepSeek-Testsets. Sämtliche folgenden Werte stammen aus dieser Model Card.
| Benchmark | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE (ohne Tools / mit Tools) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench (öffentlich) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack (intern) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard (intern) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
Gegenüber dem Preview ist der Sprung deutlich: DeepSWE steigt von 12.8 auf 62.7, AutomationBench von 12.8 auf 31.8. Im Wettbewerbsvergleich führt Pro-0813 bei HLE mit Tools mit 60.0 vor Kimi K3 mit 56.0 und Opus 4.8 mit 57.9. Bei DeepSWE, Terminal Bench und Toolathlon-Verified liegt es jedoch hinter Kimi K3 und Fable 5. Die beiden DSBench-Zeilen stammen vom Anbieter selbst und sollten daher nicht wie unabhängig gepflegte Benchmarks gewichtet werden.
Offene Gewichte unter MIT-Lizenz
Die 0813-Gewichte stehen auf Hugging Face bereit, lizenziert unter MIT und mit Deployment-Pfaden für vLLM und SGLang. Die Model Card enthält ein vLLM-Serving-Beispiel mit DSpark Speculative Decoding, FP8-KV-Cache und einem einzelnen 4x-GB300-Knoten.
„Broadly competitive with the strongest proprietary models available.“ — DeepSeek V4-Pro Model Card, Hugging Face
API-Preise ab 16. August: Peak und Off-Peak im Detail
Die Preisseite nennt sowohl einen aktuellen Einheitstarif als auch die ab 16. August 2026, 16:00 UTC geltenden Peak-/Off-Peak-Tarife. Peak-Zeiten sind 01:00–04:00 UTC sowie 06:00–10:00 UTC, entsprechend 09:00–12:00 und 14:00–18:00 Uhr in Peking. Alle übrigen Zeiten gelten als Off-Peak. Der Off-Peak-Preis beträgt exakt die Hälfte des Peak-Preises.
DeepSeek V4 Pro (DeepSeek-V4-Pro-0813)
| Abrechnungskategorie | Aktueller Einheitstarif | Off-Peak (16. Aug.) | Peak (16. Aug.) | Änderung zu Peak-Zeiten |
|---|---|---|---|---|
| Input, Cache-Hit | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| Input, Cache-Miss | $0.435/M | $0.66/M | $1.32/M | +203% |
| Output | $0.87/M | $1.98/M | $3.96/M | +355% |
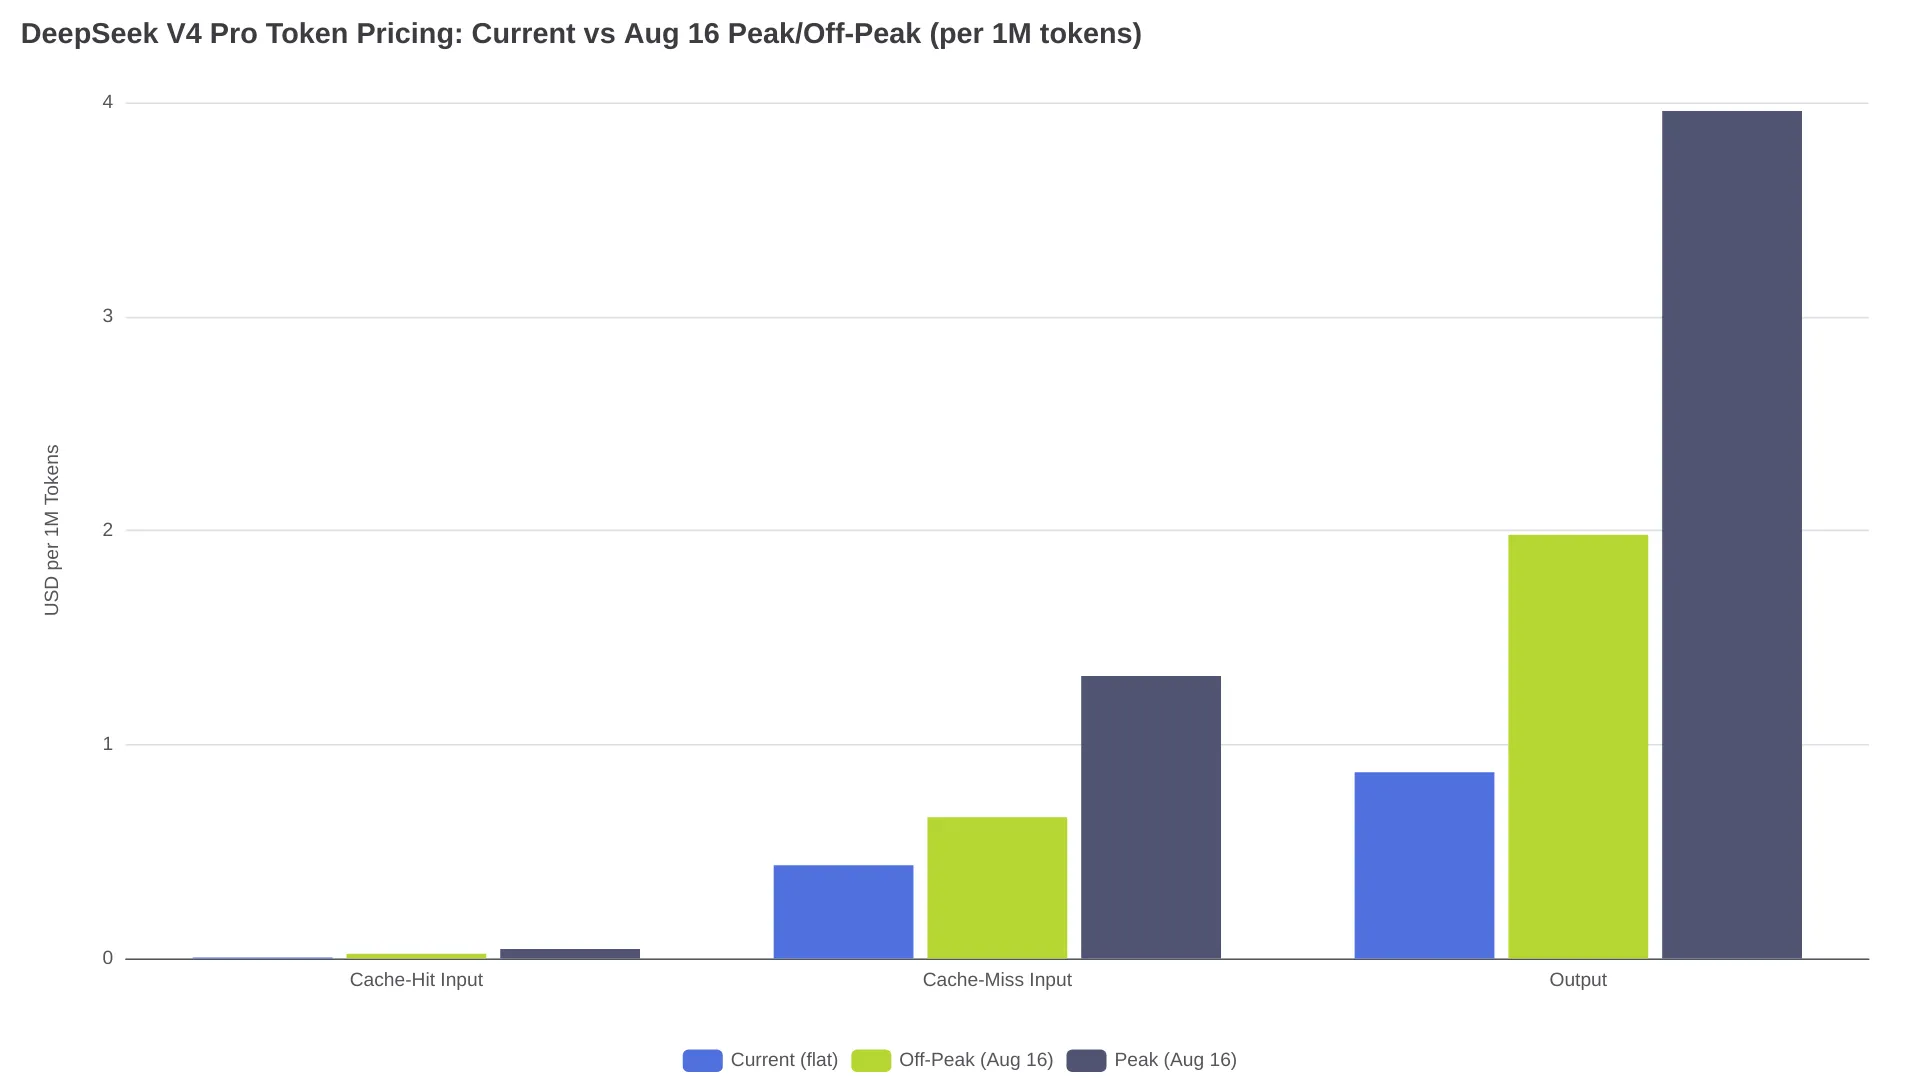
Der Output-Preis zu Peak-Zeiten steigt auf das 4,6-Fache. Für Agent-Workflows in Produktion ist die Änderung bei Cache-Hits noch einschneidender: Der bisherige Preis von $0.003625/M lag ungefähr 120-mal unter dem Preis eines Cache-Miss. Nach dem 16. August beträgt dieses Verhältnis in beiden Tarifstufen nur noch 30x (0.022 gegenüber 0.66 im Off-Peak, 0.044 gegenüber 1.32 im Peak), während die absoluten Cache-Hit-Kosten um das 6- bis 12-Fache steigen.
DeepSeek V4 Flash (DeepSeek-V4-Flash-0731)
| Abrechnungskategorie | Aktueller Einheitstarif | Off-Peak (16. Aug.) | Peak (16. Aug.) | Änderung zu Peak-Zeiten |
|---|---|---|---|---|
| Input, Cache-Hit | $0.0028/M | $0.007/M | $0.014/M | +400% |
| Input, Cache-Miss | $0.14/M | $0.22/M | $0.44/M | +214% |
| Output | $0.28/M | $0.66/M | $1.32/M | +371% |
Concurrency-Limit: 2,500 parallele Anfragen – fünfmal so viel wie bei Pro.
Peak-Zeiten in verschiedenen Zeitzonen
| Zeitzone | Peak-Fenster 1 | Peak-Fenster 2 |
|---|---|---|
| Peking (UTC+8) | 09:00–12:00 | 14:00–18:00 |
| London (UTC+1) | 02:00–05:00 | 07:00–11:00 |
| New York (UTC-4) | 21:00–00:00 (Vortag) | 02:00–06:00 |
| San Francisco (UTC-7) | 18:00–21:00 | 23:00–03:00 |
Für Teams in den USA liegen die Peak-Fenster überwiegend in den Abend- und Nachtstunden. In China und Ostasien fallen sie dagegen mit den üblichen Geschäftszeiten zusammen.
Rechenbeispiel: Pro bei 10.000 Aufrufen pro Tag
Angenommen, ein produktiver Agent sendet pro Aufruf einen gecachten Präfix mit 50K Tokens und erzeugt eine Antwort mit 2K Tokens.
| Kostenbestandteil | Aktueller Einheitstarif | Off-Peak | Peak |
|---|---|---|---|
| Cache-Hit-Input (500M Tokens) | $1.81 | $11.00 | $22.00 |
| Output (20M Tokens) | $17.40 | $39.60 | $79.20 |
| Tagessumme | $19.21 | $50.60 | $101.20 |
| Summe für 30 Tage | $576 | $1,518 | $3,036 |
Reale Workloads verteilen Aufrufe auf Peak- und Off-Peak-Zeiten und liegen damit zwischen diesen beiden Grenzen. Derselbe Workload kostet mit Flash zum aktuellen Einheitstarif $7.00 pro Tag, im Off-Peak rund $16.70 und im Peak $33.40. Flash im Peak ($33.40 pro Tag) ist damit teurer als Pro zum aktuellen Einheitstarif ($19.21), während Flash im Off-Peak ($16.70) darunter bleibt.
Migration: Modell-IDs, Reasoning-Steuerung und Versions-Pinning
Abgekündigte Endpunkte und neue Modell-IDs
Die Preview-Ankündigung vom 24. April erklärte, dass deepseek-chat und deepseek-reasoner nach dem 24. Juli 2026 um 15:59 UTC „vollständig eingestellt und nicht mehr erreichbar“ sein würden. Code, der diese Strings verwendet, muss angepasst werden.
| Alter Endpunkt | Worauf er routete | Nachfolger |
|---|---|---|
deepseek-chat | V4 Flash ohne Thinking | deepseek-v4-flash |
deepseek-reasoner | V4 Flash mit Thinking | deepseek-v4-flash (Thinking) oder deepseek-v4-pro |
Viele Teams gingen davon aus, dass deepseek-reasoner Reasoning auf Pro-Niveau liefert. Tatsächlich routete der Endpunkt an Flash im Thinking-Modus. Die Migration auf deepseek-v4-pro verändert daher sowohl die Ausgabequalität als auch die Rechnung.
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
Die Base-URL bleibt https://api.deepseek.com. An der übrigen Request-Struktur ändert sich nichts.
Stufen für den Reasoning-Aufwand
V4-Pro-0813 führt drei Stufen für den Reasoning-Aufwand ein: low für einfache Aufgaben, high für die tägliche Agent-Arbeit und max für komplexe Probleme. Thinking ist standardmäßig aktiviert; Thinking-Tokens werden als Output abgerechnet. Löst ein Prompt zunächst 3.000 Thinking-Tokens aus und produziert anschließend eine Antwort mit 200 Tokens, werden bei Peak-Preisen 3.200 Output-Tokens berechnet – $0.0127 pro Aufruf statt $0.0008 allein für die Antwort. DeepSeek sieht low für einfache Aufgaben vor, bei denen ausgedehntes Thinking Kosten verursacht, ohne zusätzlichen Nutzen zu bringen.
Versionen fest pinnen
Der Alias deepseek-v4-pro verweist auf den aktuellen Build und kann sich ändern, sobald DeepSeek weitere Versionen veröffentlicht. Für reproduzierbares Verhalten in Produktion sollten Sie prüfen, ob Ihr Provider datierte Modell-IDs unterstützt. Einige Drittanbieter-Gateways bieten gepinnte Routen an – kontrollieren Sie in der Provider-Dokumentation, welcher Build hinter jeder Route steht, bevor Sie sich in Produktion darauf verlassen.
Kompatible API-Protokolle
Beide Modelle unterstützen die Formate OpenAI ChatCompletions und Anthropic API. Der Anthropic-Endpunkt lautet https://api.deepseek.com/anthropic. Die Kompatibilität mit Responses API und Codex ist neu im GA-Build. Treten nach der Migration Fehler auf, sollten Sie beide Protokollpfade testen.
Pro oder Flash nach der Preiserhöhung?
V4-Pro-0813 übertrifft V4-Flash-0731 in allen zehn veröffentlichten Kennzahlen. Wie groß der Vorsprung ausfällt, hängt jedoch von der Aufgabenkomplexität ab:
| Benchmark | Pro 0813 | Flash 0731 | Abstand |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 Punkte |
| DeepSWE | 62.7 | 54.4 | 8.3 Punkte |
| AutomationBench | 31.8 | 25.1 | 6.7 Punkte |
| Cybergym | 83.3 | 76.7 | 6.6 Punkte |
V4 Pro ist die passende Wahl, wenn:
- Ihr Agent-Loop wiederholt einen stabilen, großen Präfix. Die Einsparungen durch Cache-Hits greifen weiterhin, wenn auch bei höherem Basistarif
- Sie die höhere Parameterzahl von Pro für komplexes Reasoning, mehrstufige Tool-Nutzung oder Code-Generierung im großen Maßstab benötigen
- Ihr Workload mit dem Limit von 500 parallelen Anfragen auskommt
V4 Flash passt besser, wenn:
- Ihre Aufgaben einfach, hochvolumig oder latenzkritisch sind
- Sie für Fan-out-Workloads das Limit von 2.500 parallelen Anfragen brauchen
- der Qualitätsunterschied keinen dreimal höheren Output-Preis rechtfertigt
Eine ausführlichere Gegenüberstellung finden Sie in unserem Vergleich DeepSeek V4 Flash vs Pro. Wer das Modell ohne API-Keys ausprobieren möchte, erhält über die V4-Pro-Chatseite und die V4-Flash-Chatseite direkten Zugang.
FAQ
Sind die V4-Pro-0813-Gewichte für Self-Hosting verfügbar?
Ja. Sie stehen unter MIT-Lizenz auf Hugging Face bereit und bieten Pfade über vLLM und SGLang. Details zum Deployment stehen oben im Abschnitt zu den offenen Gewichten.
Sollte ich mit der GA von V4 Flash auf V4 Pro wechseln?
Für die meisten kostenbewussten Workloads bleibt Flash die bessere Wahl. In den Benchmarks liegt es je nach Test zwischen 0.5 Punkten bei Agents' Last Exam und 8.5 Punkten bei HLE mit Tools hinter Pro, kostet beim Output aber nur ein Drittel. Ein Wechsel zu Pro lohnt sich, wenn Ihr Workload die volle Parameterzahl für komplexes mehrstufiges Reasoning oder Code-Generierung im großen Maßstab benötigt.
Wie minimiere ich die Auswirkungen der Preiserhöhung?
Drei Hebel sind entscheidend: Planen Sie Batch-Jobs und verschiebbare Agent-Aufgaben außerhalb der Peak-Zeiten von 01:00–04:00 und 06:00–10:00 UTC; maximieren Sie Cache-Hits durch stabile Prompt-Präfixe; routen Sie einfache Aufgaben an Flash oder verwenden Sie bei Pro den Reasoning-Aufwand low.
Gilt die Peak-/Off-Peak-Abrechnung auch für die DeepSeek-App und die Website?
Die offizielle Preisseite dokumentiert ausschließlich die tokenbasierte API-Abrechnung. Der genannte Zeitplan gilt für direkte API-Aufrufe; Gateway-Provider können ihn weiterreichen, Aufschläge berechnen oder eigene Tarife nutzen. Die aktuellen Details stehen auf der Preisseite.