 AIREITER
别只看单项跑分来选模型:真正决定结果的,是你的工作负载形态和实际计费路径。需要原生视觉能力时选 GLM-5.3-Flash;如果是缓存命中率高的文本与代码任务,DeepSeek V4 Flash 更值得优先尝试。
先确认:这里比较的是哪两个模型
本文对比的是 GLM-5.3-Flash(glm-5.3-flash)以及 DeepSeek 面向生产环境的 API 模型 deepseek-v4-flash。后者在官方定价页中标注的发布版本为 DeepSeek-V4-Flash-0731。DeepSeek V4 Pro 和独立的 deepseek-v4-flash-vision-exp 端点,都不能直接替代本文所说的主 Flash 模型。关于 Ox Alpha 的身份、硬件限制及预览版注意事项,可参考 AIReiter GLM-5.3-Flash review。
按工作负载快速选型
| 你的首要需求 | 建议选择 | 原因 |
|---|---|---|
| 截图转代码、UI 检查、视频或文件输入 | GLM-5.3-Flash | 同一个模型原生支持图像、视频和文件输入 |
| 高缓存命中的纯文本批处理 | DeepSeek V4 Flash | 官方缓存输入价格更低,尤其是在非高峰时段 |
| GLM 促销期间,以新输入和高输出为主的流量 | GLM-5.3-Flash | 促销输入和输出单价均低于 DeepSeek 官方的缓存未命中和输出价格 |
| 以终端为核心的编程任务,且希望采用稳妥的生产方案 | DeepSeek V4 Flash | 有带版本号的公测路径,以及官方 Flash 评测结果 |
| 视觉浏览器或电脑操作 Agent | GLM-5.3-Flash | 视觉反馈可留在编程或工具调用闭环中 |
| 100 万 Token 级文本上下文 | 默认都不选 | 两者都宣传 100 万 Token 级上下文,需在实际提示词规模下测试检索能力 |
| 一套模型处理混合文本、代码和图片 | GLM-5.3-Flash | 主多模态流程无需额外接入视觉端点 |
官方规格里真正写了什么
Z.AI model documentation 和 Z.AI pricing page 说明了 GLM 的模型能力与计费方式。DeepSeek 则通过 Models & Pricing documentation 和 change log 提供相应的 Flash 版本和功能信息。
| 规格 | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| API 模型 ID | glm-5.3-flash | deepseek-v4-flash |
| 公开版本 | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| 上下文窗口 | 1M tokens | 1M tokens |
| 官方文档列出的最大输出 | 128K tokens | 384K tokens |
| 主要输入类型 | 文本、图像、视频和文件 | 文本和代码;视觉能力为独立实验模型 |
| 输出 | 文本 | 文本 |
| 推理控制 | 启用 Thinking;支持 reasoning_effort | 支持思考与非思考模式;可选 low、high 和 max effort |
| 工具与结构化输出 | 函数调用、流式输出、上下文缓存和 JSON 输出 | 工具调用、JSON 输出、Responses API 和 Anthropic API 兼容性 |
| 权重 | 提供商已发布开放权重 | 提供商已发布开放权重 |
GLM 的 320B 总参数和 18B 激活参数,描述的是稀疏专家架构,并不意味着它是一个 18B 的本地检查点;DeepSeek 官方 Flash 定价页未公布可直接对应的参数量。
GLM 在主模型路径中即可接收视觉输入;DeepSeek 则单独提供 deepseek-v4-flash-vision-exp,这会改变你的路由设计和测试前提。
编程与 Agent:其实是两类不同的测试
终端 Agent 考验的是代码仓库理解与工具执行;视觉 Agent 还要能读懂渲染后的界面和 GUI 状态。
终端与代码仓库任务
Z.ai 的发布表格和 DeepSeek 的官方 7 月 31 日更新给出了以下成绩:
| 基准测试 | GLM-5.3-Flash | DeepSeek V4 Flash | 证据状态 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | 由两家提供商分别报告的评测 |
| DeepSWE | 63.4 | 54.4 | 由两家提供商分别报告的评测 |
| Toolathlon Verified | 78.4 | 70.3 | 由两家提供商分别报告的评测 |
| AutomationBench | 48.8 | 25.1 | 由两家提供商分别报告的评测 |
| Agents’ Last Exam | 26.3 | 25.2 | 由两家提供商分别报告的评测 |
在这些由厂商自行报告的基准中,GLM 处于领先位置。但由于测试框架并不相同,这些分数适合用来缩小候选范围,而不该直接替你做最终决定。
独立证据让结论没有那么一边倒。Composio 在 8 月 27 日测试了 30 个多步骤 Agent 任务,GLM-5.3-Flash 完成了 21/30,DeepSeek V4 Flash 完成了 20/30。DeepSeek 在 30 个任务中的 19 个里速度最快;按每个成功任务计算,报告中的成本约为 DeepSeek $0.028,GLM 约 $0.06。这些数据来自 Composio’s test,并非任一模型提供商发布。
如果你的 Agent 高度依赖终端,在速度、可复现性和便于在生产环境中解释的初始方案之间取平衡时,可以先从 DeepSeek V4 Flash 开始。若首轮修复质量或更广泛的工具使用表现值得为之测试,再将 GLM 纳入对照,衡量它是否值得高于该低成本方案的投入。
工具调用、浏览器状态与视觉反馈
当 Agent 必须检查自己生成的代码最终呈现效果时,GLM 的产品匹配度更高。Z.ai 描述的工作闭环是:模型读取截图或渲染后的界面,修改实现,再检查结果。这适用于截图转代码、前端调试、浏览器操作、文档处理以及部分 3D 工作流。
DeepSeek 可通过 deepseek-v4-flash 处理文本和代码型 Agent 工作;视觉输入则需要走独立的 deepseek-v4-flash-vision-exp 路径。如果现有流水线已经具备视觉路由,这种拆分可以接受。但如果 Agent 要在源码、浏览器截图和视频之间切换且不希望更换端点,GLM 会是更干净的选择。该站的 DeepSeek V4 Flash Vision Exp API guide 介绍了这一替代方案。
跑分之后,真实用户怎么说
社区反馈更像是一种取舍,而非出现了绝对赢家。一位用户在高强度使用 GLM-5.3-Flash 两天后表示:它在较小上下文下表现不错,但提示词变长后稳定性下降;不过该用户也认可其图像支持能力:
“当上下文变大时,它开始显得焦躁而且粗糙。”—— @XBToshi,在一篇公开对比中总结两天的 GLM-5.3-Flash 重度使用体验
这只是个案,并不代表故障率。但它指出了基准表格难以反映的一种失效模式:上下文窗口足够大,不等于多轮 Agent 行为一定稳定。
一项小规模的 Ollama experiment 也更偏向 DeepSeek 的提供商专属配额单位,但作者并未将这些单位直接等同于 API 的美元成本。
延迟与服务表现会改写答案
目前没有针对这两个确切模型、采用同一测试框架发布的 p50 延迟或吞吐量对比;不要把 Pro、Vision-Exp 或其他路由的结果套用过来。Composio 发现 DeepSeek 在 30 个 Agent 任务中的 19 个里最快,这是有参考价值、但并非吞吐量指标的信号。交互式助手应测量首次有效工具调用的时间;批处理任务则应测量到获得可接受结果的总墙钟时间。
Token 单价,不等于完成一个任务的成本
官方价目表给出的结论,比“DeepSeek 更便宜”复杂得多。Z.AI 列出了 GLM-5.3-Flash 的 50% 促销活动,截止到 2026 年 9 月 9 日 24:00 UTC+8。DeepSeek 则对缓存命中和缓存未命中分别定价,并区分高峰与非高峰费率。
以下价格均以每 100 万 Token 的美元价格计算。
| 计费项目 | GLM-5.3-Flash 促销价 | GLM-5.3-Flash 标准价 | DeepSeek V4 Flash 非高峰 | DeepSeek V4 Flash 高峰 |
|---|---|---|---|---|
| 新输入/缓存未命中输入 | $0.075 | $0.15 | $0.22 | $0.44 |
| 缓存输入 | $0.015 | $0.03 | $0.007 | $0.014 |
| 输出 | $0.25 | $0.50 | $0.66 | $1.32 |
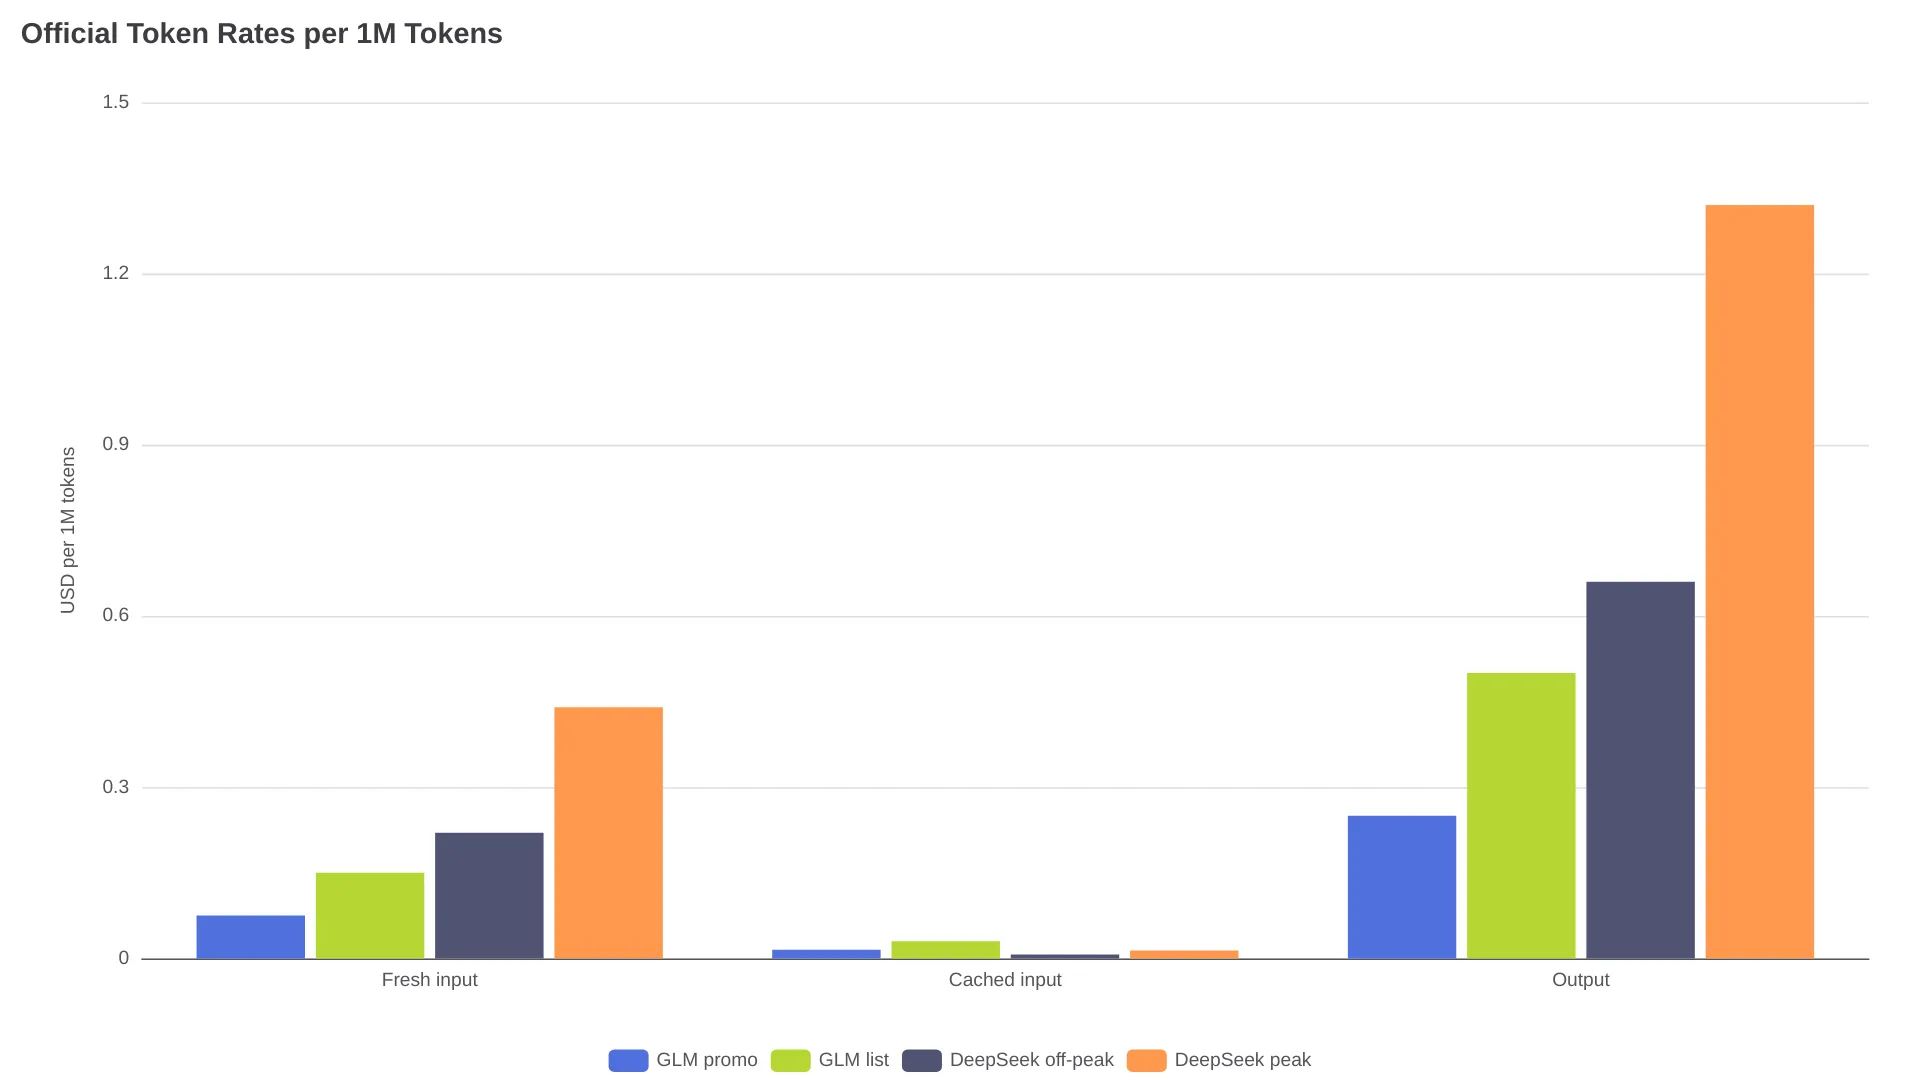
DeepSeek 的高峰时段为周一至周五 01:00–04:00 UTC 以及 06:00–10:00 UTC,其他时间均为非高峰。其官方价格表还列出 V4 Flash 支持 2,500 并发。GLM 的定价页列出了限时免费的缓存输入存储,但没有在该页面给出统一的并发数量。
- 缓存输入价格,DeepSeek 始终更低,在所有对应时段均是如此。
- 新输入和输出价格,GLM 促销价更有优势,低于 DeepSeek 官方的缓存未命中和输出费率。
- 促销结束后,GLM 的标准新输入和输出价格仍低于 DeepSeek 列出的非高峰价格。
- DeepSeek 最具优势的价格场景,是缓存占比高、输入占主导、输出较短,且可调度到非高峰时段的流量。
以 1000 万输入 / 200 万输出为例
假设有 1000 万新输入 Token 和 200 万输出 Token,不计工具费用和重试:
| 模型与计费路径 | 计算方式 | 总价 |
|---|---|---|
| GLM 促销价 | 10 × $0.075 + 2 × $0.25 | $1.25 |
| GLM 标准价 | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek 非高峰,缓存未命中 | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek 高峰,缓存未命中 | 10 × $0.44 + 2 × $1.32 | $7.04 |
如果这 1000 万输入 Token 全部命中缓存,DeepSeek 非高峰总价会变为 $1.39(10 × $0.007 + 2 × $0.66),GLM 促销期总价则为 $0.65(10 × $0.015 + 2 × $0.25)。当输入输出比进一步拉高、输出更短时,DeepSeek 的缓存优势会变得更重要。
哪些情况下 DeepSeek 的低账单足以决定选择
如果大部分请求都会复用很长且稳定的系统提示词或仓库前缀,生成的回答短,并且能避开高峰运行,那么选择 DeepSeek V4 Flash。分类、信息抽取、摘要和常规纯文本自动化,比截图驱动的 Agent 更符合这一模式。
GLM 的额外能力何时反而更省钱
如果图像、文档或视频本来需要额外发起一次视觉请求,GLM 便可能降低整条流水线的成本。对于会生成长代码补丁的 Agent,其促销期输出费率同样值得关注。但不要默认它在单任务成本上一定更低,应以实际计费 Token、修复循环次数和任务接受率验证这个判断。
长上下文是容量承诺,不是质量保证
两套官方文档都标注了1M-token context window,因此单看上下文长度两者打平。DeepSeek 标注的最大输出为 384K;Z.AI 的模型文档中,GLM-5.3-Flash 的最大输出为 128K。只有允许生成异常长内容的应用,才会真正受到这一差异影响。
Z.ai 表示,相比 GLM-5.3,GLM 的注意力计算降低了 3.01×,KV-cache 大小降低了 4.44×;同时也指出,GLM 的 KV cache 仍略高于 DeepSeek V4 Flash。这些厂商说法不足以证明它相对 DeepSeek 具备延迟或检索质量优势。
请在 50K、200K 以及你的实际最大提示词规模下,测试检索、工具完成率和任务接受率,并采用下文所述的验收规则。
选定默认模型,或让两者协同路由
| 工作负载 | 优先测试的模型 | 回退或升级方案 |
|---|---|---|
| 纯文本分类与信息抽取 | DeepSeek V4 Flash | 格式或质量不达标时转 GLM |
| 高缓存命中的仓库对话 | DeepSeek V4 Flash | 复杂修复轮次使用 GLM |
| 终端编程 Agent | DeepSeek V4 Flash | 首轮完成率更重要时使用 GLM |
| 截图转代码 | GLM-5.3-Flash | 纯文本后续工作使用 DeepSeek |
| 浏览器或电脑操作 Agent | GLM-5.3-Flash | 非视觉规划步骤使用 DeepSeek |
| 基于视频、图像或文件的分析 | GLM-5.3-Flash | 可接受独立路由时使用 DeepSeek Vision Exp |
| 长文本、短输出 | DeepSeek V4 Flash | 检索效果下降时转 GLM |
| 促销期内的长代码生成 | GLM-5.3-Flash | 缓存命中经济性占主导时使用 DeepSeek |
在切换生产工作负载前,建议先跑一轮小规模、同一测试框架下的验收:
- 固定准确的模型 ID:
glm-5.3-flash和deepseek-v4-flash;不要让路由器在后台自动替换为 Pro 或 Vision-Exp。 - 选取 20–50 个真实任务,覆盖成功案例和近期失败案例。若产品是 Agent,至少应包含五个工具调用任务。
- 记录通过率、修复循环次数、遗漏工具调用、首次有效操作耗时、总输入/输出 Token 数和缓存命中率。
- 对比每个被接受任务的成本;在超时率和失败率稳定前,保留另一模型作为回退方案。
Z.AI’s quick start 和 DeepSeek’s first API call guide 都介绍了 OpenAI 兼容访问方式,但两者的推理控制、视觉路由和计费语义并不相同。
采购方还常问的问题
GLM-5.3-Flash 和 Ox Alpha 是同一个模型吗?
Z.ai 官方确认,GLM-5.3-Flash 就是其此前以 Ox Alpha 匿名测试的模型。不过,预览版的路由方式、配额与端点行为,不应被视为公开模型的长期固定规格。
可以先按上方路由表选型,再用固定 ID、真实失败案例和同一测试框架验证默认模型。GLM-5.3-Flash review 覆盖了模型身份与部署证据;DeepSeek V4 Flash Vision Exp API guide 则介绍独立的视觉路径。