 AIREITER
在正式揭晓之前,Ox Alpha 一直以匿名模型的身份流传。如今,Z.ai 终于给这个实验项目补上了公开名称:GLM-5.3-Flash。不过,“Flash”这个名字不能只按字面理解:它每个 token 实际激活 18B 参数,但公开 checkpoint 的总规模约为 320B。即使在本地运行,依然需要相当可观的硬件。
先说结论:Ox Alpha 就是 GLM-5.3-Flash 的预览版
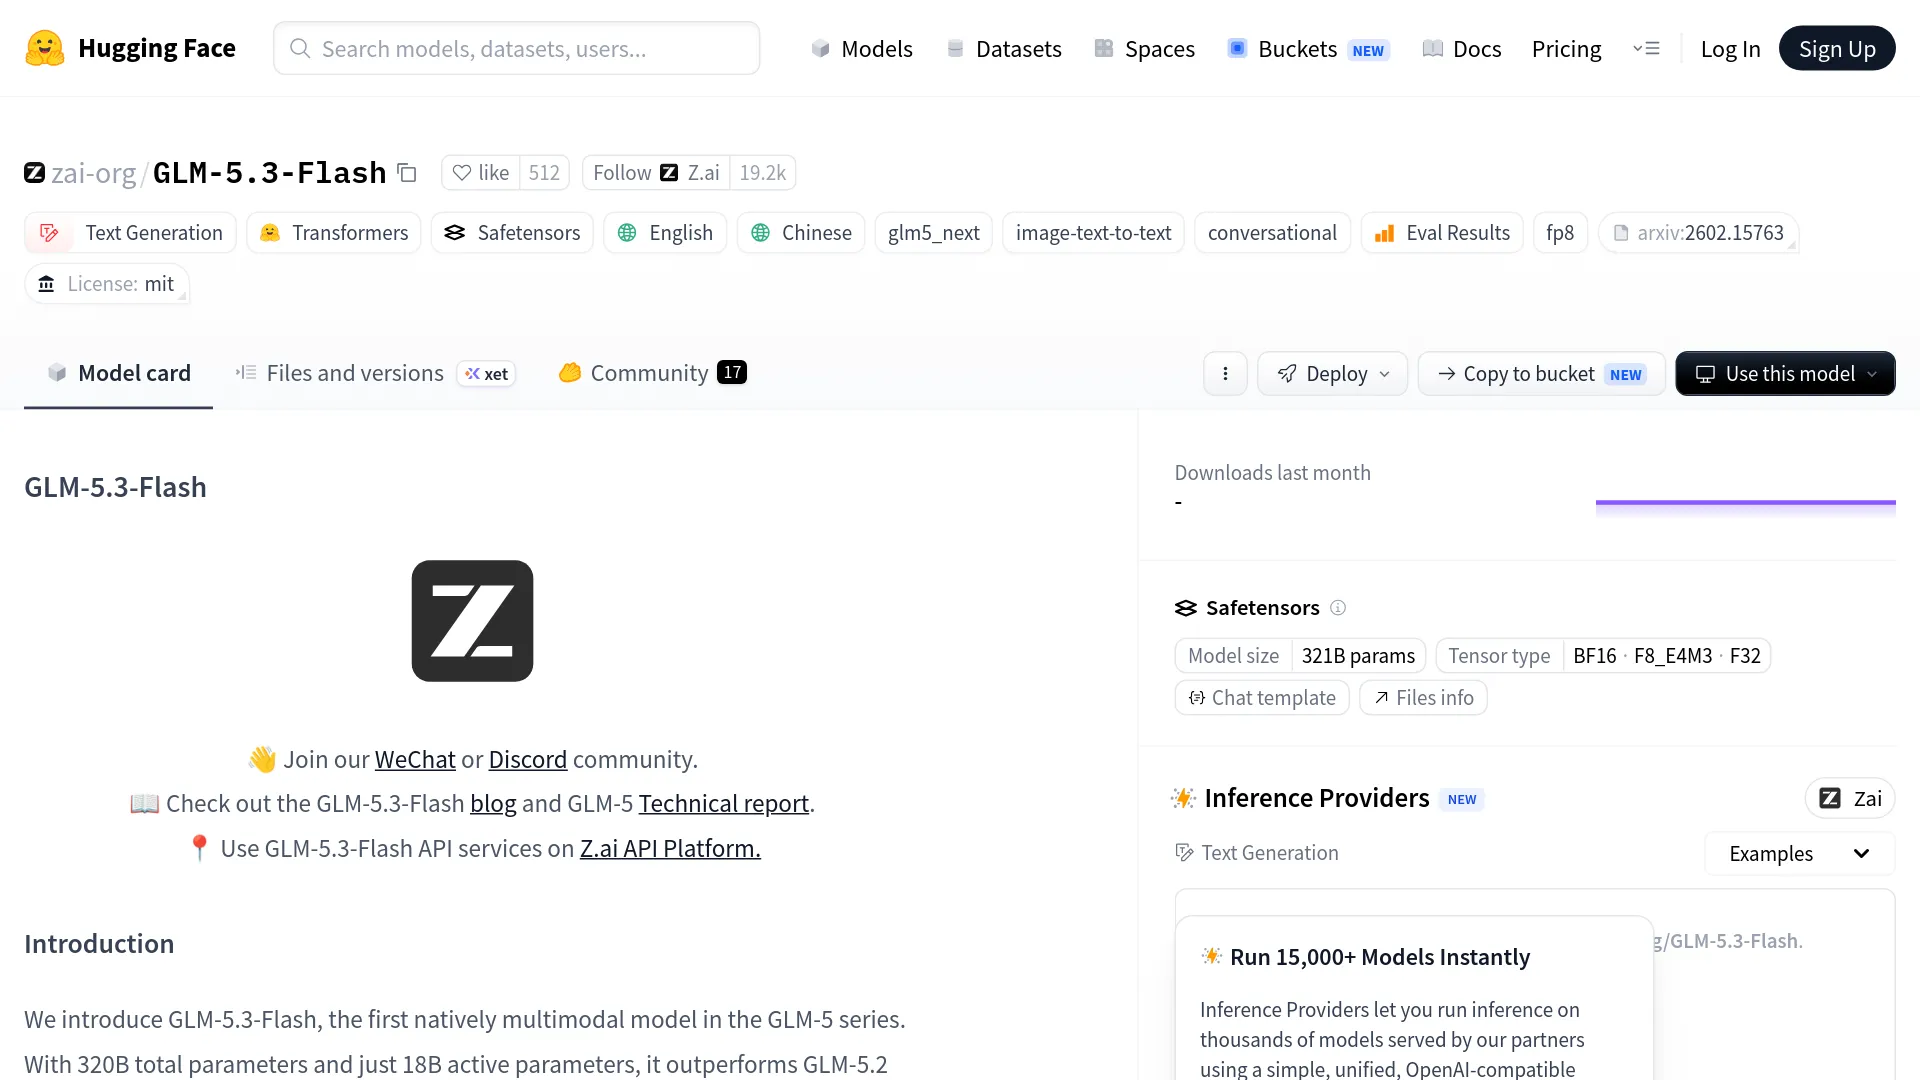
Z.ai 在2026 年 8 月 26 日的公告中确认,GLM-5.3-Flash 就是此前以匿名身份出现在 OpenCode 和 OpenRouter 上的 Ox Alpha。官方 Hugging Face 模型卡现在已经列出了公开 checkpoint、MIT 许可证、多模态输入,以及本地部署参考资料。
因此,关于 Ox Alpha 的早期报告更适合被视为预览阶段的参考,而不是正式发布模型的规格说明。Ox Alpha 当时有自己的路由、流量和运营条件,早期用户反馈中的速度、配额和策略限制,并不一定适用于所有 GLM-5.3-Flash 接口。
“对我来说什么都没改变。这两个模型对于我的 32 GB 内存系统来说都太大了。”——r/LocalLLaMA 用户 u/dampflokfreund
GLM-5.3-Flash 核心规格一览
| 规格 | GLM-5.3-Flash |
|---|---|
| 正式发布 | 2026 年 8 月 26 日 |
| 早期预览名称 | Ox Alpha / ox-alpha |
| 模型规模 | 总参数 320B,每个 token 激活 18B |
| 上下文窗口 | 1,048,576 tokens(1M) |
| 输入 | 文本、图片和视频 |
| 输出 | 文本 |
| 许可证 | MIT |
| 官方 checkpoint | zai-org/GLM-5.3-Flash |
| API 输入价格 | 每 1M tokens 0.15 美元 |
| 缓存输入价格 | 每 1M tokens 0.03 美元 |
| API 输出价格 | 每 1M tokens 0.50 美元 |
Hugging Face 页面显示的模型存储规模约为 321B 参数,而模型介绍中使用的是更简洁的320B-A18B。前者代表完整存储规模,后者代表每个 token 实际参与计算的参数量。18B active 并不意味着它会变成一个只需 18B 显存或内存的本地模型。
从 Ox Alpha 到正式模型,变化在哪里
Z.ai 表示,正式发布前曾将 GLM-5.3-Flash 以 Ox Alpha 的匿名形式部署在 OpenCode 和 OpenRouter 上,以收集真实使用反馈。OpenRouter 页面当时将它列为支持多模态和长上下文的模型,并提供临时的 0 美元价格。正式发布后,服务提供方、checkpoint 和许可证终于都有了明确归属。
不过,预览服务和正式模型仍然是两套不同的运行环境。分词器一致,或者出现 GLM 风格的 API 报错,可以作为判断模型血缘的线索,但无法证明每一次匿名请求都使用了最终权重,也无法证明它们经过了相同的路由层。如今,公开 checkpoint 才是部署和复现时应当参考的对象。
“Flash”背后的模型架构
GLM-5.3-Flash 采用稀疏混合专家架构,并对注意力机制进行了调整,目标是降低超长上下文的计算成本。Z.ai 给出的信息包括:总参数 320B、激活参数 18B、45 层网络、稀疏注意力与线性注意力混合架构、IndexPool 检索,以及 Manifold-Constrained Hyper-Connections(mHC)。模型卡还表示,它的训练使用了 30T tokens 的多模态预训练语料。
与 GLM-5.3 相比,Z.ai 宣称 GLM-5.3-Flash 在 1M 上下文下的注意力计算量降低了 3 倍,KV cache 缩小了 4.4 倍。但这属于厂商给出的架构层面数据,并不能直接等同于与硬件无关的延迟保证。实际速度仍会受到上下文长度、并发量、视觉预处理和推理服务栈的影响。
它原生支持多模态,真正有价值的地方不只是“视觉聊天”这么简单。Z.ai 更看重的是代理工作流:让智能体查看渲染后的界面、浏览器状态、文档或其他视觉结果,再据此修改代码或输出内容。官方模型卡展示了图片输入,公开模型和部署文档也说明支持视频输入。
基准测试能说明什么,不能说明什么
官方发布材料和模型卡给出了相当亮眼的成绩,尤其是在编程和智能体任务上。模型卡中列出的结果包括:TerminalBench 2.1 得分 84.3、DeepSWE 得分 63.4,以及 HLE 得分 55.3。Z.ai 的发布材料还给出了 Artificial Analysis Intelligence Index 57 分、AutomationBench 48.8 分,以及 Z.ai Code Bench maximum-effort 29.0 分。
| 基准测试 | GLM-5.3-Flash | 对比对象或基线 | 来源与限制 |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2:81.0;Claude Opus 4.8:85.0 | Z.ai/模型卡结果;测试框架和资源预算都会影响结果 |
| DeepSWE v1.1 | 63.4 | GLM-5.2:46.2 | 公开评测结果;不能外推到所有代码仓库 |
| AutomationBench | 48.8 | GLM-5.2:26.2 | 在指定基准版本下进行的公开评测 |
| Z.ai Code Bench,maximum effort | 29.0 | Claude Opus 4.8:29.5 | 在 Z.ai 测试设置下接近持平 |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai 称其与 Claude Opus 4.8 相当 | 外部综合指数,并非只针对编程任务的分数 |
这些结果使用了不同的测试框架、上下文限制、超时设置和评判器,最多只能用来判断大致趋势,不能简单拼成一张统一排行榜。相对稳妥的结论是:在编程智能体评测中,GLM-5.3-Flash 相比 GLM-5.2 有可信的明显提升;但这并不等于它已经在所有前沿模型面前占据优势。
早期社区测试也需要同样谨慎看待。@prz_chojecki 曾报告,Ox Alpha 在 ErdosBench 的 226 道题目上全部优于 GLM-5.2。这类观察适合用来设计后续测试用例,但不能替代在自己的工具链和代码仓库上进行受控评测。
早期用户遇到的实际限制
“Flash”更准确地描述了模型的激活计算量和成本定位,而不是交互延迟。r/opencodeCLI 的真实用户讨论同时提到了很强的编程能力和令人烦躁的等待时间,尤其是在匿名预览阶段。这些反馈与服务提供方和工作负载有关,不能当作官方延迟基准。
“如果它比主模型慢很多,怎么还能叫‘Flash’?”——r/opencodeCLI 用户 u/ahriad
更值得关注的运行指标,是高负载下长时间智能体任务的稳定性。@solomonneas 曾报告,在为期七天的测试中,49 次尝试成功构建了 30 次,另有 14 次失败原因是超时。这并不能证明官方 API 存在固定失败率,但足以说明,对于可能运行数小时的任务,最好准备备用路由。
基准测试标题往往会掩盖另一个现实限制:官方 FP8 checkpoint 在不计算运行时和 KV cache 开销的情况下,体积约为 306 GiB。因此,一个总参数量 320B 的模型,即使每个 token 只激活 18B 参数,本地运行依然需要高内存基础设施。
API、托管服务与本地部署怎么选
如果选择托管服务,Z.ai 的价格页面显示,GLM-5.3-Flash 的输入价格为每 1M tokens 0.15 美元,缓存输入为每 1M tokens 0.03 美元,输出为每 1M tokens 0.50 美元。目前还有一个临时 50% 促销价:输入 0.075 美元、缓存输入 0.015 美元、输出 0.25 美元,截止时间为 2026 年 9 月 9 日 24:00,UTC+8。由于促销有明确结束时间,做预算前应查看Z.AI 官方价格表。
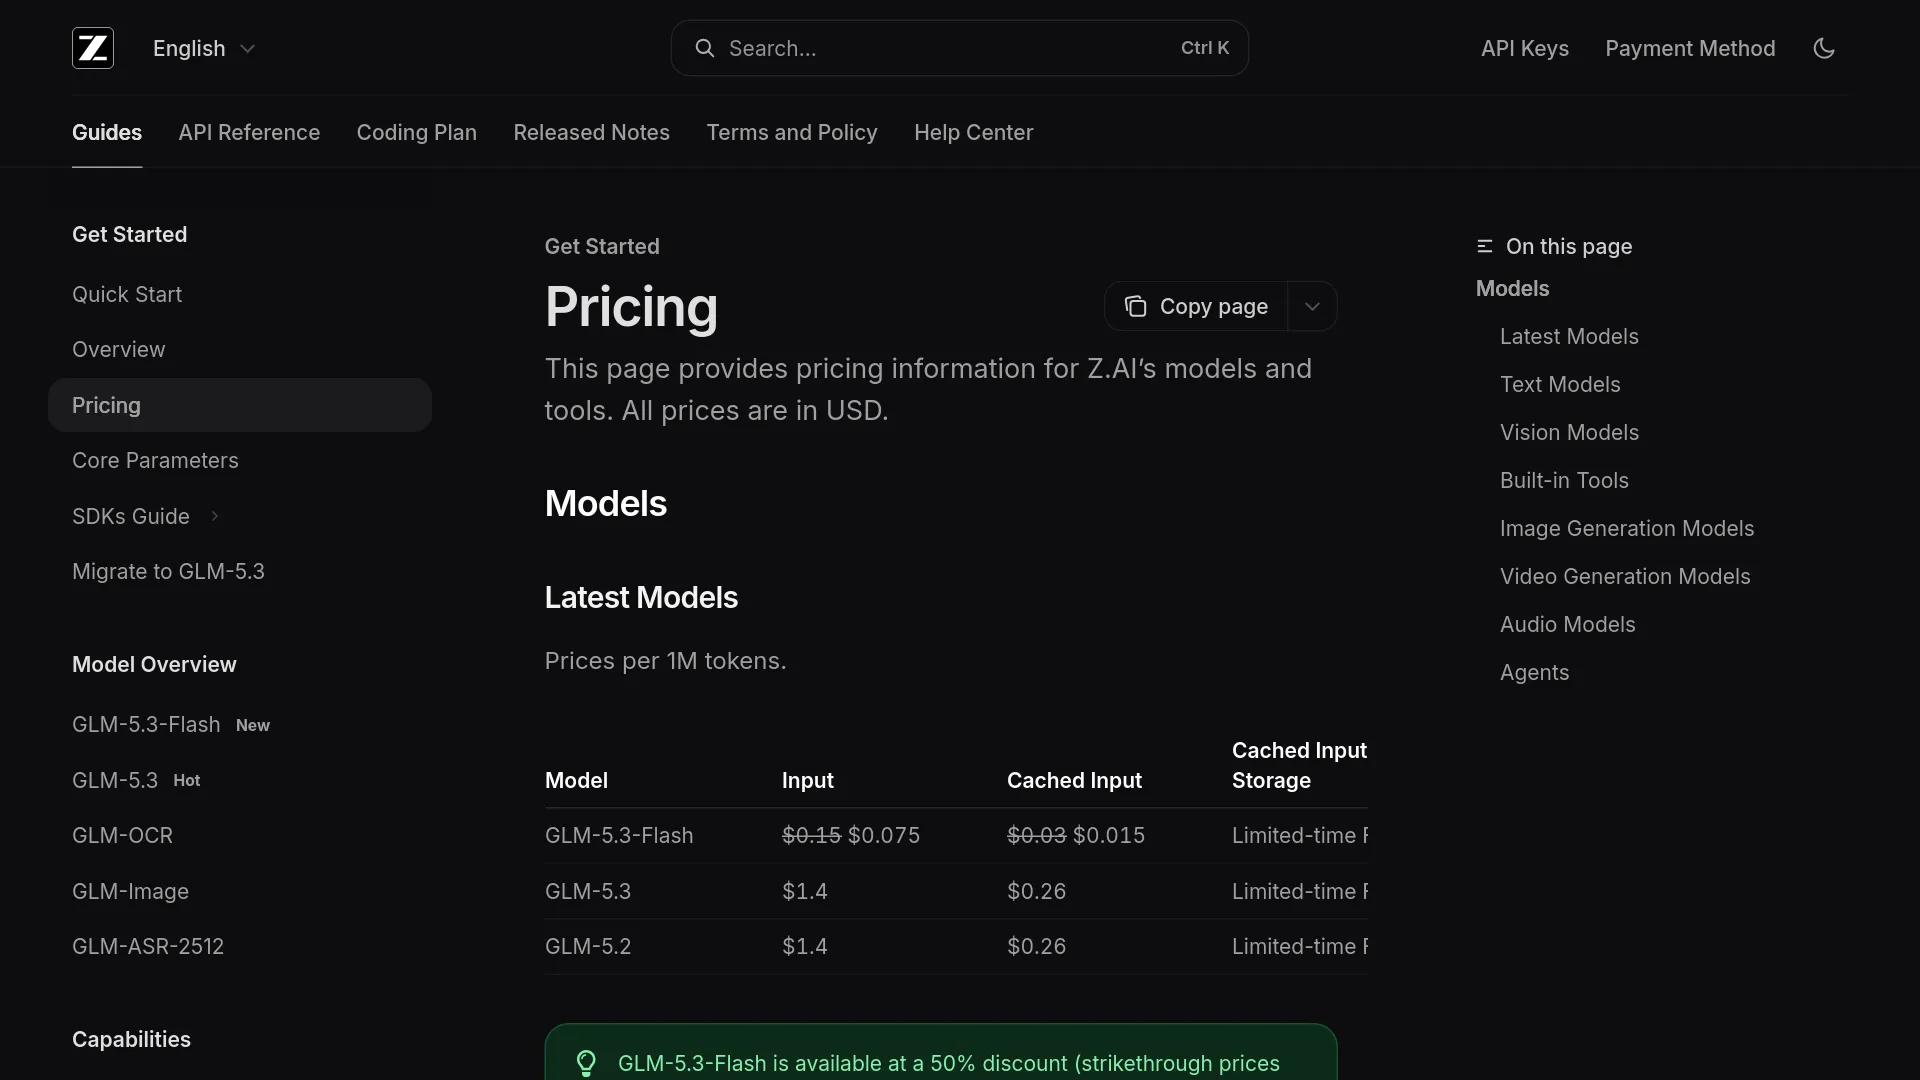
公开标准价格与 Ox Alpha 预览阶段的临时价格不是一回事。举个简单例子,按标准价格计算,1000 万输入 tokens 加上 200 万输出 tokens,总费用是2.50 美元,不考虑其他服务商费用:10 × 0.15 + 2 × 0.50。如果服务商将部分输入 tokens 按缓存计费,缓存输入可以进一步降低输入部分的成本。
本地部署当然可行,但它更像一个基础设施项目,而不是下载到笔记本上就能运行的软件。官方vLLM 部署配方显示,FP8 权重大约需要 306 GiB,默认 FP8 部署需要 386GB 显存;BF16 配置则列出了 772GB。目前官方支持路径还要求 NVIDIA Hopper 或更新架构的 GPU、较新版本的 FlashInfer,以及一个专用 vLLM 镜像,相关集成仍在完善。
KTransformers 教程记录了 CPU-GPU 异构推理、直接加载官方 FP8 权重,以及至少 350GB 可用系统内存的要求。教程中的单 GPU 示例是 offload 配置,并不意味着一张消费级 GPU 就能装下整个模型。该教程还采用了经过验证的 501,025-token 设置,并将每次多模态请求限制为最多八张图片或一个视频。
| 部署方式 | 文档支持的能力 | 主要限制 |
|---|---|---|
| Z.ai API | 按量计费的托管访问;公开标准价格和促销 token 价格 | 确认速率限制、地区条款和当前促销活动 |
| vLLM | FP8/BF16 服务、OpenAI 兼容接口、张量并行和多模态路径 | 需要高内存 NVIDIA 基础设施;当前配方面向 Hopper+ |
| KTransformers | CPU-GPU 异构推理和 FP8 加载 | 权重大约 306 GiB;建议至少 350GB 系统内存 |
| Ollama/LM Studio/llama.cpp 生态 | 模型卡指向量化分发包和兼容工具 | 量化支持和运行速度取决于具体构建版本 |
现在适合哪些人使用 GLM-5.3-Flash?
适合成本敏感型编程智能体和长上下文工程试点。较低的标准价格、1M 上下文,以及相较 GLM-5.2 的公开评测提升,让它很适合代码仓库分析、多文件修改、测试生成和反复调用智能体。正式投入前,建议保留验收测试和备用模型,直到你自己的成功率稳定下来。
当纯文本 GLM 模型成为瓶颈时,可以用它处理多模态技术任务。图片和视频输入能够帮助智能体检查浏览器输出、UI 布局、图表、文档和渲染结果。它不是视频生成模型,而是理解视觉输入,并输出文本或代码。
不要因为“18B active”听起来像桌面级模型,就直接选择它。完整 checkpoint 的规模约为 320B 参数,本地部署在上下文和运行时开销之外,还需要数百 GB 的存储或内存。除非你已经拥有高内存推理硬件,否则托管 API 通常是更简单、经济的选择。
不要把机密代码发送到未经验证的预览接口。公开发布的 GLM-5.3-Flash 已经明确归属于 Z.ai,但服务商条款、数据留存和请求路由仍然需要关注。生产流量应记录接口当前的数据政策,并使用官方 API,或选择一家运营条款可以审计的服务商。
常见问题
Ox Alpha 和 GLM-5.3-Flash 完全是同一个模型吗?
Z.ai 已正式确认,GLM-5.3-Flash 就是此前以 Ox Alpha 名义进行预览的模型。Ox Alpha 的早期表现仍然有参考价值,但预览阶段的路由和限制不能直接当作公开模型规格。
GLM-5.3-Flash 是开源模型吗?
官方 Hugging Face checkpoint 采用 MIT 许可证发布,Z.ai 也提供了本地部署参考。更准确的说法是“开放权重”:模型权重可以获取,但运行完整模型仍然需要规模不小的基础设施。
GLM-5.3-Flash 本地运行需要多少内存?
官方 FP8 权重在不计算运行时和 KV cache 开销的情况下约占 306 GiB。vLLM 配方为默认 FP8 部署列出了 386GB 显存,而 KTransformers 则建议异构推理至少准备 350GB 系统内存。
API 真的只要每百万输入 tokens 0.15 美元吗?
是的。Z.AI 官方价格页面列出的输入价格是 0.15 美元,缓存输入是 0.03 美元,输出是 0.50 美元;50% 促销价目前列明持续到 2026 年 9 月 9 日,UTC+8。
GLM-5.3-Flash 比其他 Flash 模型更快吗?
现有证据无法证明它在延迟方面拥有统一排名。早期用户曾报告智能体会出现等待时间过长或超时,因此应在自己的服务商路由上测试首 token 延迟、完成时间、重试次数和任务最终接受率。
GLM-5.3-Flash 支持图片和视频吗?
支持。Z.ai 和官方模型卡都说明它可以接收文本、图片和视频,并输出文本。相关本地部署文档还给出了请求边界,例如 KTransformers 的文档配置中,每次请求最多支持八张图片或一个视频。
如果你想使用 GLM-5.3-Flash 的低成本和多模态能力,但不想购买一台配备数百 GB 内存的推理服务器,托管 API 是更现实的选择;只有在已经拥有相应基础设施时,才值得尝试本地部署。对于长时间运行的智能体任务,请保留经过验证的备用模型,因为目前公开证据更能证明它的能力和价格优势,而不是持续交互时的可靠性。