 AIREITER
如果你正在寻找 GLM-5-3-Flash 替代方案,现在最需要的可能不是再看一遍 Ox Alpha 的来龙去脉,而是尽快解决实际迁移问题:替换价格低但偶尔变慢的 Agent 路由、避开 320B 级别的本地模型,或者在不重写 API 客户端的前提下保留多模态能力。究竟该换成谁,取决于你想解决的具体问题。
先说结论:根据你要修复的问题来选
DeepSeek V4 Flash适合需要缓存命中计费、可选非思考模式和高并发能力的文本工作流。它提供 1M token 上下文,并发请求上限为 2,500;官方公布的非高峰价格为:每百万未缓存输入 token 0.22 美元,每百万输出 token 0.66 美元。
Qwen3.8-Flash适合需要图片和视频输入、API 兼容性以及内置工具的托管方案。其公开价格为每百万输入 token 0.15 美元,每百万输出 token 0.47 美元。
GLM-5.3是留在 Z.ai 生态内、但升级到旗舰文本模型时的自然选择。GPT-5.6 Terra和Claude Opus 4.8则属于高价路线,适合那些“任务成功一次”就值得多付几倍费用的场景。Kimi K3提供 1M 上下文能力,但并不是便宜替代品。
真正的问题不是“哪个模型全面胜出”,而是你究竟在优化Token 成本、视觉输入、长周期编程、本地控制,还是任务最终成功率。
Ox Alpha 端点已经消失,先确认你的迁移状态
Z.ai 官方公告于 2026 年 8 月 26 日确认,匿名的 Ox Alpha 预览模型就是 GLM-5.3-Flash。正式发布后,官方提供了具名模型检查点、公开价格、采用 MIT 许可证的 Hugging Face 模型以及文档化的 API 访问方式。不要把旧预览环境当成永久的模型契约:预览路由、配额、延迟和策略行为都可能与正式 API 不同。
如果配置里仍然调用 stealth/ox-alpha,公开的 OpenRouter 标识符是 z-ai/glm-5.3-flash;直接请求 Z.ai 时,通用基础 URL 为 https://api.z.ai/api/paas/v4。Z.ai 还单独提供 Coding Plan 端点 https://api.z.ai/api/coding/paas/v4,因此不要想当然地认为订阅路线和通用 API 的计费方式或限制完全相同。
之前的 AIReiter GLM-5.3-Flash 评测已经介绍过基础情况,包括 18B 激活参数与约 320B 总参数检查点之间的区别。本文进一步回答一个更实际的问题:当它的成本、速度、硬件要求或可靠性不再适合你的工作流时,应该换成什么?
“对我来说什么都没改变。这两个模型对于我的 32 GB 内存系统来说都太大了。”——u/dampflokfreund,r/LocalLLaMA
按价格、上下文和部署方式对比替代方案
下面的价格是截至 2026 年 8 月 28 日核对的服务商公开信息快照,并非统一促销价:DeepSeek 会区分高峰和非高峰时段,Z.ai 的 Flash 价格则包含截至 2026 年 9 月 9 日 24:00 UTC+8 的临时折扣。
| 模型 | 输入 / 每百万 token | 输出 / 每百万 token | 上下文 | 输入模态 | 最适合替代的原因 |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | 非高峰 0.22 美元;高峰 0.44 美元 | 非高峰 0.66 美元;高峰 1.32 美元 | 1M | 文本 | 支持缓存感知的文本路由和非思考模式 |
| Qwen3.8-Flash | 0.15 美元 | 0.47 美元 | 1M | 文本、图片、视频 | 托管多模态能力和 API 兼容性 |
| GLM-5.3 | 1.40 美元 | 4.40 美元 | 1M | 文本 | 同一服务商下的高能力家族路线 |
| GPT-5.6 Terra | 2.00 美元 | 12.00 美元 | 1.05M | 文本 | 更高成功把握的复杂 Agent 任务 |
| Claude Opus 4.8 | 5.00 美元 | 25.00 美元 | 1M | 文本 | 高难度编程和长上下文审查 |
| Kimi K3 | 3.00 美元 | 15.00 美元 | 1M | 文本 | 长上下文能力型工作 |
Z.ai 目前列出的 GLM-5.3-Flash 价格为:促销期间每百万输入 token 0.075 美元、缓存输入 token 0.015 美元、输出 token 0.25 美元,折扣为 50%。正式标价则分别为 0.15 美元、0.03 美元和 0.50 美元。对比图采用的是正式标价,而不是临时促销价。(Z.ai 价格表)
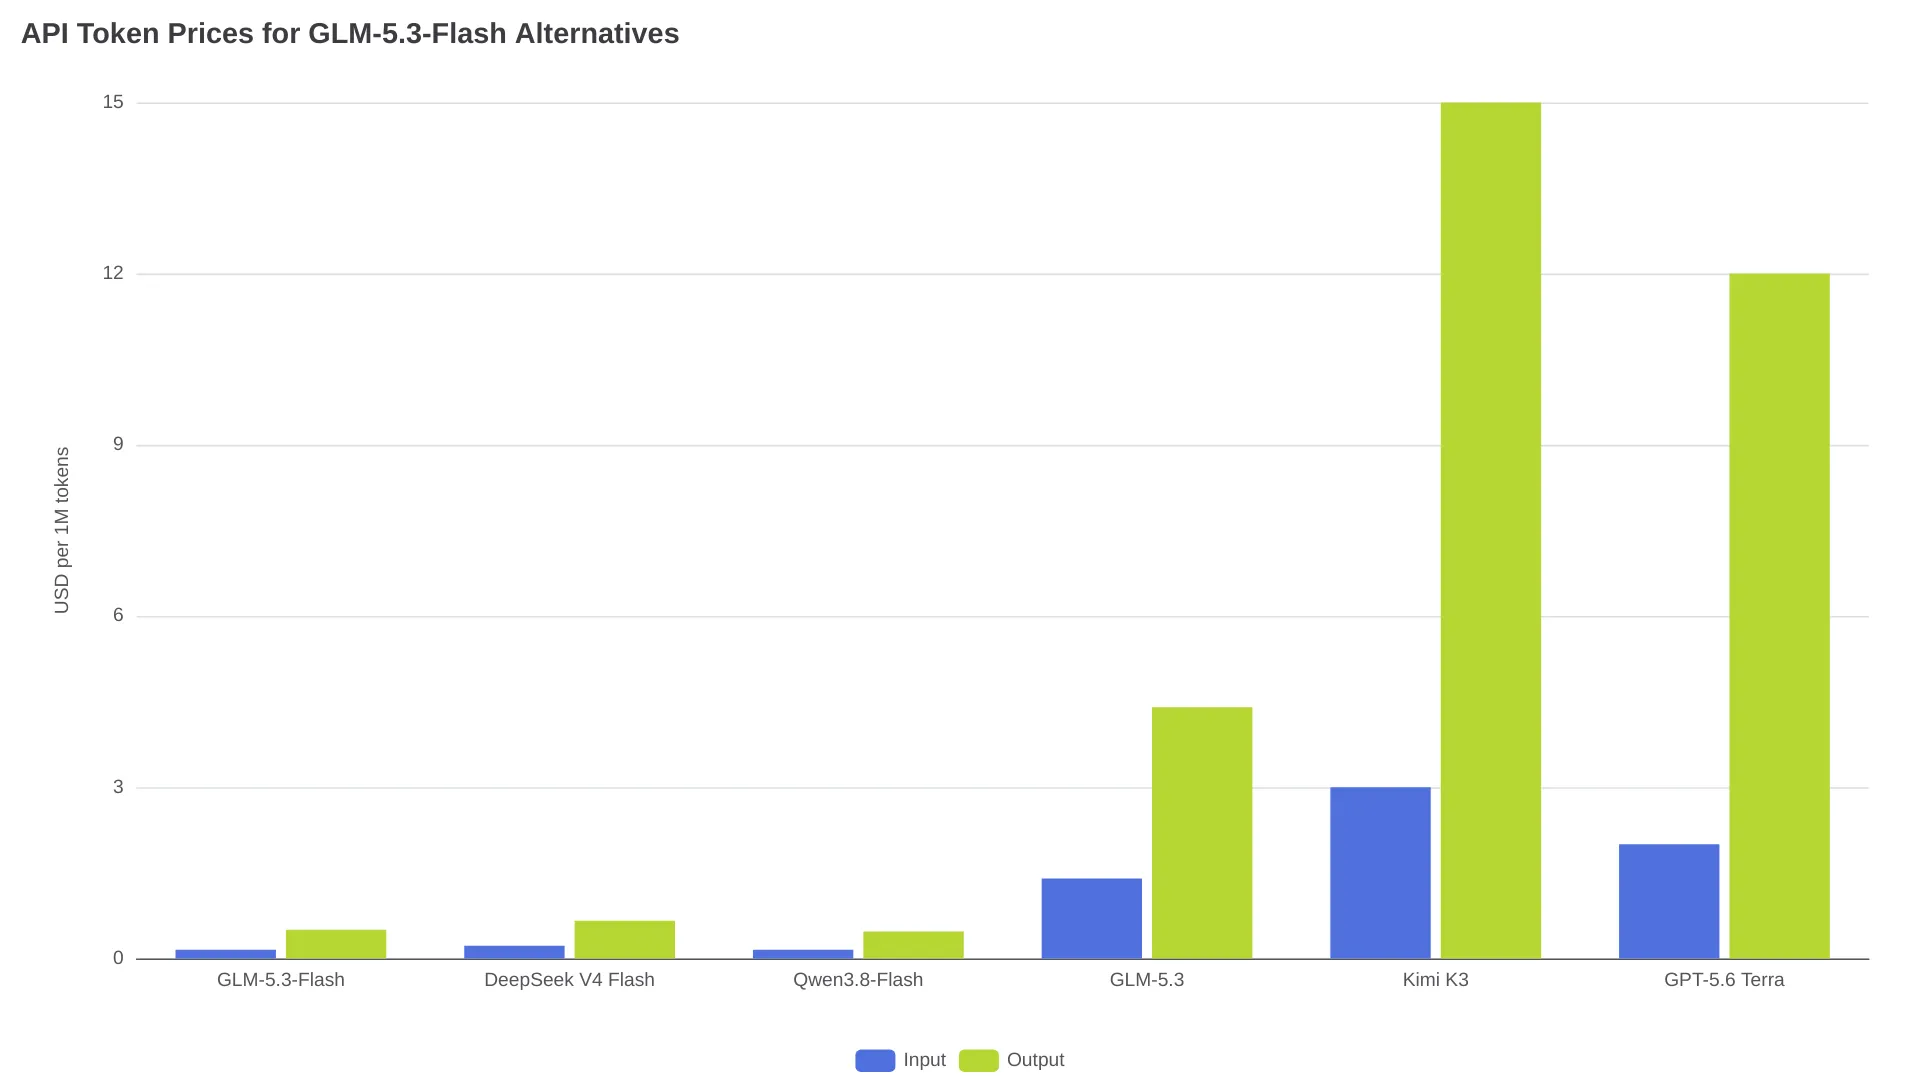
价格口径:GLM-5.3-Flash 正式标价、DeepSeek V4 Flash 官方非高峰价格,以及其他模型当前由服务商公布的价格。DeepSeek 高峰价格是非高峰价格的两倍。
6 条真正可行的替代路线
DeepSeek V4 Flash:面向缓存和文本编程的路线
当 GLM-5.3-Flash 用于日常文本流量的成本过高时,DeepSeek V4 Flash是最值得优先测试的模型。DeepSeek 提供 1M token 上下文、384K 最大输出、JSON 输出、工具调用、Responses API 以及 Anthropic 兼容访问方式。官方并发限制为 2,500 个请求。
计费方式是它的关键区别。DeepSeek 会分别计算缓存命中和缓存未命中,并在工作日高峰时段——UTC 01:00–04:00 和 06:00–10:00——将价格翻倍。它还支持思考和非思考模式;相比之下,GLM-5.3-Flash 模型卡记录的是低、高和最大推理力度,并没有一个简单的“不思考”开关。
如果你的工作流包含大量重复上下文、以检索为主的聊天,或者是纯文本编程,并且看重缓存命中或可控推理,DeepSeek V4 Flash 值得选择。需要注意的是,Qwen3.8-Flash 的新鲜 Token 标价更低,所以 DeepSeek 并不是每种文本请求下都最便宜。它也不是视觉能力上的即插即用替代品:图片输入需要使用 DeepSeek 单独的 deepseek-v4-flash-vision-exp 路线,而且从图片中提取的 Token 会按输入计费。
Qwen3.8-Flash:最接近的托管多模态替代品
如果你的 Agent 会发送截图、图表或视频,同时又希望保留单一的 API 形态集成,Qwen3.8-Flash是最接近的托管替代方案。QwenCloud 列出了图片、文本和视频输入能力,支持 1M token 上下文、991K 最大输入和 131K 最大输出。此外,它还支持 OpenAI 和 Anthropic 兼容 API、工具、结构化输出、缓存、批处理、联网搜索和微调。
实际使用时需要留意它的缓存计费结构。QwenCloud 列出的隐式缓存读取价格为每百万 token 0.016 美元,显式缓存创建为 0.20 美元,输出为 0.47 美元。公开限制为每分钟 2M token 和每分钟 15,000 个请求,但页面没有说明这些限制究竟是按账户、密钥、组织还是部署计算。
当视觉输入不可或缺,或者你更看重新鲜 Token 的价格时,可以优先测试 Qwen3.8-Flash。官方模型页面没有提供具名基准表、延迟结果或长会话可靠性研究,因此不要因为功能列表看起来相近,就默认它们的实际行为也完全一致,最好用自己的 Agent 日志验证。
GLM-5.3:Flash 能力不够时的同家族升级
GLM-5.3并不是低价替代方案。当问题在于纯文本任务的推理深度不够,而不是成本或多模态能力不足时,它是更合理的升级路径。Z.ai 的价格表列出每百万输入 token 1.40 美元、缓存输入 0.26 美元、输出 token 4.40 美元,约为 Flash 正式标价的一个数量级。
Z.ai 将 GLM-5.3 定位为旗舰编程模型,而 GLM-5.3-Flash 则是成本更低、原生支持多模态的模型。对于困难的文本优先任务,可以有选择地切换到 GLM-5.3;但如果你的工作流依赖视觉输入,升级后可能会失去 Flash 原本的优势。
GPT-5.6 Terra:需要更高 Agent 执行成功率时
GPT-5.6 Terra适合把复杂任务完成度放在低 Token 价格之前的团队。OpenAI 列出的价格为每百万输入 token 2 美元、缓存输入 0.20 美元、输出 token 12 美元,上下文窗口约为 1.05M token。在Z.ai 公布的基准表中,GPT-5.6 Terra 在 Terminal-Bench 2.1 和 DeepSWE v1.1 上分别获得 87.4 和 69.6,高于 GLM-5.3-Flash 在所引用测试设置下的 84.3 和 63.4。
当一次失败的编程任务代价高于增加的 API 费用时,这些数字足以说明为什么值得测试 Terra;但它们不能证明 Terra 在所有生产场景中都更强。更合适的用法,是把它作为高价值代码库修改或复杂自主任务的升级层。
Claude Opus 4.8:应对困难编程和长上下文审查
按照 Anthropic 的标准全球价格,Claude Opus 4.8每百万输入 token 5 美元,每百万输出 token 25 美元。Anthropic 还列出每百万 token 0.50 美元的缓存读取价格,以及标准输入和输出价格一半的批处理价格。
在Z.ai 的对比表中,Opus 4.8 在 Terminal-Bench 2.1、Agents’ Last Exam、HLE with Tools 和 NL2Repo 上领先 GLM-5.3-Flash;而 Flash 在多个重工具调用和自动化项目上领先。这样的结果分化,说明 Opus 更适合经过验证后作为升级模型,而不是无条件替换所有默认路由。
Kimi K3:面向 1M 上下文能力型工作,不是低价推理
之所以把Kimi K3列入其中,是因为它对应的是另一种迁移需求:你可能需要一个 1M 上下文路线,用于长周期软件工程或研究工作流。Kimi 列出的价格为每百万缓存输入 token 0.30 美元、输入 3 美元、输出 15 美元。
在这样的价格下,只有当它的上下文和能力特征确实值得溢价时,才应该选择 Kimi K3。若你的问题是“怎么降低 Token 账单”,它并不是答案。
按工作负载选择,不要只看排行榜
| 工作负载或限制 | 优先测试的模型 | 原因 |
|---|---|---|
| 批量文本分类或信息抽取 | Qwen3.8-Flash | 相比 DeepSeek V4 Flash 的非高峰价格,新鲜输入和输出价格都更低 |
| 包含大量重复前缀的长文本 | DeepSeek V4 Flash | 支持缓存命中计费和可选非思考模式 |
| 主要由新鲜输入组成的长文本 | Qwen3.8-Flash | 新鲜 Token 标价更低 |
| API 工作流中的截图、图表或视频 | Qwen3.8-Flash | 原生支持图片和视频输入,并兼容常见 API 协议 |
| 留在 Z.ai 生态,但需要更强的文本推理 | GLM-5.3 | 保留原服务商,同时升级到更高的家族层级 |
| 失败代价高昂的编程任务 | GPT-5.6 Terra | 具备更强引用编程成绩的高价升级路线 |
| 严谨代码审查或代码库规划 | Claude Opus 4.8 | 高端推理能力,并提供缓存和批处理选项 |
| 上下文比价格更重要的长周期任务 | Kimi K3 | 定位于 1M 上下文能力 |
| 普通笔记本或 32GB 工作站 | 优先使用托管 API | GLM-5.3-Flash 是约 320B 总参数的检查点,不是 18B 本地模型 |
本地部署是一个不容忽视的限制。官方 GLM-5.3-Flash 检查点被描述为总参数约 320B;AIReiter 的部署评测记录显示,其 FP8 占用约为 306 GiB,使用默认 vLLM 部署时大约需要 386GB 显存。量化可以降低门槛,但它依然不是普通笔记本可以随手下载运行的模型。
更稳妥的 Agent 迁移方式
把服务商适配层与任务路由分开,然后针对真正重要的工作负载评估替代模型。
- 统一请求接口。在服务商支持的情况下,保留 OpenAI 兼容的消息、工具和结构化输出层。至于推理控制、视觉载荷、工具调用、结构化输出和上下文限制,则应视为能力标记,而不是所有模型都通用的字段。
- 测试最终完成的任务,而不只是生成的文本。记录代码是否能构建、工具调用是否有效、视觉检查是否通过,以及任务是否无需重试即可完成。一次便宜的初始响应,如果随后需要两次以代码库规模进行的重试,最终未必更便宜。
- 根据失败模式路由。将重复上下文文本发送给 DeepSeek V4 Flash,多模态请求发送给 Qwen3.8-Flash,再根据实际验收结果,把高风险编程任务交给 GPT-5.6 Terra、Claude Opus 4.8 或 GLM-5.3。
- 保留备用路线。AIReiter 评测记录了一次为期七天的社区测试:49 次尝试中有 30 次成功构建,14 次超时失败。这不能代表所有服务商在所有场景下的失败率,但已经足以说明,生产环境中的 Agent 不应只依赖单一路由。
- 按正常价格做预算。Z.ai 的 Flash 促销将于 2026 年 9 月 9 日结束。DeepSeek 的价格会随高峰时段变化。Qwen 的缓存创建和缓存读取也采用不同价格。只有在临时优惠价下成立的迁移方案,不能算稳定的成本模型。
一个实用的第一轮测试,可以准备 10 个日常或文本密集型请求,再准备 10 个编程、工具调用或视觉任务。比较任务最终成功率、总完成时间、重试次数和 Token 总支出。对许多团队来说,这意味着先测试用于重复上下文文本的 DeepSeek V4 Flash,以及用于多模态工作的 Qwen3.8-Flash,同时保留 GLM-5.3-Flash 作为备用,直到新路线证明自己足够可靠。
常见问题
Ox Alpha 最好的免费替代方案是什么?
在本文核查的官方资料中,还没有确认存在一个长期、与服务商无关的免费替代方案。服务商可能会提供不断变化的配额或促销活动,但生产环境决策应以公开付费价格为依据,把免费额度当作额外福利。
哪些替代方案支持图片和视频?
Qwen3.8-Flash 官方列出了图片、文本和视频输入能力。DeepSeek 的标准 V4 Flash 路线与 deepseek-v4-flash-vision-exp 路线不同,因此在迁移视觉 Agent 前,应先测试确切的端点。
哪些替代方案可以本地运行?
开放权重路线包括 GLM-5.3-Flash 检查点和 Qwen3.8-Flash-Next。GLM-5.3-Flash 的总参数约为 320B,而 Qwen 的开放权重 Flash-Next 文档说明其原生上下文为 262K,借助 YaRN 可扩展到 1M。不要默认它们中的任何一个都能装进 32GB 机器。
更换服务商后,如何避免出现意外?
在两条路线之间运行 20 个有代表性的任务,比较最终成功率、总完成时间、重试次数和 Token 总支出。在替代方案通过你自己的工具和代码库验证可靠性之前,保留现有的 GLM-5.3-Flash 路线作为备用。