 AIREITER
真正决定默认模型的,是你的工作负载。对于大多数边界清晰、输出量较大的任务,Claude Opus 5 是更稳妥的起点;而 Claude Fable 5.1 更适合拿来测试长时间运行的代理,以及需要反复复用超大上下文的特殊场景。Fable 5.1 的主要省钱点来自缓存读取,而不是更低的输入或输出价格。
比较 Fable 5.1 和 Opus 5,先看你的工作负载
对大多数团队来说,可以先从 Opus 5 开始;当任务需要更多推理时,提高它的 effort 设置;只有经过验证的高难度任务,才交给 Fable 5.1。Anthropic 的 Fable 5.1 文档也给出了大致相同的建议:大多数工作负载优先使用 Opus 5,只有在提高 Opus 5 的 effort 后仍无法满足要求时,再转向 Fable 5.1。
| 如果你的主要限制是…… | 可以先从……开始 | 原因 |
|---|---|---|
| 短请求或边界清晰的请求 | Opus 5 | 它的输入和输出价格只有 Fable 5.1 的一半。 |
| 输出量较大的生产流量 | Opus 5 | Fable 更低的缓存读取价格,并不会降低生成 token 的价格。 |
| 规格明确的多文件编码任务 | Opus 5 | 更低的成本更容易承担反复重试和提高 effort 带来的开销。 |
| 长时间运行、频繁调用工具的代理 | Fable 5.1——先做评测 | 在 Anthropic 发布的代理和工具使用对比中,Fable 处于领先位置。 |
| 需要在多轮对话中反复复用的大型上下文 | Fable 5.1——先做成本测算 | 它的缓存读取价格是 Opus 5 的一半。 |
| 对故障回退敏感的生产路由器 | 优先 Opus 5 | Fable 5.1 改变了思考块和对话历史的处理方式。 |
这场比较的核心是:在合适的 effort 和成本下使用 Opus 5,还是在合适的上下文形态与可靠性门槛下使用 Fable 5.1。
Fable 5.1 和 Opus 5 到底有什么不同?
Claude Fable 5.1 是 Anthropic 面向高难度推理和长周期代理任务的高阶模型;Claude Opus 5 则定位为价格更低、用于严肃编码、代理和专业工作的模型。两者都支持 100 万 token 的上下文窗口和 128,000 token 的最大输出,因此 Fable 的优势在于长周期执行,而不是更大的公开上下文上限。
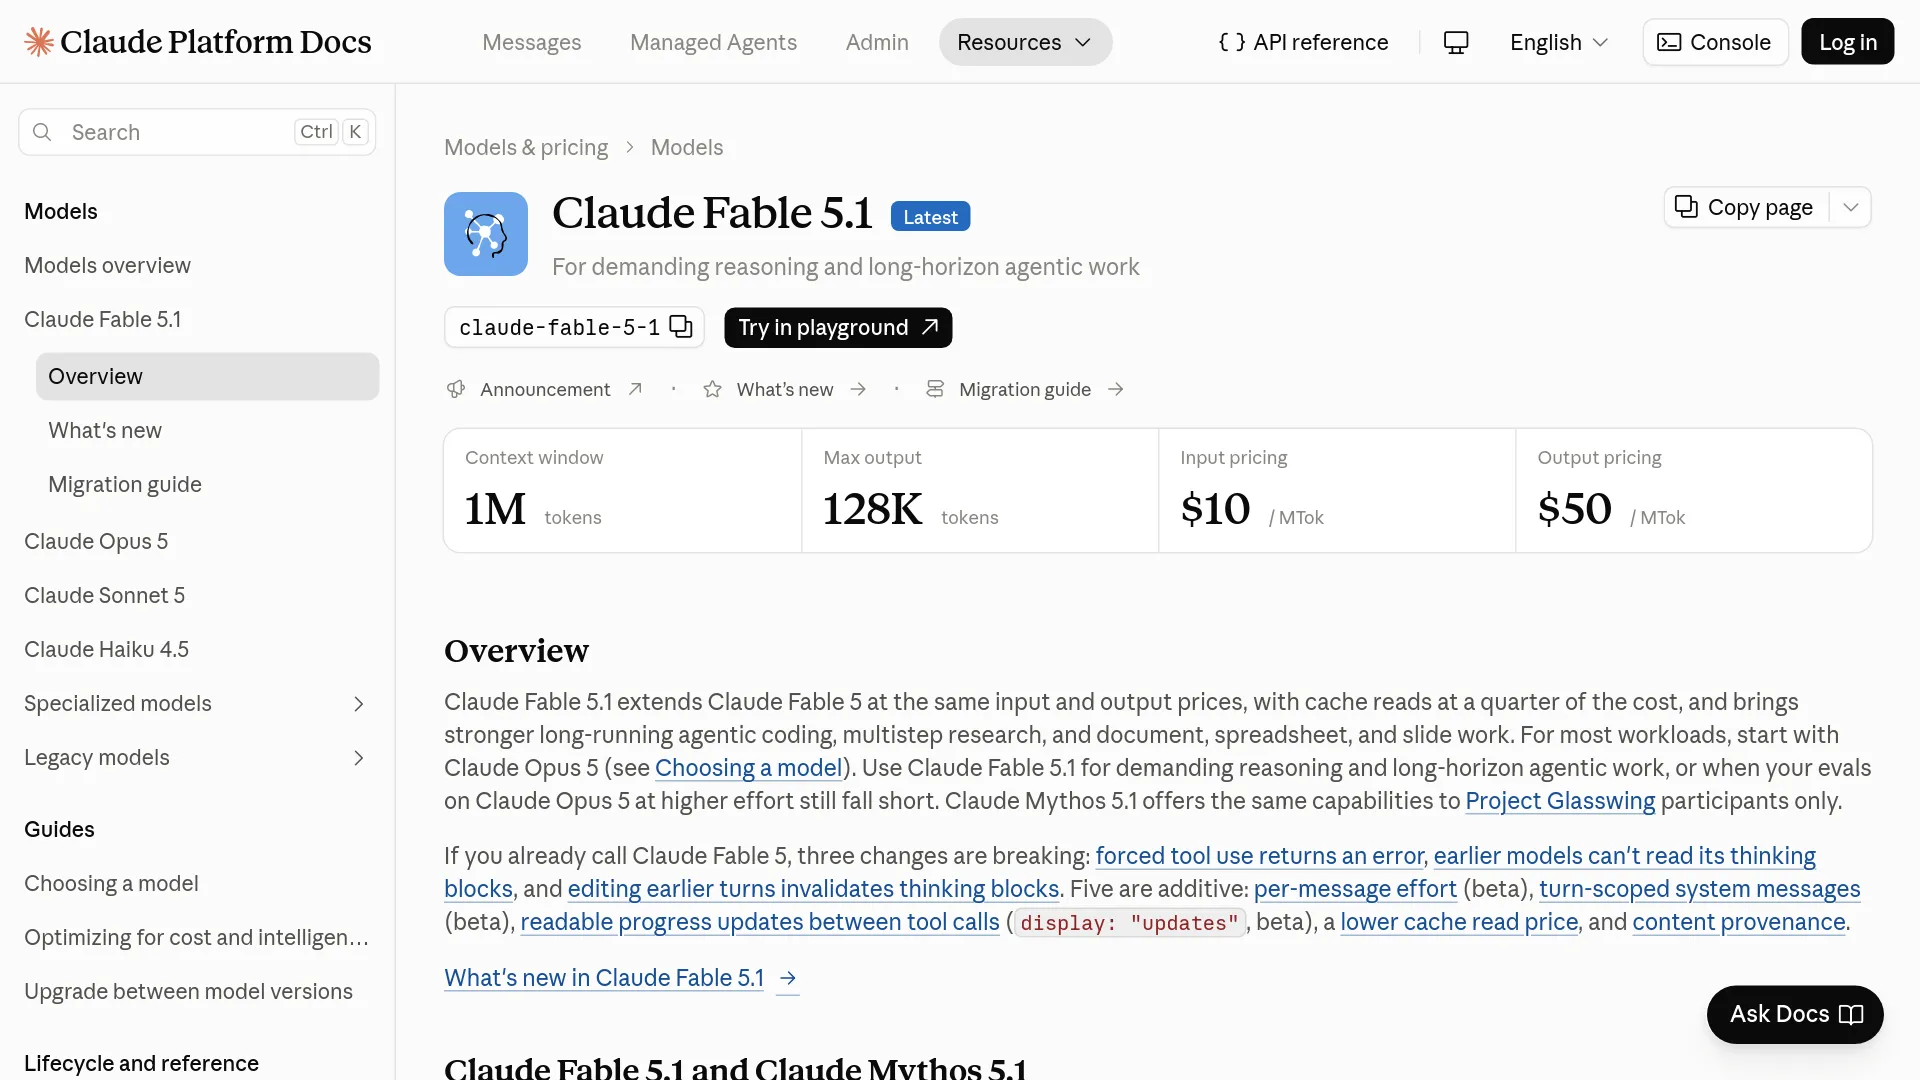
| 规格 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| API 模型 ID | claude-fable-5-1 | claude-opus-5 |
| 上下文窗口 | 100 万 token | 100 万 token |
| 最大输出 | 128,000 token | 128,000 token |
| 输入模态 | 文本和图像 | 文本和图像 |
| 输出模态 | 文本 | 文本 |
| 思考 | 自适应,始终开启 | 可控制 effort 的推理 |
| Effort 控制 | low、medium、high、xhigh、max | 可配置的 effort 等级 |
| Anthropic 的定位 | 高难度推理和长周期代理 | 大多数工作负载和严肃编码 |
| 发布状态 | 当前/最新;发布于 2026 年 9 月 1 日 | 当前 Opus 模型;发布于 2026 年 7 月 24 日 |
如需确认具体部署所使用的模型 ID 和可用性,请查看 Fable 5.1 模型页面和 Claude Opus 5 产品页面。
Fable 5.1 的基准成绩很强,但并非全面领先
Anthropic 发布的基准测试表显示,在两款模型都有数据的每一项测试中,Fable 5.1 都领先于 Opus 5。不过,这张表由厂商自行测试,因此它更适合作为发布阶段评测的参考证据,而不能视为生产环境中的保证。
| Anthropic 评测 | Fable 5.1 | Opus 5 | Fable 5.1 领先幅度 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 23.6 个百分点 |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 3.5 个百分点 |
| GDPval-AA v2 | 1,853 Elo | 1,824 Elo | 29 Elo |
| OSWorld 2.0,严格模式 | 41.7% | 39.6% | 2.1 个百分点 |
| Humanity’s Last Exam,使用工具 | 65.0% | 63.6% | 1.4 个百分点 |
| AutomationBench | 31.4% | 26.9% | 4.5 个百分点 |
| CursorBench 3.2.0 | 73.4% | 70.0% | 3.4 个百分点 |
Anthropic 表示,测试启用了生产环境安全防护;某些干预可能导致得分为零,或将任务路由到备用模型。Anthropic 还报告称,在 Terminal-Bench-Science 0.1 中,每个模型的标准误差约为 3.5–4.5 个百分点。因此,23.6 个百分点的差距,比 Humanity’s Last Exam 上 1.4 个百分点的差距更有参考价值。
第三方 CodeRabbit 评测选取了 45 个任务,其中包含 105 个已知问题点。结果显示,Fable 5.1 的召回率为 61.0%、精确率为 37.3%;Opus 5 的召回率为 55.2%、精确率为 39.3%。两者都生成了 166 条处理后的评论,但作者也提醒,测试设置并不完全相同。
“Fable 5.1 是一名专业的代码审查者。”——CodeRabbit 对其评测结果的描述(CodeRabbit)
API 定价才是实际比较的关键
对于未缓存的输入和输出,Fable 5.1 的价格是 Opus 5 的两倍;但它的缓存读取价格只有后者的一半。这会为长时间、重复性较高的代理会话创造一个成本分界点,但并不意味着每次 Fable 5.1 请求都更便宜。
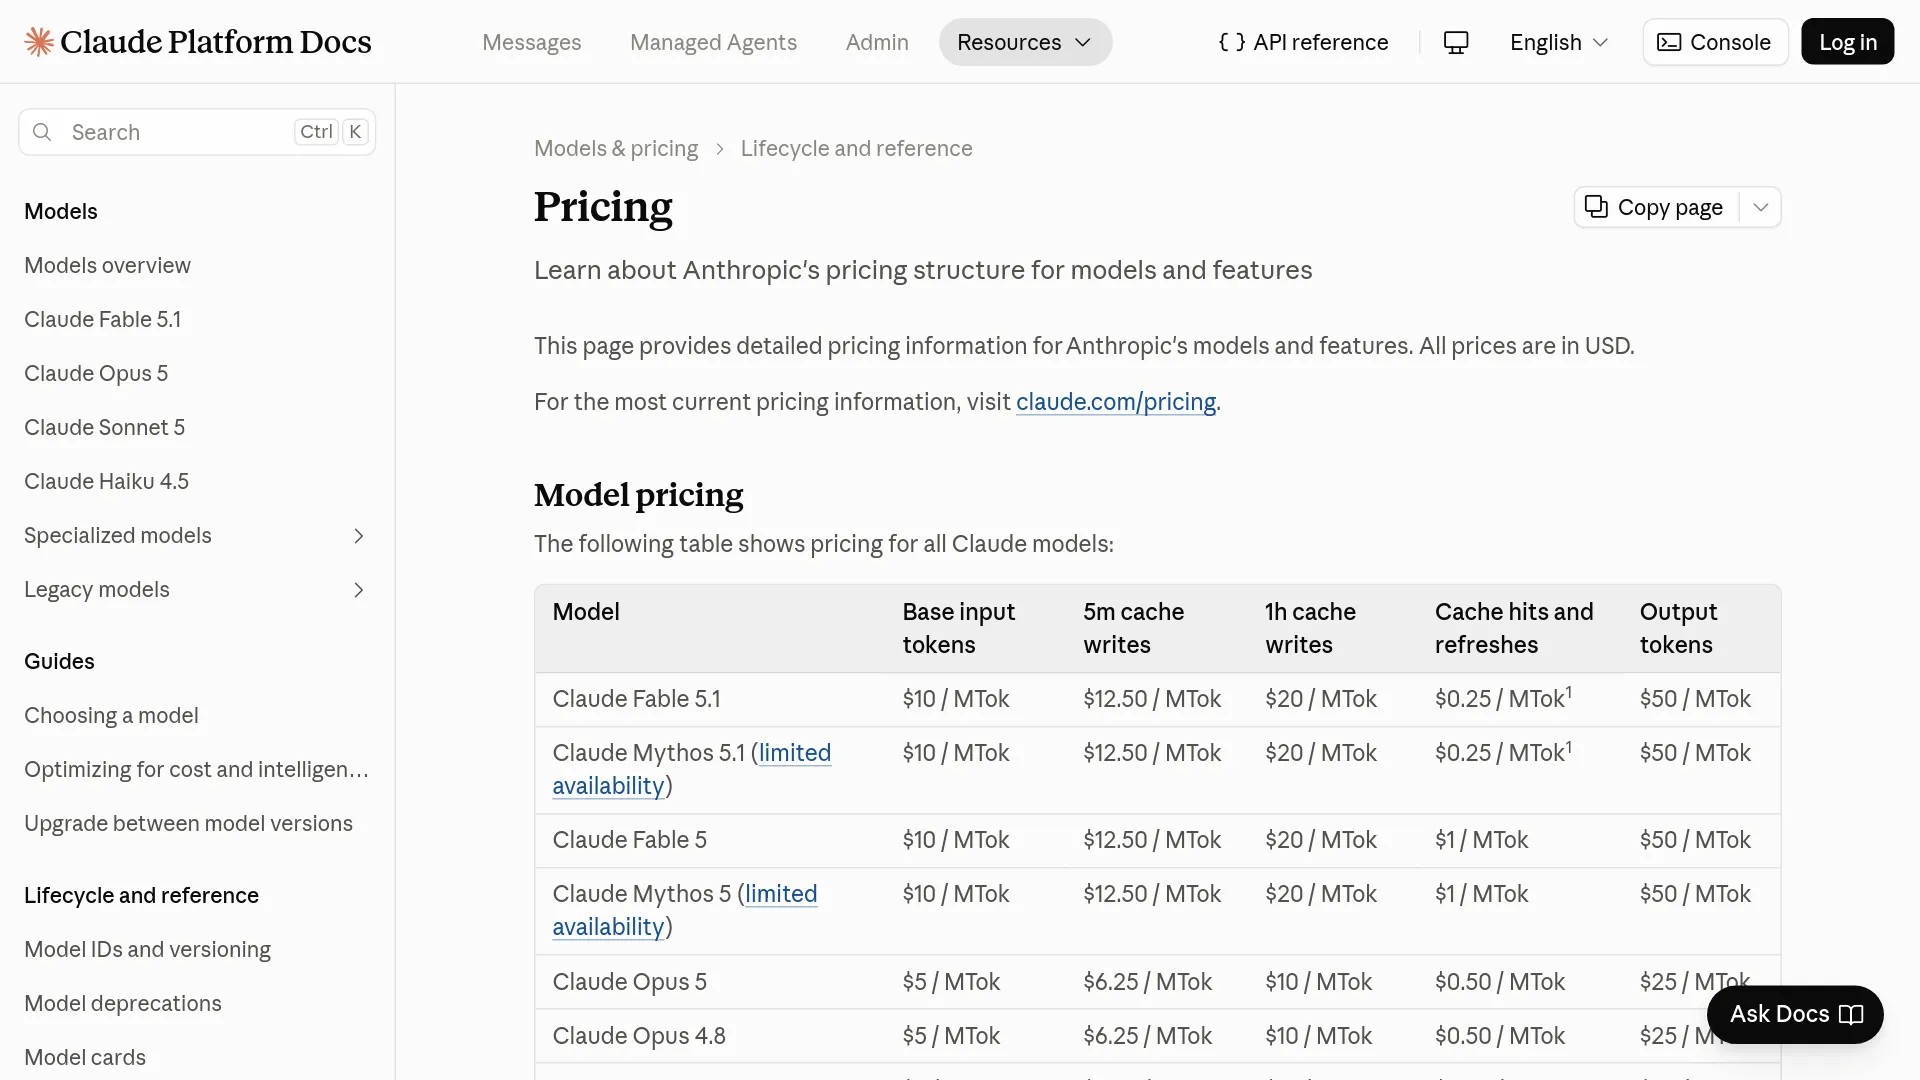
以下价格来自 Anthropic 当前的 API 定价文档,单位为每百万 token 的美元价格。
| 计费项目 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| 基础输入 | $10.00 | $5.00 |
| 5 分钟缓存写入 | $12.50 | $6.25 |
| 1 小时缓存写入 | $20.00 | $10.00 |
| 缓存读取 | $0.25 | $0.50 |
| 输出 | $50.00 | $25.00 |
| 批处理输入 / 输出 | $5.00 / $25.00 | $2.50 / $12.50 |
Fable 5.1 的输入和输出价格与 Fable 5 相比没有变化。真正带来宣传中成本节省的,是缓存读取价格:每百万 token 为 $0.25,低于 Fable 5 的 $1.00。Anthropic 估计,典型工作负载的成本大约可降低 25%,高度代理化工作负载的成本最高可降低约 45%;但这些只是针对特定工作负载的估算,并非普遍适用的折扣。
按轮次计算一次,差异会更直观。设 C 为缓存上下文,I 为新输入,O 为输出,三者的单位均为百万 token。忽略缓存写入费用,Fable 5.1 的成本为 10I + 0.25C + 50O;Opus 5 的成本为 5I + 0.50C + 25O。
只有满足以下条件时,Fable 更低的缓存读取价格才能抵消更高的新输入和输出价格:
0.25C > 5I + 25O
以 2,000 token 的新提示词和 1,000 token 的响应为例,I = 0.002,O = 0.001。在仅计算读取费用的情况下,缓存上下文必须超过约 140,000 token,Fable 才会在算术成本上占优。如果把缓存写入费用也算进去,成本分界点还会进一步推后。
这也是为什么不该仅仅出于价格原因,把短文本提取、分类、改写和一次性编码请求升级到 Fable 5.1。这类请求几乎没有可复用的前缀,而每个生成 token 的计费价格又是 Opus 5 的两倍。
两款模型分别适合哪些真实工作流
实际上的分界,在于边界清晰的执行与长周期持续运行。当任务规格明确或输出量较大时,Opus 5 更容易证明其合理性;当代理需要维护计划、反复使用工具、从失败中恢复,并在多轮对话中携带大段上下文时,Fable 5.1 才更值得关注。
编程代理:看最终完成了多少工作,而不是只看基准排名
对于普通代码仓库任务,Opus 5 更适合先行测试:范围明确的 bug 修复、重构、代码审查,以及那些可以通过更低成本来增加重试次数或提高 effort 的任务。对于多文件修改、迁移、系统级调试,以及异步进行的编码会话,Fable 5.1 值得试点,因为在这些场景中,后期失败的代价可能高于更慢的响应。
社区反馈指向了两种不同的运行风险。在一场规模较大的 r/ClaudeCode 讨论中,用户 u/CyCoCyCo 写道:
“我唯一成功的方法,就是让它生成目标提示词,然后从头到尾跑完。”——Reddit 用户 u/CyCoCyCo
这反映的是提示词和工作流方面的抱怨,并不能证明 Opus 5 在所有代码库中都会失败。同一讨论中的其他用户提到,在更长、上下文更重的任务中遇到过问题,包括指令逐渐偏移,以及修复一个问题后引入新的缺陷。
Fable 5.1 面临的抱怨则有所不同:在一场发布讨论中,有用户称它消耗 token 或配额的速度异常快。这一说法属于轶闻,并不能说明所有订阅都存在统一的限制,但足以提醒团队在试点期间跟踪用量,而不是只根据输出质量评价模型。
一次合理的编程代理试点,应该记录:
- 无需人工干预即可完成的任务数量。
- 模型报告成功后重新打开的 bug,或随后出现的回归问题。
- 输入、缓存输入和输出 token 总量。
- 实际耗时和工具调用次数。
- 人工修正时间,以及后期运行失败所产生的成本。
研究和文档密集型工作:Fable 的适用理由更充分
如果任务涉及非常大的文档集合、反复调用工具、可视化图表、多步骤研究,或需要经过多轮修改才能交付的成果,Fable 5.1 是更值得优先考虑的候选模型。Anthropic 特别将它定位于文档、电子表格、幻灯片、图表、表格和长时间运行的研究任务。
Opus 5 同样支持 100 万 token 的上下文容量,Anthropic 也称其能够处理复杂文档和高级代理。如果任务只是一次性分析,但需要生成大量内容,那么 Opus 更低的价格可能比 Fable 的缓存优势更重要。在把 Fable 的基准领先视为生产要求之前,先用有代表性的样本进行测试。
计算机操作和业务自动化:要测试完整执行轨迹
在 Anthropic 的 OSWorld 和 AutomationBench 测试中,Fable 5.1 领先于 Opus 5,但这类任务衡量的是一连串操作,而不是单个答案。对于浏览器代理或业务流程代理,需要评估它是否能到达正确的最终状态、需要恢复的频率,以及某次操作失败是否会导致后续流程全部失效。
真正应该关注的单位是每个已完成结果的成本,而不只是每百万 token 的价格。一个能减少长流程重复重试的模型,即使单价更高,也可能更经济;如果模型还没到达最终状态就耗尽了使用预算,那就谈不上划算。
切换模型前,团队必须检查这些集成细节
Fable 5.1 的迁移文档说明了强制工具调用、思考块和对话历史校验方面的变化。如果团队使用自有消息路由器,在更换默认模型前必须先测试这些行为。
| 变化 | 可能出现的情况 | 迁移动作 |
|---|---|---|
| 强制工具调用 | tool_choice: {"type":"any"}或指定工具的选择可能返回 HTTP 400。 | 配合清晰的工具指令使用auto,或在合适的场景使用结构化输出。 |
| 思考块的可移植性 | 较早的模型无法读取 Fable 5.1 的思考块;回退轮次可能会丢弃这些内容。 | 审查模型切换和回退路径。 |
| 对话编辑 | 修改早期消息、系统提示词或工具列表,可能使后续思考块失效。 | 将历史记录视为只追加,或使用受支持的轮次级控制。 |
| 思考配置 | Fable 5.1 使用自适应思考,无法像 Opus 5 那样以相同方式关闭思考。 | 通过 effort 设置控制开销,并重新测试 token 用量。 |
在混合模型路由器中,回退机制尤其值得注意。Fable 5.1 请求可能会携带原有推理上下文继续执行,但回退到 Opus 5 时,后者无法读取 Fable 5.1 的思考块。如果路由器悄悄丢弃这些内容,回退模型就可能重新规划,从而增加延迟和 token 消耗。成功路径和失败路径都要使用接近生产环境的历史记录进行测试。
小规模评测,胜过宏大的模型宣传
对两款模型使用相同的提示词、工具、上下文、effort 策略和验收测试;否则,所谓模型对比很可能最后变成测试框架对比。
- 边界清晰的任务线:运行范围明确的 bug 修复、信息提取、结构化写作和代码审查。记录有效输出、修正时间和成本。
- 长周期任务线:运行多文件功能开发、迁移、研究任务或浏览器工作流。记录最终状态是否成功、恢复情况、回归问题和实际耗时。
- 缓存密集型任务线:重复使用稳定的系统提示词、工具集,以及代码仓库或文档前缀。记录缓存命中率和总账单,同时计入缓存写入和输出费用。
先将 Opus 5 设置为你实际会部署的 effort 等级,然后在切换到 Fable 5.1 之前测试更高的 Opus effort。对于 Fable,至少测试 medium 和 high;不要假设不同模型之间同名的 effort 等级含义完全一致。Anthropic 表示,effort 设置控制的是深度与成本之间的取舍;第三方测试则发现,更高的推理强度并不会自动改善总体代码审查结果。
Fable 5.1 vs Opus 5 常见问题
哪款模型更适合编码?
在 Anthropic 发布的 Terminal-Bench 和 CursorBench 结果中,Fable 5.1 领先于 Opus 5;但对于大多数范围明确、对成本敏感的编码任务,Opus 5 更适合作为起点。是否值得使用 Fable,要通过有代表性的代码仓库评测来判断,看它更高的完成质量能否抵消价格和延迟。
Fable 5.1 值得支付两倍的 API 价格吗?
不能默认这样认为。它的输入和输出价格是 Opus 5 的两倍,而缓存读取价格只有一半;只有当工作负载会反复复用大型上下文,同时生成内容相对较少时,Fable 才可能在经济性上更有吸引力。
Fable 5.1 的上下文窗口更大吗?
不是。Anthropic 为两款模型都列出了 100 万 token 的上下文窗口和 128,000 token 的最大输出。Fable 的区别在于它面向更长周期的推理和代理轨迹,而不是拥有更大的公开窗口。
切换前,应该先提高 Opus 5 的 effort 吗?
应该。Anthropic 的模型指南建议,在转向 Fable 5.1 之前,先评估提高 effort 后的 Opus 5。与其所有请求都直接使用最高 effort,不如比较额外 token 成本和质量提升之间的关系。
从 Fable 5.1 安全回退到 Opus 5 吗?
可以构建这样的回退机制,但不要假设对话状态能够直接迁移。较早的模型无法读取 Fable 5.1 的思考块,而 Fable 5.1 的历史校验也可能暴露出会修改既有轮次的路由器问题;应使用真实的工具 schema 和消息历史测试回退流程。
开发者可以在哪里使用 Fable 5.1 和 Opus 5?
Anthropic 列出了这两款模型,支持通过 Claude 订阅方案使用,也支持通过其平台和云市场集成向开发者提供服务。不同提供商的具体模型 ID 和可用性可能不同,因此请在Fable 5.1 文档或 Opus 5 产品页面中确认具体部署所使用的标识符。
实际选择应该是一条路由规则,而不是永久升级
| 决策场景 | 使用 Opus 5 | 使用 Fable 5.1 |
|---|---|---|
| 混合流量的默认模型 | 是 | 仅在评测后使用 |
| 短促的一次性请求 | 是 | 没有价格优势 |
| 输出量较大的生成任务 | 是 | 通常不是 |
| 大型缓存前缀 | 仔细比较 | 可能具备成本优势 |
| 长时间运行的自主编码 | 先做试点 | 很有潜力 |
| 严格限定范围的重构 | 通常使用 | 仅当 Opus 无法通过验收测试时 |
| 浏览器或多步骤自动化 | 先做试点 | 基准测试表现突出 |
| 自定义回退路由器 | 更简单的基线方案 | 需要进行迁移测试 |
将 Opus 5 保留为基线,在同一组边界清晰和长周期任务上同时测试两款模型;只有当 Fable 5.1 能够提升每美元完成的工作量时,才将任务路由给它。
如需了解具体模型的成本细节,请查看 Claude Fable 5.1 API 定价;如需更全面的模型参考,请查看 Claude Opus 5。