 AIREITER
“Sonnet 5 接近 Opus 4.8,但更便宜”是 Anthropic 自己的宣传语。我们想知道这种说法从哪里开始不再成立,于是通过 Claude Code CLI 将四个完全相同的任务分别在这两个模型上运行,并记录了每次 API 响应中的实际成本、耗时和工具调用次数。最关键的一点是:将 Sonnet 5 的 xhigh 努力级别提升到与 Opus 4.8 默认行为一致,而我们测得的价格差距几乎消失了——与此同时,Opus 4.8 完成任务所用时间大约只有一半。
Sonnet 5 与 Opus 4.8 一览
Claude Sonnet 5 | Claude Opus 4.8 | |
|---|---|---|
发布日期 | 2026年6月30日 | |
上下文窗口 | 100万 tokens | 100万 tokens |
最大输出 | 128K tokens | 128K tokens |
价格(每 100万 tokens 输入/输出) | $5/$25 | |
快速模式 | 不支持 | 支持(研究预览版),在高级定价下最高可达约 2.5 倍输出速度 |
努力级别 | low / medium / high / xhigh / max | low / medium / high / xhigh / max |
定位 | 更便宜、以 agent 为重点的 Sonnet 级模型 | Anthropic 的旗舰、最高准确率选项 |
上下文窗口和最大输出是相同的——这在这里不是区别点。一个不同之处是:Sonnet 5 运行在一个新的 tokenizer 上,Anthropic 说它对相同文本会产生“约 30% 更多的 tokens”,因此从 Sonnet 4.6 沿用过来的 max_tokens 预算或成本估算不会直接适用。
官方基准比较
根据 Anthropic 自身披露的信息,并结合 llm-stats.com 的第三方分析,模式是一致的:Sonnet 5 在少数几个基准测试中获胜或打平,而 Opus 4.8 在大多数其他测试中领先,通常只领先个位数。
基准测试 | Sonnet 5 | Opus 4.8 | 差距 |
|---|---|---|---|
Terminal-Bench 2.1 | 80.4% | 74.6% | Sonnet 5 +5.8 |
Humanity's Last Exam(使用工具) | 57.4% | 57.9% | 几乎持平 |
Humanity's Last Exam(不使用工具) | 43.2% | 49.8% | Opus +6.6 |
SWE-bench Verified | 85.2% | 88.6% | Opus +3.4 |
SWE-bench Pro | 63.2% | 69.2% | Opus +6.0 |
Toolathlon | 54.3% | 59.9% | Opus +5.6 |
OSWorld-Verified(电脑使用) | 81.2% | 83.4% | Opus +2.2 |
CursorBench | 61.2% | 63.8% | Opus +2.6 |
USAMO 2026 problems | 79.5% | 96.7% | Opus +17.2 |
有两点很突出。Opus 4.8 的最大领先体现在高难数学(USAMO)上,而不是编码——编码方面的差距(SWE-bench、Terminal-Bench)都只有个位数,甚至 Sonnet 5 还直接拿下了其中一项。在工具增强的通用推理(带工具的 HLE)上,两者足够接近,可以算是平手。
还有一个值得注意的安全数字,尽管它不是能力基准:根据同样的披露,在没有额外防护措施的浏览器使用场景中,Sonnet 5 的实测提示注入攻击成功率为 0.93%,而 Opus 4.8 为 31.5%。Anthropic 尚未就这一具体差距发布详细解释。如果你正在构建任何会在无人监督下浏览开放网络的 agentic 应用,最好测试你自己的防护措施,而不是假定旗舰模型就一定自动是更安全的默认选择。
我们亲自进行了四项一对一测试
目前市面上的大多数内容,要么是汇总了上面的官方基准表,要么只是分享主观的单模型印象。我们没有找到受控的、使用相同提示的成本和延迟比较,因此我们自己做了一次。
方法: 四个任务,运行于 2026-07-01,每次通过 Claude Code CLI 向 claude-sonnet-5 和 claude-opus-4-8 发送相同提示(claude -p --model <id> --effort <level> --output-format json)。成本、时长和轮次计数均直接读取自每次运行的 API 响应,而不是根据 token 数量估算。每种模型/effort 配置在每个任务上运行一次——这些是真实的单次运行结果,而不是统计平均样本。请将各项差距的大小视为方向性而非精确值;在我们进行的每一次测试中,方向都是一致的。
测试 1:成本反转检查
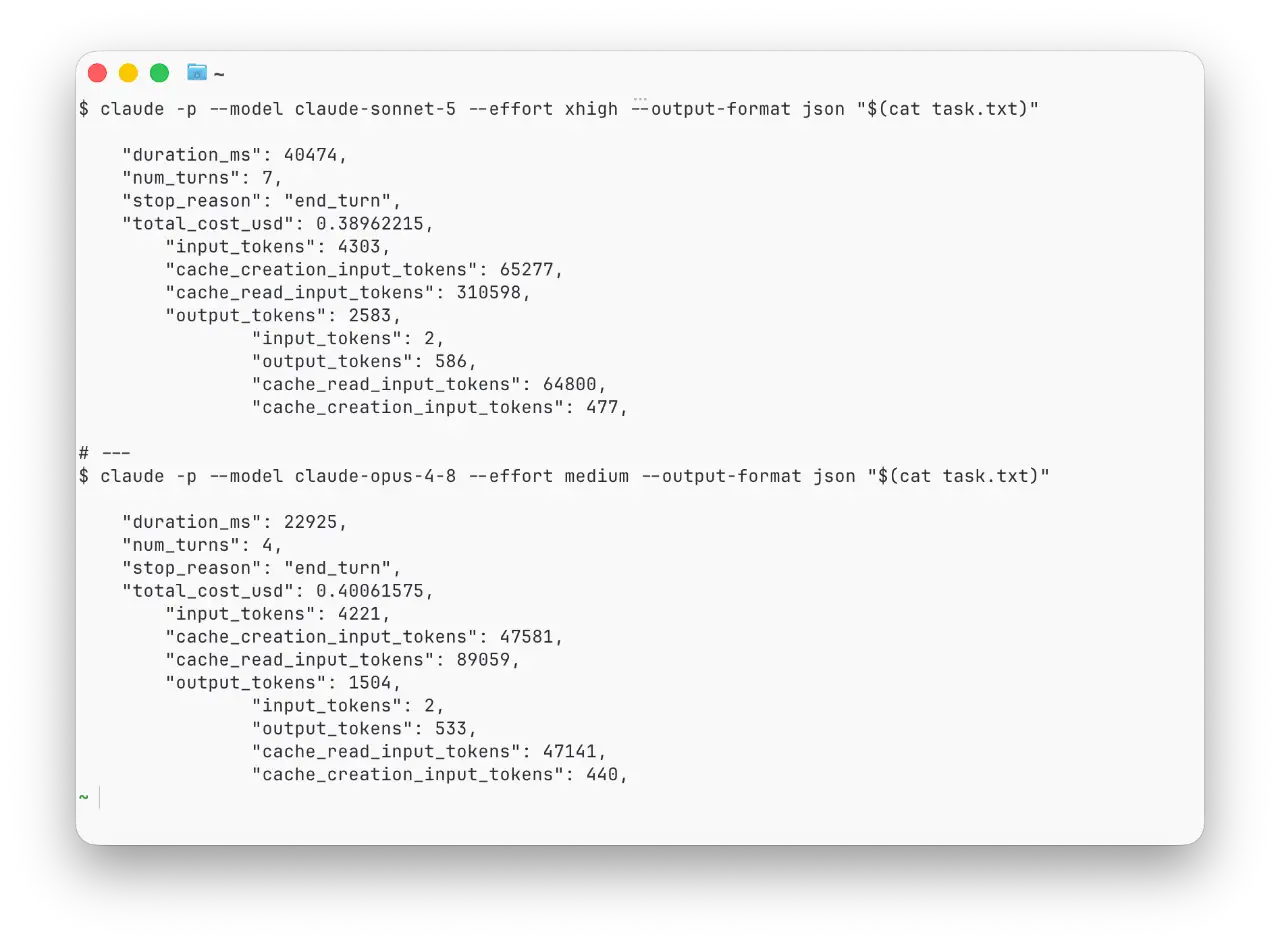
我们最想回答的问题是:当你提高 Sonnet 5 的 effort level 以应对更难的任务时,它是否仍然更便宜?我们在 Sonnet 5 xhigh 与 Opus 4.8 medium 的条件下,运行了与 Test 2(如下)相同的编码任务。
设置 | 成本 | 时长 | 轮次 | 结果 |
|---|---|---|---|---|
Sonnet 5, effort | $0.390 | 40.5s | 7 | 8/8 tests pass |
Opus 4.8, effort | $0.401 | 22.9s | 4 | 7/7 tests pass |
3% 的成本差异——基本上可以忽略不计——而 Opus 4.8 在其 较低 努力设置下,仅用不到一半的轮次,就在 57% 的时间内完成。两者都生成了正确、可工作的代码。这与人们已经在 Hacker News上指出的情况一致:那里有一位评论者估计,Opus 4.8 在中等推理下的成本约为 $0.45,而 Sonnet 5 在 xhigh/max 下约为 $0.52,二者可完成相当的工作。
测试 2:匹配努力下的编码任务
相同提示,两种模型都使用 high 努力:编写一个高效的最长回文子串函数,生成覆盖边界情况的测试用例,运行它们,并修复任何失败之处。
设置 | 成本 | 时长 | 轮次 | 结果 |
|---|---|---|---|---|
Sonnet 5 (high) | $0.378 | 37.4s | 7 | 8/8 通过 |
Opus 4.8 (high) | $0.439 | 28.9s | 5 | 8/8 通过 |
两者都采用了相同的以中心向外扩展的方法,并且在第一次运行时就通过了所有测试。Opus 4.8 更快地达成目标,而且所需轮次更少,但花费大约多了 16%。当质量完全相同时,这一项仅凭速度就归 Opus 所有。
测试 3:写作 / 知识工作
一个没有唯一正确答案的商业判断提示:为一家 12 人的 SaaS 公司提供建议,判断是否应在其 A 轮融资完成前六周,花 3-4 周时间迁移到第二个 AWS 区域以进行灾难恢复。
设置 | 成本 | 时长 | 轮次 |
|---|---|---|---|
Sonnet 5 (high) | $0.072 | 14.7s | 1 |
Opus 4.8 (high) | $0.084 | 22.7s | 1 |
两者给出的建议本质上相同——跳过完整迁移,改为交付一个轻量级的备份/运行手册——且推理质量相当。Sonnet 5 用时约为前者的三分之二,成本也低了 14%。这是唯一一个清楚表明“Sonnet 5 在知识型工作上表现良好”的测试。
测试 4:智能检索——Sonnet 5 真的会“过度思考”吗?
一些 Reddit 讨论串将 Sonnet 5 描述为比 Opus 4.8 更容易对简单请求过度思考。我们测试了一个真正简单的任务:汇总目录树中每个 .py 文件的字节大小,并报告哪个子目录包含的这类文件最多。
设置 | 成本 | 时长 | 轮次 |
|---|---|---|---|
Sonnet 5 (high) | $0.119 | 18.5s | 3 |
Opus 4.8 (high) | $0.120 | 12.1s | 2 |
两者都得出了相同的正确答案。成本几乎可以忽略不计,但 Sonnet 5 多用了一次工具调用回合,且耗时大约长了 50%。这确实是对“过度思考”这一批评的一个真实但不算大的数据点——而且它与测试 1 一致:Sonnet 5 往往需要更多步骤才能到达同样的结果。
那么你实际上应该使用哪个?
选择 Opus 4.8 用于速度很重要的编码任务、涉及大量工具调用的 agentic 工作流,或者任何你本来会想把 Sonnet 5 的 effort 提高到
high以上来信任输出的场景——这正是 Sonnet 5 的成本优势消失的时候。选择 Sonnet 5 用于高吞吐量、预算敏感的工作,以及通用知识/写作任务,但请将其保持在
medium或higheffort。不要机械地为了“保险起见”就把它调到xhigh——这正是定价优势崩塌的地方。两者都可以 用于简单查询和单轮请求;我们测得的实际差异只是多一轮对话和几秒钟,而不是错误答案。
常见问题
Claude Sonnet 5 实际上比 Opus 4.8 更便宜吗?
在相同的努力级别下,是的——差距相当明显。但如果把 Sonnet 5 调到 xhigh 以应对更困难的任务,差距可能缩小到几个百分点,而较低努力设置下的 Opus 4.8 完成速度更快。在假设自己能省钱之前,先检查你实际运行的是哪个努力级别。有关 Haiku、Sonnet 和 Opus 的完整价格表,请参阅我们的 Claude API 定价指南。
Claude Sonnet 5 与 Sonnet 4.6 有什么区别?
这是一次代际升级,而不是模型档位的选择——而且成本的变化方向也不一样。Sonnet 5 在 Terminal-Bench 上比 Sonnet 4.6 高出两位数,但在我们自己的正面对比成本测试中,在我们尝试的每个 effort level 下,Sonnet 5 都比 Sonnet 4.6 更贵,主要原因是新的 tokenizer。完整测试和数据见 Sonnet 5 vs Sonnet 4.6: Is It Actually Cheaper?
将 Claude Sonnet 5 与 Opus 4.6 进行比较是否公平?
并不是这样——Opus 4.6 比 Opus 4.8 落后一个版本。如果你现在正在决定要用什么,请拿它和 Opus 4.8 比较,而不是和它的前代产品。
这两个的上下文窗口不同吗?
不——两者都提供 100 万 token 的上下文窗口和 128K 的最大输出。
为什么 Opus 4.8 在浏览器使用中的提示注入率高得多?
根据 Anthropic 的披露,在未增加额外防护措施的情况下为 31.5%,而 Sonnet 5 为 0.93%,具体是在无监督的浏览器使用场景中。Anthropic 尚未发布详细说明。应将其视为一个理由,去测试你自己的具体防护措施,而不是假设旗舰模型会自动成为更安全的默认选择。
附录:精确提示词与原始输出
对于任何想要复现这一点的人,这里是我们为每个测试发送的准确提示词(测试 1 和测试 2 使用了相同的编程提示词,只是努力程度不同)。
测试 1 & 2 — 编程提示:
编写一个 Python 函数 `longest_palindromic_substring(s: str) -> str`,返回
s 中最长的回文子串,使用比
暴力 O(n^3) 更高效的方法(例如中心扩展法或 Manacher 算法)。将其保存到 solution.py。

然后编写 test_solution.py,至少包含 6 个测试用例,覆盖:空字符串、
单个字符、所有字符相同、没有长度大于 1 的回文、一个
偶数长度回文,以及一个奇数长度回文。

使用 pytest 运行测试并确保它们全部通过。如果有任何失败,修复
代码并重新运行,直到全部通过。报告最终的 pytest 输出。
测试 3 — 写作/知识工作提示:
你正在为一家小型 SaaS 公司提供建议(12 名员工,$80k MRR,目前运行在
单个 AWS 区域),需要判断是否应在其 A 轮融资前扩展到第二个 AWS 区域以进行灾难
恢复;该轮融资将在 6 周后完成。工程团队估计迁移需要 3-4 周,并且在这段期间会占用
团队大部分产能,导致两项客户请求的功能延后。

撰写一份约 350 字的高管建议:他们现在应该做,推迟做,还是寻找中间路径?结合权衡
因素说明理由。不要前言,只给出
建议。
测试 4 — agentic 查找提示:
在当前目录树中,找到所有扩展名为 .py 的文件,汇总它们的
总大小(以字节为单位),并告诉我哪个单个子目录(工作目录的直接子目录)
包含最多的 .py 文件(按数量计算)。只要这两个
数字/答案,不需要写入任何新文件。
以下是 Test 1 中 Sonnet 5 (xhigh) 运行的实际 API 响应,已裁剪为与成本和时间相关的字段:
{
  "duration_ms": 40474,
  "num_turns": 7,
  "stop_reason": "end_turn",
  "total_cost_usd": 0.38962215,
  "usage": {
    "input_tokens": 4303,
    "cache_creation_input_tokens": 65277,
    "cache_read_input_tokens": 310598,
    "output_tokens": 2583
  }
}
那是 Claude Code CLI 对该次运行返回的未经编辑的 total_cost_usd、 duration_ms 和 token 计数——上方 Test 1 表中的数字直接来自这类字段,每次运行对应一个 JSON 响应。