 AIREITER
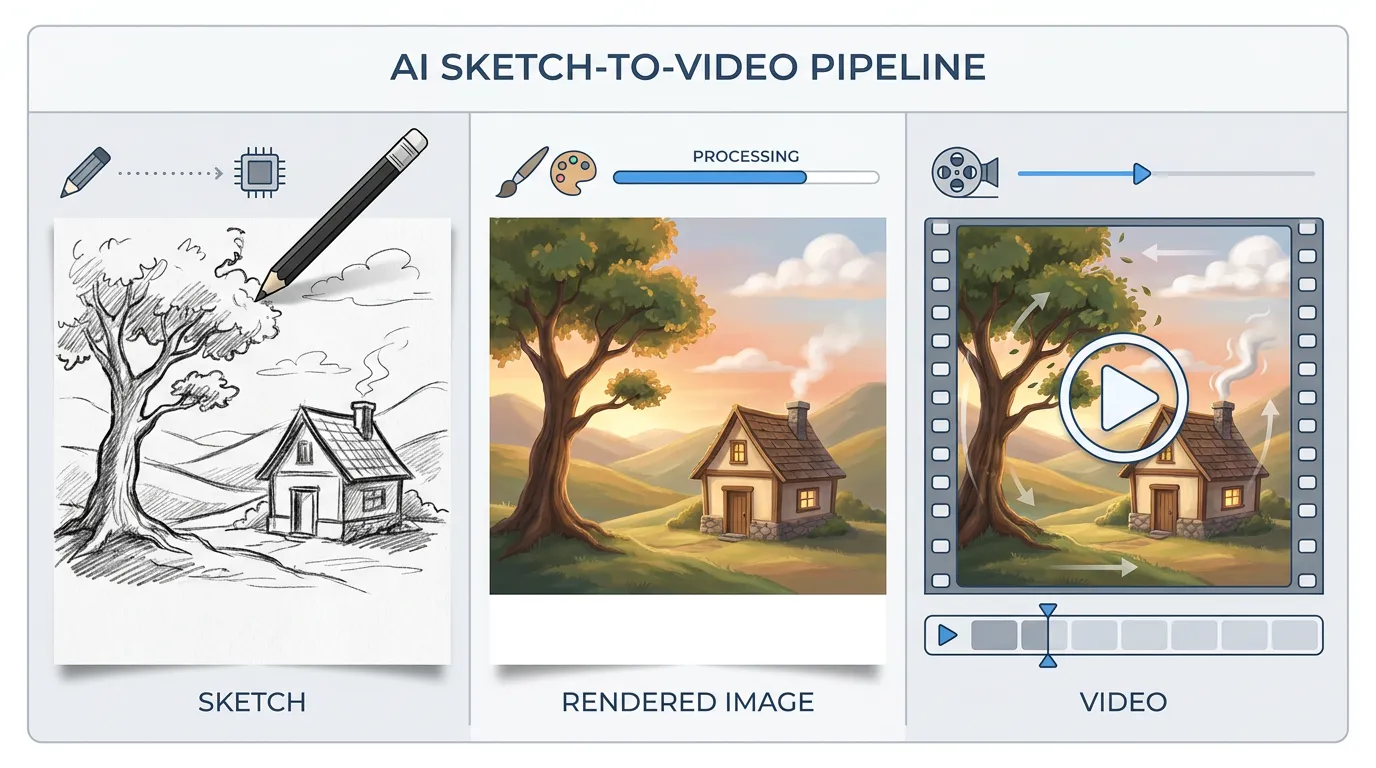
想讓草圖做成影片,真正影響成品的往往不是選了哪個一鍵工具,而是能不能掌握中間那一張圖。多數 sketch-to-video 工具其實都走兩段式流程:先把線稿生成完整靜態畫面,再將畫面做成動畫。若自己拆開處理,就能在動畫前檢查與修改渲染結果,決定成片該忠於原稿,還是接受 AI 的重新詮釋。
Sketch to Video AI 到底在做什麼?
Sketch to video AI 能將手繪草圖、線框圖或分鏡畫面轉成動畫,甚至是完整渲染的短片。草圖負責提供構圖與空間配置,AI 則補上材質、光線、色彩與動態。只要位置關係清楚,即使是很粗略的火柴人也能使用;模型主要讀取的是畫面結構,也就是物件位在鏡頭中的哪裡,而不是你的繪畫技巧有多好。
市面上並不存在單一一種「sketch-to-video 模型」。Adobe 的 Firefly 教學明確將流程分成三步:上傳草圖、由 Firefly 生成渲染靜態圖,再把這張圖製作成一段五秒影片。Higgsfield's Sketch-to-Video 則以 Sora 2 為引擎,透過五個預設按鈕(Realistic、Cinematic、Anime、Commercial、Horror)把流程包裝起來,讓使用者看不見中間步驟;但內部仍是先渲染、再動畫。自己分兩段執行時,可以先把草圖修成乾淨的靜態圖,再交給影片模型,並在中途檢視、調整與重新下提示詞。多數品質問題,正是在這個階段解決。
一鍵工具與手動管線:該怎麼選?
實際操作上,你需要在整合式工具與手動製作管線之間做選擇。
整合式工具——例如 Higgsfield Sketch-to-Video、Dreamina's sketch-to-video tool、sketchtovideoai.com 與 Seedance's storyboard-to-video page——可直接讀取你的草圖,通常不必額外輸入文字提示,然後輸出完成短片。它們速度快、使用門檻最低。Higgsfield 提供 16:9 或 9:16 的 1080p 輸出,使用 Sora 2 作為引擎,也能只根據線條推斷動作。不過代價是你無法查看或編輯中間生成的渲染圖,能調整的項目也僅限於工具提供的預設選項。
手動管線則是先自行選擇圖片模型來渲染草圖、檢查結果,再挑選獨立的影片模型製作動畫。Reddit 社群中很常看到這類工作方式:創作者先畫草圖,用 AI 生成風格化畫面與初始網格,最後再手動完成作品。
「AI 幫我加快了讓這張草圖活起來的過程。」—— u/Snoo-73452, r/2D3DAI
簡單來說:若動畫前必須確認渲染構圖,選手動管線;若速度比細部控制更重要,整合式工具會更合適。
從紙上草圖到動畫短片的實作流程
先把草圖整理好
AI 看重的是空間結構,不是畫功。以下三點最能決定草圖能否產出可預期的結果:
- 清楚區分空間層次。不同景深的物件應該在視覺上明確分開。若線條在同一位置重疊,模型容易把它們解讀為單一的平面形狀,深度感就會不自然。
- 讓主體足夠明顯。主角應透過線條粗細或密度,與背景拉開差異。若視覺焦點混在周圍環境裡,模型很難判斷該讓什麼動起來。
- 線條乾淨、對比足夠高。數位草圖通常比紙本拍照更可靠,因為視覺雜訊較少。若必須拍攝紙上草圖,請在均勻光線下平拍、裁切緊湊,並在上傳前提高對比。
步驟 1:將草圖轉為完成的渲染圖
第一個生成步驟,是將線條轉換成完整的靜態畫面。你需要搭配文字提示,說明線條代表什麼,以及畫面應該呈現什麼風格。可採用這個提示詞公式:
「[主體]、[視覺風格]、[光線]、[草圖無法表達的具體細節]」
例如,一張粗略的房間草圖可以寫成:「一間中世紀現代風格客廳,溫暖自然光,寫實攝影風格,左側有木製書桌、筆記型電腦與一杯咖啡。」
可同時接收參考圖與文字的圖片模型——包括 Nano Banana Pro、Seedream 5 Pro 與 GPT Image 2——都能依照草圖構圖補齊渲染內容。Adobe Firefly 的圖片模型也能在其整合流程中做到同樣的事。這個階段最重要的是先檢查渲染靜態圖,再開始製作動畫。如果構圖跑掉、光線不對,或模型加進了不需要的細節,應在此時透過調整提示詞修正;這比整段影片重生快得多。
步驟 2:讓渲染畫面動起來
取得乾淨的渲染圖後,將它交給 image-to-video 模型,並輸入動態提示詞。這一步要描述什麼會動、如何動:鏡頭運動,例如「從左側緩慢推進」;角色動作,例如「女子轉頭微笑」;環境動態,例如「窗簾隨微風輕擺,光束中有塵埃粒子」。
這一步表現出色的 image-to-video 模型包括 Kling 3.0、Seedance 2.5、Veo 3.1 與 Runway Gen-4。VidAU's 指南將此視為最常被忽略的技巧:很多人完全跳過文字提示,直接讓模型猜測動作。明確指定鏡頭運動、速度,以及哪些元素應靜止或移動,產出的會是有意圖的鏡頭調度,而非隨機生成的瑕疵。
步驟 3:檢查、修正並串接鏡頭
每支生成影片都應檢查以下四項:
- 動作是否自然。動態是否符合場景類型?建築漫遊鏡頭應慢而流暢;社群短片則需要在第一秒就有能量感。
- 構圖是否忠於原圖。影片有沒有偏離渲染靜態圖的取景?模型有時會意外裁切或重新構圖。
- 結構是否穩定。留意閃爍、變形的幾何結構、肢體在影格間融化變形,以及片段中途線條粗細改變。這些都是草圖來源影片常見的失敗模式,通常源自輸入草圖不夠明確。修正應從上游著手:更乾淨、空間分層更明確的草圖,會減少後段瑕疵。若變形持續出現,降低動作強度設定或縮短影片時長;更長片段中的更多動作,會給模型更多出錯空間。
- 速度是否符合用途。直式社群短片動得太慢,或電影感建立鏡頭動得太快,都表示提示詞與目標平台不匹配。
製作多鏡頭序列時,請為每個鏡頭各自生成一張渲染靜態圖,而不是嘗試一次生成一段很長的影片。Seedance 與 Higgsfield 都支援起始影格與結束影格控制,可用於串接分鏡節點之間的轉場,有助於維持剪輯間的連續性。
各工具的實際成本
價格會隨模型、解析度與片段長度而變動。以下數字來自官方定價頁與已核實指南,截至 2026 年 8 月。
| 工具 | 入門方案 | 每支 5 秒短片 | 適合用途 |
|---|---|---|---|
| Runway Gen-4 | $12/月,625 點數 | 60 點數(Gen-4)或 25 點數(Turbo) | 電影感 B-roll、建立場景鏡頭 |
| Adobe Firefly | $9.99/月,2,000 點數 | 100 點數(540p)至 500 點數(1080p) | 整合式草圖轉圖片再轉影片流程 |
| Kling AI | $6.99/月,660 點數 | 每支 5 秒短片約 10–25 點數 | 動態動作場景 |
| Higgsfield | $9/月起(依地區而定) | 依點數計費,隨模型而異 | 一鍵草圖動畫,不需要提示詞 |
| Seedance 2.5 | 透過 API 平台按片段付費 | 720p、5 秒約 $0.48 | 跨片段的參考圖優先一致性 |
定價表中有兩個數字值得留意。Runway 的API 費率為每點數 $0.01,因此一支五秒的 Gen-4 Turbo 短片成本約為 $0.25。Firefly Standard 方案可生成 20 支 540p、每支五秒的短片,但若使用 1080p,則只能生成 4 支。Kling 的免費方案每 24 小時提供 66 點數(含浮水印、不可商用);Standard 方案依畫質設定不同,約可生成 26 至 66 支短片。
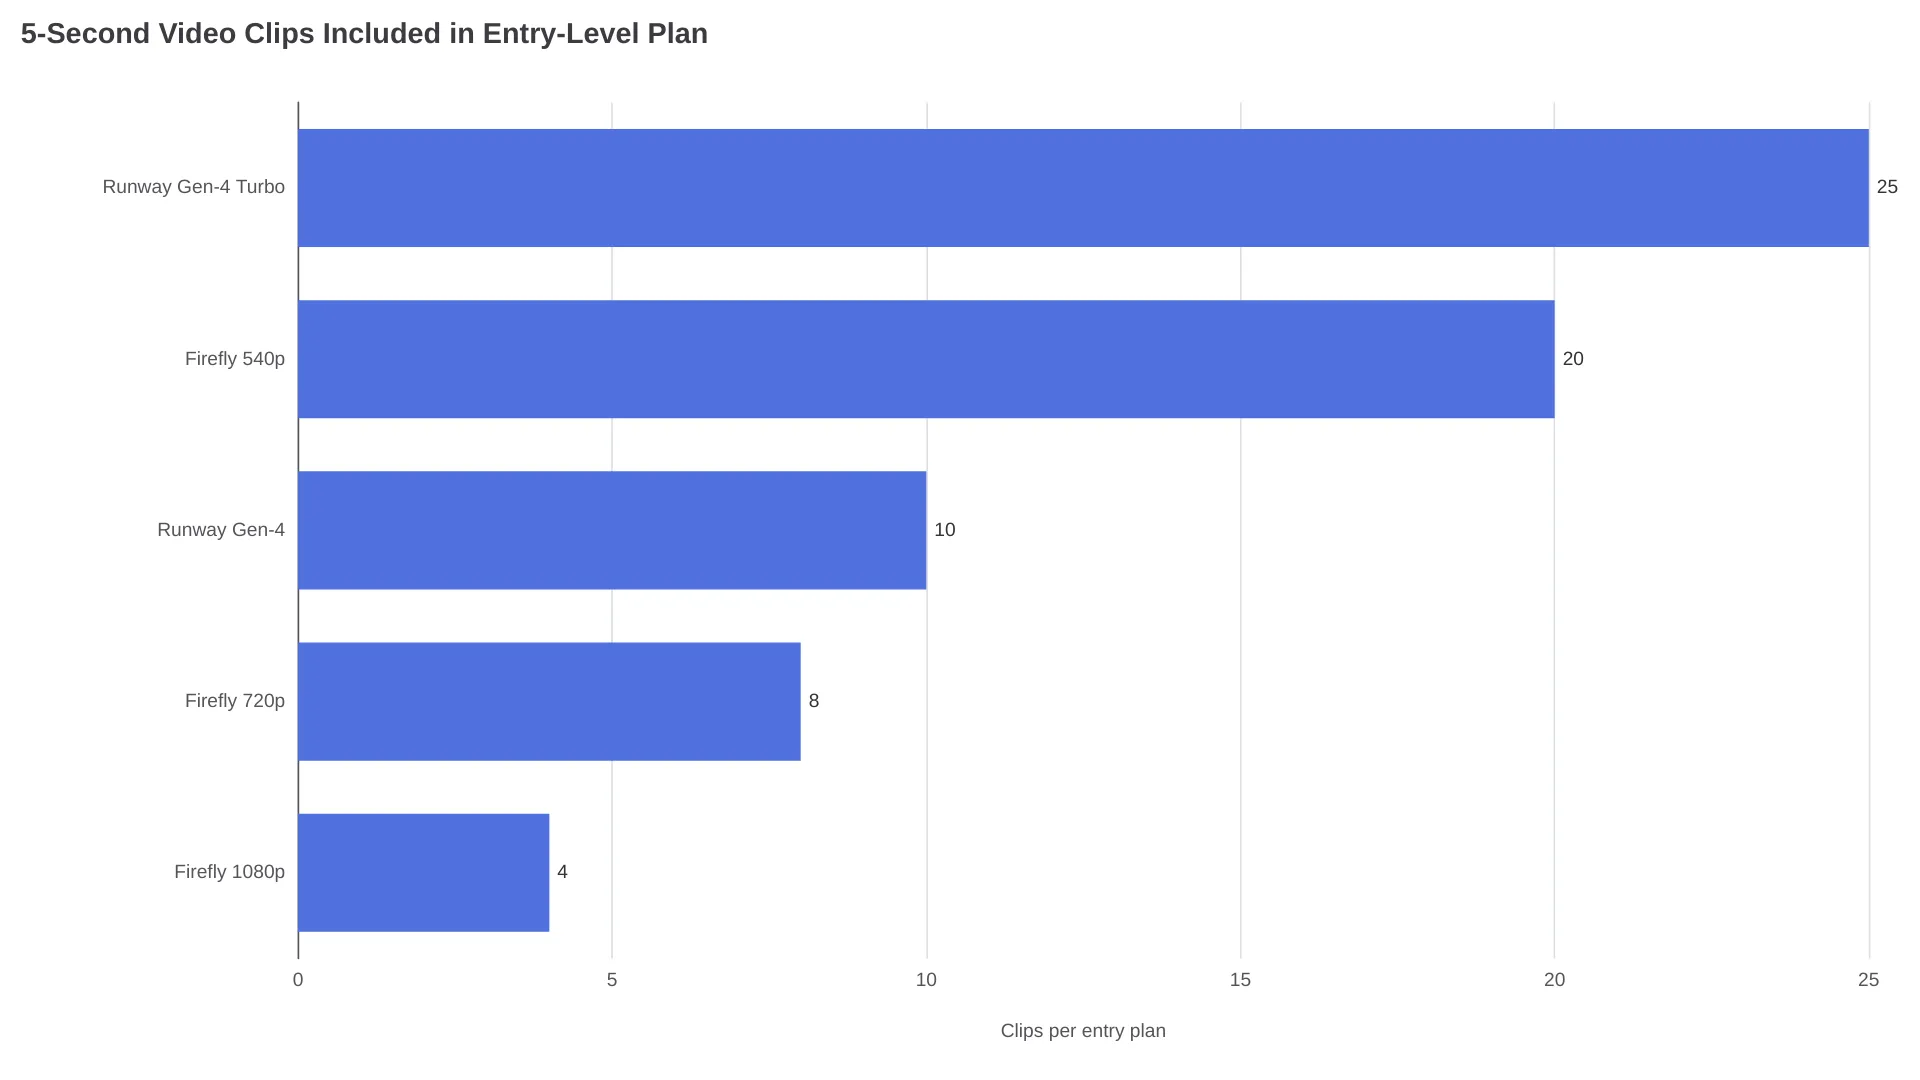
若要針對同一張草圖進行大量迭代,Runway Gen-4 Turbo 或使用 540p 的 Firefly 能把點數用得最久。若只需要少量高品質 1080p 短片,Firefly 1080p 或 Runway Gen-4(非 Turbo)單支影片的成品會更精緻。
如何保留原始草圖的味道
使用 sketch-to-video 最常見的抱怨,是成品看起來不像原始草圖。模型做的是重新詮釋,而非單純渲染:鉛筆草圖可能變成寫實場景,線稿角色也可能被加上創作者從未預期的陰影和色彩。這究竟是優點還是問題,取決於你的目標。
若要保留手繪或線稿美學,請在圖片模型中明確說明。像是「保留原始線稿風格、極少陰影、扁平插畫」這類描述,能讓渲染結果更貼近原稿。若你在本機使用 ControlNet,lineart 或 scribble ControlNet 模組會是更精準的選擇:它能將模型鎖定在邊緣圖上,避免新增原本不存在的結構。
若要讓多支影片中的角色保持一致,請把步驟 1 產生的渲染圖,作為每次後續生成的參考圖。Seedance 2.5 的 reference-first 架構正是為此設計——它將輸入圖片視為角色錨點,圍繞該畫面生成動態,而不是每次都重新想像主體。缺少參考影格時,模型每次執行都會產生新的角色詮釋,臉部、服裝與比例就容易逐漸偏移。
免費方案:ComfyUI 搭配 ControlNet
如果你有足夠性能的 GPU,也不想支付訂閱費,整套流程可以在本機免費運行。一套經社群測試、來自 r/StableDiffusion 的 ComfyUI workflow,串接了數個開源模型:
- ControlNet(lineart 或 scribble 模組)將生成結果鎖定在草圖邊緣上,避免結構漂移。
- Flux 或 Stable Diffusion checkpoint依照文字提示,將草圖渲染成完整圖片並套用所需風格。
- Wan 或 AnimateDiff將渲染完成的靜態圖製作成短片。
交換條件是設定時間與硬體需求。ControlNet 加上 Flux 再加上影片擴散模型,若要舒適地跑完整管線,通常約需 16 GB VRAM;實際需求仍會隨模型、解析度與量化方式而異。消費級硬體生成一支五秒短片可能要花數分鐘,相較之下雲端基礎設施只需數秒。這條路徑不會有平台浮水印;至於商用權利,則取決於你安裝的特定模型與 checkpoint 授權,而非平台服務條款。
不同草圖適合哪一條路?
| 你的情境 | 建議路線 | 原因 |
|---|---|---|
| 快速發想、社群短片、一次性實驗 | 整合式工具(Higgsfield、Dreamina) | 不需提示詞,預設選項會替你完成整套流程 |
| 客戶提案或必須精準符合構圖的預視化作業 | 雲端管線(圖片模型 → 影片模型) | 動畫前可先檢查並修正渲染靜態圖 |
| 預算有限、需要大量迭代、熟悉本機工具 | ComfyUI + ControlNet + Wan/AnimateDiff | 免費、控制力最高、沒有平台浮水印 |
| 需要多支影片之間的角色一致性 | 採用參考影格模型的管線(Seedance) | reference-first 架構可避免角色身分漂移 |
| 包含多個鏡頭的粗略分鏡 | 具備起始/結束影格控制的管線 | 分開管理各鏡頭,轉場會更乾淨 |
FAQ
有免費的 sketch to video AI 嗎?
Kling AI 每 24 小時提供 66 點數(含浮水印、不可商用)。Higgsfield 與 Dreamina 也提供部分免費生成額度。若要不受限制地免費使用,可在本機以 ControlNet 和 AnimateDiff 建置 ComfyUI 管線,但需要性能足夠的 GPU。
很粗略的火柴人草圖也能用嗎?
可以,前提是畫面元素的空間位置必須清楚。AI 讀取的是構圖而非藝術品質:物件彼此的位置關係,比畫得多精細更重要。
Sketch to video 和 image to video 有什麼不同?
Image-to-video 是將完成的照片或圖片製作成動畫;sketch-to-video 則從原始手繪輸入開始,同時生成視覺畫面與動態。實務上,多數工具會先渲染草圖、再進行動畫,因此兩者使用的動畫引擎相同,差別主要在於起始素材。
哪個模型最能保留我的原始草圖?
在本機環境中,ControlNet 的 lineart 或 scribble 模組能提供最嚴格的結構鎖定。在雲端工具中,像 Seedance 2.5 這類 reference-first 影片模型會以輸入內容作為動畫錨點,能減少重新詮釋的程度。
生成影片最長可以多長?
多數 image-to-video 模型每次生成的片段長度為 5 至 10 秒。若要做更長的序列,應規劃生成並剪輯多支短片,而非依賴一次長片生成。起始影格與結束影格控制有助於維持片段之間的連續性。