 AIREITER
Claude Sonnet 5.5 的輸入價格是每百萬 token $2,公開的 Terminal-Bench 4.0 成績則達到 70.6%;不過,代理程式若以最高推理強度執行,實際每個「成功採納的變更」成本可能遠高於表面價格。對正在挑選正式環境程式開發模型的團隊來說,Sonnet 5.5 適合先作為預設路線試行,但還不到可以直接取代 Opus 5.5 的程度。
正式環境結論:先把 Sonnet 5.5 設為預設程式開發路線
建議先用 Claude Sonnet 5.5 處理範圍明確的錯誤修正、重構、測試產生,以及需要使用工具操作程式碼儲存庫的任務。Anthropic 公布的 Terminal-Bench 4.0 成績為 70.6%,高於同一比較中的 Claude Opus 5.5(66.4%)與 Claude Sonnet 5(10.3%)。
但請務必加上一道護欄:明確設定推理強度與輸出上限。獨立成本分析指出,Sonnet 5.5 在最高推理強度下,每項 benchmark 任務的成本可能高於 Opus 5.5,儘管 Sonnet 的標準單價較低。
Claude Sonnet 5.5 為 API 團隊帶來哪些變化
Claude Sonnet 5.5 於 September 28, 2026 發表。官方模型文件列出的模型 ID 是 claude-sonnet-5-5,支援 1-million-token context window、128,000-token standard maximum output、adaptive thinking,以及 API 預設為 high 的 effort level。
| 正式環境細節 | Claude Sonnet 5.5 |
|---|---|
| 發表日期 | September 28, 2026 |
| 模型 ID | claude-sonnet-5-5 |
| Context window | 1M tokens |
| 標準最大輸出 | 128K tokens |
| Batch 最大輸出 | 300K tokens with the documented beta header |
| API 預設 effort | high |
Anthropic 的文件承諾,在 September 28, 2027 之前不會讓此模型退役。這是最低生命週期承諾,不代表模型一定會在該日期退役。
會直接影響程式開發帳單的 API 預設值
Adaptive thinking 預設開啟。從 Sonnet 5 遷移的團隊,如果需要停用預先思考,應測試 between_tools。官方文件指出,強制使用工具現在會回傳錯誤,而非預設的 temperature、top_p 或 top_k 值則會回傳 HTTP 400 錯誤。
工具呼叫之間產生的文字,可能會以 thinking blocks 傳回。如果串流用戶端預設每個中間訊息都是一般文字區塊,遷移後可能看起來像是沒有回應。將 Sonnet 5.5 接入既有程式開發代理程式前,先更新 parser。
Terminal-Bench 效能:足以擔任預設路線
這裡最具代表性的程式開發代理程式 benchmark 是 Terminal-Bench 4.0,評估的是多步驟命令列任務。Anthropic 公布的結果顯示,Sonnet 5.5 得分 70.6%,Opus 5.5 為 66.4%,Sonnet 5 則是 10.3%。
| 模型 | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70.6% | 1844 | 55.5% |
| Claude Opus 5.5 | 66.4% | 1846 | 57.8% |
| Claude Sonnet 5 | 10.3% | 1449 | 34.1% |
上述 benchmark 數據來自 DataCamp benchmark summary,該頁將評測結果歸因於 Anthropic 的發表資料。Sonnet 5.5 在終端機程式開發比較中領先,但 Opus 5.5 在 CursorBench,以及數項更廣泛的推理與知識工作評測中仍然勝出。
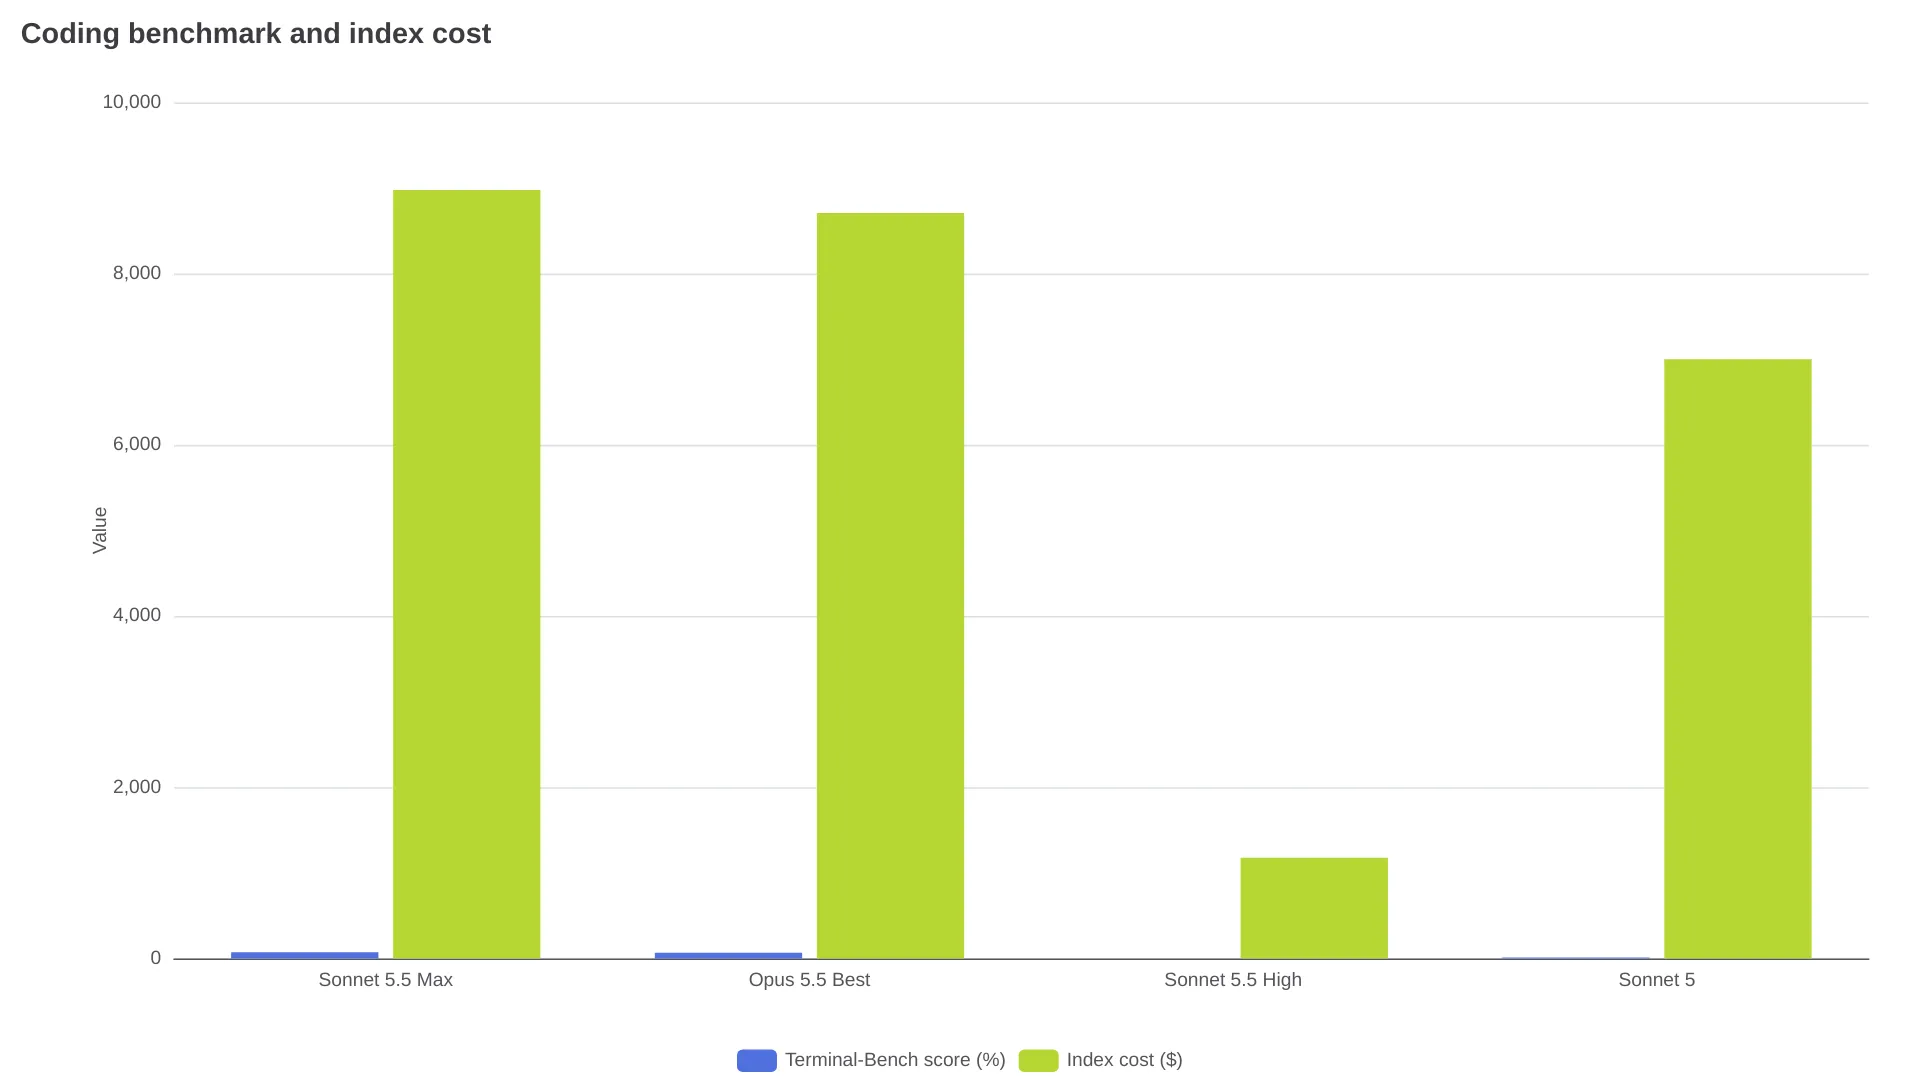
請使用儲存庫重播進行驗證,觀察通過的測試、工具回合數與成功採納的變更,而不要只看 diff。
Claude Sonnet 5.5 API 在實際工作負載下的定價
Anthropic 的價格表看似簡單,但程式開發代理程式實際付費的內容,可能不只有畫面上看得到的 prompt。Thinking tokens 會按照輸出計費,而跨回合重複帶入的儲存庫內容,則可能在後續回合成為 cache reads。
| API 項目 | Claude Sonnet 5.5 價格 |
|---|---|
| 輸入 | $2 per 1M tokens |
| 輸出,包括 thinking | $10 per 1M tokens |
| 5-minute cache write | $2.50 per 1M tokens |
| 1-hour cache write | $4 per 1M tokens |
| Cache read | $0.20 per 1M tokens |
| Batch input | 50% discount, equivalent to $1 per 1M |
| Batch output | 50% discount, equivalent to $5 per 1M |
官方文件列出 512-token minimum cacheable prompt,並說明 Sonnet 5.5 使用 adaptive thinking。根據 eesel 的獨立定價分析,Sonnet 5.5 與 Sonnet 5 使用相同 tokenizer;完成遷移並不會自動降低 token 數量。
一個包含 4,000 個輸入 token 與 700 個輸出 token 的請求,在不計其他費用的情況下,成本約為 $0.015:輸入 $0.008,加上輸出 $0.007。若程式開發代理程式執行 20 個回合,每回合包含 3,000 個新增輸入 token 與 2,000 個輸出 token,扣除 cache reads、cache writes、工具與重試前,新增輸入約耗用 $0.12,輸出約耗用 $0.40。這些只是工作負載示例,不代表所有任務的固定價格。
Effort 才是真正的成本控制旋鈕
TokenCost 的 effort 分析根據 Artificial Analysis Intelligence Index 測量結果,公布了 Sonnet 5.5 的以下數據:
| Effort | 分數 | Full-index cost |
|---|---|---|
| Low | 35.8 | $544 |
| Medium | 40.7 | $701 |
| High | 46.7 | $1,176 |
| Xhigh | 51.9 | $2,738 |
| Max | 56.0 | $8,977 |
最高推理強度的結果尤其值得警惕。同一份分析顯示,Opus 5.5 在 max 下得到 57.6 分、成本為 $8,708;在 xhigh 下則得到 56.0 分、成本為 $4,057。該測試中,Sonnet 5.5 max 每項任務約使用 193,000 個輸出 token。
建議從 medium 或 high 開始,限制輸出 token,只有失敗或高風險任務才升級到更昂貴的路線。不要直接把舊有的 Sonnet 5 max 設定套到 Sonnet 5.5,應重新執行成本與品質評估。
正式環境程式開發模型的遷移清單
- 在 staging 固定使用
claude-sonnet-5-5,不要直接在全域切換 alias。 - 從程式碼儲存庫重播具代表性的錯誤修正、重構、測試與多檔案變更任務。
- 明確設定 effort,並記錄輸出 token、cache reads、工具回合數、實際耗時,以及成功採納變更的比例。
- 在適用情況下,將
thinking: disabled改為受支援的between_tools行為。 - 移除對強制工具使用的假設,並測試新的工具選擇行為。
- 更新串流程式碼,處理工具呼叫之間的
thinkingblocks。 - 重新檢查非預設 sampling 參數;官方文件列出非預設
temperature、top_p與top_k會回傳 400 錯誤。 - 加入支出上限,並為失控的輸出或重複工具迴圈設定中止條件。
- 比較每個成功採納變更的成本,而不是每個請求的成本。
- 先讓少量流量使用新模型。只有在約定的容許範圍內達到與現有模型相當的成功採納變更比例,同時降低每個成功採納變更的成本時,才逐步提高 Sonnet 的流量。
Anthropic 員工 @cjav_dev 表示,使用 thinking: {"type":"disabled"} 的請求開始回傳 400 錯誤,應改用 between_tools(X 上的貼文)。
什麼時候該選 Sonnet 5.5、Opus 5.5,或更便宜的模型
| 工作負載 | 首選建議 | 原因 |
|---|---|---|
| 範圍明確的錯誤修正與重構 | Sonnet 5.5,使用 medium/high | 終端機評測成績強,token 單價較低 |
| 大量程式碼分類或簡單編輯 | Sonnet 5.5,使用 low/medium,或更便宜的模型 | 避免為不必要的推理付費 |
| 長時間執行的儲存庫代理程式 | 搭配 caching 與硬性預算的 Sonnet 5.5 | Cache 與回合數才是實際帳單的關鍵 |
| 模糊的架構問題或最終審查 | Opus 5.5 | 廣泛的判斷能力比最低價格表更重要 |
| 離線、非緊急的程式碼分析 | Sonnet 5.5 Batch API | API 提供 50% input/output discount |
| 最高推理強度的終端機實驗 | 只有在完成內部 benchmark 後才使用 Sonnet 5.5 | Terminal-Bench 是其相對強項,但 max 可能十分昂貴 |
定義清楚、可量化的任務交給 Sonnet;涉及模糊架構判斷的工作則升級到 Opus。
Claude Sonnet 5.5 API 常見問題
Claude Sonnet 5.5 API 怎麼計價?
標準價格是每百萬輸入 token $2,以及每百萬輸出 token $10。Cache reads 為每百萬 token $0.20;cache writes 的價格是五分鐘 $2.50,或一小時 $4;Batch API 則對輸入與輸出都提供 50% 折扣。
Sonnet 5.5 的程式開發能力比 Opus 5.5 好嗎?
在公開的 Terminal-Bench 4.0 比較中,Sonnet 5.5 以 70.6% 領先 Opus 5.5 的 66.4%。不過,Opus 在其他數項評測中仍然勝出,因此團隊應該依任務類型分流,而不是把這項程式開發成績視為全面排名。
Sonnet 5.5 的模型 ID 是什麼?
在 Claude API 上使用 claude-sonnet-5-5。各 provider 的專用識別碼可參考Anthropic 的模型文件。
Sonnet 5.5 支援 1M-token context window 嗎?
支援。Anthropic 列出的 context window 為 1-million-token,標準最大輸出為 128,000-token。Message Batches API beta 搭配文件所述的 beta header 後,可支援 300,000 個輸出 token。
從 Sonnet 5 遷移時有哪些變化?
Adaptive thinking 與 response-block 行為有所變更;強制使用工具可能回傳錯誤;非預設 sampling 參數可能回傳 400 錯誤;而 thinking: disabled 必須改成受支援的行為。正式上線前,請重新執行代理程式與串流測試。
先進行為期一週、使用 medium/high effort 的重播試行,衡量每個成功採納變更的成本,並將失敗案例升級到 Opus。