 AIREITER
В карточке модели MiniMax прямо называет слой предобработки H3 «критически важным для качества финального результата». А в Reddit-треде о промптинге H3, набравшем 220 голосов, пользователи в основном разбирают бессвязные реплики персонажей. В этом обзоре MiniMax H3 сопоставлены официальный формат и задокументированные тесты авторов: управление камерой и референсами в них работает заметно надёжнее диалогов и аудио, а лучший результат иногда даёт сознательный отход от рекомендованного синтаксиса.
Как устроен формат промптов MiniMax H3
Официальный промпт MiniMax H3 — это структурированный документ с тремя полями: integrated_multimodal_description, overall_soundscape и non_diegetic_music. В нём указываются шоты с таймкодами, постоянные идентификаторы говорящих и диалоги в тегах <d>. Такая конструкция нужна потому, что H3 рассчитывает на промежуточное структурированное представление, которое обычно создаёт закрытый препроцессор H3-Context-IR. MiniMax не включила его в релиз открытых весов: в облачном API он сам переписывает свободный запрос в нужную форму, а при локальном запуске 33B-весов через SGLang, vLLM, Diffusers или ComfyUI эту структуру приходится писать вручную.
В официальном GitHub-репозитории MiniMax также выложила переносимый навык h3-prompt-writing. Это два файла-инструкции — base-en.txt и ref-en.txt, — которые может прочитать любой coding-агент без внешних API-вызовов. Авторы запускают его в Claude или Cursor, чтобы превращать обычный бриф в полный структурированный промпт. Именно такой процесс для кинематографичных роликов показывает @AI__TSUBAKI.
Ограничения, которые нужно учитывать в каждом промпте
| Ограничение | Значение | Что это меняет в промпте |
|---|---|---|
| Длительность ролика | 4–15 секунд, 24 FPS | Таймкоды должны строго возрастать и укладываться в длительность ролика |
| Аудио | Стерео 32 кГц, генерируется вместе с видео | Поля звуковой среды и музыки обязательны, допускается N/A |
| Разрешение | 768p по умолчанию; 2K через H3-Regenerate-2K, только API | Тестируйте в 768p, а за 2K платите после фиксации промпта |
| Типы задач | T2VA (текст), I2VA (первый кадр на 0.00 с), FL2VA (первый и последний кадры), L2VA (последний кадр), Ref2VA (универсальные референсы) | Для каждого типа нужна своя фраза выравнивания |
| Лимиты референсов | 9 изображений + 3 видеоклипа + 3 аудиоклипа, всего 12 файлов, ≤15 с на тип медиа | Больше референсов означает больше маршрутизации, но не обязательно лучший результат |
| Размер промпта | Официальные примеры занимают 300–700 слов; для чистого text-to-video лимит около 7 000 символов | Короткие промпты без референсов официальное руководство относит к частым причинам сбоев |
Минимальный рабочий промпт с тремя полями, одной командой для камеры, видимым говорящим и репликой в кавычках, но без музыки, помещается в десять строк:
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
Полный синтаксис по полям — все теги, фразы выравнивания и шаблоны — разобран в нашем гайде по промптам MiniMax H3. Здесь же важно понять, оправдывает ли этот синтаксис затраченные усилия.
Три обещания формата: что подтверждают тесты
В официальных рекомендациях заложены три неявных обещания. Судя по приведённым отчётам, первые два подтверждаются лучше, чем точность следования аудиоинструкциям.
Обещание №1: структура помогает получить ожидаемый результат
Здесь доказательства наиболее убедительны. Автор X @AIWarper опубликовал сравнение до и после перехода на официальную структуру:
«Я НАСТОЯТЕЛЬНО советую придерживаться руководства по промптам от Minimax. Оно действительно сильно помогает получить именно то, чего вы ожидали.... В моём прошлом посте рекомендованная структура не использовалась». — @AIWarper, 306 лайков
Сторонний журнал тестов показывает тот же эффект на уровне деталей: автор запросил монтажную склейку ровно на 00:05.000 и получил её, дословно воспроизвёл прописанный отзыв и сохранил композицию первого кадра на протяжении 6-секундного I2VA-клипа. Отчёты по раскадровкам совпадают: H3 следует последовательности шотов в бордах @aimikoda, а раскадровка @nanyuan0412 была выполнена без импровизации. Исключением стали незаполненные поля звука — результат оказался почти беззвучным.
Повторяющаяся проблема — не отказ модели следовать сценарию, а темп. «Самой большой проблемой был темп», — пишет u/Relevant_One_2261. Диалог не помещается в хронометраж, а таймкоды стоят слишком близко друг к другу — именно такие структурные ошибки встречаются чаще всего.
Обещание №2: команды для камеры лучше описаний желаемого кадра
Это подтвердил случай с неудачным кадрированием, который удалось исправить. Пользователь r/StableDiffusion пытался удержать идущего человека в полный рост простой фразой «entire subject remains visible throughout», но H3 раз за разом не справлялась. Решением стал перевод желаемого результата на привычный для H3 язык камеры:
«Камера отъезжает с большой амплитудой и с той же скоростью, с которой персонаж идёт вперёд, сохраняя композицию в полный рост». — u/Powerful-Goal52, работоспособность подтверждена автором исходного поста
Эта формулировка напрямую использует три параметра камеры в H3: тип движения, амплитуду и скорость. Кроме того, в каждом шоте должна быть только одна команда камеры. Быстрый перевод целей в понятные модели инструкции:
| Желаемый результат | Команда, которой следует H3 |
|---|---|
| Персонаж остаётся полностью в кадре во время ходьбы | Pull Out с большой амплитудой на скорости ходьбы персонажа |
| Мягко подчеркнуть объект, не ломая кадрирование | Push In, малая амплитуда, низкая скорость |
| Показать окружение вокруг неподвижного персонажа | Truck Left или Truck Right, средняя амплитуда |
| Изменить высоту камеры без наклона | Pedestal Up / Pedestal Down на низкой скорости |
Официальное руководство по промптингу перечисляет 13 семейств движений: Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll и POV. Каждое дополнительно задаётся амплитудой и скоростью. На практике различие между zoom — изменением фокусного расстояния — и push, то есть физическим движением камеры, принципиально: эти термины нельзя считать взаимозаменяемыми.
Обещание №3: отдельные поля аудио сохраняют чистый звук
Это слабое место формата. Разделять диегетическую звуковую среду и недиегетическую музыку — хорошая идея, но модель следует этим полям нестабильно:
«Я использую это, но примерно в 20% случаев она всё равно добавляет музыку, лол». — u/TheElectriking о
non_diegetic_music: N/A
Тот самый тред с 220 голосами описывает и остальные типичные проблемы: аудиоартефакты на границах клипа, случайная тарабарщина вместо реплик и фразы, произнесённые не тем персонажем. u/krigeta1 передал три собственных аудиореференса, но получил «случайный голос или не то аудио, которое я назначал персонажам». В отдельном обсуждении удалось исправить реплики, которые читались за кадром вместо произнесения персонажем в кадре: помогло явно привязать ID говорящего к видимому герою.
Текст в кадре столь же хрупок. Вики сообщества прямо предупреждает: «точный текст ненадёжен». Критичные для бренда надписи лучше передавать через референсное изображение или накладывать на постобработке. Есть и более жёсткая оценка: @web4miko пишет, что в его тестах H3 «не может даже превзойти Seedance 2.0» в понимании текста и контекста. В приведённых отчётах постоянно повторяются три слабые зоны: маршрутизация аудио, точный текст и плотный контекст.
Когда стоит отступить от официального синтаксиса
В приведённых сравнениях и отчётах из первых рук встречаются три отступления от официального формата. О них стоит знать до того, как вкладываться в полную структуру.
Кавычки иногда надёжнее тегов <d>. В сравнении на r/StableDiffusion, которое собрало около 105 голосов и 81 комментарий, автор обнаружил: если убрать рекомендованную разметку <d>[Language]...台词...</d> и оставить обычную реплику в кавычках, речь получается чистой. Вариант с тегами, напротив, добавлял незапрошенное аудио. Комментатор с похожими тестами согласился:
«официальный промптинг диалогов ужасно баговый... подход с кавычками всё равно далеко не идеален, но он заметно менее глючный, чем разметка
<d></d>». — u/networking_noob
Практический вывод: сначала пробуйте <d>, поскольку это штатный путь, на котором обучали модель. Но если речь искажается или генерируется сверх запроса, повторите ту же реплику в кавычках, а не переписывайте весь промпт.
non_diegetic_music: N/A работает и без остальной структуры. По словам u/Nextil, это предотвращает появление музыки «даже если игнорировать большую часть остальной структуры». Если структурировать только что-то одно, пусть это будет данный параметр: нежелательная фоновая музыка — частая жалоба в упомянутых отчётах.
Чем больше референсов, тем меньше нужен текст. Если изображения уже несут идентичность персонажа, а видео задаёт движение, задача промпта сводится к маршрутизации и новому действию. Самые популярные шаблоны @aimikoda — один из них сохранили более 1 300 раз — намеренно минималистичны по этой причине. А @CharaspowerAI показал, как собственный агент Design от MiniMax автоматически разворачивает одну фразу, «act as an expert FPV director and turn this into something viral», в полный структурированный промпт. Блок маршрутизации референсов может выглядеть так:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
Дальше промпт описывает только новый шот. Практический процесс в этих отчётах такой: сначала зафиксировать статику, дать референсам сделать основную работу и тратить слова лишь на то, что меняется.
Разбор сбоев: чего не объясняет руководство
Официальное руководство заканчивается на синтаксисе. Оно не объясняет, что делать, когда генерация возвращается сломанной. Эта таблица собрана по описанным выше отчётам о сбоях:
| Симптом | Вероятная причина | Что делать |
|---|---|---|
Музыка появляется несмотря на N/A | Один пользователь наблюдал утечку примерно в 20% генераций | Перегенерировать; нигде в промпте не запрашивать «настроение» музыки |
| Реплику произносит не тот персонаж | Конфликт маршрутизации говорящего и аудио | Явно привязать ID говорящего к видимому персонажу в кадре |
| Реплика персонажа в кадре читается как закадровый голос | Нет привязки к липсинку | Указать, что говорящий виден; для настоящего закадрового текста добавить «lips remain closed» |
| Аудиореференс игнорируется | Превышены лимиты в 3 клипа / 15 секунд или роли не назначены | Назначить каждому клипу роль; сократить общий объём аудиореференсов |
| Локальная модель игнорирует китайский диалог | ComfyUI использует повторно токенайзер Qwen; shell повреждает кодировку текста | Токенайзер из репозитория, как требует MiniMax + Unicode-безопасная отправка + <d>[Chinese] 台词</d> (исправление, предложенное сообществом) |
| Длинный непрерывный шот (>15 с) разваливается | Он выходит за проектный диапазон 4–15 с; объекты уплощаются, теряется непрерывность | Разбить на 15-секундные сегменты и заранее спланировать непрерывность между ними |
Строка о локальном развёртывании заслуживает отдельного внимания. В отчёте @eternityspring проблема «H3 won't speak Chinese» оказалась связана с повторным использованием токенайзера и кодировкой, а не с самим промптом.
Цена структуры: токены, итерации и переносимость
Структура не даётся бесплатно. В официальном репозитории опубликован расход токенов Context-IR для трёх воспроизводимых сценариев. С ростом числа референсов цифры резко увеличиваются:
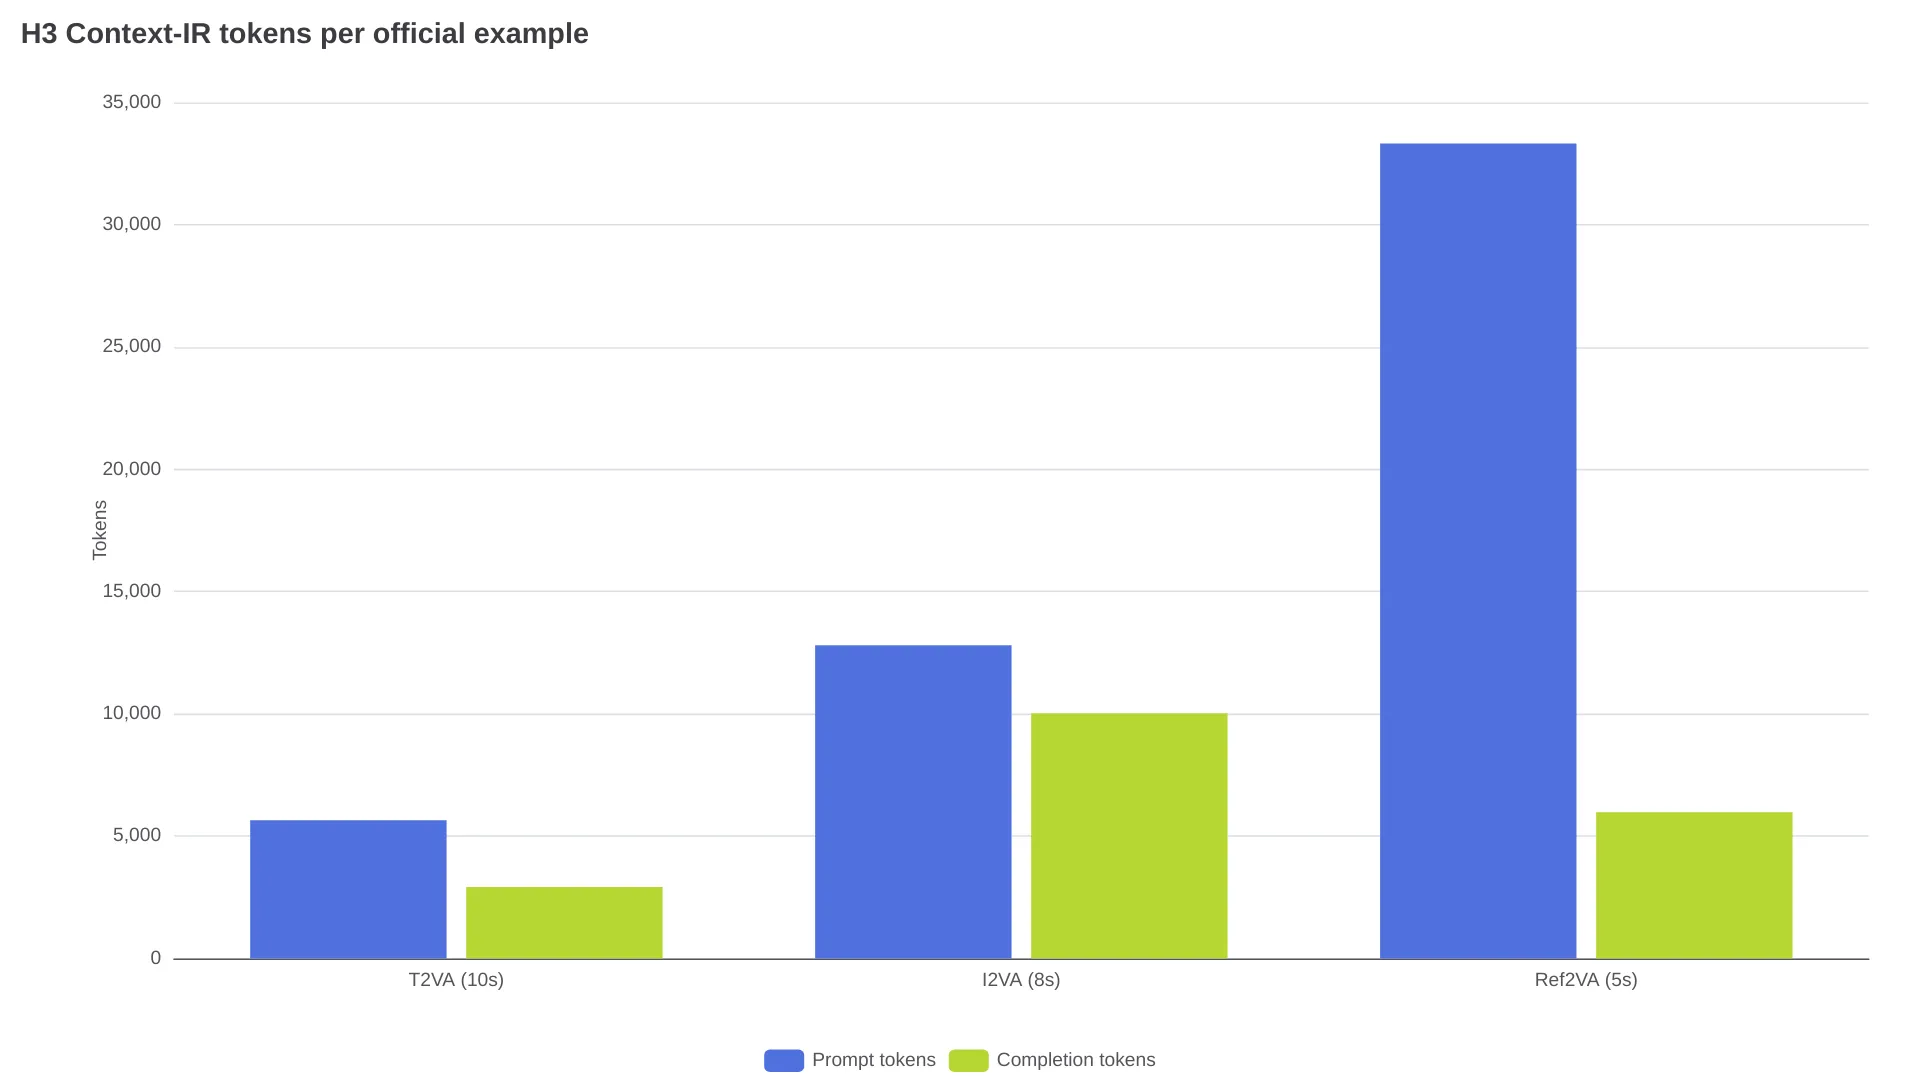
Генерация только по тексту потребляет 8 565 токенов предобработки; мультимодальная задача с референсами — 39 299, из которых 33 323 приходятся на сторону промпта. При локальном запуске это добавляет задержку предобработки, а в облачном процессе увеличивает накладные расходы, даже если цена указывается за секунду готового видео. Есть и временная цена: один автор в X документировал 48 часов полировки единственного промпта с тремя персонажами и движущейся по орбите камерой, прежде чем результат получился (@LoveUolanda). Экономный способ итерировать: черновики делать в 768p, где 6-секундный тест стоит около $0.68, и отправлять готовый промпт в 2K только после фиксации. На странице модели ретранслятора указаны тарифы MiniMax H3: $0.1125/с для 768p и $0.1825/с для 2K.
Последняя скрытая цена — переносимость. Поля H3, ID говорящих и теги образуют диалект, а не стандарт. В одном сравнительном разборе моделей отмечается, что Veo 3.1 нужны обычные абзацы с встроенными метками SFX:, а Seedance 2.0 использует описание из шести слотов. Ни одна из них не принимает поля, ID говорящих и теги H3. Библиотека промптов для H3 не переносится копированием — для каждой другой модели её придётся переписывать.
FAQ по промптам MiniMax H3
Обязателен ли структурированный формат промпта для MiniMax H3?
Нет. В облачном API Context-IR сам преобразует свободный текстовый запрос во внутреннее представление. Структура особенно важна при локальном запуске открытых весов, а также для точных монтажных склеек, таймкодов и маршрутизации говорящих.
Как запретить MiniMax H3 добавлять фоновую музыку?
Заканчивайте промпт строкой non_diegetic_music: N/A и нигде больше не задавайте музыкальное настроение. Утечки всё равно случаются, поэтому перегенерация в такой ситуации нормальна.
Какой длины должен быть промпт для MiniMax H3?
Собственные примеры MiniMax занимают 300–700 слов, а чистый text-to-video принимает примерно до 7 000 символов. Если референсы уже передают внешность и движение, промпт должен становиться короче, а не длиннее.
Можно ли использовать промпты H3 в Seedance или Veo?
Нет. Именованные поля, ID говорящих и теги H3 специфичны для этой модели. Seedance использует шестислотовый формат, а Veo принимает обычные абзацы, поэтому для каждой целевой модели нужен отдельный вариант промпта.
Почему локальная H3 игнорирует диалог не на английском языке?
Обычно проблема в инструментах, а не в модели: конфигурации с повторно использованным токенайзером Qwen или оболочки, повреждающие Unicode, ломают реплики ещё до генерации. Используйте официальный токенайзер из репозитория и формат диалога <d>[Language].
Итог: кому стоит осваивать формат
| Ваша задача | Вердикт |
|---|---|
| Многошотный ролик с диалогами | Осваивайте полный формат; закладывайте повторные попытки для аудио и запасной вариант с кавычками |
| Анимация продукта или статичного изображения (I2VA) | Освойте облегчённый вариант: фраза выравнивания + движение + поля звука |
| Раскадровка или серия с постоянством персонажей | Да — основную работу выполняют референсы; промпты должны быть минимальными и удобными для маршрутизации |
| Разовые короткие клипы для обычного использования | Большую часть формата можно пропустить: хватит обычного описания + non_diegetic_music: N/A |
| Единая библиотека промптов для разных моделей | Нет — каждой модели нужен собственный диалект; пишите отдельные версии |
Формат стоит изучать для многошотных сцен, работы с таймкодами и референсами: именно в этих задачах его предсказуемость подтверждена и воспроизводима. Для разовых клипов он избыточен, а в роликах с насыщенными диалогами лучше сразу рассчитывать на несколько попыток, а не на безусловное следование инструкции.
Сообщество само разделилось вокруг этого компромисса. В один и тот же месяц появился и 48-часовой марафон по настройке камерного промпта, и пост на 880 голосов, где один из комментаторов написал, что «читать руководство было действительно увлекательно». Пока соблюдение аудиополей не догнало точность управления камерой, рабочая стратегия выглядит так: поручите агенту собрать структуру, сами проверьте аудиополя и недорого тестируйте в 768p, прежде чем переходить к 2K.