 AIREITER
MiniMax는 H3 모델 카드에서 전처리 레이어를 "최종 출력 품질에 결정적"이라고 설명한다. 반면 H3 프롬프팅 관련 220업보트 Reddit 스레드에는 알아들을 수 없는 대사 문제가 빼곡하다. 이 MiniMax H3 프롬프트 리뷰는 공식 형식과 제작자 테스트, 실패 보고를 함께 대조한다. 인용한 사례를 종합하면 카메라와 레퍼런스 제어는 비교적 안정적이지만, 대사와 오디오는 그렇지 않다. 심지어 더 나은 결과를 위해 공식 문법을 의도적으로 벗어나야 하는 경우도 있다.
MiniMax H3 프롬프트 형식은 무엇인가
MiniMax H3의 공식 프롬프트는 integrated_multimodal_description, overall_soundscape, non_diegetic_music라는 세 필드로 구성된 구조화 문서다. 여기에 타임코드 샷, 지속되는 화자 ID, <d> 대사 태그를 넣는다. H3는 원래 호스팅된 전처리기가 생성하는 구조화 중간 표현, 즉 H3-Context-IR를 기대하도록 설계됐기 때문이다. MiniMax는 이를 오픈 웨이트 릴리스에 포함하지 않았다. 호스팅 API는 느슨한 요청을 내부적으로 재작성해 주지만, 로컬에서 33B 오픈 웨이트를 돌리는 경우(SGLang, vLLM, Diffusers, ComfyUI)에는 사용자가 이 구조를 직접 작성해야 한다.
MiniMax는 공식 GitHub 리포지터리에 이식 가능한 h3-prompt-writing 스킬도 제공한다. 외부 API 호출 없이 코딩 에이전트가 읽을 수 있는 두 개의 가이드 파일(base-en.txt, ref-en.txt)이다. 제작자들은 Claude나 Cursor 안에서 이 스킬을 실행해 자연어 브리프를 전체 형식으로 변환한다. @AI__TSUBAKI는 시네마틱 클립 제작에 이 워크플로를 사용한 사례를 정확히 기록했다.
프롬프트 작성 전에 알아둘 제약 조건
| 제약 조건 | 값 | 프롬프팅에 미치는 영향 |
|---|---|---|
| 클립 길이 | 4–15초, 24 FPS | 타임스탬프는 엄격히 오름차순이어야 하며 전체 길이 안에 들어와야 한다 |
| 오디오 | 32 kHz 스테레오, 영상과 함께 생성 | 사운드스케이프와 스코어 필드는 필수이며 N/A 사용 가능 |
| 해상도 | 기본 768p, 2K는 H3-Regenerate-2K(API 전용) | 768p에서 테스트하고 프롬프트를 확정한 뒤 2K 비용을 지불하는 편이 낫다 |
| 작업 유형 | T2VA(텍스트), I2VA(0.00초 첫 프레임), FL2VA(첫·마지막 프레임), L2VA(마지막 프레임), Ref2VA(옴니 레퍼런스) | 각 유형에는 고유한 정렬 문장이 필요하다 |
| 레퍼런스 한도 | 이미지 9장 + 영상 클립 3개 + 오디오 클립 3개, 총 12개 파일, 미디어 유형별 합계 ≤15초 | 레퍼런스가 많아질수록 라우팅도 늘어나며, 항상 결과가 좋아지는 것은 아니다 |
| 프롬프트 크기 | 공식 예시는 300–700단어, 순수 텍스트-투-비디오는 약 7,000자 제한 | 레퍼런스 없는 짧은 프롬프트는 공식 매뉴얼이 지적한 실패 패턴이다 |
세 필드, 카메라 지시 하나, 화면에 보이는 화자의 인용 대사, 그리고 스코어 없음. 이 정도의 최소 실행 프롬프트라면 열 줄이면 충분하다.
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
모든 태그, 정렬 문장, 템플릿을 포함한 필드별 전체 문법은 MiniMax H3 프롬프트 가이드에서 다뤘다. 이 글에서는 그 문법이 실제로 들인 수고만큼의 가치를 내는지에 집중한다.
공식 형식이 약속하는 세 가지, 실제로는
공식 가이드는 사실상 세 가지를 약속한다. 인용한 보고서는 첫 두 항목에는 대체로 긍정적이지만, 오디오 준수도는 훨씬 낮게 평가한다.
약속 1: 구조를 지키면 의도한 결과에 가까워진다
이 항목의 근거가 가장 강하다. X 제작자 @AIWarper는 공식 구조로 전환한 전후 결과를 비교해 올렸다.
"MiniMax가 공개한 프롬프팅 가이드를 따르기를 강력히 권합니다. 기대한 결과를 정확히 얻는 데 정말 큰 도움이 됩니다.... 제 이전 게시물은 권장 프롬프트 구조를 따르지 않았습니다." — @AIWarper, 좋아요 306개
서드파티 테스트 로그도 세부 수준에서 같은 경향을 보여준다. 정확히 00:05.000에 컷을 요청했고 실제로 그 시점에 컷이 나왔으며, 스크립트로 작성한 추천 대사를 한 글자도 틀리지 않고 옮겼다. 6초 I2VA 클립에서는 첫 프레임의 구도도 안정적으로 유지했다. 스토리보드 사례도 비슷하다. @aimikoda의 보드는 순차적인 샷 가이드로 따라갔고, @nanyuan0412의 보드도 사운드 필드를 빠뜨린 부분을 제외하면 즉흥 해석 없이 그대로 따랐다. 누락된 사운드 필드의 결과는 거의 무음이었다.
반복해서 드러나는 한계는 거부가 아니라 페이싱이다. u/Relevant_One_2261는 "가장 큰 문제는 페이싱"이라고 썼다. 러닝타임에 들어가지 않는 대사, 지나치게 촘촘한 타임스탬프가 대표적인 구조적 실패 원인으로 반복된다.
약속 2: 결과 설명보다 카메라 명령이 잘 먹힌다
구도 실패를 해결한 사례가 이를 뒷받침한다. 한 r/StableDiffusion 사용자는 걷는 인물의 전신을 계속 프레임 안에 유지하려고 "entire subject remains visible throughout"라고 간단히 지시했지만 여러 번 실패했다. 해결책은 원하는 결과를 H3가 이해하는 카메라 문법으로 옮기는 것이었다.
"피사체가 앞으로 걷는 속도와 같은 속도로 카메라를 큰 진폭으로 뒤로 빼며, 전신 구도를 유지한다." — u/Powerful-Goal52, 원 게시자가 작동을 확인
이는 H3의 카메라 3요소, 즉 움직임 유형·진폭·속도와 샷당 카메라 지시는 하나만 둬야 한다는 규칙에 정확히 맞는다. 실전용 변환표는 다음과 같다.
| 원하는 결과 | H3가 따르기 쉬운 명령 |
|---|---|
| 걷는 피사체의 전신을 계속 보여주기 | 피사체의 보행 속도에 맞춰 큰 진폭으로 Pull Out |
| 구도를 깨지 않고 은은하게 강조하기 | 작은 진폭, 느린 속도의 Push In |
| 정지한 피사체 주변 환경을 드러내기 | 중간 진폭의 Truck Left 또는 Truck Right |
| 틸트 없이 카메라 높이 바꾸기 | 느린 속도의 Pedestal Up / Pedestal Down |
공식 프롬프팅 가이드는 Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll, POV까지 13개 움직임 유형군을 제시하며, 각각은 진폭과 속도로 조절된다. 줌은 초점거리 변화이고 푸시는 카메라 자체의 물리적 이동이다. 실제 작업에서는 이 둘을 바꿔 쓸 수 없다.
약속 3: 오디오 필드를 분리하면 깔끔하게 제어된다
여기가 가장 약한 층이다. 장면 내 사운드스케이프와 비다이제틱 스코어를 나누는 설계 자체는 좋지만, 지시 준수도는 일관되지 않다.
"저도 이걸 쓰는데, 약 20%는 그래도 음악을 넣더라고요 ㅋㅋ" — u/TheElectriking,
non_diegetic_music: N/A에 대해
이 인용이 나온 220업보트 스레드는 클립 경계의 오디오 아티팩트, 인물이 무작위 횡설수설을 하는 문제, 대사를 엉뚱한 인물이 말하는 문제까지 정리한다. u/krigeta1은 맞춤형 오디오 레퍼런스 세 개를 전달했지만 "임의의 목소리가 나오거나 내가 캐릭터에 배정한 오디오가 나오지 않았다"고 보고했다. 또 다른 스레드에서는 화면 속 대사가 계속 오프스크린으로 읽히던 문제를, 화자 ID를 화면에 보이는 캐릭터와 명시적으로 연결해 해결했다.
화면 텍스트도 같은 취약성을 보인다. 커뮤니티 위키는 이를 "exact text is fragile"이라고 표현하며, 브랜드에 중요한 문구는 이미지 레퍼런스로 제공하거나 후반 합성하는 편이 낫다고 권한다. 반대 의견도 있다. @web4miko는 자신의 테스트에서 H3가 텍스트와 문맥 이해 능력으로 "Seedance 2.0조차 이기지 못한다"고 밝혔다. 인용된 보고에서 반복되는 약점은 오디오 라우팅, 정확한 텍스트, 밀도 높은 문맥이다.
공식 문법을 일부러 깨야 할 때
인용한 비교 테스트와 실사용 보고에는 공식 형식에서 벗어난 세 가지 방법이 등장한다. 전체 구조를 고수하기 전에 알아둘 만한 예외다.
대사는 <d> 태그보다 따옴표가 나을 때가 있다. r/StableDiffusion에 올라온 비교 게시물(약 105업보트, 댓글 81개)에서 원 게시자는 가이드의 <d>[Language]...台词...</d> 태그를 제거하고 일반적인 따옴표 대사를 썼을 때 깨끗한 음성이 나왔다고 했다. 태그 형식은 요청하지 않은 오디오를 추가했다. 비슷한 테스트를 한 댓글 작성자도 동의했다.
"공식 대사 프롬프팅은 정말 버그가 심합니다... 따옴표 방식도 완벽하진 않지만
<d></d>태깅보다는 훨씬 덜 문제를 일으킵니다." — u/networking_noob
실전에서는 학습 경로인 <d>를 먼저 시도하되, 대사가 깨지거나 과도하게 생성되면 프롬프트 전체를 다시 쓰지 말고 같은 대사를 따옴표 형식으로 재시도하는 편이 낫다.
non_diegetic_music: N/A만으로도 독립적인 제어가 된다. u/Nextil은 "다른 구조 대부분을 무시해도" 이 설정이 음악을 막는다고 보고했다. 다른 구조를 하나도 쓰지 않더라도 이 항목은 넣을 만하다. 인용된 보고에서 원치 않는 배경음악은 반복적으로 지적되는 문제다.
레퍼런스가 많을수록 텍스트는 줄여야 한다. 이미지가 정체성을 전달하고 영상이 움직임을 전달한다면, 프롬프트의 역할은 라우팅과 새 동작 지시로 줄어든다. @aimikoda의 가장 많이 공유된 템플릿 중 하나는 1,300개 이상의 북마크를 받았는데, სწორედ 이 이유로 최소한의 서술만 사용한다. @CharaspowerAI는 MiniMax의 Design agent가 "act as an expert FPV director and turn this into something viral"이라는 한 줄을 완전한 구조형 프롬프트로 자동 확장하는 모습도 시연했다. 레퍼런스 라우팅 블록은 이런 형태다.
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
그 다음 프롬프트는 새 샷만 설명하면 된다. 이 보고들에서 드러난 실용적인 작업 순서는 이렇다. 먼저 스틸을 확정하고, 레퍼런스가 대부분의 정보를 전달하게 둔 뒤, 바뀌는 요소에만 텍스트를 쓴다.
매뉴얼에 없는 실패 대응법
공식 프롬프팅 가이드는 문법에서 멈춘다. 생성 결과가 망가졌을 때 무엇을 해야 하는지는 알려주지 않는다. 아래 표는 앞서 살핀 실패 보고를 바탕으로 정리했다.
| 증상 | 추정 원인 | 대응 방법 |
|---|---|---|
N/A인데 음악이 추가됨 | 한 사용자는 실행의 약 20%에서 누출을 관찰했다 | 재생성하고, 프롬프트 어디에도 음악 "분위기"를 요청하지 않는다 |
| 엉뚱한 캐릭터가 대사를 말함 | 화자-오디오 라우팅 충돌 | 화자 ID를 화면에 보이는 캐릭터와 명시적으로 묶는다 |
| 화면 속 대사가 오프스크린 내레이션으로 읽힘 | 립싱크 연결 정보 누락 | 화자가 화면에 보인다고 명시하고, 실제 보이스오버라면 "lips remain closed"를 추가한다 |
| 오디오 레퍼런스가 무시됨 | 3클립 / 15초 제한 초과 또는 역할 미지정 | 각 클립의 역할을 배정하고 전체 레퍼런스 오디오 길이를 줄인다 |
| 로컬 모델이 중국어 대사를 무시함 | ComfyUI가 Qwen 토크나이저를 재사용했거나 셸 인코딩이 텍스트를 훼손함 | 리포지터리 토크나이저(공식 요구 사항) + 유니코드 안전 전송 + <d>[Chinese] 台词</d> 사용(커뮤니티 보고 해결책) |
| 긴 원테이크(>15초)가 무너짐 | 4–15초 설계 범위를 벗어나며 오브젝트가 평면화되고 연속성이 흔들림 | 15초 단위로 나누고 구간 사이의 연속성을 계획한다 |
로컬 배포 항목은 특히 다시 볼 필요가 있다. @eternityspring의 보고에서 "H3 won't speak Chinese" 문제는 프롬프트가 아니라 토크나이저 재사용과 인코딩에서 비롯됐다.
비용 문제: 토큰, 반복 작업, 이식성
구조화에는 비용이 든다. 공식 리포지터리는 재현 가능한 세 가지 사례의 Context-IR 토큰 사용량을 공개했으며, 레퍼런스 수가 늘수록 수치도 가파르게 증가한다.
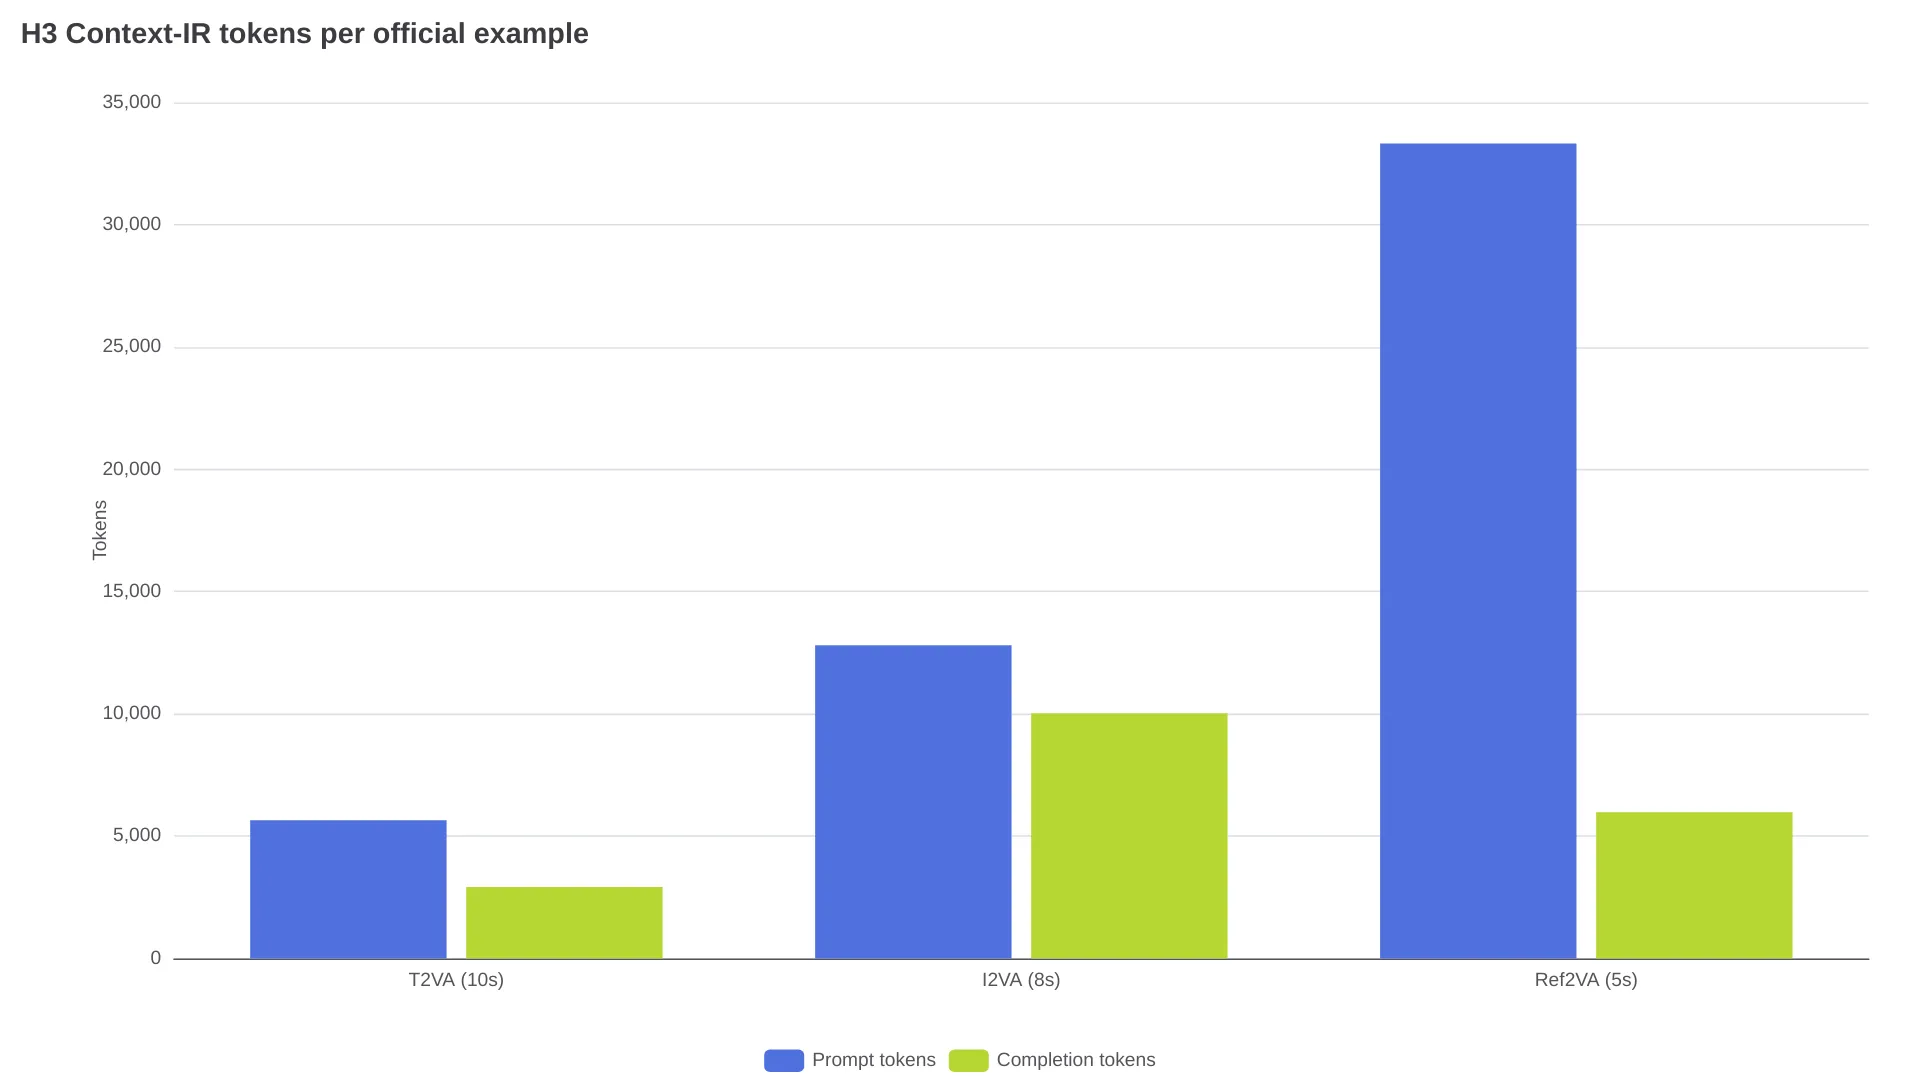
텍스트 전용 생성은 전처리에 8,565토큰을 소비한다. 멀티모달 레퍼런스 작업은 39,299토큰이며, 이 가운데 33,323토큰이 프롬프트 측에서 발생한다. 로컬 실행에서는 이 토큰이 전처리 지연을 늘리고, 생성 초당 가격으로 과금되는 호스팅 워크플로에서도 처리 오버헤드를 만든다. 시간 비용도 무시하기 어렵다. 한 X 제작자는 3인물 오비팅 카메라 프롬프트 하나를 완성하는 데 48시간을 썼다고 기록했다(@LoveUolanda). 반복 비용을 줄이는 방법은 간단하다. 6초 테스트가 약 $0.68인 768p에서 먼저 다듬고, 프롬프트가 확정됐을 때만 2K로 보낸다. 릴레이 모델 페이지에는 MiniMax H3 요금이 768p $0.1125/s, 2K $0.1825/s로 표시돼 있다.
마지막 숨은 비용은 이식성이다. H3의 필드, 화자 ID, 태그는 표준이 아니라 하나의 방언이다. 크로스 모델 비교 가이드에 따르면 Veo 3.1은 인라인 SFX: 라벨이 있는 일반 문단을 원하고, Seedance 2.0은 6슬롯 설명 형식을 사용한다. 둘 다 H3의 필드, 화자 ID, 태그를 받지 않는다. H3용 프롬프트 라이브러리는 다른 모델에서 복사해 붙이는 자산이 아니라 다시 써야 하는 초안이다.
MiniMax H3 프롬프트 리뷰 FAQ
MiniMax H3에서 구조형 프롬프트는 필수인가?
아니다. 호스팅 API에서는 Context-IR이 느슨한 자연어 요청을 내부 표현으로 재작성한다. 구조가 가장 중요한 경우는 로컬 오픈 웨이트 실행, 정확한 컷, 타임스탬프, 화자 라우팅이 필요한 작업이다.
MiniMax H3가 배경음악을 넣지 않게 하려면?
마지막에 non_diegetic_music: N/A를 넣고, 프롬프트 다른 곳에서 음악 분위기를 요청하지 않는다. 그래도 누출은 발생하므로 재생성은 일반적인 과정이다.
MiniMax H3 프롬프트는 어느 정도 길이가 적당한가?
MiniMax 공식 예시는 300–700단어이며, 순수 텍스트-투-비디오는 약 7,000자까지 허용한다. 다만 레퍼런스가 정체성과 움직임을 전달한다면 프롬프트는 길어지는 대신 짧아져야 한다.
H3 프롬프트를 Seedance나 Veo에서 재사용할 수 있나?
아니다. H3의 명명된 필드, 화자 ID, 태그는 모델 전용이다. Seedance는 6슬롯 형식을 쓰고 Veo는 일반 문단을 받으므로, 대상 모델마다 별도의 재작성본이 필요하다.
로컬 H3 배포 환경에서 비영어권 대사를 무시하는 이유는?
대개 모델이 아니라 도구 체인 문제다. Qwen 토크나이저를 재사용하거나 유니코드를 훼손하는 셸 환경은 생성 전에 대사를 망가뜨린다. 리포지터리의 공식 토크나이저와 <d>[Language] 대사 형식을 사용해야 한다.
결론: 누가 이 형식을 익혀야 하나
| 작업 유형 | 판정 |
|---|---|
| 대사가 있는 멀티샷 영상 | 전체 형식을 익힐 만하다. 오디오 재시도와 따옴표 대체안을 감안해야 한다 |
| 제품 / 스틸 이미지 애니메이션(I2VA) | 가벼운 버전을 익히면 된다. 정렬 문장 + 움직임 + 사운드 필드면 충분하다 |
| 스토리보드 또는 캐릭터 일관성 시리즈 | 추천한다. 레퍼런스가 대부분을 담당하므로 프롬프트는 짧고 라우팅하기 쉽게 유지한다 |
| 일회성 단일 클립, 가벼운 사용 | 대부분 건너뛰어도 된다. 일반 설명 + non_diegetic_music: N/A면 충분하다 |
| 하나의 크로스 모델 프롬프트 라이브러리 구축 | 추천하지 않는다. 모델마다 방언이 달라 모델별 버전을 작성해야 한다 |
멀티샷, 타임스탬프 기반, 레퍼런스 중심 작업이라면 이 형식을 익히는 편이 좋다. 이 영역에서는 준수도가 문서화되어 있고 재현도 가능하다. 반대로 일회성 클립에는 굳이 전체 형식을 쓸 필요가 없다. 대사 비중이 높은 오디오에서는 완벽한 복종보다 재시도를 예상하는 편이 현실적이다.
이 절충을 두고 커뮤니티의 의견은 정확히 갈린다. 같은 달에 한쪽에서는 48시간짜리 카메라 프롬프트 작업기가 나왔고, 다른 한쪽에서는 댓글 작성자가 "매뉴얼 읽는 일이 실제로 즐거웠다"고 쓴 880업보트 게시물도 나왔다. 모델의 오디오 필드 준수도가 카메라 제어 수준을 따라잡기 전까지 가장 실용적인 전략은 이렇다. 에이전트에게 구조 초안을 맡기고, 오디오 필드는 직접 검토하며, 2K에 들어가기 전에 768p에서 저렴하게 테스트하라.