 AIREITER
Claude Opus 5とGPT-5.6のSol、Terra、Lunaを、2026年7月29日に同一条件で比べた。4つのタスクに対し、4モデルから計16件の回答を取得した結果、正解は16件すべて。少なくとも今回の小規模な検証では、精度だけでモデルを選ぶ理由はなかった。
差がはっきり出たのは、実際にコストへ効く2点、すなわちトークン消費量と長文コンテキスト時の料金だ。Opus 5は1,642出力トークンを課金したのに対し、Solは480トークン。さらに入力が272,000トークンを超えると、GPT-5.6は上位の料金体系に切り替わる一方、Claude Opus 5は1Mトークンのコンテキストウィンドウ全域で単価が変わらない。入力200K・出力20Kのリクエストでは、両フラッグシップの定価差は7%以内だが、出力が増えるほど、また272Kをまたぐと差は広がる。結局は、リクエストの形とモデルの挙動で選ぶことになる。
4モデルに同じ4タスクを実行した
各モデルには、機械的に正誤判定できる4種類の問題を、まったく同じユーザープロンプトで与えた。バグを含むPythonのmedian関数の修正、固定文字列に含まれる文字数のカウント、3時15分の時計の針が作る7.5度の角度の計算、そして挙動を変えずに意図的に読みにくくしたJavaScript関数をリファクタリングする課題だ。コードについては見た目で判断せず、エッジケースを含めて実行し、結果を検証した。
結果は全モデル全問クリアだった。Pythonの修正はいずれも偶数個の要素を持つリストを正しく処理し、文字数と時計の問題では4モデルすべてが正解である9と7.5を返した。リファクタリング後のコードも、falsyなフィールドとnullのカテゴリフィルターを含む挙動差分テストを通過している。
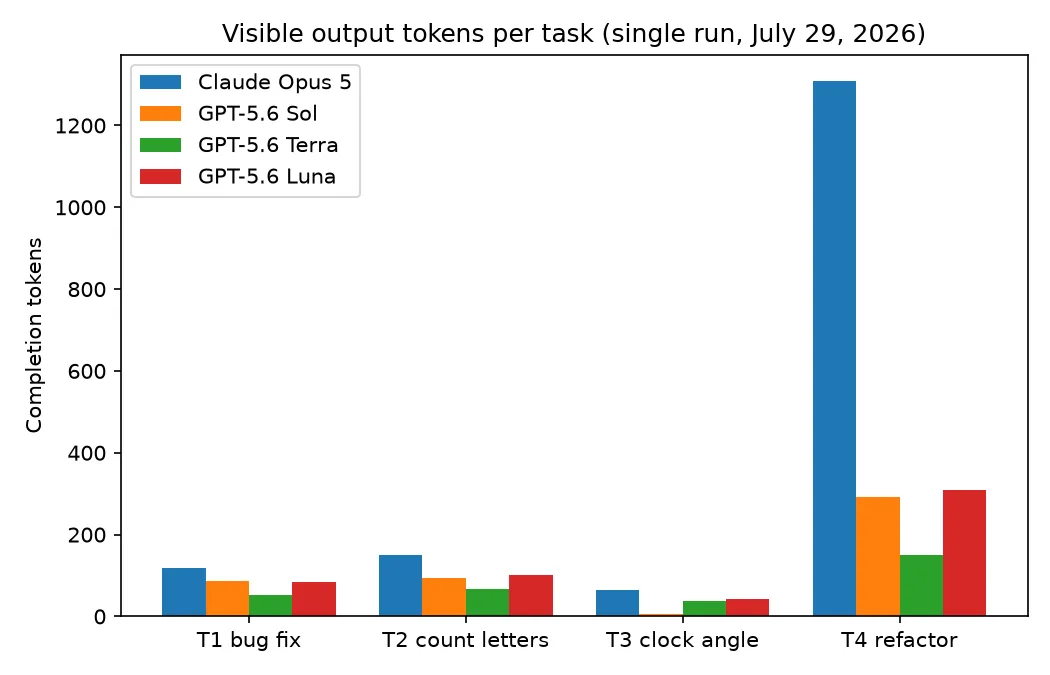
この数値を引用する前に、3つ留意点がある。これは各モデル・各タスクにつき1回だけの実行であり、ベンチマークではなくスモークテストだ。また、呼び出しには独自のシステムプロンプトを注入するゲートウェイを使用したため、入力トークンはリクエストごとに35〜4,415と大きく変動した。したがって入力トークンは比較対象から完全に外している。さらに両ベンダーとも、隠れた推論トークンを出力として課金する。このため、ここでいう「出力トークン」は画面で読める量ではなく、請求対象となる量を指す。
横並びの結果でも、質的な差は1つ残った。4モデルの中で最も良いリファクタリングを出したのはOpus 5だ。元コードの2つのループを1パスにまとめ、1.2倍の係数を名前付き定数に切り出し、挙動維持のため意図的に緩い等価比較を残していることもコメントで明記した。Sol、Terra、Lunaも正しいコードを返したが、より字義的な2ループ構成の変換だった。
正確さは横並び。違うのはトークン量と所要時間
16回の実行で正確性は同じだったため、実用上の比較軸は回答ごとのコストになる。Opus 5は4タスク合計で32.4秒、課金対象の完了トークンは1,642だった。Solは19.7秒・480トークン、Terraは11.7秒・308トークン、Lunaは15.3秒・537トークンである。
| 2026年7月29日の単発実行 | 正解数 | 出力トークン | 合計時間 | 出力のみのコスト |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1,642 | 32.4秒 | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19.7秒 | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11.7秒 | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15.3秒 | $0.0032 |
この差は最終回答の長さではなく、推論量によるものだ。Opus 5はリファクタリングで、最終回答が492バイトだったにもかかわらず1,308トークンを課金した。「7.5」と答える問題でも64トークンを使い、Solの7トークンを大きく上回った。Anthropicのドキュメントによると、Opus 5のAPIではデフォルトで高いeffortが設定される。この結果にはモデル固有の性質だけでなく、デフォルト設定も影響している。測定したのは下限値ではなく、初期設定での挙動だ。
コミュニティのデータも同じ傾向を示している。7月29日に確認した時点でこのクエリのGoogle検索結果の先頭に出たr/Anthropicのチャート投稿では、コーディングスコアは両者ほぼ同点だが、Opusは時間がかかり、消費トークンも明らかに多い。あるr/ClaudeCodeのユーザーは、これをもっと率直に表現していた。
GPT 5.6 Solは、頼んだことをすぐにやる。Opus 5は全12巻の「戦争と平和」を書いてから、頼んだことをやる。
ただし、effort設定次第で経済性は逆転し得る。Artificial Analysisのデータを読んだHacker Newsのコメント投稿者によれば、高effortのOpus 5はインテリジェンス指標1回あたり約$1.06、max設定のSolは$1.04だった。両モデルに強く推論させるなら、ほぼ同じ水準になる。
GPT-5.6は1モデルではない。Sol、Terra、Lunaの違い
GPT-5.6は単一モデル名ではない。OpenAIは3つのSKUを提供しており、指定子のgpt-5.6は、最も高価なgpt-5.6-solへのエイリアスとして文書化されている。設定にgpt-5.6とだけ書くと、このファミリーの最上位料金で課金される。コスト比較の前に確認しておきたい点だ。
OpenAIのモデルリファレンスでは、Solを「複雑な専門業務向けのフロンティアモデル」、Terraを「知能とコストのバランスを取る階層」、Lunaを「コスト重視のワークロード向けに最適化」と説明している。3モデルは1.05Mトークンのコンテキストウィンドウ、最大128K出力、2026年2月16日のナレッジカットオフ、そしてnoneからmaxまで6段階で選べる推論effortを共通で持つ。
| 仕様、2026年7月29日確認 | Claude Opus 5 | GPT-5.6(3モデル共通) |
|---|---|---|
| コンテキストウィンドウ | 1Mトークン | 1.05Mトークン |
| 最大出力 | 128K(Batch APIベータでは300K) | 128K |
| 信頼できるナレッジカットオフ | 2026年5月 | 2026年2月16日 |
| 推論の制御 | Adaptive thinking、effortのデフォルトはhigh | none / low / medium / high / xhigh / max |
| API ID | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
この表のうち、選定に実際に効くのは2項目だ。Opus 5のナレッジカットオフは2026年5月で、GPT-5.6ファミリー全体より3か月新しい。2026年春のリリースを参照する用途では、この差が意味を持つ。また推論制御は、単に選択肢の数が違うわけではない。GPT-5.6ならnoneを選び、推論を完全にオフにできる。一方のOpus 5は、思考予算を適応的に管理し、その上でeffortレベルを公開している。
料金比較:1Mまで定額のOpus 5と、272Kで上がるGPT-5.6
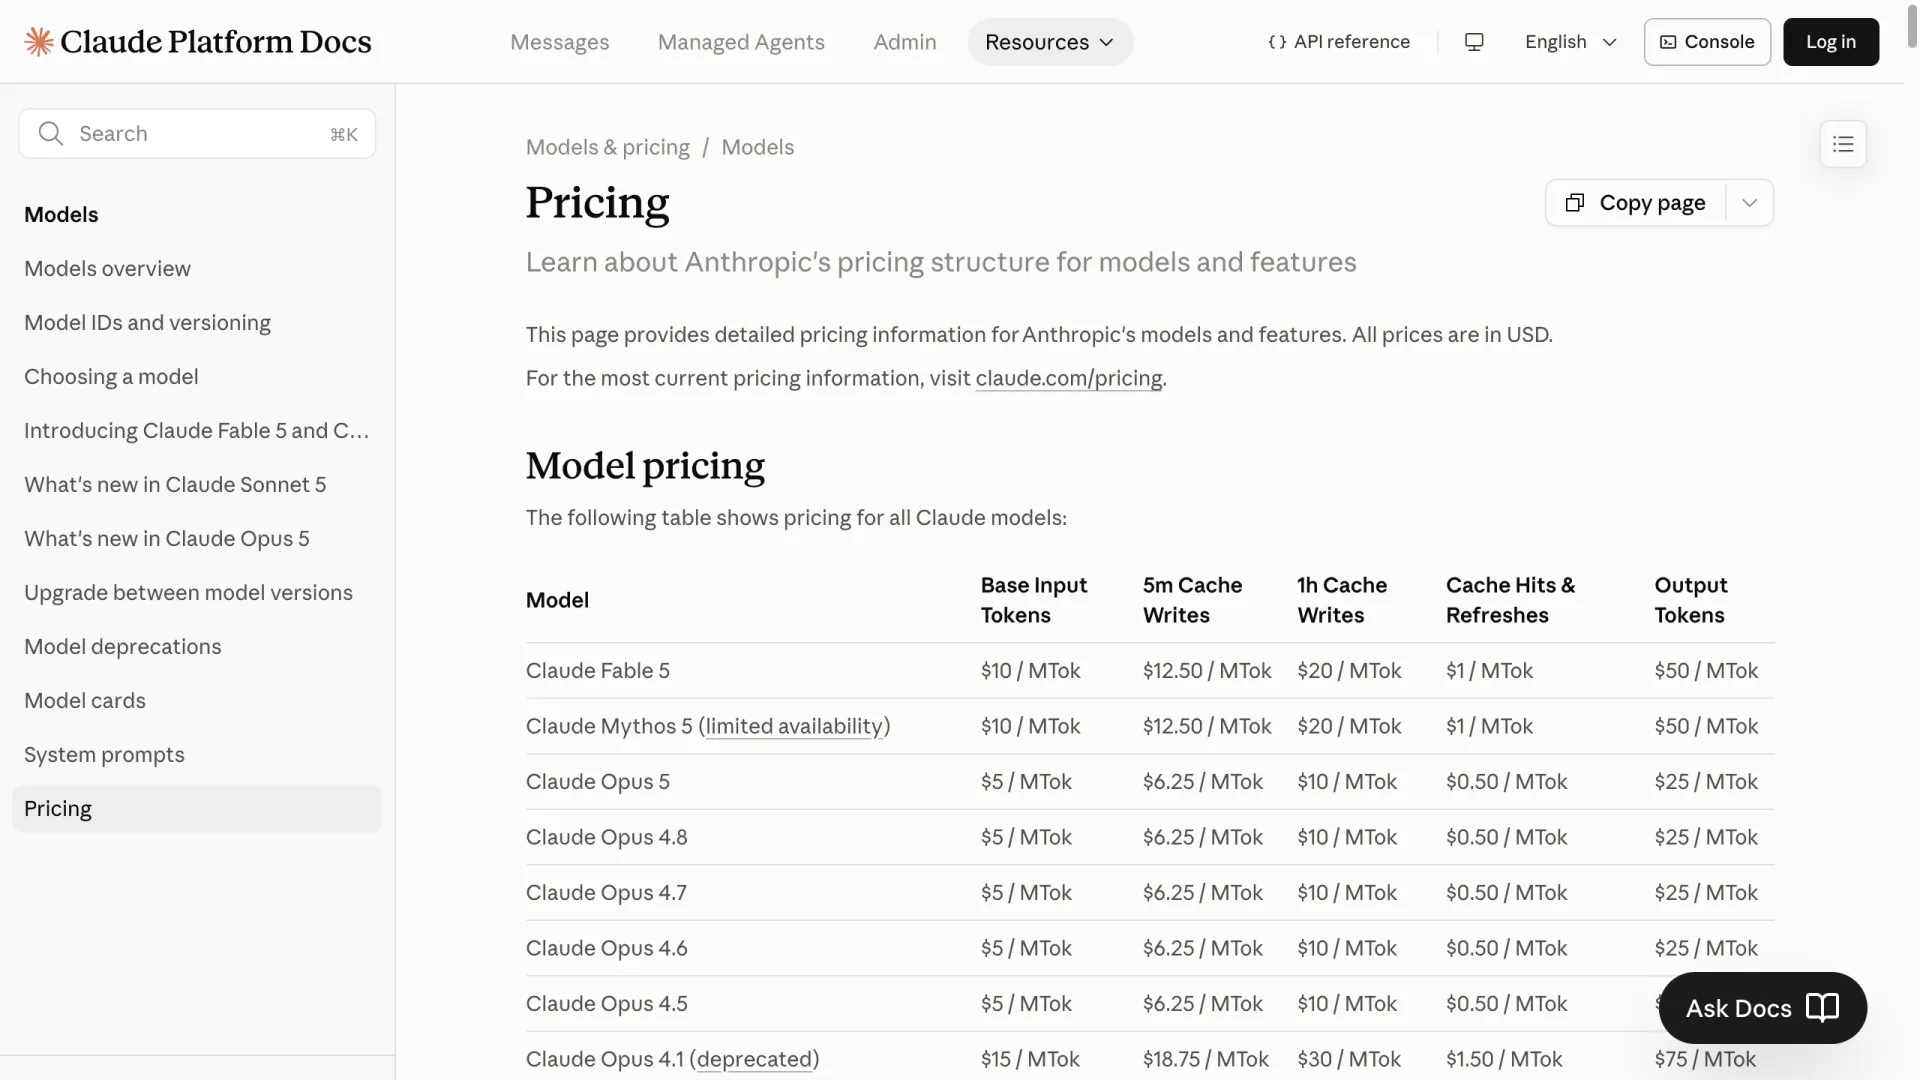
両社ともトークン単価を明快に公開しており、入力272Kトークン未満では差は小さい。両フラッグシップの入力は100万トークンあたり$5、キャッシュ済み入力はともに$0.50。出力はOpus 5が$25、Solが$30で、バッチ処理はいずれも50%割引となる。この単価で入力200K・出力20Kのリクエストを計算すると、Opus 5は$1.50、Solは$1.60だ。
| 100万トークンあたり、2026年7月29日の定価 | 入力 | キャッシュ済み入力 | 出力 | バッチ |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
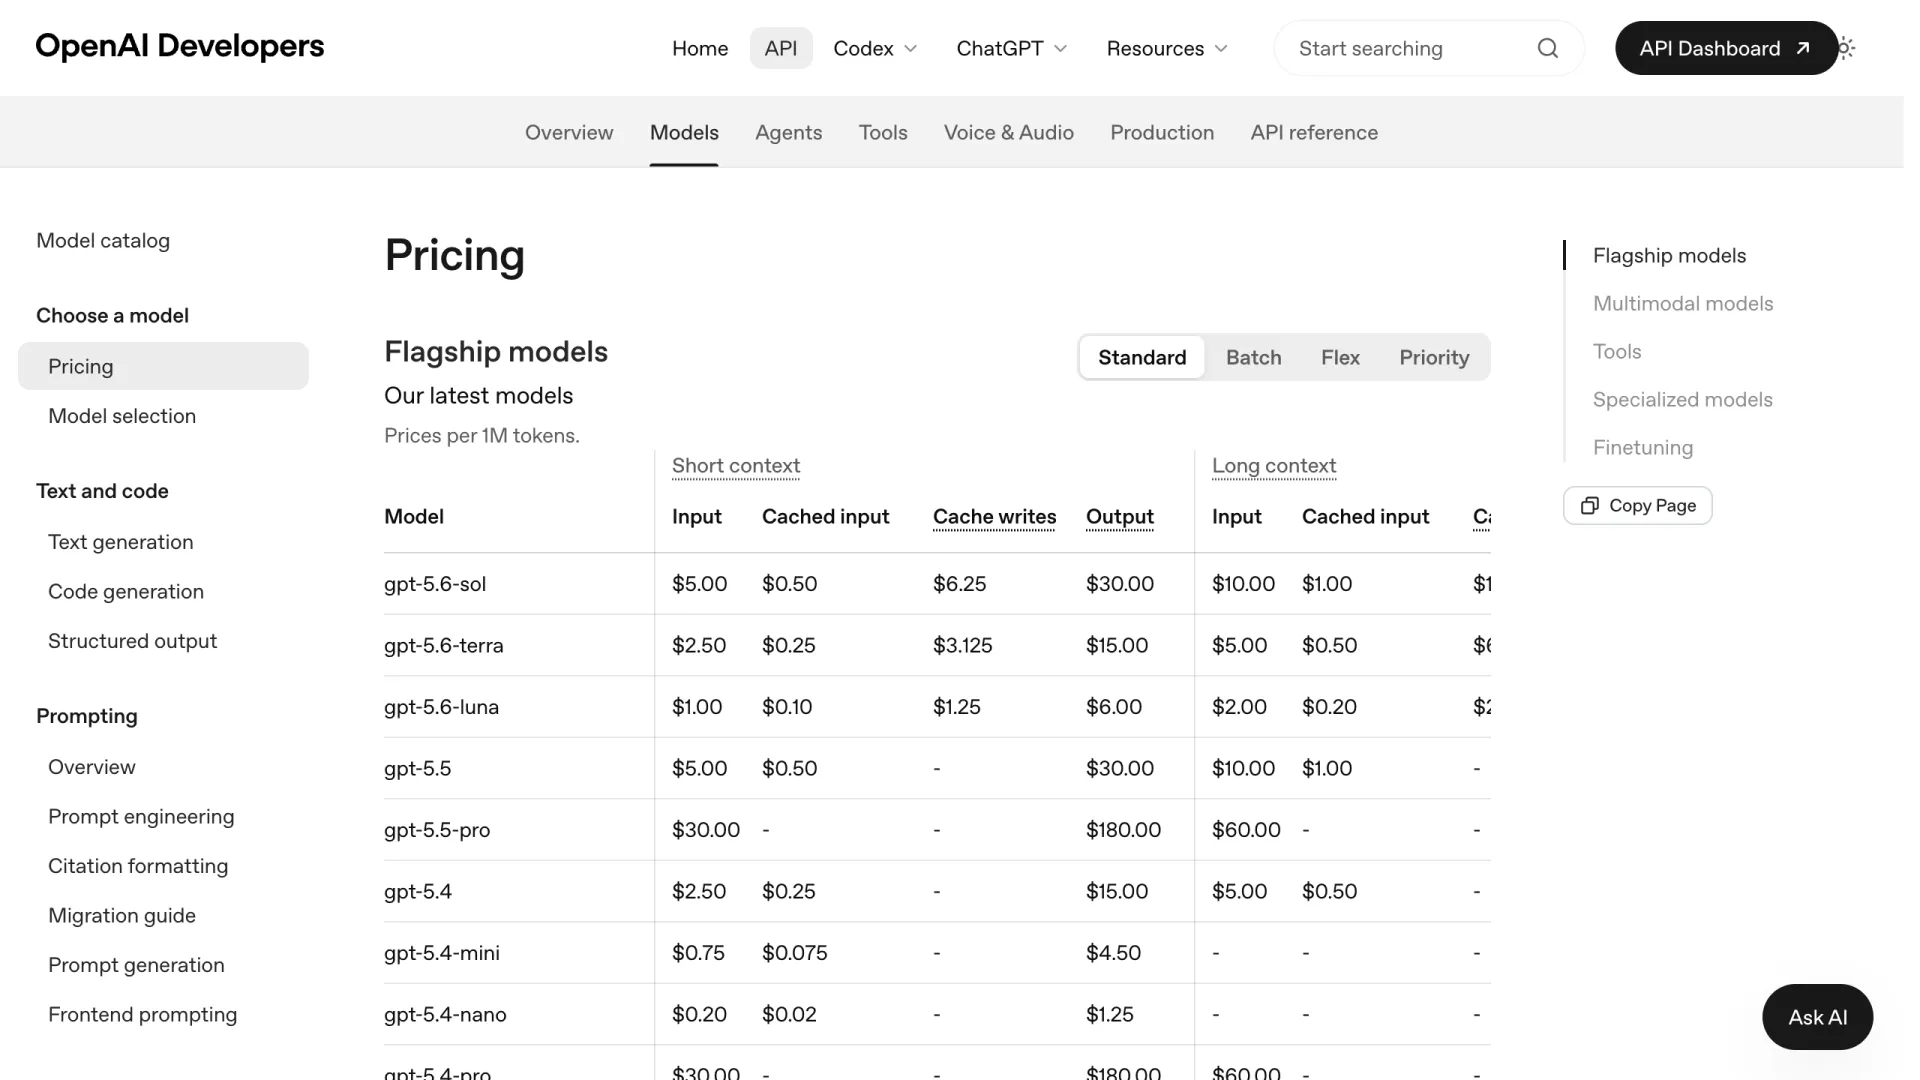
構造的な違いが現れる境目は、入力272Kトークンだ。OpenAIの料金ページでは、すべてのGPT-5.6のレートを短コンテキストと長コンテキストに分けている。入力272Kを超えると、入力料金は2倍、出力料金は1.5倍になり、Solは入力$10・出力$45となる。対照的に、Anthropicの料金ドキュメントは、「900kトークンのリクエストも9kトークンのリクエストも、トークンあたりの課金レートは同じ」としている。
出力を各ケース20Kとした場合、入力300KのリクエストはOpus 5が$2.00、Solが$3.90となる。入力500Kでは$3.00対$5.90、900Kでは$5.00対$9.90だ。この閾値を超えると、同じ形のリクエストでOpus 5はSolのおよそ半額で動く。
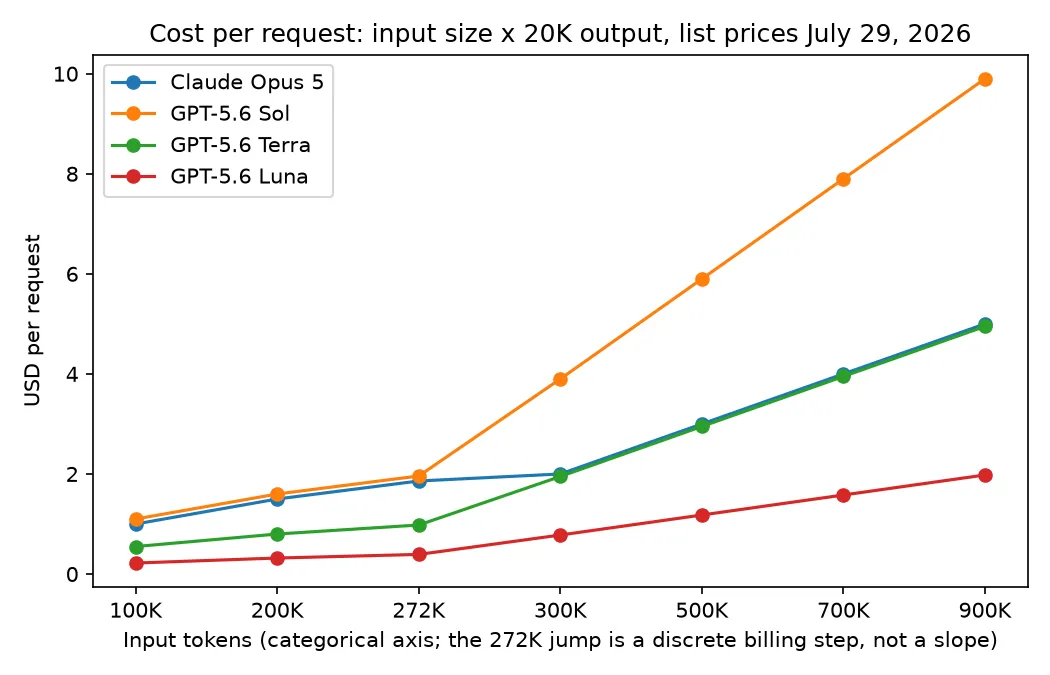
ただし、このグラフには「Anthropicの圧勝」とは言えない意外な点がある。272Kを超えるとTerraの2倍になった入力単価は$5となり、Opus 5と同額だ。さらにTerraの長コンテキスト出力単価は$22.50で、Opus 5の$25を下回る。出力20Kなら、入力300K、500K、700K、900KのいずれでもTerraのほうがリクエストあたり常に5セント安い。この5セントは入力サイズではなく出力量に応じて増え、出力100万トークンあたりの差額は$2.50となる。
予算を組む際には、さらに3つの注記がある。AnthropicはOpus 5の高速モードをリサーチプレビューとして提供しており、入力$10・出力$50。OpenAIの優先ティアは、短コンテキスト限定で標準料金の2倍だ。米国リージョンでのデータレジデンシーは、両社とも約10%の追加料金となる。またAnthropic自身の注記によれば、現在のClaudeトークナイザーは、同じテキストに対して4.7以前のモデルより約30%多くトークンを生成する。単価を掛ける前に、代表的なプロンプトを両方のトークナイザーに通して確認するのが、最も誠実な最終チェックだ。
用途別:どのモデルを呼ぶべきか
正確性が並んだ以上、ルーティングはリクエスト形状と作業スタイルで決めることになる。r/ClaudeCodeでは、Solをhigh effortでレビュー担当・QAエージェントとして使う開発者がいる。理由は、徹底した検証とブラウザー利用への強さだ。一方でr/codexには、ほとんどの作業をmedium reasoningの低価格GPTティアへ振り分け、そこで最高のコストパフォーマンスを得ているという報告もある。
| リクエストの形 | 推奨モデル | 理由 |
|---|---|---|
| 入力272K未満、出力の多いエージェントループ | Claude Opus 5 | 出力単価は$25対$30。今回の実行では最も優れたリファクタリング判断を示した |
| 入力272K未満、低レイテンシまたは大量処理 | GPT-5.6 Terra | テストで通過したモデルの中では最速かつ最安だった |
| 入力272K超 | Claude Opus 5またはTerra | Solの長コンテキスト料金は倍増。TerraはOpus 5より5セント安い |
| レビュー、QA、ブラウザーを使う検証 | GPT-5.6 Sol | レビューの深さを6段階のeffortで調整できる。自分のQAセットで検証すべき |
| 使い捨ての分類・抽出 | GPT-5.6 Luna | $1/$6で4つの検証をすべて通過した |
SolがQA向きという見方には異論もある。r/codexのあるスレッドでは、SolをGPT-5.5からの後退と評価する一方、Opus 5はプランあたりで完了できるタスク数が多いとしている。デフォルト設定は安価に検証できる。4モデルはいずれもAIReiterのカタログにあるため、Opus 5とSolで自分のタスクを横並びに再実行できる。
この比較から持ち帰るべき数字は、272,000入力トークンだ。これより下では、挙動、レイテンシ、出力単価の$5差で選ぶ。これを超えると、Solに対する価格面の優位はAnthropicにある。ただしTerraはOpus 5より5セント安く、Lunaは両者を大きく下回る。
FAQ
gpt-5.6はGPT-5.6 Solと同じモデル?
はい。OpenAIのモデルリファレンスでは、指定子gpt-5.6はgpt-5.6-solに解決されるエイリアスとして記載されている。そのためSolの料金で課金される。入力272K未満では100万トークンあたり入力$5・出力$30、272K超では$10・$45だ。
Claude Opus 5は長文コンテキストで料金が上がる?
上がらない。Anthropicは通常APIにおいて、1Mのコンテキストウィンドウ全体を標準単価で課金している。900Kトークンのリクエストも9Kのリクエストも、トークンあたりのコストは同じだ。追加料金がかかるのは任意の高速モードのみで、入力$10・出力$50となる。
Claude Opus 5とGPT-5.6、どちらが安い?
ティアによる。入力272K未満では、Opus 5の出力単価はSolより100万トークンあたり$5安く、それ以外の単価は同じ。TerraとLunaはどちらよりも大幅に安い。272Kを超えると、Opus 5のリクエスト単価はSolのおよそ半分になり、TerraはOpus 5よりわずかに安いまま推移する。
コーディングではClaude Opus 5のほうがGPT-5.6より優秀?
7月29日の実行では、両者とも修正、カウント、リファクタリングを正しく完了した。同日にこのクエリでGoogle検索結果の先頭に出たr/Anthropicのチャート投稿でも、コーディングスコアはほぼ同点だ。Opus 5は最も良いリファクタリング判断を示した一方、デフォルト設定ではSolの3.4倍の出力トークンを課金した。コーディング用途での選択は、経済性と冗長さの問題になる。
Opus 5とGPT-5.6のナレッジカットオフは?
AnthropicがClaude Opus 5に設定している信頼できるナレッジカットオフは2026年5月。GPT-5.6の3モデルはすべて2026年2月16日で、約3か月前となる。