 AIREITER
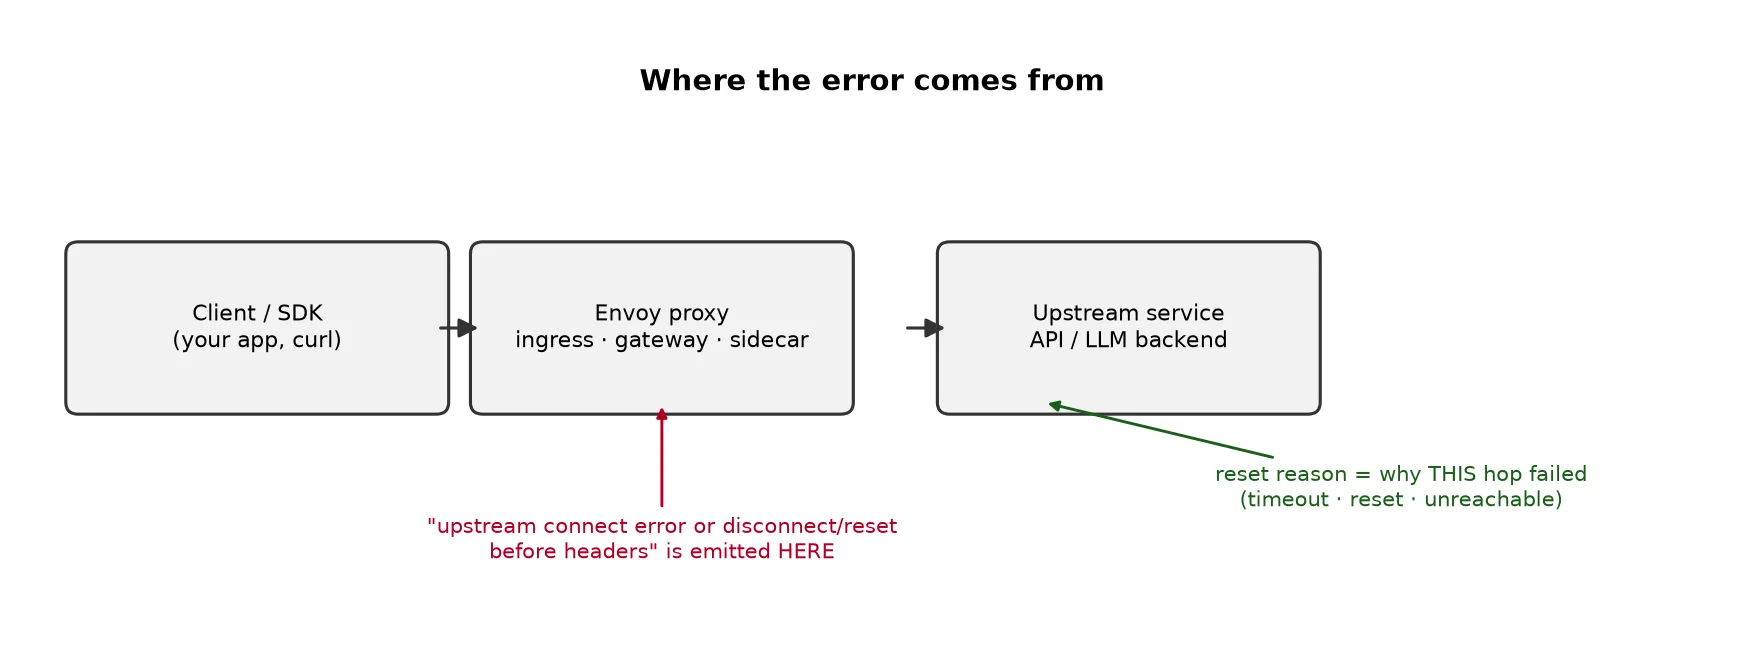
Vedi upstream connect error or disconnect/reset before headers su ChatGPT o nelle chiamate all'API OpenAI? Il problema è lato OpenAI. Il messaggio è generato da Envoy, il proxy sul perimetro dell'infrastruttura OpenAI, e segnala che non è riuscito a ottenere una risposta utilizzabile dal backend. Sul sito di ChatGPT compare spesso come Error Code 111. La parte successiva a reset reason: contiene la diagnosi effettiva; before headers, invece, indica che il proxy ha rinunciato prima di ricevere anche un solo header di risposta. Quel 503, quindi, non nasconde una risposta applicativa: è la risposta di Envoy stesso. Non puoi intervenire sull'infrastruttura di OpenAI, ma il passo successivo cambia in base al reset reason e al fatto che l'errore compaia nel browser oppure nel codice.
In quale caso ti trovi:
- ChatGPT sul web o nell'app: controlla status.openai.com, poi ricarica la pagina o avvia una nuova sessione.
- API OpenAI nel codice: leggi il reset reason, registra il request ID e applica una strategia di retry.
Cosa indica davvero questo errore
Envoy si trova tra il tuo client e il backend di OpenAI. Quando arriva una richiesta, apre una connessione al backend, inoltra la richiesta e attende gli header della risposta. Se la connessione fallisce, viene reimpostata, scade oppure incontra un limite di capacità prima che arrivino gli header, Envoy restituisce questo messaggio con HTTP 503, talvolta 502. Può comparire nelle schermate di disservizio di ChatGPT, negli stack trace di openai.InternalServerError e nei log degli agent.
La formulazione può cambiare: retried and the latest reset reason significa che Envoy ha già eseguito dei tentativi e che il fallimento riguarda l'ultimo. In ogni caso, è il proxy di OpenAI a segnalare che il proprio backend non ha risposto: non dipende dal prompt né dal body della richiesta.
Come leggere il reset reason
Il reset reason chiarisce cosa ha incontrato il proxy di OpenAI e, di conseguenza, se vale la pena ritentare.
| reset reason | Cosa ha rilevato il proxy OpenAI | Cosa fare |
|---|---|---|
connection timeout | Il backend è stato troppo lento ad accettare la connessione | Riprova con backoff e controlla lo stato del servizio |
overflow | È stato raggiunto un limite di capacità o di rate limit, con backend sovraccarico | Riduci la concorrenza, applica backoff e riprova |
connection failure / remote connection failure | Il backend non è raggiungibile o ha rifiutato la connessione | Riprova; se persiste, verifica lo stato e segnala il problema |
connection termination / connection reset | Il backend ha chiuso la connessione durante la richiesta | Riprova; di solito coincide con un incidente |
protocol error | Un problema di protocollo lato OpenAI | Riprova; se continua, segnala il caso includendo il request ID |
overflow e connection timeout sono i due motivi riportati più spesso dalla community OpenAI, un quadro coerente con un backend che raggiunge la capacità sotto carichi improvvisi. Nessuno di questi casi si risolve modificando qualcosa sul tuo computer: le azioni utili sono controllare lo stato del servizio, usare il backoff e prevedere il failover.
Su ChatGPT web o app: Error Code 111
Per prima cosa apri status.openai.com. Se è segnalato un incidente, la soluzione principale è attendere che rientri, anche se un errore persistente legato a uno specifico account merita una segnalazione al supporto. Se lo stato risulta regolare, ricarica la pagina, apri una nuova scheda oppure esci e accedi di nuovo: una sessione non aggiornata può mantenere una connessione ormai inutilizzabile. Cambiare rete o disattivare una VPN o un proxy aziendale aiuta solo se è proprio quel livello a reimpostare la connessione; vale la pena verificarlo prima di attribuire il problema a OpenAI.
Gestire l'errore nell'API OpenAI
Con l'API si tratta di un errore intermittente e dipendente dal carico. Uno sviluppatore nel tracker delle issue di openai-python ha riportato fallimenti in circa il 5% delle chiamate, con openai.InternalServerError: upstream connect error or disconnect/reset before headers, mentre effettuava centinaia di richieste all'ora; il restante 95% andava a buon fine. Un tasso di errore parziale di questo tipo indica una possibile saturazione del backend. I job ad alto volume, come embeddings in blocco o importazioni di documenti di grandi dimensioni, ci incappano più facilmente perché aumentano la concorrenza. In genere serve una policy di retry, non una modifica del payload; ad alto carico, però, contano altrettanto la gestione della concorrenza e l'accodamento dei job bulk.
Prima di aprire una segnalazione, raccogli elementi sufficienti a dimostrare che il problema è lato provider: timestamp, endpoint e modello, stato e body HTTP, x-request-id, versione dell'SDK, numero di richieste in corso e l'eventuale corrispondenza tra i fallimenti e un incidente pubblicato. Poi applica una strategia di retry adatta alla produzione:
import random, time
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI()

def with_retry(fn, max_attempts=5, cap=30.0):
    for attempt in range(max_attempts):
        try:
            return fn()
        except (APIConnectionError, APIStatusError) as e:
            status = getattr(e, "status_code", None)
            # retry connection drops and 5xx (incl. this 503); never blindly retry 4xx
            if isinstance(e, APIStatusError) and status and status < 500 and status != 429:
                raise
            if attempt == max_attempts - 1:
                raise
            retry_after = float(getattr(e, "response", None).headers.get("retry-after", 0)) if getattr(e, "response", None) else 0
            backoff = retry_after or min(cap, 0.5 * 2 ** attempt) * (0.5 + random.random())
            time.sleep(backoff)
Gli SDK OpenAI ritentano già in autonomia gli errori transitori, tramite max_retries con valore predefinito 2. Imposta quindi questo comportamento in modo esplicito, per esempio con OpenAI(max_retries=0), prima di avvolgere le chiamate nella tua logica; altrimenti i retry del tuo livello e quelli dell'SDK si sommano. Limita sia i tentativi complessivi, 3–5, sia la concorrenza generale, così i retry non amplificano il picco che ha provocato overflow. Per il codice 429, rispetta Retry-After; ritenta 408/409 soltanto quando l'operazione può essere ripetuta in sicurezza. Fai particolare attenzione alle chiamate non idempotenti o in streaming: un retry indiscriminato può duplicare il lavoro o riprodurre uno stream già consumato a metà.
Come si manifesta dal lato client
Spesso non vedrai nemmeno il body 503 di Envoy, perché la connessione si interrompe prima. Un curl -v verso un endpoint non funzionante restituisce curl: (52) Empty reply from server dopo Request completely sent off: la richiesta è partita, ma non è arrivata alcuna risposta. Nella variante restituita da Envoy, invece, il server risponde con un 503 che contiene nel body il testo upstream connect error.... Anche le segnalazioni pubbliche coincidono: nel subreddit di OpenAI un utente ha pubblicato l'esatta stringa retried and the latest reset reason: connection timeout insieme a "Network connection lost", mentre il tracker di openai-python riporta lo stesso messaggio come InternalServerError con volumi di richieste elevati.
Quando conviene usare un percorso alternativo
Poiché il passaggio che fallisce è quello tra il gateway OpenAI e il suo backend, su un singolo endpoint puoi solo ritentare e applicare backoff. L'altra opzione è la ridondanza: passare da un livello che effettua il failover verso un backend diverso quando un upstream va in timeout o raggiunge overflow. Gateway multi-provider come OpenRouter e AIReiter espongono più provider di modelli e possono aggirare quello rallentato, secondo lo stesso modello di routing multi-provider su cui è costruito OpenRouter. Un singolo upstream lento può così tradursi in un rerouting anziché in un 503 visibile al client. Il compromesso è concreto: un hop aggiuntivo, la dipendenza dalla disponibilità del router e differenze da valutare in termini di prezzi, gestione dei dati e osservabilità. In cambio, si riduce l'esposizione all'instabilità di un singolo provider.
FAQ
Cos'è ChatGPT Error Code 111?
Alcuni utenti di ChatGPT vedono questo messaggio accompagnato dall'etichetta "Error Code 111". Significa che il proxy di OpenAI non è riuscito a ottenere una risposta dal backend: è un problema lato server. Controlla status.openai.com e ricarica la pagina.
Perché capita solo sotto carico o in modo casuale?
I fallimenti legati al carico indicano in genere overflow, cioè un limite di capacità o rate limit, oppure un backend saturo che porta i tempi di connessione oltre il timeout. Entrambe le condizioni emergono quando sale la concorrenza, ed è per questo che lo stesso codice funziona nella maggior parte dei casi.
Una VPN o il firewall possono provocarlo?
Sì, ma solo se è quel livello a reimpostare la connessione tra te e OpenAI. Conviene escluderlo cambiando rete, ma non risolverà un vero disservizio OpenAI né un 503 lato API.
È lo stesso problema di un rate limit 429?
No. Un 429 è una risposta esplicita di rate limit che hai effettivamente ricevuto. Questo 503 segnala invece che non è arrivata alcuna risposta utilizzabile. Con un 429 rispetta Retry-After; con il 503 applica backoff e riprova.
Cosa significa "retried and the latest reset reason"?
Envoy ha già ritentato la richiesta e questo è il motivo per cui l'ultimo tentativo è fallito. Indica un problema persistente del backend lato OpenAI, non un inconveniente isolato.