 AIREITER
Seed Audio 1.0 merita una prova se produci contenuti audio brevi in inglese o cinese, ma al momento la strada più concreta passa da un gateway di terze parti e non dall'API ufficiale. Il modello di ByteDance costruisce da un solo prompt una scena sonora completa, con dialoghi, musica di sottofondo ed effetti; il vero elemento distintivo è proprio la capacità di gestire conversazioni con più voci e mix musicale nello stesso output, anziché limitarsi a TTS o musica. Restano però tre vincoli importanti: ogni generazione arriva al massimo a due minuti, le lingue supportate sono soltanto inglese e cinese, e l'API ufficiale è ancora accessibile solo su invito, senza un listino pubblico. Vediamo cosa significa nella pratica.
Cos'è davvero Seed Audio 1.0
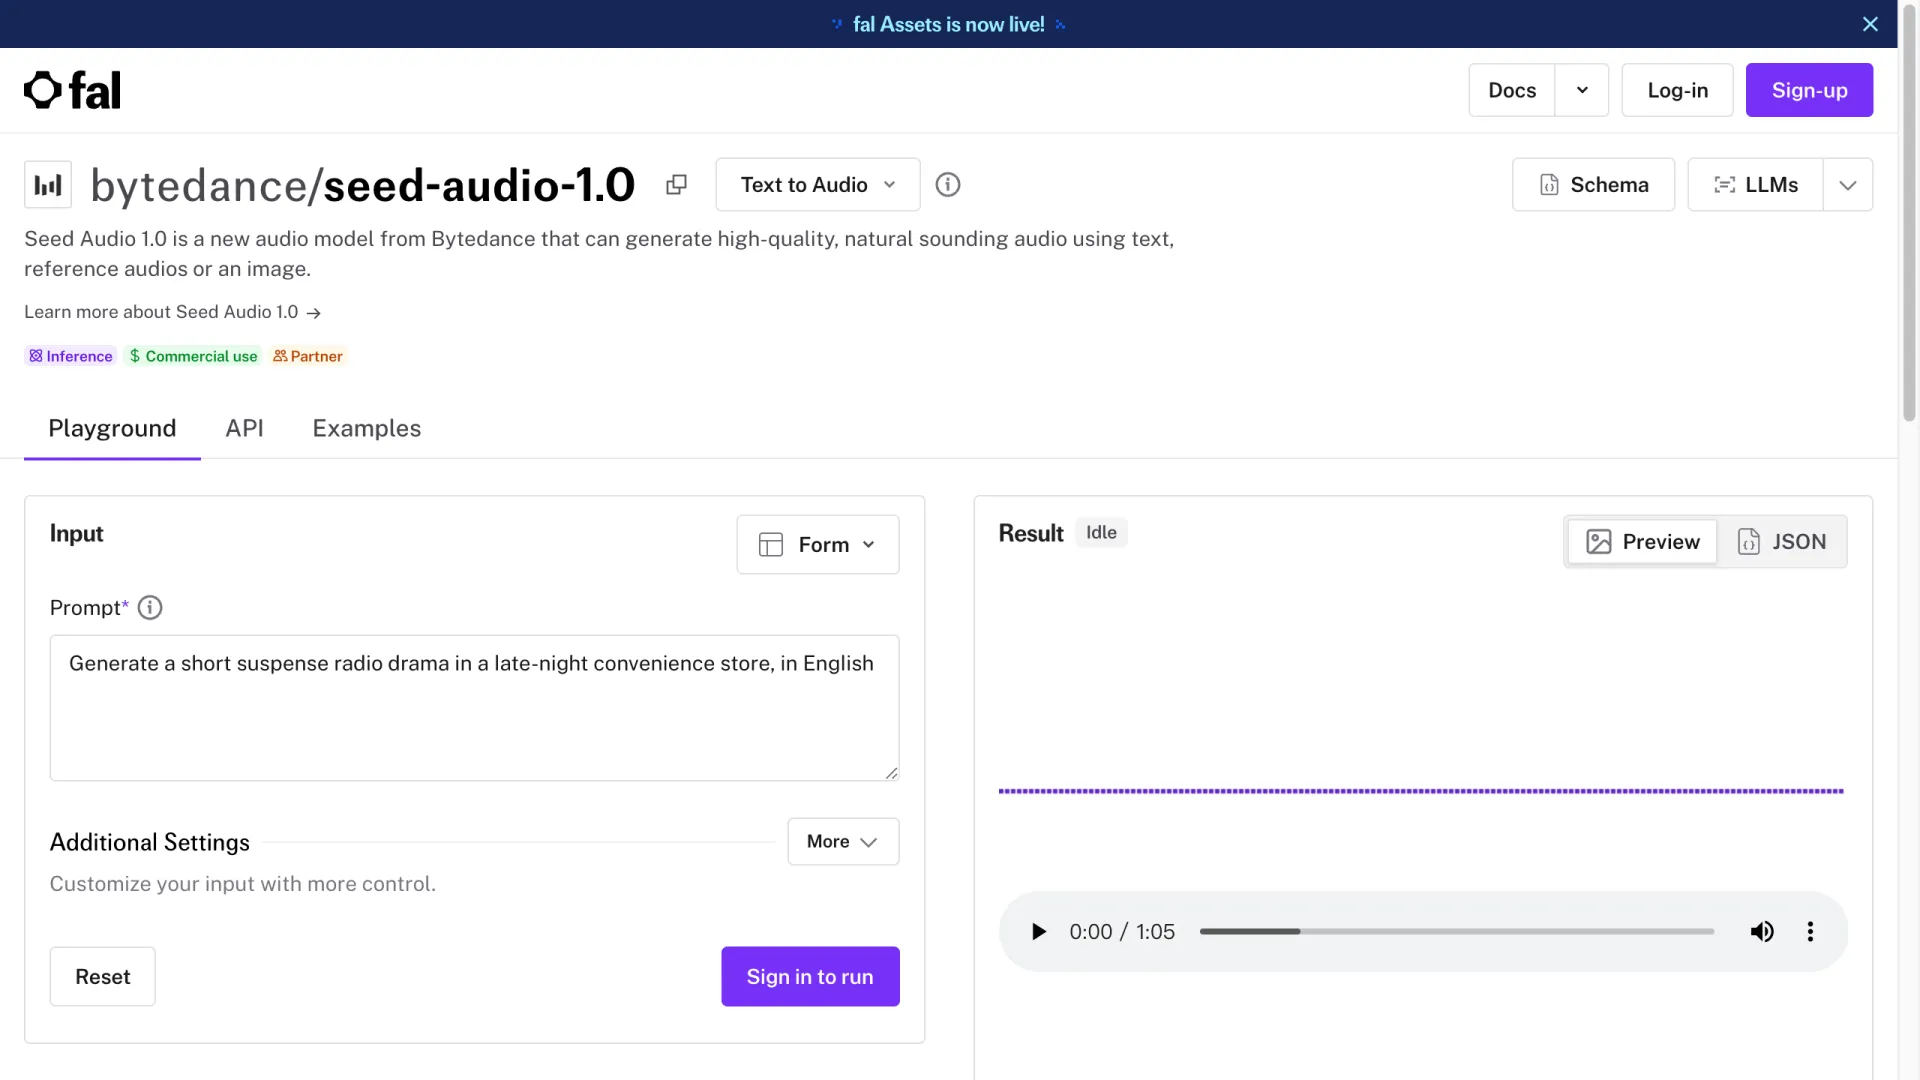
La maggior parte degli strumenti audio generativi svolge un compito solo: sintesi vocale, musica oppure effetti sonori. Seed Audio 1.0, il cui nome completo è Doubao-Seed-Audio 1.0, riunisce invece tutti e tre gli elementi su un'unica timeline, in un solo passaggio. Basta un prompt come "un radiodramma thriller in un minimarket a tarda notte" per ottenere un file già completo di battute, suoni ambientali e base musicale mixata.
Il modello funziona in tre modalità. Text-to-audio (T2A) crea una scena da una descrizione scritta. Text-and-audio-to-audio (TA2A) combina clip di riferimento e testo, permettendo di indirizzare voce e stile. Il TTS classico, infine, serve per una semplice narrazione quando occorre soltanto parlato pulito. La modalità dipende quindi dal materiale fornito in input.
Vale la pena chiarire un aspetto: è uno strumento per il clonaggio vocale? Seed Audio 1.0 può far interpretare più ruoli alla stessa voce e riprendere il tono di una clip di riferimento, ma genera un risultato sintetico, non vincolato all'identità di uno specifico speaker reale. È più corretto considerarlo zero-shot voice styling, non un clone senza consenso di una persona nominata. Si basa sulle precedenti ricerche ByteDance Seed-TTS e Seed-Music: ecco perché espressività del parlato e generazione musicale convivono nello stesso modello.
Specifiche: i limiti da verificare prima di usarlo
Prima di tutto bisogna capire se il caso d'uso regge i limiti tecnici. Questi sono i dati più rilevanti, verificati incrociando le schede del modello su fal ed EvoLink:
| Specifica | Valore |
|---|---|
| Durata massima per generazione | 120 secondi (2 minuti) |
| Limite del prompt testuale | ~1.500–2.000 caratteri (le fonti differiscono; verificare nella console) |
| Audio di riferimento | Fino a 3 clip, ciascuna ≤30 secondi |
| Lingue | Solo inglese e cinese |
| Formati di output | WAV, MP3, PCM, OGG Opus |
| Frequenze di campionamento | 48K / 24K / 16K / 8K |
| Controlli | Velocità, intonazione, volume (senza SSML) |
| Modello di fatturazione | Basato sulla durata dell'output |
Il limite di due minuti è quello che pesa di più. Un episodio podcast completo o una narrazione lunga richiedono di dividere il copione e ricucire le sezioni, con il rischio di variazioni di tono tra un blocco e l'altro. Le note del modello su fal indicano un aggiornamento previsto che dovrebbe portare la durata della singola generazione verso i dieci minuti, aggiungendo il controllo esplicito della lunghezza e un supporto linguistico più ampio: se lavori soprattutto sul long-form, può valere la pena aspettare.
Prezzi: cosa si sa finora
Per ora non esiste un prezzo ufficiale. A luglio 2026, Volcengine non ha pubblicato una tariffa al secondo per Seed Audio 1.0: il modello resta solo su invito su Volcano Ark, e i prezzi ufficiali arrivano di norma con la disponibilità generale. Anche gateway come fal ed EvoLink non fissano una tariffa rigida: fatturano in base alla durata dell'output (costo = secondi generati × tariffa), quindi anche i tentativi ripetuti incidono. Meglio ignorare le cifre basate sui token che circolano online: la fatturazione a token non è coerente con un modello audio tariffato sulla durata.
Come ottenere accesso oggi
Le strade sono due, ma nella pratica sono molto diverse.
Il canale ufficiale è Volcano Ark, dove Seed Audio 1.0 è disponibile solo su invito. Bisogna fare domanda, attendere l'abilitazione e usare la console di ByteDance: sarà la fonte di riferimento quando arriveranno disponibilità generale e prezzi.
L'alternativa pratica è un gateway di terze parti. fal ospita il modello come bytedance/seed-audio-1.0 senza whitelist: con una normale chiave API è possibile chiamare l'endpoint. EvoLink offre un accesso simile. È il modo in cui oggi la maggior parte degli utenti può generare con il modello senza aspettare un invito.
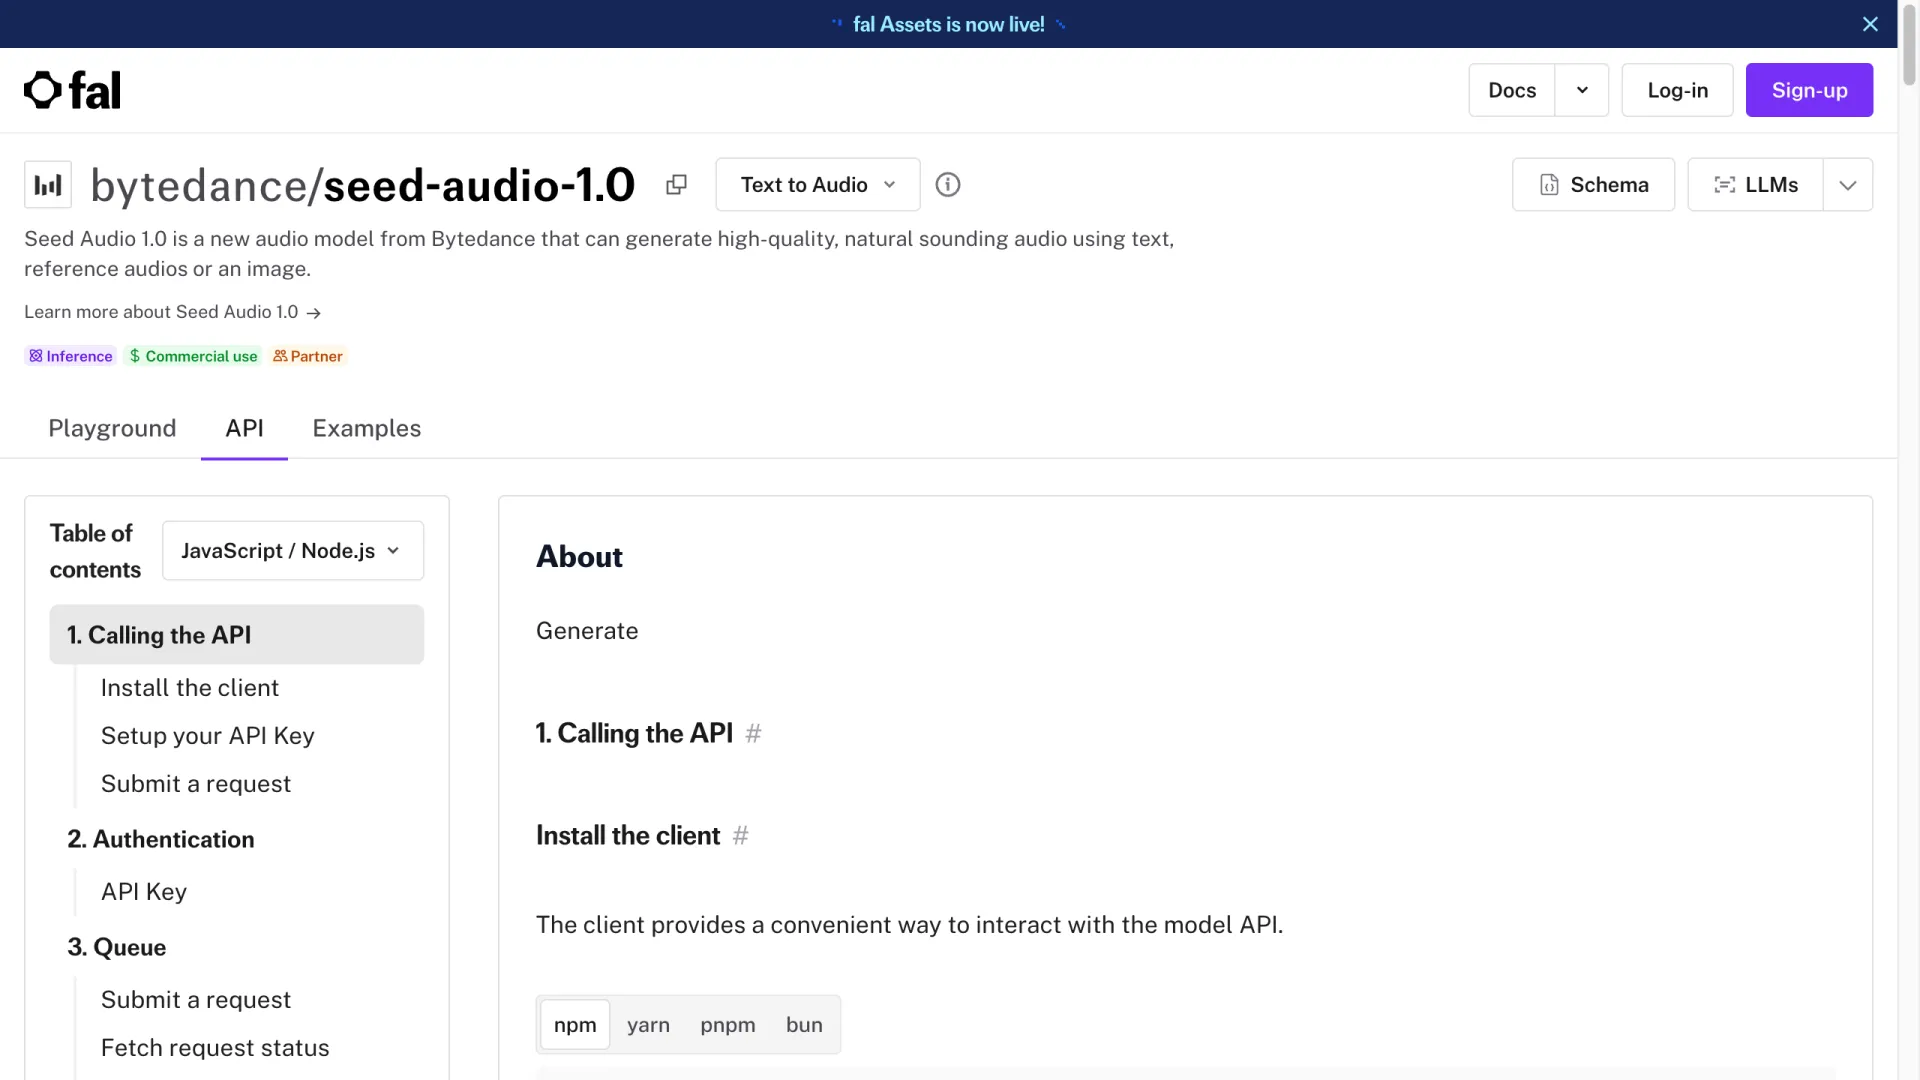
Il flusso di chiamata segue il classico schema API con coda: si installa il client, si imposta la chiave, si invia il prompt e si interroga il risultato. Chi ha già integrato un modello generativo ospitato con questo approccio non dovrà imparare nulla di nuovo; la nostra recensione di fal.ai approfondisce l'esperienza lato sviluppo.
Un buon primo test è una breve scena con più speaker, capace di mettere alla prova insieme dialoghi, ambiente e ritmo: per esempio, "un radiodramma thriller di 30 secondi in un minimarket a tarda notte, inglese". Conviene restare sotto i 30 secondi per la prima clip: se il risultato non funziona, il costo dell'esperimento rimane contenuto mentre si impara a interpretare il comportamento del modello rispetto al prompt.
Seed Audio 1.0 contro ElevenLabs, Stable Audio e AudioCraft
Il confronto utile non riguarda tanto la qualità di ogni singola clip, quanto il tipo di lavoro per cui ciascuno strumento è progettato.
| Strumento | Punto di forza | Mix della scena | Lingue | Controllo della voce |
|---|---|---|---|---|
| Seed Audio 1.0 | Scene audio complete (parlato + musica + SFX) | Sì, in un passaggio | EN, CN | Styling zero-shot |
| ElevenLabs | Parlato e clonaggio vocale | Solo parlato | 30+ | Clonaggio più avanzato |
| Stable Audio | Generazione di musica e suoni | Traccia singola | N/D (musica) | Basato su prompt |
| AudioCraft | Musica/SFX open source | Traccia singola | N/D (musica) | Basato su prompt |
Se serve il miglior parlato puro o un clonaggio vocale preciso in molte lingue, ElevenLabs resta la scelta migliore. Per musica autonoma, Stable Audio o AudioCraft di Meta sono strumenti nati per quello scopo. Il vantaggio di Seed Audio 1.0 è invece l'unione di dialoghi, musica ed effetti in una sola scena coerente e modificabile: nessun altro strumento qui elencato ci riesce con una singola chiamata.
Dove eccelle e dove mostra i limiti
Punti di forza: Il richiamo principale sono i dialoghi multi-speaker e il mix di musica ed effetti in un solo passaggio. Inoltre, i flussi di editing documentati — estendere una clip, intervenire in in-painting su una sezione, unire diverse take, secondo la guida d'uso di fal — lo rendono uno strumento da produzione, non un semplice generatore one-shot.
Limiti: Il tetto di due minuti obbliga a unire segmenti per qualsiasi contenuto lungo. Il supporto esclusivo per inglese e cinese esclude gran parte del lavoro vocale internazionale. È un modello di generazione offline, quindi non è adatto agli agent vocali in tempo reale. Inoltre, l'accesso ufficiale resta vincolato a un invito.
Vale già la pena usarlo?
Se i tuoi contenuti sono in inglese o cinese e appartengono al formato breve — doppiaggi, estratti di audiolibri, colonne sonore per video brevi, prototipi di radiodrammi — Seed Audio 1.0 vale una prova oggi attraverso un gateway. Generare l'intera scena in un passaggio elimina il lavoro manuale di sovrapporre parlato, musica ed effetti.
Se invece servono interazioni in tempo reale, una lingua non supportata oppure audio lungo e ininterrotto, meglio aspettare. La disponibilità generale e il previsto aggiornamento della durata cambieranno i termini del confronto; nel frattempo, un modello real-time come Qwen Audio 3 è più adatto ai casi d'uso live. Per tutti gli altri, questo è il momento di "testarlo tramite un gateway mantenendo attivo lo stack attuale", non di sostituire tutto.
FAQ
Seed Audio 1.0 è gratuito?
No. Non esiste un piano ufficiale gratuito: l'API Volcano Ark è solo su invito e, una volta ottenuto l'accesso, la fatturazione è basata sulla durata dell'output. I gateway di terze parti applicano le rispettive tariffe a consumo.
Seed Audio 1.0 può clonare la mia voce?
Può imitare lo stile di una clip di riferimento e far interpretare più ruoli a una voce, ma produce parlato sintetizzato anziché un clone vincolato a una persona reale specifica. Non va considerato uno strumento sostitutivo per il clonaggio dell'identità vocale.
Quali lingue supporta Seed Audio 1.0?
Al lancio supporta soltanto inglese e cinese. Secondo le note del modello di fal, un aggiornamento previsto aggiungerà un supporto multilingue più ampio.
Quanto può durare l'audio generato?
Oggi fino a 120 secondi per generazione. L'aggiornamento previsto porta la durata della singola generazione verso i dieci minuti, con controllo esplicito della lunghezza.
Esiste un'API ufficiale per Seed Audio 1.0?
Sì, su Volcano Ark di Volcengine, ma per ora è accessibile solo su invito. Per un accesso aperto senza whitelist, si può usare un gateway come fal, che ospita bytedance/seed-audio-1.0.
Che differenza c'è tra Seed Audio e Seed Music?
Seed-Music era la precedente ricerca di ByteDance focalizzata sulla musica; Seed Audio 1.0 integra quella capacità musicale con parlato ed effetti sonori in un unico modello per la generazione di scene.