 AIREITER
Qwen Audio 3.0 Realtime porta nella gamma Qwen conversazioni vocali realmente bidirezionali: parli al modello, lui risponde a voce con una latenza abbastanza bassa da ricordare una telefonata. Sulla piattaforma Alibaba, questa capacità arriva tramite l'API Realtime Qwen3-Omni / Qwen3.5-Omni (con ID modello come qwen3-omni-flash-realtime), affiancata da Qwen-TTS-Realtime per il solo text-to-speech e da qwen3-asr-flash per la trascrizione. I modelli omni Realtime ospitati riconoscono oltre 100 lingue, supportano il full-duplex con interruzioni e hanno un costo di conversazione nell'ordine di una frazione di centesimo al minuto.
Il punto di partenza più rapido è qwen3-omni-flash-realtime via WebSocket. Vediamo cosa fa ciascun modello, quanto costa, come si posiziona rispetto a OpenAI Realtime e Gemini Live e come iniziare a usarlo. Ogni specifica, prezzo e ID modello rimanda alla fonte primaria, soprattutto alla documentazione Realtime di Model Studio di Alibaba e alla model card di Qwen3-Omni; in questo settore i fornitori aggiornano tutto rapidamente, quindi se un dato non coincide più, fa fede la fonte linkata.
Come orientarsi tra i modelli audio Qwen
La linea audio di Qwen attraversa più generazioni. Capirne l'evoluzione aiuta a scegliere subito il modello giusto:
Qwen-Audio(2023) eQwen2-Audioerano modelli di comprensione dell'audio: ricevevano audio e restituivano testo. Non producevano risposte vocali.- La generazione attuale integra l'audio nei modelli omni.
Qwen3-OmnieQwen3.5-Omnielaborano testo, immagini, audio e video, generando sia testo sia parlato naturale. - Il comportamento in tempo reale è un livello di distribuzione: gli stessi modelli omni vengono chiamati tramite la Realtime API, con ID che terminano in
-realtime.
In pratica, "Qwen Audio 3.0 Realtime", indipendentemente da come lo si scrive, indica la famiglia Qwen3-Omni usata in tempo reale. È questa la piattaforma trattata nel resto della guida.
Lo stack audio realtime di Qwen: tre componenti
Più che a un singolo modello, conviene pensare a una pipeline. Una voice app in produzione in genere coinvolge tre modelli Qwen, utilizzabili insieme oppure separatamente.
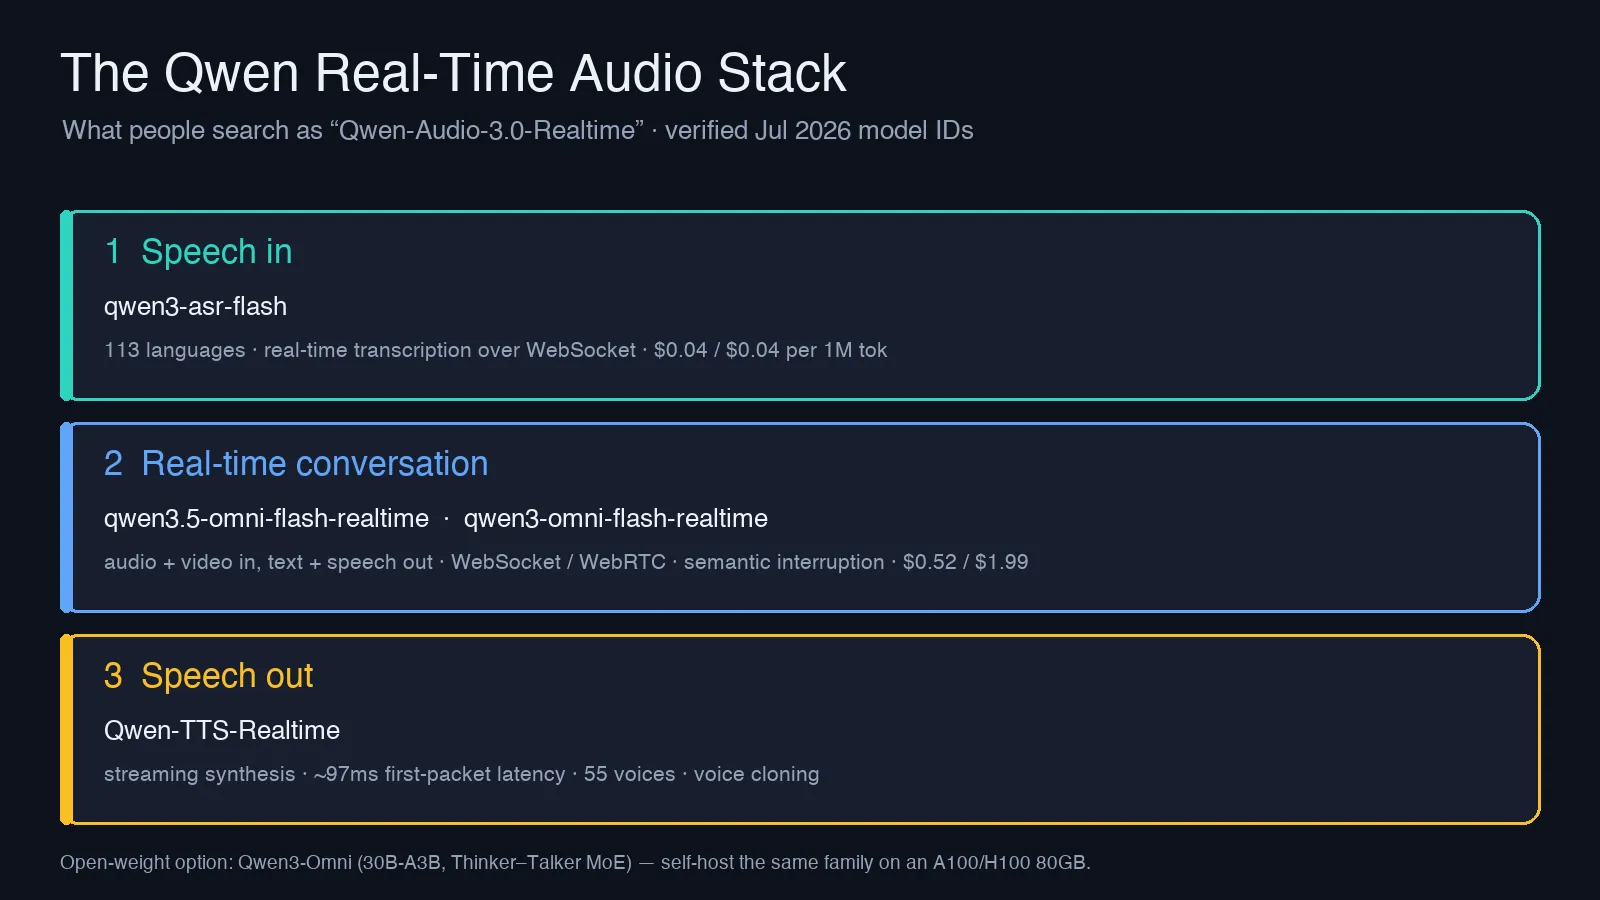
- Input vocale —
qwen3-asr-flash. Riconoscimento vocale in streaming via WebSocket, ottimizzato per sottotitoli live e front end di agenti vocali. Trascrive in un'ampia gamma di lingue ed è pensato come motore di trascrizione a basso costo. - Conversazione in tempo reale —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. È il nucleo dello stack: riceve audio, e anche frame video, e restituisce testo e voce sintetizzata attraverso una connessione persistente che rimane aperta tra un turno e l'altro, senza riaprirsi a ogni richiesta. - Output vocale —
Qwen-TTS-Realtime. Modello dedicato di text-to-speech in streaming per i casi in cui serve solo trasformare testo in voce, ad esempio per leggere la risposta generata da un LLM testuale.
Usando un modello omni Realtime per il livello centrale, spesso non servono chiamate ASR e TTS separate: gestisce infatti input e output vocale end-to-end. I modelli separati servono quando si vuole comporre liberamente lo stack, ad esempio abbinando un proprio STT al TTS di Qwen.
Le specifiche che contano davvero
Questi sono i dati riportati nella documentazione Realtime di Model Studio, non nelle pagine marketing.
| Caratteristica | Qwen Realtime API (famiglia omni) |
|---|---|
| Input audio | PCM, 16 kHz |
| Output audio | PCM, 24 kHz |
| Altri input | Frame immagine / video (JPG, fino a 1080p, 256 KB dopo la codifica) |
| Riconoscimento vocale | 113 lingue e dialetti (API ospitata) |
| Generazione vocale | 36 lingue e dialetti |
| Voci | 55 in totale (47 multilingue, 8 dialettali), più clonazione vocale sui modelli 3.5 |
| Connessioni | WebSocket (autenticazione Bearer, VAD manuale o lato server) e WebRTC (negoziazione SDP) |
| Durata massima della sessione | 120 minuti via WebSocket |
| Funzioni extra | Interruzione semantica, function calling, ricerca web autonoma, controllo vocale di volume / velocità / emozione |
Alcuni elementi meritano di essere evidenziati. L'interruzione semantica permette al modello di distinguere una vera interruzione da un semplice segnale di ascolto come "mh-mh": è la differenza tra un agente vocale naturale e uno irritante. Il supporto WebRTC è importante per le applicazioni browser, perché gestisce cancellazione dell'eco e jitter. Il dato delle 113 lingue riguarda invece l'API ospitata: come vedremo, la release open-weight copre un set più ristretto.
Quanto alla latenza, il percorso streaming dedicato Qwen-TTS-Realtime punta a circa 97 ms di latenza al primo pacchetto, secondo la documentazione streaming di Qwen3-TTS: è il parametro che determina se la voce sembra immediata. Si tratta del tempo necessario per ricevere il primo blocco audio, non una risposta completa. Per il ciclo conversazionale completo, l'architettura Thinker–Talker è progettata per lo streaming; il report tecnico di Qwen3-Omni descrive un design multi-codebook pensato per minimizzare la latenza, mentre test della community collocano la risposta audio-to-audio sotto i 250 ms, con turni full-duplex e interrompibili. I risultati reali dipendono da regione, rete e carico: meglio misurare sul proprio traffico anziché affidarsi a un singolo dato di copertina.
Prezzi dell'audio realtime Qwen: i numeri
I prezzi realtime ospitati di Qwen sono sensibilmente inferiori a quelli delle API realtime chiuse. Le tariffe seguenti sono espresse per milione di token, input / output, come riportato nella directory dei modelli DashScope di Portkey, aggregatore terzo che rispecchia le tariffe Alibaba; prima di impegnarsi, conviene verificare il prezzo aggiornato nella console Model Studio:
| Modello | Input / 1M tok | Output / 1M tok |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (trascrizione) | $0.04 | $0.04 |
Tradotto in costo per chiamata. L'audio consuma molti token: circa 427 token per minuto di audio. Prendiamo una conversazione vocale di 10 minuti, con 5 minuti parlati dall'utente e 5 minuti di risposta del modello. Con qwen3-omni-flash-realtime si tratta di circa 2.135 token in input e 2.135 in output: all'incirca $0.001 in input + $0.004 in output ≈ mezzo centesimo per una chiamata di 10 minuti. Anche su larga scala l'audio realtime rimane economico; la voce di costo che può sorprendere è il tempo parlato in output, dato che le risposte vocali costano circa 4 volte l'input.
Prima di impostare un budget, ci sono altri due aspetti da considerare:
- Esiste una quota gratuita, ma dipende dalla regione. L'endpoint di Singapore, quello internazionale, ha offerto 1 milione di token input e 1 milione di token output gratuiti per 90 giorni; l'endpoint USA no. Le quote possono cambiare: verificate l'offerta attuale nella console Model Studio della vostra regione prima di farci affidamento.
- Il tier
qwen3.5-omniusa fasce di prezzo basate sulla dimensione della richiesta, non una tariffa piatta. Una singola richiesta con contesto molto ampio può quindi finire in una fascia diversa rispetto a più richieste piccole. Fate una prova con il profilo reale del vostro traffico prima di decidere.
Confronto con OpenAI Realtime e Gemini Live
Tra i fornitori di LLM generalisti di frontiera, a metà 2026 le tre opzioni più evidenti per il parlato in tempo reale da voce a voce sono Realtime API di OpenAI, Gemini Live di Google e la famiglia omni Realtime di Qwen. I provider vocali specialistici, come ElevenLabs, Deepgram, Cartesia e Hume, competono in modo aggressivo soprattutto su TTS e STT; qui però il confronto riguarda l'approccio basato su un modello multimodale completo. Invece di citare prezzi della concorrenza che cambiano ogni mese, ecco come valutare la scelta:
- Costo. Alle tariffe per chiamata viste sopra, il realtime di Qwen si colloca nella fascia bassa delle opzioni ospitate basate su modelli di frontiera. Per confronto, l'audio Realtime di OpenAI è stato intorno a $0.06 al minuto in input e $0.24 al minuto in output (qui l'analisi dei prezzi); con queste tariffe, la stessa chiamata di 10 minuti che costa circa mezzo centesimo con
qwen3-omni-flash-realtimearriva più vicina a $1.50 su OpenAI. Prima di basarsi sul divario, verificate le tariffe correnti da entrambe le parti, perché possono cambiare; lo scarto è comunque ampio. Qwen è inoltre l'unico dei tre a offrire una versione open-weight, auto-ospitabile per avvicinare il costo marginale allo zero. - Apertura. OpenAI Realtime e Gemini Live sono disponibili solo come API chiuse. Qwen3-Omni offre pesi aperti, quindi è possibile passare dall'hosting all'auto-hosting senza riscrivere l'applicazione attorno al comportamento di un altro modello.
- Qualità. Coperture di terze parti riportano che il tier di punta
qwen3.5-omni-pluspuò eguagliare o superare Gemini 3.1 Pro in alcuni benchmark di comprensione audio. Un singolo benchmark va considerato un'ipotesi iniziale: la verifica decisiva resta quella sui propri contenuti audio. - Ecosistema. OpenAI e Google dispongono oggi di strumenti, SDK ed esempi della community più maturi. La documentazione Qwen è valida, ma richiede più lavoro diretto con le specifiche WebSocket/WebRTC.
In termini pratici: se contano il costo o la possibilità di auto-ospitare, Qwen è la scelta più forte. Se invece cercate l'esperienza SDK più rifinita e siete disposti a pagarla, OpenAI e Google rimangono avanti sul fronte della maturità. Per un'analisi completa dei costi delle alternative chiuse, trovate le letture correlate in fondo.
Quale variante scegliere
| Scenario | Modello consigliato |
|---|---|
| Loop vocale completo ospitato al costo più basso | qwen3-omni-flash-realtime |
| Migliore qualità ospitata, sessioni più lunghe, clonazione vocale | qwen3.5-omni-plus-realtime |
| Serve solo la trascrizione | qwen3-asr-flash |
| Serve solo text-to-speech | Qwen-TTS-Realtime |
| I dati devono restare sul proprio hardware | Auto-ospitare Qwen3-Omni (30B-A3B) open-weight |
I tier 3.5 aggiungono clonazione vocale, contesto più ampio e limiti di dialogo superiori, fino a 100 turni e 600 secondi di audio conservato, rispetto al più leggero qwen3-omni-flash, che arriva a 8 turni. Per un prototipo conviene iniziare con Flash e passare a Plus solo quando si incontra un limite concreto.
Come accedere al servizio
Hosting: la via diretta. Create una chiave API in Alibaba Cloud Model Studio, quindi aprite una connessione WebSocket con autenticazione Bearer oppure negoziate WebRTC tramite un POST SDP per le app browser. L'audio PCM viene inviato in streaming e la risposta arriva come PCM più testo. L'SDK Python DashScope incapsula l'interfaccia Realtime, se preferite non gestire direttamente il socket. La connessione essenziale è breve, con la gestione degli errori omessa:
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
Con il VAD lato server, il modello stabilisce quando l'utente ha terminato di parlare; passate alla modalità manuale se volete controllare voi i confini dei turni. Il flusso degli eventi ricorda da vicino quello di OpenAI Realtime, quindi il codice client esistente può essere adattato con modifiche limitate. Prima della messa in produzione, controllate nomi esatti dei campi, elenco delle voci e host dell'endpoint regionale nella documentazione Realtime: le distribuzioni di Singapore e USA differiscono, e l'API continua a evolvere.
Auto-hosting. Il modello open-weight Qwen3-Omni usa un'architettura Thinker–Talker Mixture-of-Experts, con 30B parametri totali e circa 3B attivi. Alibaba raccomanda vLLM rispetto a Transformers puro. Per l'inferenza BF16 del modello completo da 30B, le guide di deployment di terze parti indicano come minimo una singola scheda da 80 GB, A100 o H100; una GPU da 24 GB come RTX 4090 non basta per i pesi completi, anche se le build quantizzate abbassano la soglia.
Il limite è che servire il modello in tempo reale è più complesso dell'inferenza batch. Chi lo auto-ospita segnala la necessità di limitare la KV cache per evitare blocchi sotto carico concorrente, oltre a un throughput di token su singola scheda inferiore rispetto all'API ospitata. Gli stack di serving ottimizzati per lo streaming riducono gran parte del divario: gli ingegneri che lavorano su Red Hat AI e vLLM hanno riferito che la sovrapposizione degli stadi della pipeline porta la generazione vocale di un clip di 3 secondi da circa 8 secondi a circa 0.5. È un miglioramento reale, ma richiede lavoro ingegneristico aggiuntivo. L'auto-hosting elimina il costo per token, introducendo costi di GPU e operatività: conviene quindi con volumi elevati e costanti, non per i prototipi.
Per una voce omni in tempo reale, oggi l'endpoint DashScope è il percorso di riferimento. Se il vostro stack instrada già più provider attraverso un unico gateway, potete collocare davanti un aggregatore, ma verificate prima che il catalogo includa gli specifici ID modello realtime Qwen: molti relay supportano modelli testuali e immagini, ma non il tier audio realtime.
Limiti da conoscere prima di sviluppare
- Le sessioni sono limitate a 120 minuti. Per durate superiori, come una linea di assistenza o una lunga sessione di tutoraggio, serve una logica di riconnessione che mantenga il contesto tra socket diversi.
- La regione incide sia sulla quota gratuita sia sulla disponibilità. Testate sull'endpoint che utilizzerete in produzione, non semplicemente su quello scelto al momento della registrazione.
- Versione ospitata e open-weight non sono identiche. L'API ospitata dichiara riconoscimento in 113 lingue e generazione in 36; la release Qwen3-Omni open-weight copre un set più ristretto, con 19 lingue per l'input vocale e 10 per l'output. Se una lingua specifica è un requisito, verificatela sulla variante esatta che intendete distribuire.
- Il costo realtime cresce con il tempo di parola, non con il numero di richieste. Poiché l'audio usa molti token, un utente molto loquace costa più di uno sintetico. Modellate la spesa sui minuti di conversazione, non sul numero di chiamate.
Domande frequenti
Qwen 3 supporta l'audio?
Sì. I modelli Qwen3-Omni sono multimodali nativi: ricevono audio, testo, immagini e video e possono rispondere in tempo reale con testo o voce.
Qwen può generare audio, oltre a comprenderlo?
Sì. A differenza di Qwen-Audio originale, che produceva solo testo, i modelli omni Realtime e Qwen-TTS-Realtime generano audio parlato in output, incluse le voci clonate nel tier 3.5.
L'audio realtime di Qwen è gratuito?
È disponibile una quota di prova gratuita, storicamente pari a 1 milione di token input e 1 milione di token output per 90 giorni sull'endpoint internazionale di Singapore. Oltre tale soglia, il modello è a consumo per token; Qwen3-Omni interamente open-weight è invece gratuito da eseguire se si fornisce la propria GPU.
Come eseguo Qwen audio in locale?
Scaricate Qwen3-Omni (30B-A3B) open-weight e servitelo con vLLM. Per il modello completo in BF16 serve una scheda da circa 80 GB, A100 o H100; GPU consumer più piccole gestiscono solo build quantizzate, non i pesi completi.
Letture correlate
Fonti primarie:
Prezzi delle alternative: