 AIREITER
Tra ultra, Fast mode e Ultrafast mode, i nomi possono trarre in inganno: solo uno promette 750 token al secondo. Annunciato il 13 agosto 2026, OpenAI Ultrafast mode è un nuovo livello di servizio API che esegue GPT-5.6 Sol su chip wafer-scale Cerebras, con una velocità fino a 14 volte superiore a Standard. Per ora, però, è riservato a un gruppo selezionato su invito e OpenAI non ne ha comunicato il prezzo. Il tier più rapido che si può acquistare oggi resta quindi Fast mode, a $10/$60 per milione di token.
ultra, Fast mode e Ultrafast: tre nomi, tre cose diverse
Chi acquista GPT-5.6 Sol si trova davanti a tre etichette legate alla velocità, ma indicano servizi e comportamenti distinti. Ecco la differenza, in sintesi.
| Nome | Cos'è | Come si ottiene | Prezzo Sol (per 1M di token) | Velocità dichiarata |
|---|---|---|---|---|
Impostazione di ragionamento ultra | Una modalità di ragionamento/lavoro che usa subagenti e calcolo aggiuntivo su un singolo compito | Impostazione di Codex, non un tier API acquistabile separatamente | Nessuna tariffa autonoma; consuma rapidamente i limiti di utilizzo | Più lenta per progetto |
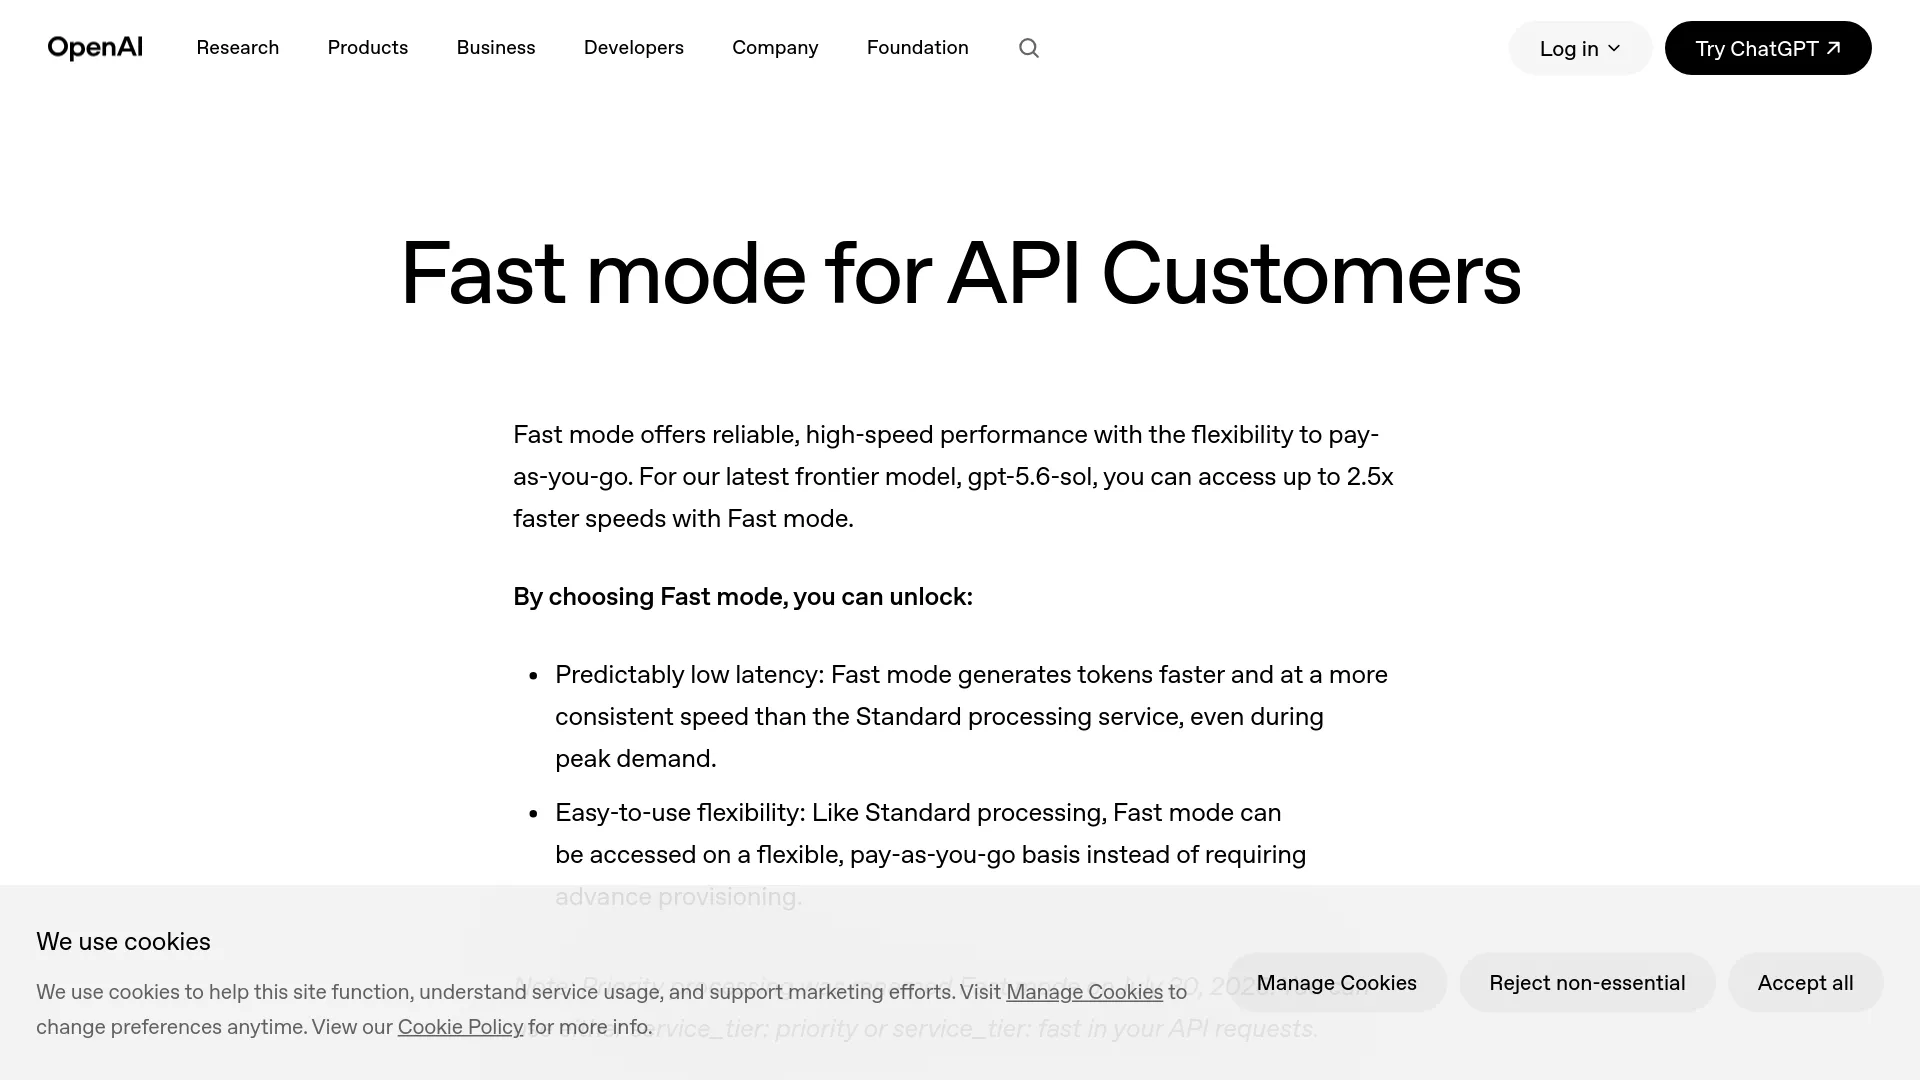
| Fast mode | Tier di elaborazione API, rinominato da Priority il 30 luglio 2026 | service_tier="fast" in qualsiasi richiesta API | $10 in / $60 out (contesto breve) | Fino a 2,5x Standard |
| Ultrafast mode | Tier API basato su Cerebras per GPT-5.6 Sol, presentato in anteprima il 13 agosto 2026 | Anteprima limitata, solo per clienti selezionati | Non divulgato | Fino a 14x Standard |
Le direzioni sono opposte: ultra è la modalità di lavoro con subagenti che sacrifica velocità in cambio di maggiore accuratezza; Ultrafast mode punta invece sulla pura velocità di generazione dello stesso modello. In mezzo c'è Fast mode, l'upgrade di latenza acquistabile e descritto separatamente nella pagina Fast mode di OpenAI.
Cosa include davvero l'anteprima del 13 agosto
L'annuncio ufficiale conferma cinque elementi concreti: Ultrafast debutta inizialmente nelle API OpenAI, supporta solo GPT-5.6 Sol, offre fino a 14x la velocità di elaborazione Standard e fino a 750 token di output al secondo, utilizza Cerebras ed è disponibile in anteprima limitata per un gruppo di clienti selezionati, tra cui Jane Street, Podium, Basis e Rogo.
Mancano però quattro informazioni essenziali per chi deve acquistarlo: prezzo per token, model ID, limiti di velocità e SLA di latenza. Non vengono neppure citati benchmark nominativi.
La dimostrazione proposta da OpenAI mette a confronto Ultrafast e Standard Sol mentre costruiscono, partendo dallo stesso prompt, un simulatore 3D di magazzino. Alex Wang di Rogo riassume così la promessa: "Ultrafast makes complex financial research feel like a real-time interaction."
Da 2,5x a 14x: cosa cambia nella pratica
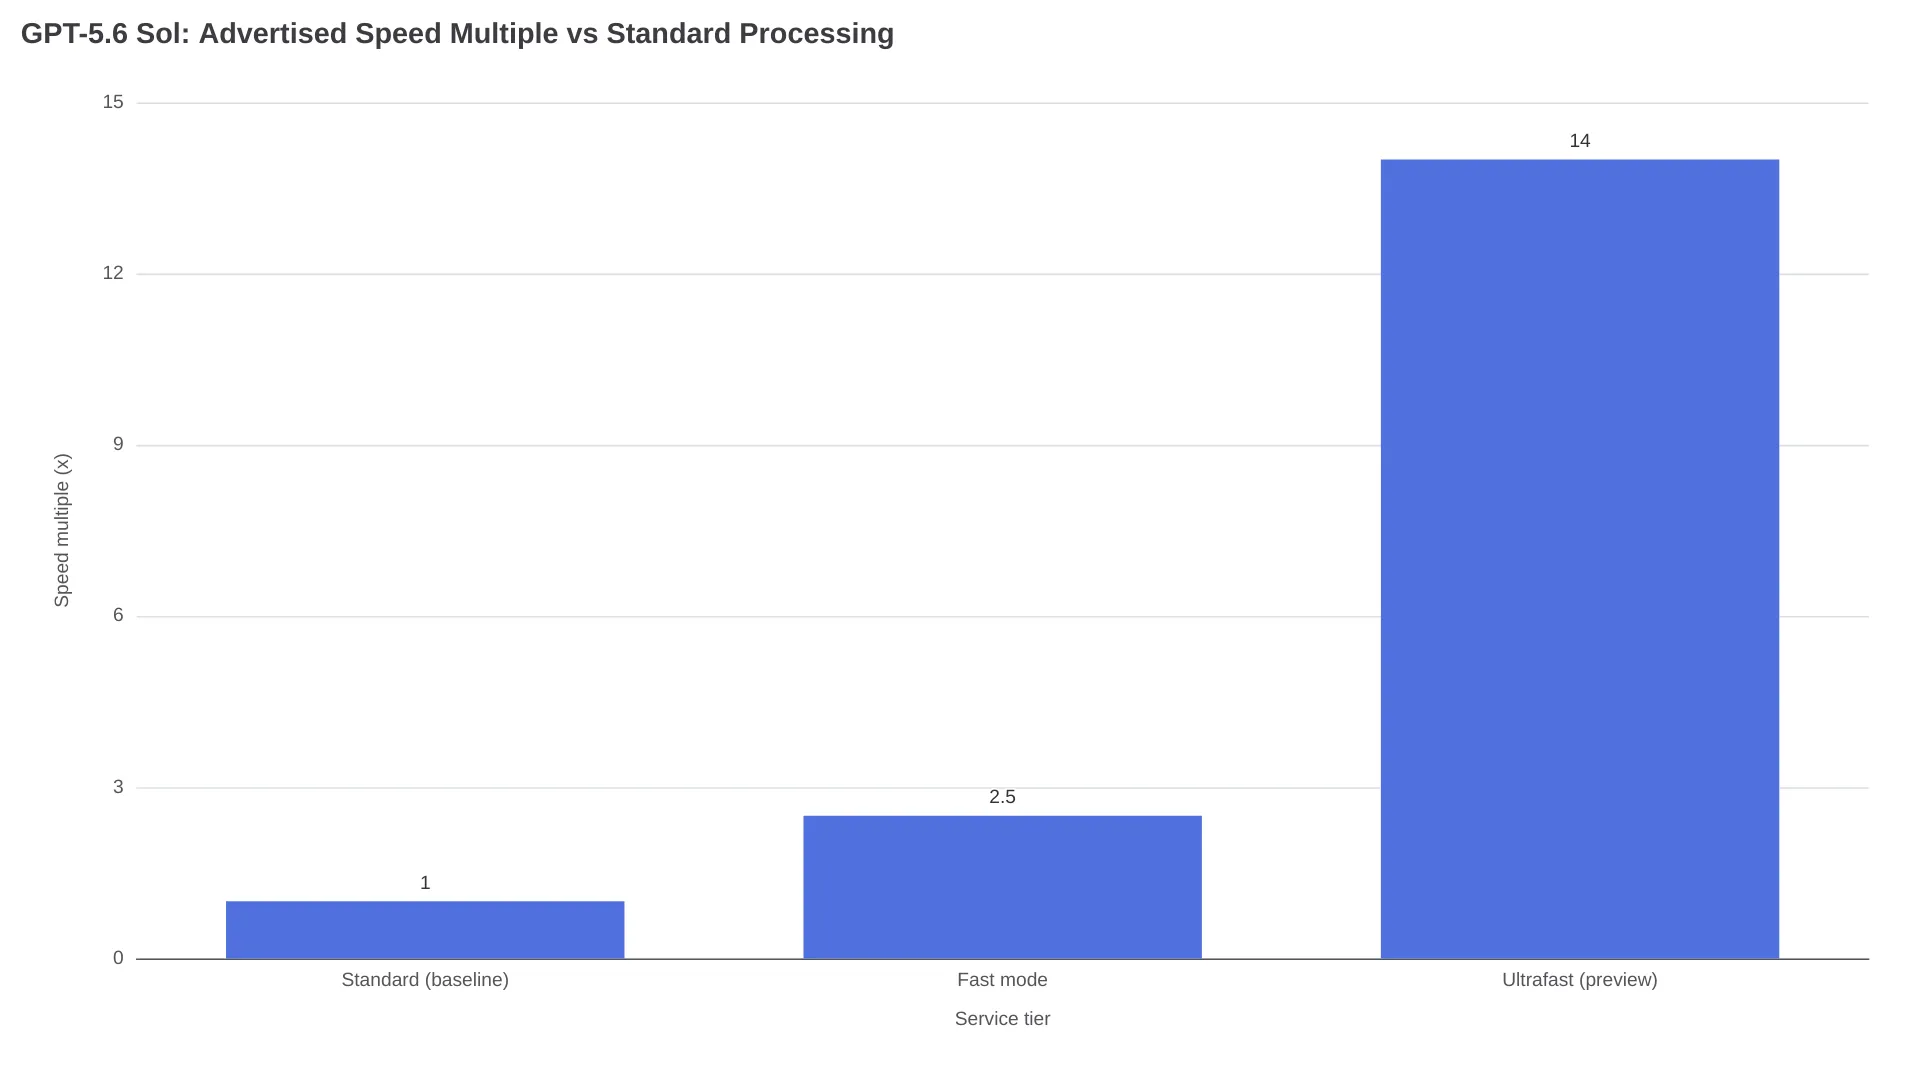
Va fatta anzitutto una distinzione: i 750 token al secondo sono throughput di output dichiarato, mentre il dato di Fast mode è una soglia SLA. Sono metriche correlate, ma non identiche. Dividendo 750 per 14, Standard Sol risulta attorno a 54 token al secondo: una generazione di 10.000 token richiederebbe quindi circa 186 secondi su Standard, fino a 125 secondi con la soglia SLA Enterprise di Fast mode pari a 80 token al secondo e circa 13 secondi con Ultrafast.
| Carico di lavoro | Standard (~54 tok/s, derivato) | Fast mode (SLA ≥80 tok/s) | Ultrafast (750 tok/s dichiarati) |
|---|---|---|---|
| Generazione di 10.000 token | ~186 s | ≤125 s | ~13 s |
| Ciclo agente di 5 turni, 1.000 token/turno | ~93 s | ≤63 s | ~7 s |
I dati circolati su r/AIToolsPerformance attribuiscono questi confronti ad Artificial Analysis e Cerebras: Ultrafast sarebbe 11x più veloce di Claude Fable 5 e 5x più veloce di Opus 4.8 in Fast mode; inoltre, un'esecuzione completa di Humanity's Last Exam con 2.500 domande sarebbe durata 11 ore e 11 minuti, contro le 78 ore e 27 minuti di Fable 5. Sono tutti dati riportati dai fornitori: non esistono ancora repliche indipendenti.
Il prezzo di Ultrafast resta sconosciuto
Il listino pubblico di Ultrafast non esiste. L'annuncio non indica alcuna tariffa e la comunità ha subito evidenziato il vuoto informativo: come ha scritto un utente di r/AIToolsPerformance, "What the blog doesn't say is price. Nobody outside the preview knows what it costs."
Per ora, l'unico riferimento è la struttura prezzi nota di GPT-5.6 Sol, sempre per milione di token:
| Tier | Input (ctx breve) | Output (ctx breve) | Input (ctx lungo >272k) | Output (ctx lungo) | Input in cache |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | non divulgato | non divulgato | non divulgato | non divulgato | non divulgato |
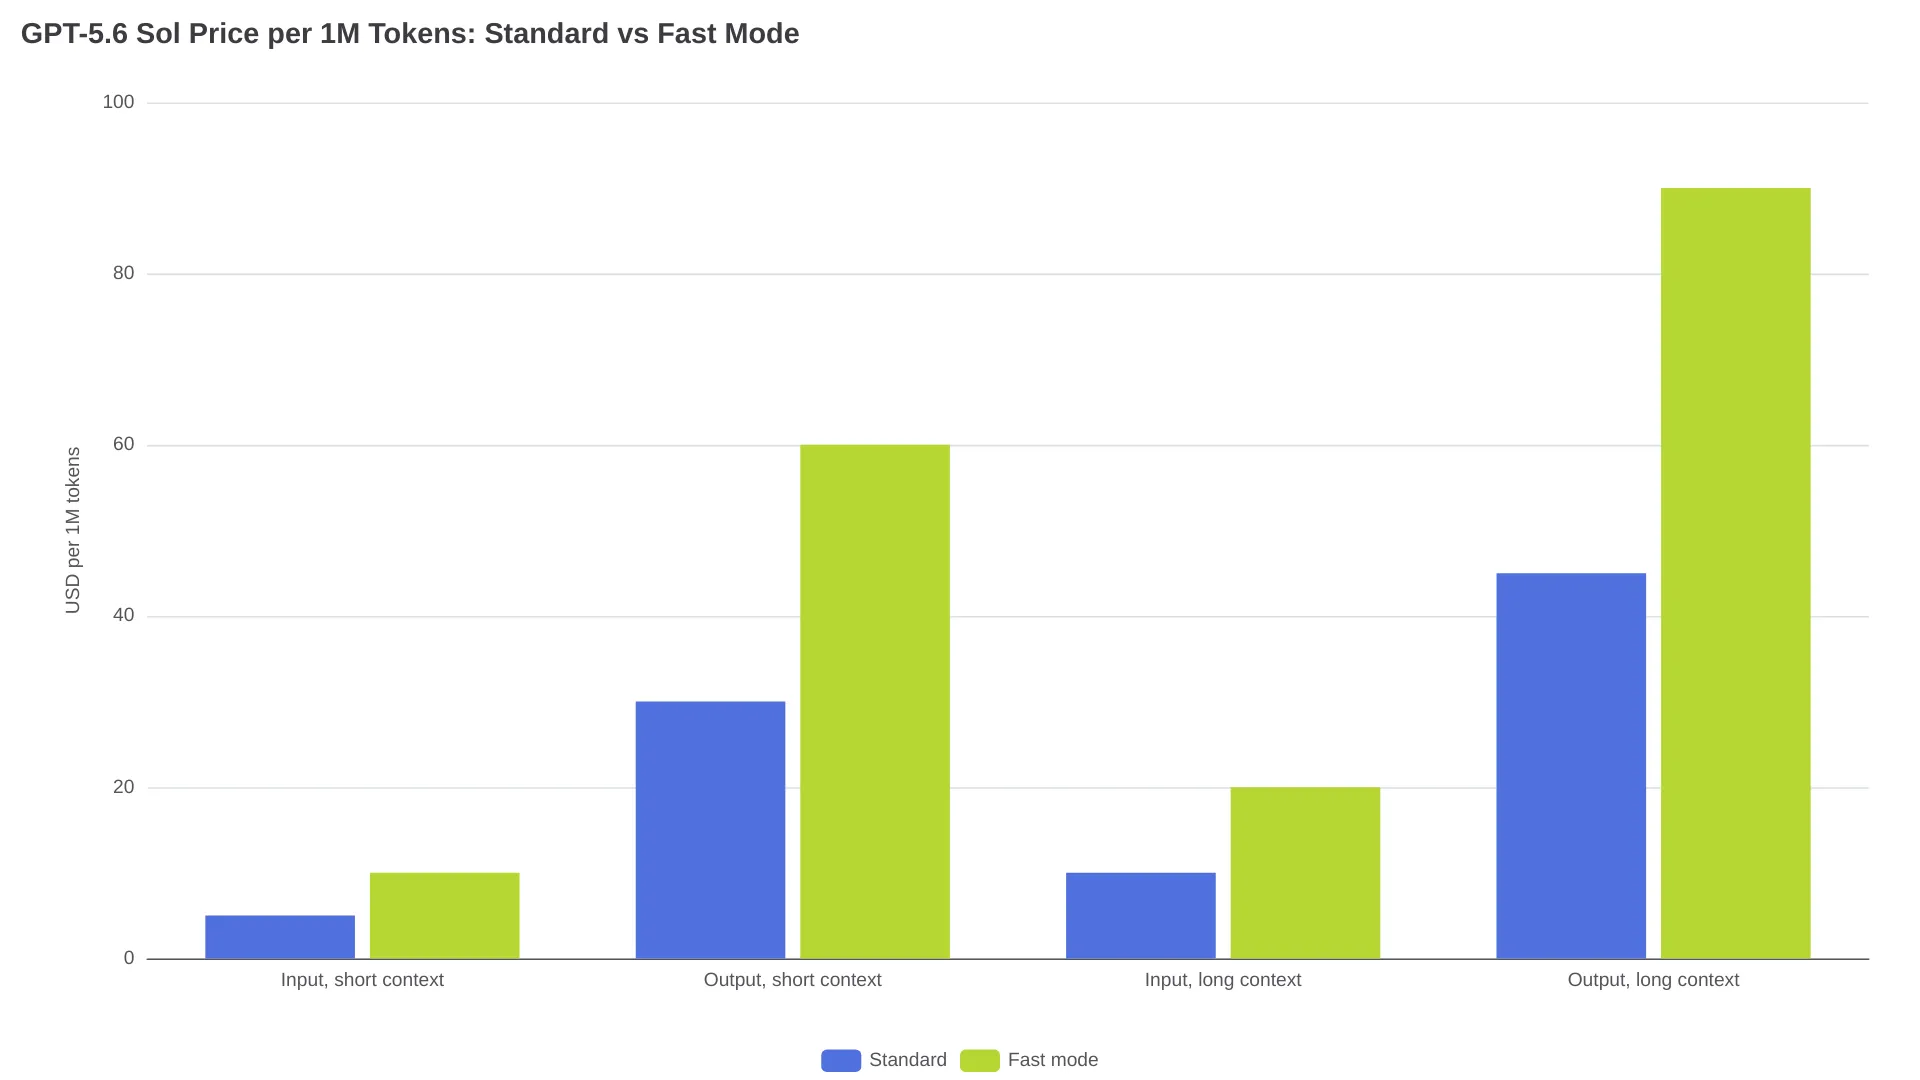
Per Sol, Fast mode costa esattamente il doppio di Standard. Le informazioni pubbliche non consentono però di stimare il prezzo di Ultrafast partendo da questo moltiplicatore: le tariffe possono cambiare in entrambe le direzioni, come quando OpenAI ha ridotto i prezzi di Terra/Luna il 30 luglio. C'è anche una nota importante per chi pianifica un budget di latenza: oltre 1 milione di token al minuto, se il traffico aumenta di più del 50% in meno di 15 minuti, le richieste eccedenti vengono silenziosamente riportate a Standard, restituiscono service_tier="Default" e sono fatturate alle tariffe Standard.
Accesso a Ultrafast: la situazione attuale
L'accesso a Ultrafast avviene tramite invito, non attraverso una waitlist pubblica. OpenAI afferma che l'anteprima verrà estesa "as capacity grows" e mette a disposizione una registrazione per ricevere aggiornamenti nella pagina dell'annuncio. Secondo le notizie di luglio, solo circa 20 organizzazioni avevano accesso iniziale a Sol.
L'infrastruttura non nasce dal nulla: la partnership tra OpenAI e Cerebras risale al 14 gennaio 2026 e riserva 750 MW di capacità wafer-scale. Sullo stesso hardware, GPT-5.3-Codex-Spark aveva già superato i 1.000 token al secondo.
Come ottenere output rapidi nell'attesa dell'invito
Fast mode è già disponibile per tutti i clienti API e si attiva modificando un solo parametro:
- Aggiungi
service_tier="fast"a una richiesta su/v1/responsesoppure/v1/chat/completions. - I valori legacy
service_tier="priority"continuano a funzionare: i modelli esistenti mostrano ancoraprioritynelle dashboard di utilizzo, mentre quelli successivi a GPT-5.6 mostrerannofast. - Per impostarlo come predefinito per un intero progetto, vai in Project settings -> Default Service Tier -> Fast.
| Modello Fast mode | Prezzo per 1M (in / out) | SLA di latenza |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 tok/s |
| GPT-5.6 Terra | $4 / $24 | >70 tok/s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 tok/s |
Tra i tre, Luna ha la soglia SLA più alta. Le letture dalla cache riducono del 90% il costo dell'input — $0.50/M su Standard Sol con un TTL di circa 30 minuti — quindi una sessione di lunga durata è più conveniente di richieste sempre nuove, indipendentemente dal tier. Per testare i tier sul traffico reale, l'endpoint API GPT-5.6 espone tutti e tre i modelli attraverso un'unica interfaccia.
FAQ
Ultrafast mode è disponibile in ChatGPT o Codex?
No. Ultrafast viene lanciato inizialmente nelle API OpenAI e l'annuncio non fornisce una data per la disponibilità in ChatGPT o Codex.
Eseguire GPT-5.6 Sol su Cerebras cambia la qualità dell'output?
OpenAI presenta Ultrafast come lo stesso GPT-5.6 Sol erogato più velocemente, non come un modello diverso. Per ora, l'unica affermazione sulla qualità è un incremento di velocità di 5,6x su GDP-Val riportato da Cerebras, senza cali di qualità; nessun benchmark indipendente l'ha ancora replicato.
Ultrafast mode ha uno SLA di latenza?
No, non ne è stato pubblicato uno. Fast mode offre ai clienti Enterprise uno SLA p50 di >80 token/sec e un uptime del 99,9%; durante l'anteprima Ultrafast non ha uno SLA dichiarato.
Quali modelli supportano Ultrafast mode?
Solo GPT-5.6 Sol. Terra e Luna supportano Fast mode, ma non fanno parte dell'anteprima Ultrafast.
Quanto costerà Ultrafast mode?
Non esiste alcuna cifra ufficiale. L'unico riferimento disponibile è il sovrapprezzo 2x di Fast mode rispetto a Standard Sol.