 AIREITER
Per un coding agent che resta entro circa 150K token di contesto, Hy3 è la scelta più sensata: costa più o meno quanto DeepSeek V4 Flash per i token in input, ma offre una qualità di ragionamento superiore. Quando però le sessioni si allungano, il repository è grande o serve molta concorrenza in produzione, Flash passa avanti grazie a tre dati che Hy3 non può eguagliare: finestra di contesto da 1M token, prezzo documentato di $0.0028 per i cache hit e limite di concorrenza pari a 2.500 richieste. In sintesi, è questo il punto centrale del confronto hy3 vs deepseek v4 flash. Le valutazioni si basano su prezzi verificati il 14 luglio 2026 nella documentazione ufficiale DeepSeek e nelle quotazioni live di OpenRouter, benchmark di terze parti e testimonianze di sviluppatori su Hacker News e Reddit che usano entrambi ogni giorno.
Stessi numeri sulla carta, obiettivi opposti
Tencent ha pubblicato la versione finale di Hy3 il 6 luglio 2026, aggiornando la preview disponibile dal 23 aprile. Come indicato nell'annuncio, è un modello Mixture-of-Experts con 295B parametri totali e 21B attivi, progettato attorno a quello che Tencent definisce ragionamento ibrido veloce/lento: a ogni richiesta il modello decide quanta capacità dedicare al ragionamento. Il contesto arriva a 256K token. I pesi sono aperti con licenza Apache 2.0, mentre l'API è ospitata su Tencent Cloud TokenHub.
DeepSeek V4 Flash è arrivato nell'aprile 2026 come fascia veloce della famiglia V4. Anche questo è un MoE a pesi aperti, con 284B parametri totali e 13B attivi secondo Artificial Analysis, ma usa licenza MIT e punta a un obiettivo differente: gestire economicamente 1M token di contesto. Supporta la modalità thinking e quella non-thinking, con la prima attiva di default, e può generare fino a 384K token in output.
I conteggi dei parametri sono vicini, ma la filosofia progettuale no. Hy3 investe il budget nella qualità del ragionamento per token; Flash privilegia lunghezza del contesto, efficienza della cache e throughput. Da questa differenza derivano quasi tutte le implicazioni pratiche del confronto.
| Specifiche (verificate il 14-07-2026) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| Parametri | 295B totali / 21B attivi | 284B totali / 13B attivi |
| Finestra di contesto | 256K | 1M (384K output massimo) |
| Ragionamento | Thinking ibrido veloce/lento | Modalità thinking + non-thinking |
| Licenza | Apache 2.0 | MIT |
| Rilascio | 6 luglio 2026 (preview 23 apr) | Aprile 2026 |
| API ufficiale | Tencent Cloud TokenHub | api.deepseek.com (formati OpenAI + Anthropic) |
Cosa dicono davvero i benchmark
Nell'Intelligence Index v4.1 di Artificial Analysis, Hy3 ottiene 41 punti contro i 37 di DeepSeek V4 Flash in modalità reasoning ad alto effort. Quattro punti su questo indice rappresentano un divario concreto, grosso modo la distanza tra Flash e i modelli della fascia immediatamente sotto, ma non una differenza di categoria. Entrambi restano nella fascia dei modelli molto capaci, senza arrivare alla frontiera.
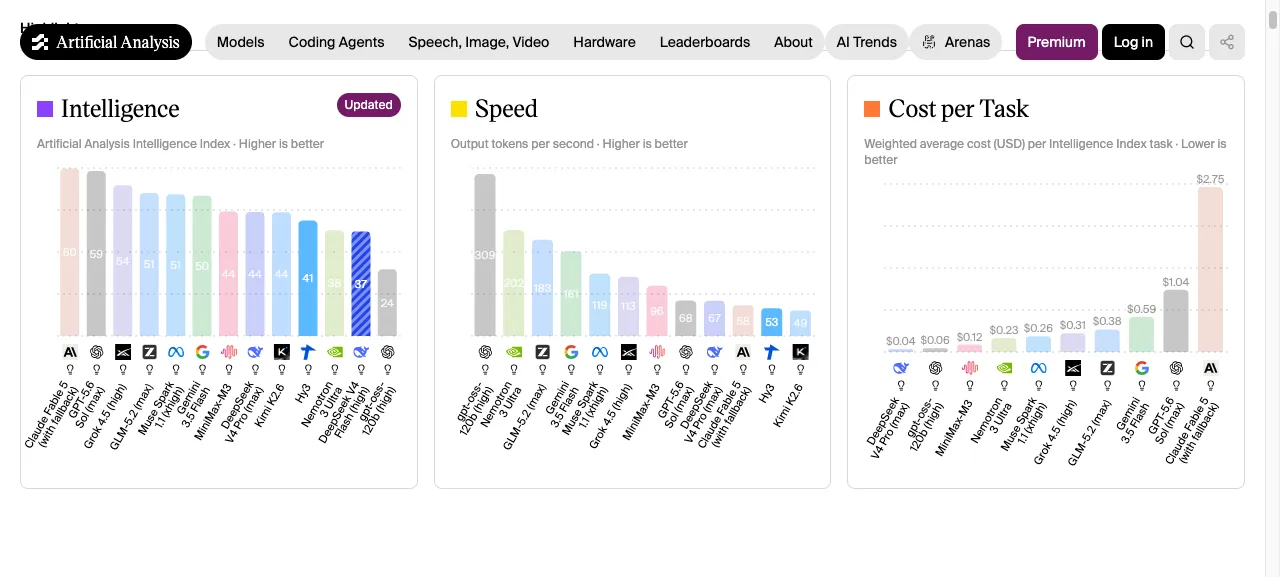
Prima di attribuire troppo peso a quel punteggio, vanno considerate due riserve.
Primo: i benchmark sul coding agentico sono meno indulgenti con entrambi. Un commentatore nel thread di lancio su Hacker News ha recuperato il risultato DeepSWE di Hy3: 28%, contro il 52% di GPT-5.4 al massimo effort. Nessuno dei due modelli cinesi è vicino alla frontiera del coding agentico: competono tra loro, non con la vetta della classifica.
Secondo: le tabelle di benchmark pubblicate dai fornitori meritano il consueto scetticismo. I numeri di lancio di Hy3 hanno attirato subito accuse di essere "benchmaxxed" nel thread HN, mentre le tabelle di DeepSeek coprono soltanto le valutazioni che l'azienda ha scelto di eseguire. I dati di terze parti riportati sopra sono quelli su cui farei affidamento: Hy3 è un po' più intelligente, ma il margine è abbastanza ridotto da poter essere ribaltato da prezzo e contesto.
Prezzi: il listino racconta solo una parte della storia
Ci sono due listini, verificati il 14 luglio 2026, che conviene tenere distinti. DeepSeek pubblica prezzi esatti per token direttamente nella documentazione API. Tencent non offre un listino in inglese equivalente per Hy3 finale: nel comunicato stampa indica per Hy3 preview un input di circa $0.18 per milione di token su TokenHub. Per questo la colonna Hy3 qui sotto usa le tariffe pubblicate da OpenRouter: un prezzo di marketplace, non di prima parte.
| Per 1M token | Hy3 (marketplace OpenRouter) | DeepSeek V4 Flash (API ufficiale) |
|---|---|---|
| Input | $0.14 | $0.14 (cache miss) |
| Input, in cache | $0.035 | $0.0028 (cache hit) |
| Output | $0.58 | $0.28 |
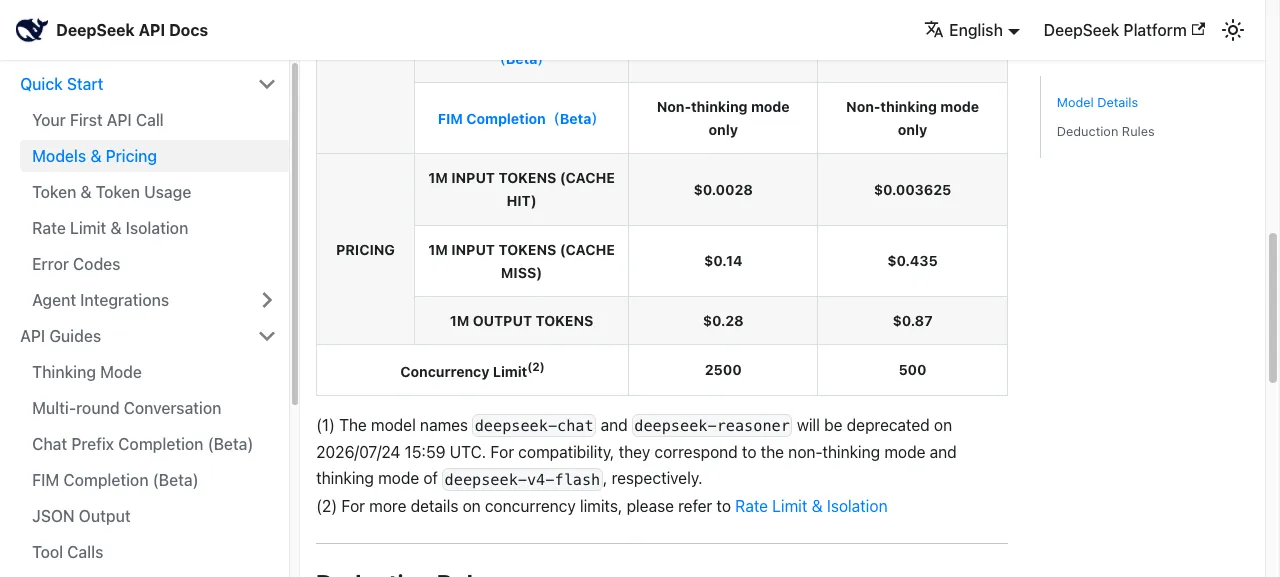
Il prezzo dell'input è identico. La scelta si gioca sulle altre due righe.
Il vantaggio enorme dei cache hit
Il prezzo di DeepSeek per un cache hit è 50 volte inferiore al cache miss e 12,5 volte più basso della tariffa cache di Hy3 su OpenRouter. Le due tariffe non sono strettamente equivalenti: quella DeepSeek è il prezzo dell'API ufficiale, mentre per Hy3 OpenRouter riflette quanto addebitano i provider sottostanti per le letture dalla cache. Sono comunque le cifre che si pagherebbero oggi. Per chi usa agenti, questo dato pesa più di qualunque altro nella pagina. A ogni turno un agent reinvia lo stesso contesto in continua crescita: system prompt, definizioni degli strumenti, contenuti dei file e cronologia della conversazione. In una sessione da 40 turni, la grande maggioranza dei token in input è ripetuta. Con un tasso di cache hit del 90%, il costo effettivo dell'input di Flash scende da $0.14 a circa $0.017 per milione di token. Hy3 scende a circa $0.045: rimane economico, ma costa quasi 3 volte di più, e il divario aumenta con sessioni più lunghe.
L'output rende Hy3 più costoso
Entrambi sono modelli di reasoning, quindi fatturano i token di ragionamento come output. Hy3 costa $0.58 in output contro i $0.28 di Flash: ogni catena di ragionamento estesa costa quindi agli utenti Hy3 circa il doppio. Flash offre inoltre una via d'uscita che Hy3 non ha: per compiti meccanici, come formattazione, estrazione o semplici modifiche, si può passare alla modalità non-thinking e smettere di pagare ragionamento non necessario. L'analisi deepseek-v4-flash-vs-deepseek-v4-pro spiega come funziona questa commutazione nella pratica.
Il piano gratuito
Hy3 ha un vantaggio reale: OpenRouter propone la variante tencent/hy3:free senza costi, con limiti di velocità ma concretamente utilizzabile. Per valutare il modello prima di impegnarsi, è meglio di Flash, che non offre un livello API gratuito. Anche Hy3 preview resta disponibile a $0.063/$0.21, meno della release finale, per chi può convivere con il checkpoint di aprile.
Il costo nascosto della finestra di contesto
I 256K di contesto di Hy3 sembrano abbondanti finché non si mette un agent al lavoro su una codebase reale. Un utente Reddit di r/hermesagent, che eseguiva entrambi i modelli nello stesso harness, ha definito Hy3 "quasi identico, tranne per la dimensione del contesto, quindi compattazione frequente". La compattazione non è un semplice fastidio: ogni ciclo consuma token di output per riassumere, perde dettagli e invalida la prompt cache, costringendo a pagare il prezzo di cache miss per ricostruirla.
In self-hosting, il divario diventa strutturale. Il design a attenzione sparsa dell'architettura V4, il cui meccanismo è chiamato da DeepSeek lightning indexer, rende la KV cache molto più leggera rispetto all'attenzione convenzionale di Hy3. Si tratta di resoconti individuali, non benchmark, ma i numeri nel thread HN sono netti: un commentatore che eseguiva entrambi su una coppia di DGX Sparks ha riferito di riuscire a ospitare 3M token di KV cache con DeepSeek V4 Flash, contro circa 130K token con Hy3 quantizzato a FP4. Un altro ha stimato che, quando llama.cpp supporterà pienamente l'indexer, il contesto completo da 1M di Flash dovrebbe richiedere soltanto circa 6GB di RAM. Flash ha anche dimostrato di reggere quantizzazioni aggressive: diversi utenti nello stesso thread riferiscono che resta coerente persino a 2 bit, un risultato non ancora mostrato per Hy3.
Se il caso d'uso resta ben sotto i 200K token, questa sezione non comporta alcun costo e i quattro punti extra di intelligence di Hy3 sono gratis. Se invece li supera, il costo del contesto si accumula: più compattazione, più invalidazioni della cache, più memoria per sessione.
I riscontri degli sviluppatori dopo il lancio
Il segnale più utile non arriva dalle tabelle dei benchmark, ma dalle differenze di comportamento che gli sviluppatori descrivono dopo aver inserito entrambi nei propri coding agent.
Un utente nello stesso thread di Hacker News, passato a DeepSeek V4 Flash e Pro come strumenti quotidiani dopo aver annullato l'abbonamento Anthropic e poi aver provato Hy3, ha descritto Flash così: è molto veloce, ma "spesso si costruisce un modello mentale completamente sbagliato e parte nella direzione errata", richiedendo correzioni frequenti e compattazione della cronologia. Nella sua esperienza Hy3 "non è altrettanto veloce, ma finora sembra restare sul percorso molto più affidabilmente" e degrada meno con la crescita del contesto. Altri nello stesso thread hanno elogiato la conoscenza del mondo e la qualità della prosa di Hy3, ritenute migliori di quelle di Flash a questa dimensione.
Su Reddit il quadro pende nella direzione opposta quando si guarda all'output puro nel coding. Un confronto sullo stesso task in r/LLMDevs ha classificato "DeepSeek V4 Flash > Hy3 > GLM", pur definendo Hy3 "promettente per workflow pratici di coding". In r/opencode ricorre invece l'idea che Flash sia "più che sufficiente" per il lavoro quotidiano con gli agenti.
C'è poi lo storico operativo. La domanda al lancio di Hy3 ha superato la capacità di serving di Tencent: nel thread HN gli utenti hanno riportato rate limit pesanti e uno di loro, che monitora le classifiche pubbliche d'uso di OpenRouter, ha osservato che in un mese il modello è passato dalla vetta all'8ª-9ª posizione, attribuendo direttamente il calo a quei limiti. DeepSeek, al contrario, documenta per Flash un limite di concorrenza di 2.500 richieste sulla sua API ufficiale, cinque volte quello previsto per V4 Pro. Per il traffico di produzione, un fornitore pubblica garanzie di capacità e l'altro ha una storia di congestione.
Quale scegliere in base allo scenario
- Coding agent, sessioni sotto circa 150K token: Hy3. Offre una qualità di ragionamento più elevata, resta più facilmente sul compito e il costo input di listino coincide con quello di Flash. Si parla di 150K, non dei 256K massimi, perché il contesto di un agent cresce in fretta ed è bene lasciare margine prima che inizi la compattazione.
- Sessioni lunghe, repository grandi, RAG su documenti estesi: Flash è di solito più adatto. La finestra da 1M e lo sconto cache di 50 volte cambiano completamente la classe di costo, mentre l'overhead della compattazione di Hy3 erode il suo vantaggio di intelligence.
- API di produzione ad alto volume: Flash. Concorrenza documentata di 2.500 richieste, storico di serving stabile e modalità non-thinking per chiamate bulk economiche.
- Scrittura, ricerca e compiti di conoscenza generale: Hy3. Sia i report della community sia le valutazioni di conoscenza AA lo favoriscono a questa scala.
- Deploy locale: Flash per la maggior parte dell'hardware. Esistono molte più evidenze sul campo della sua efficienza nella KV cache e resistenza alla quantizzazione; le linee guida di Tencent per servire Hy3, citate nel thread di lancio, parlano di otto GPU di classe H20.
- Valutazione prima dell'acquisto: il tier gratuito Hy3 su OpenRouter non costa nulla da provare. Conviene eseguire i propri task prima di credere a qualsiasi tabella di benchmark, inclusa questa.
Dove usare i due modelli
DeepSeek V4 Flash: l'API ufficiale offre endpoint sia in formato OpenAI, api.deepseek.com, sia in formato Anthropic, api.deepseek.com/anthropic. Basta quindi cambiare il base URL per inserirla in strumenti compatibili con Claude. Attenzione alla scadenza di migrazione riportata nella stessa pagina dei prezzi: i vecchi nomi modello deepseek-chat e deepseek-reasoner sono deprecati il 24 luglio 2026 e vengono mappati rispettivamente alle modalità non-thinking e thinking di Flash. OpenRouter lo offre a $0.09/$0.18, leggermente sotto il listino ufficiale, ma senza il prezzo cache-hit dell'API ufficiale.
Hy3: Tencent Cloud TokenHub è la soluzione di prima parte. OpenRouter ospita la release finale, il checkpoint preview più economico e il tier gratuito. SiliconFlow ha proposto promozioni di lancio. Il self-hosting è possibile con Apache 2.0, a patto di avere le GPU necessarie. La guida alla configurazione dell'API Hy3 spiega come ottenere una chiave ed effettuare la prima chiamata.
FAQ
Hy3 si può usare gratuitamente?
In parte. OpenRouter elenca un tier gratuito e soggetto a rate limit, tencent/hy3:free, mentre i prodotti consumer di Tencent, Yuanbao e ima, usano Hy3 senza costi. L'accesso API di produzione tramite TokenHub o il tier a pagamento di OpenRouter viene invece fatturato a token.
Hy3 è lo stesso modello di Tencent Hunyuan?
Sì. Hy3 è la terza generazione della linea di modelli Hunyuan di Tencent, che l'azienda oggi chiama "Tencent Hy". La preview è uscita il 23 aprile 2026 e la release finale il 6 luglio 2026.
Per il coding è meglio Hy3 o DeepSeek V4 Flash?
I risultati della community variano in base alla forma del task. I confronti Reddit sullo stesso compito collocano l'output puro di Flash sopra Hy3, mentre gli utenti di agent per sessioni lunghe riferiscono che Hy3 resta più affidabilmente sul percorso. Per task brevi e ben delimitati, la velocità di Flash è un vantaggio; per sessioni agentiche di molte ore, dove una deviazione costa cara, Hy3 è preferibile purché il contesto resti comodamente entro la finestra di 256K.
Posso eseguire DeepSeek V4 Flash in locale?
Sì, e in modo più pratico rispetto a Hy3. I pesi hanno licenza MIT, la KV cache dell'architettura è insolitamente leggera e gli utenti riportano qualità utilizzabile persino con quantizzazione a 2 bit su macchine con circa 96GB di RAM.
Perché il confronto prezzi hy3 vs deepseek v4 flash è così confuso?
Perché esistono almeno quattro listini: Tencent TokenHub, le inserzioni OpenRouter per Hy3 finale e preview, e l'API ufficiale DeepSeek con una tariffa separata per i cache hit. Occorre confrontare il prezzo effettivo sul proprio schema di traffico: l'input in cache domina i workload agentici, ed è qui che la tariffa DeepSeek di $0.0028 è difficile da battere.
In conclusione
Secondo le evidenze indipendenti disponibili, Hy3 è il modello più forte; DeepSeek V4 Flash è il servizio più forte. Per i workload API di produzione, Flash è la scelta predefinita: l'economia della cache, la finestra di contesto e la concorrenza pubblicata si combinano in modo che quattro punti di vantaggio nei benchmark non riescono a compensare. Hy3 è da preferire quando conta più la qualità del ragionamento per prompt rispetto alla scala; vale la pena provare prima il suo tier gratuito, perché verificare sui propri task non costa nulla.