 AIREITER
La ricerca parte da “3-5”, ma gli ID dei modelli Google sono gemini-3.5-transcribe e gemini-3.5-transcribe-live. L’API esiste davvero ed è economica, ma la scelta dipende da cosa ti serve: prosa ripulita, testo verificabile parola per parola o sottotitoli in tempo reale.
Il verdetto sulla Gemini 3.5 Transcribe API, in una tabella
Gemini 3.5 Transcribe merita un prototipo per file registrati, dettatura ed esperienze brevi di sottotitolazione live. Non è però una scelta predefinita sicura per una trascrizione letterale o per una registrazione live prolungata: la modalità Smart modifica il parlato, le sessioni live non offrono speaker label né tempi delle singole parole e il servizio è ancora in anteprima pubblica.
| Se ti serve… | Usa… | Giudizio della recensione |
|---|---|---|
| La trascrizione di una riunione, chiamata o puntata podcast caricata | gemini-3.5-transcribe | Usala; scegli la modalità verbatim quando conta la formulazione esatta |
| Una dettatura ripulita o appunti di riunione leggibili | Modello per file registrati con modalità Smart | Usala con revisione se le modifiche al parlato sono accettabili |
| Sottotitoli mentre qualcuno sta parlando | gemini-3.5-transcribe-live | Usala per un prototipo di sessioni interattive brevi |
| Speaker label e tempi a livello di parola | Modello per file registrati con annotazioni verbatim | Usala tenendo conto dei limiti; 30 minuti e 3 o più speaker sono funzioni sperimentali |
| Una fonte ufficiale per ambito legale, medico, di compliance o archivistico | Pipeline verbatim con revisione umana | Non usarla come unica fonte |
Questa è una recensione dell’API basata sulle evidenze disponibili, non un benchmark WER controllato. La guida alla configurazione e ai prezzi della Gemini 3.5 Transcribe API illustra il flusso delle richieste; qui ci concentriamo sulle conseguenze pratiche dei compromessi documentati, una volta superata la prima chiamata.
In realtà la famiglia di modelli comprende due contratti API
gemini-3.5-transcribe gestisce file audio caricati o preregistrati tramite la Interactions API, mentre gemini-3.5-transcribe-live elabora l’audio in streaming attraverso la Live API.
Trascrizione registrata: gemini-3.5-transcribe
Il percorso per i file registrati è l’opzione più completa quando serve una trascrizione da conservare. Google documenta il rilevamento automatico della lingua in oltre 85 lingue, il vocabolario personalizzato, l’output Smart o verbatim, la diarizzazione degli speaker e i timestamp a livello di parola nella documentazione sulla trascrizione audio.
Il limite standard per l’audio arriva a un’ora. Attivando la diarizzazione o i timestamp a livello di parola, il limite scende a 30 minuti; inoltre Google considera sperimentale l’attribuzione per tre o più speaker, anche se il riferimento del modello indica un supporto fino a otto speaker.
Questo percorso è adatto a dettature, interviste e chiamate brevi. Per riunioni più lunghe che richiedono attribuzione e allineamento, l’applicazione dovrà dividere l’audio e ricomporre i risultati.
Trascrizione live: gemini-3.5-transcribe-live
Il percorso live è pensato per generare sottotitoli progressivi, non per replicare via WebSocket il comportamento della modalità registrata. La documentazione Google sulla trascrizione Live descrive gli eventi di trascrizione provvisori e definitivi, il rilevamento automatico della lingua, il vocabolario personalizzato, la modalità Smart e il rilevamento dell’attività vocale automatico, ibrido o manuale.
Una sessione live continua dura 10 minuti; lo streaming live non offre diarizzazione degli speaker né timestamp a livello di parola. L’audio deve inoltre essere PCM raw a 16 bit, 16 kHz, mono e little-endian. Sono limiti compatibili con anteprime di sottotitoli, ma per registrare chiamate lunghe servono riconnessioni, ricomposizione dei segmenti e gestione del testo provvisorio.
Il compromesso sulle funzioni che decide il verdetto
Il tratto distintivo di Gemini 3.5 Transcribe è la pulizia “intelligente” del parlato, ma proprio questa funzione cambia il significato di accuratezza. Un testo più elegante può essere molto utile per una dettatura, ma meno adatto quando serve una registrazione letterale.
La modalità Smart modifica il testo: non è una fonte originale
La modalità Smart di Google elimina intercalari, balbettii e false partenze, risolve le autocorrezioni pronunciate a voce e applica la formattazione a punteggiatura, numeri, elenchi e paragrafi. “Ci vediamo martedì, no, mercoledì” può diventare “mercoledì”, invece di conservare la falsa partenza.
Per una bozza di email, una nota vocale o appunti di riunione leggibili è un comportamento utile. Diventa rischioso quando l’esitazione, l’errore originale o l’ordine preciso delle parole hanno un significato.
La guida ufficiale alla trascrizione chiarisce il confine: la modalità Smart non può essere combinata con la diarizzazione degli speaker o con i timestamp a livello di parola. L’API impone quindi una scelta tra testo ripulito e annotazioni verificabili.
Conserva una trascrizione verbatim come fonte di riferimento e genera poi una copia Smart o ripulita a valle per i lettori. Non cercare di aggirare questa incompatibilità con un prompt: è un vincolo del contratto di output.
Timestamp e speaker label aumentano la tracciabilità, ma restringono il percorso
L’audio registrato può restituire annotazioni word_info con testo delle parole, offset e identificativi degli speaker, se configurato in modalità verbatim. Sono dati utili per sottotitoli, riproduzione con ricerca temporale, calcolo della durata degli interventi e verifica delle evidenze.
| Requisito | Percorso registrato | Percorso live |
|---|---|---|
| Diarizzazione degli speaker | Supportata; fino a 8 speaker documentati, 3 o più sperimentali | Non supportata |
| Timestamp a livello di parola | Supportati | Non supportati |
| Output Smart con annotazioni | Non supportato | Non supportato con annotazioni a livello di parola |
| Limite di durata | 1 ora normalmente; 30 minuti con diarizzazione o timestamp delle parole | 10 minuti per sessione continua |
| Nota sull’accuratezza | Google avverte che i timestamp delle parole possono ridurre l’accuratezza | Il testo provvisorio può cambiare prima della finalizzazione |
Dire semplicemente che “supporta i timestamp” è quindi una descrizione incompleta. La funzione esiste, ma riduce il limite di durata dei file e può sacrificare parte dell’accuratezza del riconoscimento. L’attribuzione degli speaker va testata sul campo: il numero massimo documentato non è una garanzia di affidabilità per riunioni più grandi.
Vocabolario personalizzato e rilevamento della lingua
Entrambi i percorsi supportano il rilevamento automatico della lingua e il vocabolario personalizzato. Google documenta più di 85 lingue e il code-switching, e suggerisce di passare indicazioni come en-US quando l’applicazione conosce già la lingua.
Il vocabolario personalizzato accetta fino a 1.000 termini, ma le indicazioni pratiche di Google dicono che i risultati sono in genere migliori con un massimo di 100. Usa l’elenco per nomi di prodotto, acronimi, nomi propri e termini tecnici, non per le parole di uso comune.
“Supportata” non significa qualità uniforme con accenti, dialetti, ambienti rumorosi e cambi di lingua a metà frase. Una delle prime discussioni su Reddit chiedeva proprio se il percorso live riuscisse a gestire lingue miste: è un buon caso di test, non la prova di un malfunzionamento.
“Preferirei che il video fosse ritardato un po’ e che i sottotitoli fossero sincronizzati con le parole pronunciate.” — u/WaterObjective5107, Reddit
Il commento mette a fuoco un problema dei prodotti live che il WER non misura: una didascalia può essere linguisticamente corretta e sembrare comunque sbagliata se non è sincronizzata con il video.
Cosa dimostrano davvero i numeri sull’accuratezza
I numeri pubblicati da Google sono incoraggianti, ma descrivono contesti di valutazione diversi e non un unico punteggio universale di Gemini 3.5 Transcribe. Sono sufficienti per avviare un pilot serio, non per sostituire i test con i tuoi microfoni, accenti, termini e configurazioni degli speaker.
| Contesto di valutazione | WER dichiarato | Cosa indica |
|---|---|---|
| Artificial Analysis, streaming | 4.0% | Una media di streaming citata, non un punteggio di latenza o diarizzazione |
| Artificial Analysis, non streaming | 2.6% | Una media citata sull’audio registrato nelle condizioni del test |
| FLEURS, streaming | 5.50% | Un risultato multilingue in streaming su una selezione di località |
| FLEURS, non streaming | 5.04% | Un risultato distinto sull’audio registrato in più lingue |
Queste cifre compaiono nell’annuncio di lancio di Google, che dichiara anche un miglioramento del 70% nel tempo necessario a ottenere la trascrizione finale rispetto a Chirp 3. È una dichiarazione di Google, non un test indipendente del tuo flusso di lavoro.
La differenza tra 2.6% e 5.50% non è una contraddizione. Cambiano percorsi, dataset, mix linguistico e condizioni di streaming. Valuta gli errori che hanno un costo concreto — nomi, ID ordine, date, importi, termini di prodotto e turni di parola — invece di affidarti soltanto al WER aggregato.
Le prime segnalazioni della community indicano come casi di test il cambio di lingua, l’attribuzione degli speaker, il comportamento dei timestamp e il completamento di registrazioni lunghe; un tester su X ha descritto un clip di 20 minuti da cui sono stati restituiti soltanto cinque minuti. Sono testimonianze indicative, non fatti controllati sul prodotto. (Segnalazione su X)
Gli attriti di produzione che la guida di configurazione non risolve
Un upload riuscito o una connessione WebSocket attiva dimostrano che il trasporto funziona, non che il prodotto sia pronto per la produzione. I rischi emergono dopo la demo: testo live mutevole, limiti specifici del percorso, gestione delle credenziali, stato di anteprima e regole per conservare una trascrizione affidabile.
Le didascalie live richiedono una gestione dello stato
Le risposte live hanno due funzioni. interim_input_transcription è un’ipotesi mutevole da mostrare nell’anteprima dei sottotitoli; input_transcription è il segmento finalizzato che può essere aggiunto allo stato persistente della trascrizione.
Usa questo modello di gestione:
- Sostituisci la didascalia visibile a ogni aggiornamento provvisorio.
- Aggiungi alla trascrizione confermata soltanto il testo finalizzato.
- Rinnova o ristabilisci la connessione prima del limite di 10 minuti della sessione.
- Ricuci le sessioni inserendo un marcatore di confine esplicito e una logica per eliminare i duplicati.
- Non basare azioni irreversibili sul testo provvisorio.
Nei client browser e mobile usa token effimeri, così una chiave API di lunga durata non viene esposta nel codice frontend. Serve un backend per generare e limitare questi token; se l’architettura dell’applicazione lo consente, l’audio può poi passare direttamente dal client alla Live API. Monitora gli errori di connessione, il ritardo di finalizzazione e i segmenti duplicati.
I flussi registrati hanno bisogno di una politica sulla fonte di riferimento
Definisci il contratto di output prima di scegliere la modalità. Usa Smart per ottenere una prosa leggibile; scegli verbatim quando contano le parole esatte, gli speaker o gli offset.
Salva il risultato verbatim insieme alle annotazioni e genera poi una trascrizione ripulita separata per la ricerca, i riepiloghi o gli appunti destinati ai clienti. È un passaggio di elaborazione in più, ma più sicuro che tentare di ricostruire intercalari eliminati o correzioni sovrascritte.
Lo stato di anteprima modifica la decisione di deployment
Google ha annunciato Gemini 3.5 Transcribe il 26 agosto 2026 come famiglia di modelli in anteprima pubblica. Il riferimento dei modelli Google documenta capacità e limiti, ma lo stato di anteprima impone di ricontrollare prezzi, quote, comportamento e disponibilità prima di una migrazione.
Inizia con un piccolo set di valutazione non sensibile e trascrizioni di riferimento salvate. Misura separatamente l’accuratezza delle entità critiche, l’attribuzione degli speaker, il ritardo di finalizzazione, il comportamento alla riconnessione e il tasso di correzione dei revisori; definisci soglie scritte di accettazione prima dei test e procedi solo quando ogni soglia è rispettata.
Prezzo e costo della trascrizione effettivamente accettata
Gemini 3.5 Transcribe è economica nelle stime pubblicate, ma la fatturazione è basata sui token e non su una tariffa fissa garantita al minuto. La tabella prezzi ufficiale di Google indica circa 0,003 $ al minuto per l’input audio registrato più 0,002 $ per l’output testuale, cioè circa 0,005 $ al minuto complessivi; per Live il costo complessivo è di circa 0,009 $ al minuto.
| Percorso | Stima input audio | Stima output testuale | Stima complessiva per la pianificazione | 100 ore |
|---|---|---|---|---|
Registrato gemini-3.5-transcribe | $0.003/min | $0.002/min | $0.005/min | Circa $30 |
Live gemini-3.5-transcribe-live | Circa $0.005/min | Circa $0.004/min | $0.009/min | Circa $54 |
Il primo budget è di circa $30 per 100 ore registrate o $54 in modalità live, prima di considerare retry, storage, conversione audio, correzione umana e riepiloghi generati a valle. La lunghezza dell’output e il contesto aggiunto possono modificare il conto: registra quindi i consumi.
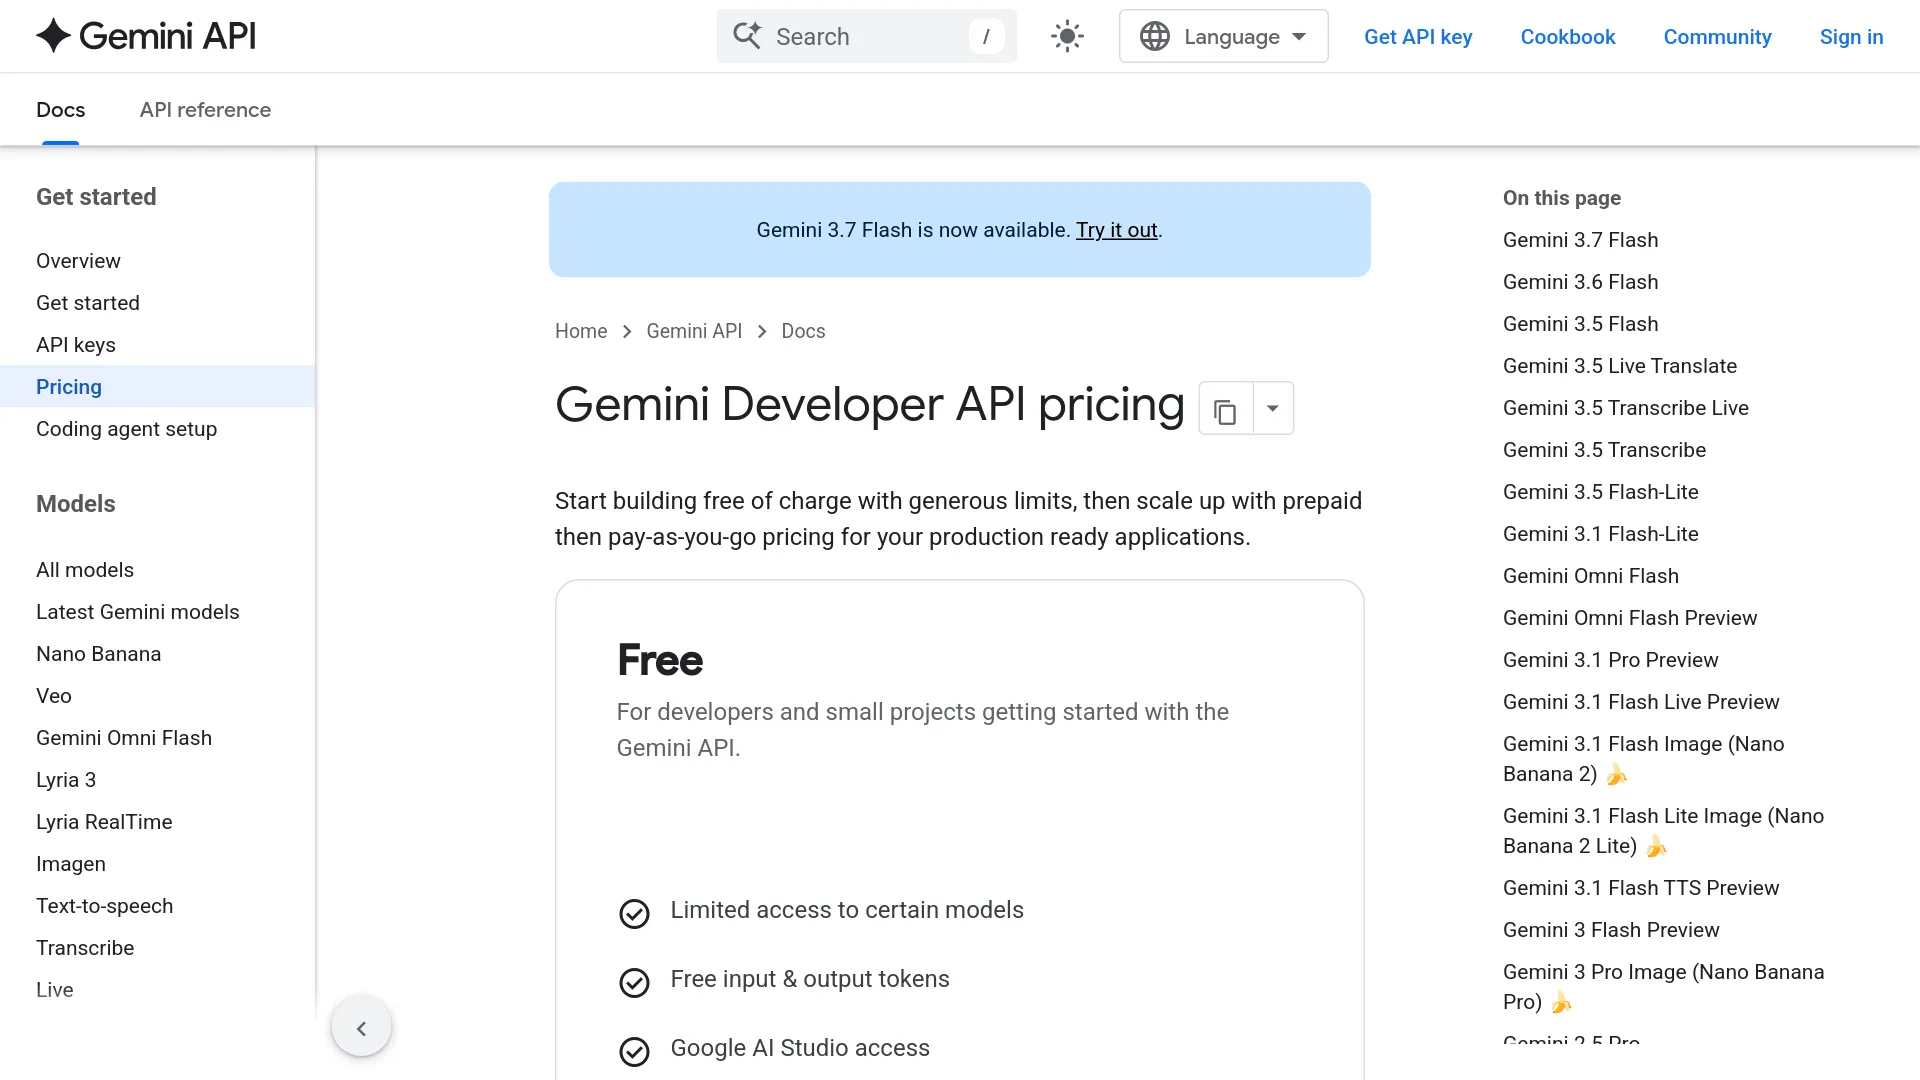
Screenshot acquisito dalla pagina pubblica dei prezzi Google; verifica la tabella aggiornata prima di impegnare volumi significativi. Consulta la documentazione ufficiale sui prezzi della Gemini API.
Calcola il costo della trascrizione accettata sommando utilizzo dell’API, tempo di revisione, tariffa del revisore, retry, storage, conversione ed elaborazione successiva. Le correzioni della modalità Smart o un secondo passaggio di annotazione possono rendere complessivamente più economica un’API dal prezzo superiore, se riducono le correzioni manuali.
FAQ sulla Gemini 3.5 Transcribe API
La trascrizione Smart conserva la formulazione esatta?
No. La modalità Smart modifica disfluenze e autocorrezioni, quindi conserva la modalità verbatim come fonte quando la formulazione esatta è importante.
La Live API fornisce speaker label o timestamp delle parole?
No. Usa il percorso registrato quando servono diarizzazione o timestamp a livello di parola.
Gemini 3.5 Transcribe può gestire una riunione lunga?
Il limite standard per i file registrati è di un’ora, oppure 30 minuti con diarizzazione o timestamp delle parole; Live è limitata a 10 minuti per sessione continua.
È adatta a trascrizioni legali, mediche o di compliance?
Usala soltanto come livello di assistenza, con output verbatim, controlli sui campi critici e revisione umana; non usare l’output Smart come unica registrazione per contesti ad alta posta in gioco.
La decisione: provala, ma non lasciare che diventi la fonte ufficiale per caso
Gemini 3.5 Transcribe è una candidata convincente quando il valore sta nella trascrizione economica, multilingue e sensibile al contesto, non nella riproduzione letterale perfetta. Inizia dal percorso registrato, confronta gli output Smart e verbatim sui tuoi audio e aggiungi le annotazioni solo quando il limite di 30 minuti è accettabile.
Passa a Live per sottotitoli o interfacce vocali dopo aver verificato che il client possa trasmettere in sicurezza il formato PCM richiesto e distinguere il testo provvisorio da quello finalizzato. Per i documenti sensibili, conserva il percorso raw e rendi la revisione umana un criterio di accettazione, non una riparazione d’emergenza dopo che la modalità Smart ha riscritto la fonte.