 AIREITER
Devi trasformare una registrazione in testo utilizzabile oppure generare sottotitoli in streaming dal microfono? Gemini 3.5 Transcribe merita attenzione per la capacità di ripulire il parlato, gestire vocabolari personalizzati e lavorare in più lingue. I due percorsi API, però, hanno limiti molto diversi: il modello per i file è pensato per trascrizioni durature e riutilizzabili, quello Live per sessioni brevi a bassa latenza.
La scelta più pratica: usa l'API per i file, a meno che ti servano sottotitoli in tempo reale
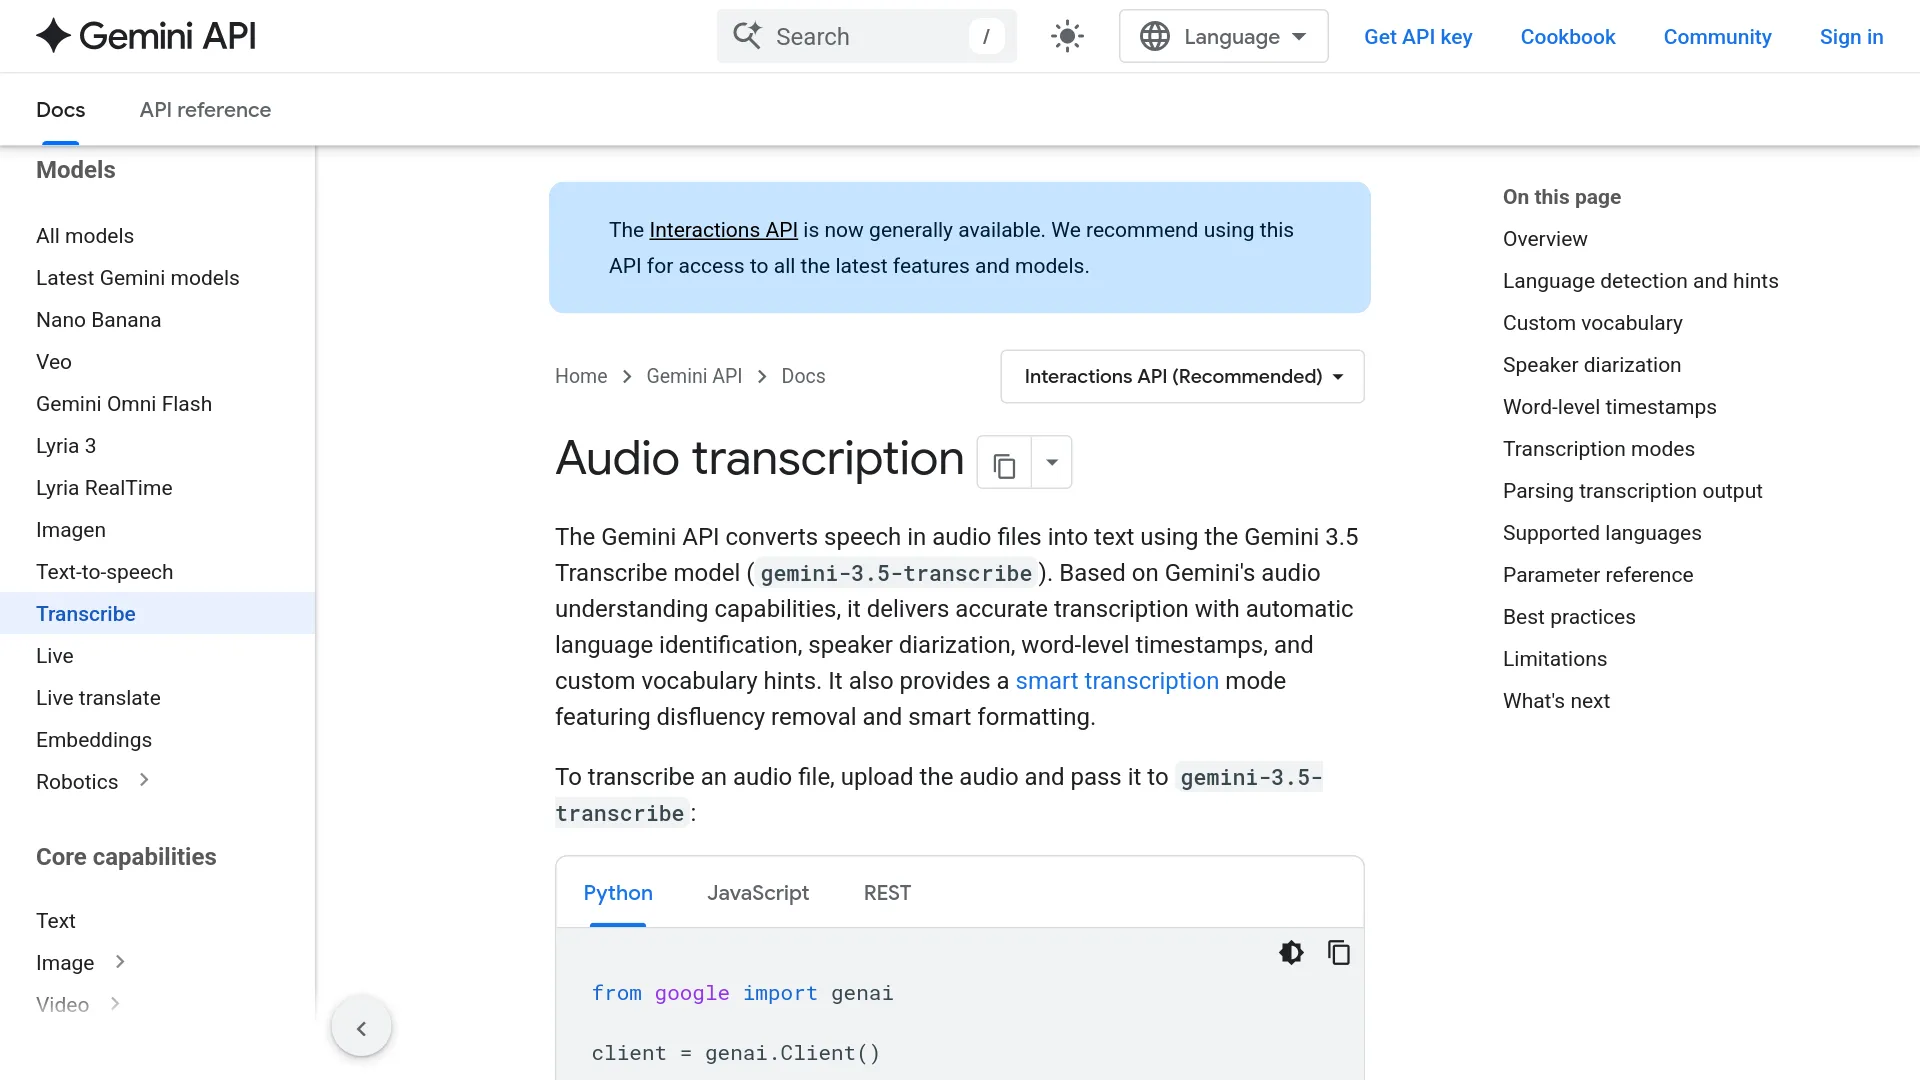
Gemini 3.5 Transcribe è la famiglia di modelli speech-to-text dedicata di Google, disponibile in public preview dal 26 agosto 2026. Google documenta ID dei modelli, sistemi di trasporto, eventi di output e vincoli distinti per l'audio registrato e quello elaborato in tempo reale.
| Esigenza | ID modello | Percorso API | Vincolo importante |
|---|---|---|---|
| Riunioni, chiamate, registrazioni caricate | gemini-3.5-transcribe | Interactions API | Fino a 1 ora per una richiesta unary standard; 30 minuti con diarizzazione o timestamp delle parole |
| Sottotitoli live, input dal microfono, interfacce vocali | gemini-3.5-transcribe-live | Live API | Sessioni continue di 10 minuti; niente diarizzazione live o timestamp a livello di parola |
Per archiviare riunioni, analizzare chiamate o preparare sottotitoli, conviene partire da gemini-3.5-transcribe. Per un'anteprima dei sottotitoli o un'interfaccia push-to-talk, scegli gemini-3.5-transcribe-live. La guida di Google alla trascrizione dell'audio registrato e la guida alla Live API descrivono i due flussi separatamente.
Per ora è disponibile solo in preview
Google ha annunciato Gemini 3.5 Transcribe il 26 agosto 2026 e indica la developer API come disponibile in public preview tramite Google AI Studio e Google Antigravity. Anche l'accesso enterprise è indicato in preview attraverso Gemini Enterprise Agent Platform. Lo stato di preview implica che copertura geografica, quote e stabilità possano differire da quelli di un servizio speech generalmente disponibile: prima di affidargli volumi importanti, è quindi opportuno provarlo con audio rappresentativo del proprio caso d'uso.
Prezzi di Gemini 3.5 Transcribe: come interpretarli in pratica
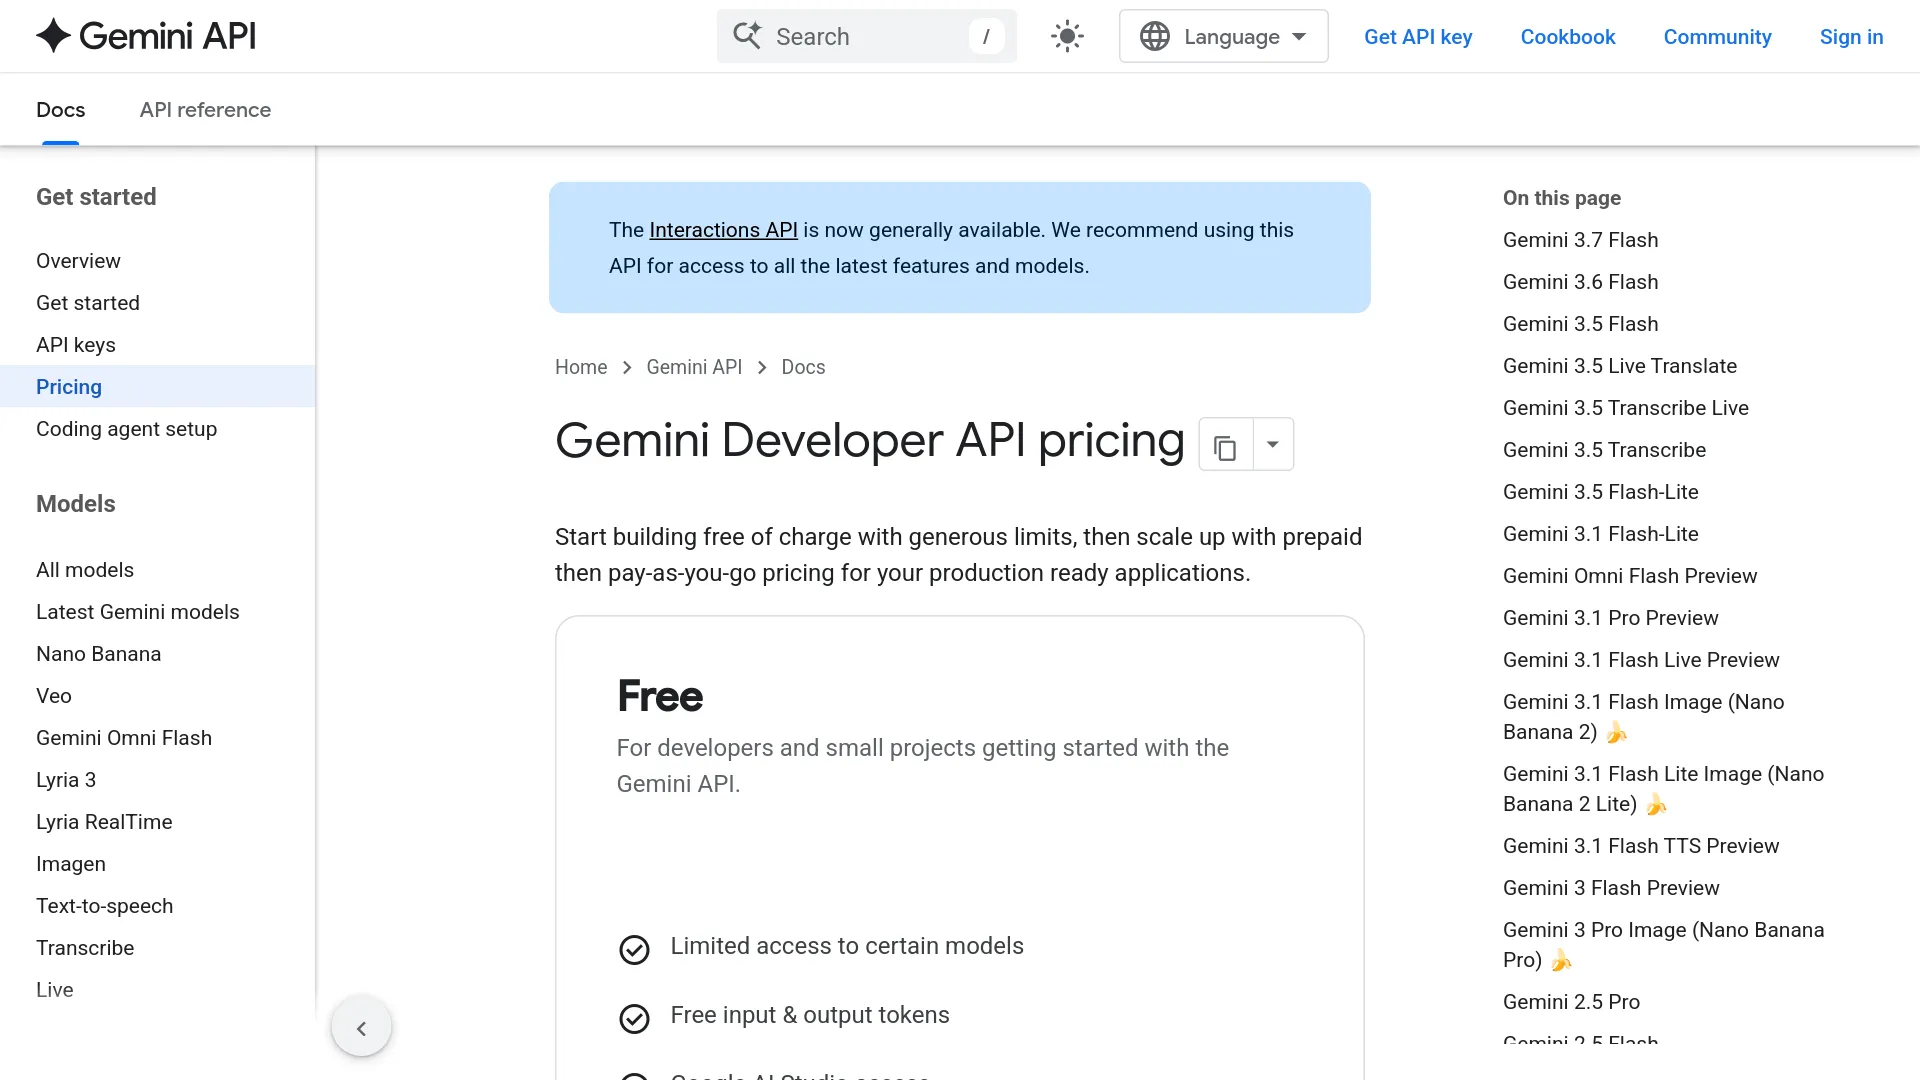
La pagina dei prezzi della Gemini API di Google indica tariffe basate sui token, non un costo fisso per la trascrizione. Il listino attuale riporta 2 $ per milione di token audio in input e 12 $ per milione di token testuali in output per gemini-3.5-transcribe.
Secondo la documentazione audio di Google, l'audio viene rappresentato con 32 token al secondo, cioè 1.920 token audio al minuto. La sola componente audio in input equivale quindi a circa 0,00384 $ al minuto con una tariffa di 2 $ per milione di token, prima di considerare l'output testuale e gli altri token fatturabili.
| Modello | Base tariffaria pubblicata | Stima indicativa combinata | Stima indicativa per 1 ora |
|---|---|---|---|
gemini-3.5-transcribe | 2 $/M token audio in input + 12 $/M token testuali in output | Circa 0,005 $/min | Circa 0,30 $/ora |
gemini-3.5-transcribe-live | Elaborazione live di audio e testo basata sui token | Circa 0,009 $/min | Circa 0,54 $/ora |
Le cifre combinate dipendono dalla quantità di testo prodotto dalla trascrizione: sono quindi stime utili per pianificare i costi, non tariffe al minuto garantite. Output particolarmente densi, contesto ripetuto e istruzioni aggiuntive possono modificare il conto. Prima di impegnare volumi significativi, verifica sempre la tabella dei prezzi aggiornata: le tariffe in preview possono cambiare.
Le differenze tra funzionalità da valutare in produzione
Trascrizione letterale o più leggibile
VERBATIM è la modalità predefinita nella documentazione di Google sulla trascrizione. Mantiene intercalari, ripetizioni, pause, false partenze e correzioni pronunciate dall'interlocutore. È la scelta giusta quando la trascrizione deve fungere da verbale, prova, base per sottotitoli o input per un controllo qualità.
SMART interviene invece sulla leggibilità. Elimina le esitazioni, risolve le autocorrezioni, aggiunge punteggiatura e struttura e può formattare date, valute, numeri, elenchi e paragrafi. La frase pronunciata “Tuesday—no, Wednesday” può diventare “Wednesday” nel risultato ripulito.
La modalità Smart non è compatibile con la diarizzazione dei parlanti né con i timestamp a livello di parola. Se l'applicazione deve produrre appunti leggibili senza perdere la possibilità di verificare l'audio, richiedi prima l'output verbatim e crea separatamente una copia ripulita.
Vocabolario personalizzato e passaggi tra lingue
Google documenta il rilevamento automatico della lingua per oltre 85 aree locali, compresi i casi di code-switching. Quando la lingua è nota, puoi indicare un codice BCP-47 come en-US o es-ES per orientare il riconoscimento.
Il vocabolario personalizzato accetta fino a 1.000 termini, ma le indicazioni pratiche di Google suggeriscono che i risultati siano generalmente migliori con 100 termini o meno. Inserisci nomi distintivi di prodotti, acronimi, nomi propri, termini medici o parole tecniche, evitando elenchi di vocaboli comuni.
Etichette dei parlanti e timestamp delle parole
L'audio registrato può restituire l'attribuzione dei parlanti e la temporizzazione a livello di parola. La documentazione dell'API indica un massimo di otto parlanti, mentre il post di lancio di Google evidenzia l'attribuzione fino a tre persone e definisce sperimentale il supporto per tre o più parlanti.
I timestamp delle parole si attivano in modalità verbatim e forniscono l'offset iniziale e finale di ogni parola. Google avverte che possono ridurre l'accuratezza complessiva della trascrizione. Diarizzazione e timestamp riducono inoltre il limite standard di durata dell'audio da un'ora a 30 minuti.
| Requisito | Supportato? | Nota |
|---|---|---|
| Etichette dei parlanti nell'audio registrato | Sì | Fino a 8 secondo la documentazione; l'attribuzione per 3 o più parlanti è sperimentale |
| Timestamp a livello di parola nell'audio registrato | Sì | Solo in modalità verbatim; possono ridurre l'accuratezza |
| Etichette dei parlanti nella trascrizione live | No | Quando l'attribuzione è importante, usa l'audio registrato |
| Timestamp a livello di parola nella trascrizione live | No | L'output live è incrementale e organizzato per enunciati |
| Modalità Smart con etichette o timestamp | No | Per queste annotazioni devi scegliere la modalità verbatim |
Come inviare un file registrato alla Gemini 3.5 Transcribe API
La guida di Google all'audio registrato descrive tre passaggi: caricare il file, passare l'URI restituito alla Interactions API e leggere la trascrizione completata da interaction.output_text.
- Carica l'audio con la Files API. È il percorso indicato per registrazioni più lunghe di pochi secondi o per file che utilizzerai più volte.
- Conserva l'URI del file restituito e il relativo MIME type, ad esempio
audio/mp3. - Invia l'URI a
gemini-3.5-transcribetramite la Interactions API. - Leggi il testo prodotto e, se richiesto, controlla le annotazioni
word_infoper ottenere informazioni su parlanti e temporizzazione.
Il flusso con l'SDK ufficiale può essere ridotto al seguente esempio di caricamento e trascrizione:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Dopo che il caricamento tramite la Files API ha restituito FILE_URI, una richiesta REST essenziale è questa:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
Per ottenere una trascrizione ripulita, aggiungi una configurazione di trascrizione con la modalità Smart:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
Per etichette dei parlanti e temporizzazione delle parole, usa invece la modalità verbatim:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Non combinare la configurazione Smart con diarizzazione o timestamp. Le regole documentate per le modalità dell'API rendono questa una scelta progettuale, non una semplice preferenza di formattazione.
Come funziona la trascrizione live
La Live API apre una connessione bidirezionale in streaming usando gemini-3.5-transcribe-live. Il client invia audio continuo e riceve due tipi di evento testuale:
interim_input_transcription: un'ipotesi aggiornata a bassa latenza, utile per sottotitoli o anteprime nell'interfaccia.input_transcription: testo definitivo da salvare nella trascrizione o nello stato dell'applicazione.
La guida live di Google specifica audio raw PCM a 16 bit, 16 kHz, mono, little-endian. Raccomanda blocchi di circa 100 millisecondi, con approssimativamente 1.024–2.048 frame per blocco. I client browser e mobile dovrebbero usare token effimeri con privilegi limitati invece di esporre una normale chiave API; gli esempi di Google impiegano un token monouso con scadenza di 30 minuti.
L'endpoint live supporta il rilevamento automatico della lingua, gli hint BCP-47, il vocabolario personalizzato e l'output VERBATIM o SMART. Non supporta la diarizzazione live né i timestamp a livello di parola. Una sessione continua è limitata a 10 minuti; per flussi più lunghi servono quindi una gestione delle sessioni a livello applicativo e l'unione delle trascrizioni.
Per individuare i confini tra i turni di parola, la Live API offre tre approcci:
- VAD automatico: il server rileva l'inizio e la fine del parlato.
- VAD ibrido: un rilevatore lato client segnala la fine del parlato, mentre il rilevamento del server resta disponibile come fallback.
- VAD manuale: un'interfaccia push-to-talk invia esplicitamente gli eventi di inizio e fine dell'attività.
Cosa dimostrano le prime evidenze — e cosa no
Google riporta valori medi di WER pari al 4,0% per lo streaming e al 2,6% per il non-streaming, sulla base di Artificial Analysis. Il post di lancio cita inoltre risultati FLEURS con WER del 5,50% in streaming e WER del 5,04% in non-streaming, oltre a un miglioramento del 70% nel tempo necessario per ottenere la trascrizione finale rispetto a Chirp 3.
Si tratta di dati riportati da Google o citati dall'azienda come evidenza di lancio, non di un test comparativo indipendente testa a testa su Gemini 3.5 Transcribe. Il benchmark STT pubblico di koedesk ha misurato Gemini 3.5 Flash e altri motori, ma non Gemini 3.5 Transcribe direttamente.
I primi utenti stanno verificando soprattutto i limiti di durata per file e sessioni live, i transcript di riferimento per il WER e l'affidabilità nella trascrizione di numeri di telefono o ID ordine durante i passaggi con audio pulito. Prova nomi, ID, numeri, cambi di parlante, precisione temporale e latenza su audio rappresentativo, senza affidarti soltanto al WER medio.
Quando scegliere Gemini 3.5 Transcribe e quando aspettare
| Scenario | Compatibilità | Configurazione iniziale consigliata |
|---|---|---|
| Appunti puliti di riunioni o dettatura | Ottima | File API, SMART, hint esplicito sulla lingua se conosciuta |
| Verbale legale, di compliance o d'archivio | Condizionata | File API, VERBATIM; revisione manuale dei passaggi critici |
| Chiamate registrate con più parlanti | Condizionata | File API, VERBATIM + diarizzazione; sessioni di massimo 30 minuti |
| Sottotitoli sincronizzati a livello di parola | Condizionata | File API, VERBATIM + timestamp delle parole; verifica di tempi e accuratezza |
| Sottotitoli live | Ottima per sessioni brevi | Live API, usa solo gli eventi finali per il testo da salvare |
| Agente vocale attivo a lungo | Richiede lavoro di sviluppo | Segmenta le sessioni prima del limite di 10 minuti e gestisci le riconnessioni |
| Elaborazione offline o locale di dati riservati | Scarsa | Il flusso documentato invia l'audio al servizio di Google; valuta un percorso ASR self-hosted |
Gemini 3.5 Transcribe dà il meglio quando la trascrizione è il primo passaggio di un flusso più ampio: ripulire il parlato, conservare il vocabolario tecnico, identificare i parlanti e inoltrare testo strutturato alle fasi successive. È meno adatto quando serve soltanto una trascrizione letterale economica o quando l'elaborazione offline è un requisito obbligatorio.
FAQ sulla Gemini 3.5 Transcribe API
Gemini 3.5 Transcribe è gratuito?
Google indica un piano gratuito per l'utilizzo della Gemini API, ma quote e disponibilità dei modelli possono cambiare. L'utilizzo a pagamento è basato sui token; la pagina dei prezzi mostra attualmente stime indicative combinate di circa 0,005 $ al minuto per la trascrizione registrata e 0,009 $ al minuto per il modello live.
Qual è la differenza tra i modelli file e live?
gemini-3.5-transcribe elabora registrazioni caricate tramite la Interactions API e supporta diarizzazione e timestamp delle parole per l'audio registrato. gemini-3.5-transcribe-live trasmette PCM raw attraverso la Live API, restituisce eventi provvisori e finali ed è limitato a sessioni di 10 minuti, senza diarizzazione live né timestamp a livello di parola.
Posso elaborare una registrazione di tre ore con una sola richiesta?
Non con la configurazione dedicata alla trascrizione registrata. Il limite standard per una richiesta unary è di un'ora, mentre diarizzazione o timestamp delle parole lo riducono a 30 minuti. Per un flusso più lungo servono suddivisione in segmenti a livello applicativo e una gestione attenta della continuità del contesto e dei parlanti.
Posso usare Gemini 3.5 Transcribe offline?
Il flusso documentato carica o trasmette l'audio al servizio di Google. Google non descrive una versione offline o self-hosted di Gemini 3.5 Transcribe.
La prima integrazione più sicura
Inizia con un campione del tuo flusso di lavoro reale, non con una clip dimostrativa pulita. Elabora lo stesso audio due volte: prima in modalità verbatim per misurare la fedeltà, poi in modalità Smart per valutare la leggibilità. Misura separatamente nomi propri, numeri, cambi di parlante, deriva dei timestamp e costi.
Conserva la trascrizione raw come fonte primaria, usa l'output Smart per gli appunti destinati agli utenti e prevedi un fallback per gli errori di caricamento o per eventuali cambiamenti del modello in preview. Passa alla Live API solo quando il client è in grado di gestire blocchi PCM da 100 millisecondi, eventi provvisori e finali, token effimeri e il limite di 10 minuti per sessione.