 AIREITER
Non esiste un vincitore valido per ogni scenario: conta la forma del carico di lavoro. Claude Opus 5 è la scelta iniziale più prudente per attività circoscritte e con molto output, mentre Claude Fable 5.1 è il modello specialistico da mettere alla prova per agenti di lunga durata e contesti riutilizzabili particolarmente estesi. Il risparmio più evidente di Fable 5.1 deriva dalle letture della cache, non da tariffe inferiori per input o output.
La scelta tra Fable 5.1 e Opus 5 dipende dal carico di lavoro
Per la maggior parte dei team, la strategia iniziale è usare Opus 5, aumentarne l'effort quando un'attività richiede più ragionamento e inviare a Fable 5.1 soltanto i casi complessi che hanno già dimostrato di averne bisogno. Anche la documentazione di Anthropic per Fable 5.1 suggerisce in linea generale questo approccio: partire da Opus 5 per la maggior parte dei workload e passare a Fable 5.1 quando le valutazioni di Opus 5 con effort più elevato non soddisfano il requisito.
| Se il vincolo principale è… | Parti da… | Perché |
|---|---|---|
| Richieste brevi o circoscritte | Opus 5 | Le sue tariffe di input e output sono la metà di quelle di Fable 5.1. |
| Traffico di produzione con molto output | Opus 5 | Il minor costo delle letture cache di Fable non riduce il prezzo dei token generati. |
| Coding multi-file con una specifica definita | Opus 5 | Il costo inferiore rende più sostenibili retry ripetuti e un effort maggiore. |
| Agenti di lunga durata che usano tool | Fable 5.1—dopo una valutazione | Fable guida i confronti pubblicati da Anthropic su agenti e uso dei tool. |
| Contesti molto ampi riutilizzati ripetutamente tra i turni | Fable 5.1—dopo una modellazione dei costi | Il prezzo delle sue letture cache è la metà di quello di Opus 5. |
| Un router di produzione sensibile ai fallback | Prima Opus 5 | Fable 5.1 cambia il comportamento di thinking block e cronologia della conversazione. |
Il confronto corretto è tra Opus 5 con l'effort e il costo adeguati e Fable 5.1 con la giusta struttura del contesto e soglia di affidabilità.
In cosa differiscono davvero Fable 5.1 e Opus 5?
Claude Fable 5.1 è il modello di fascia più alta di Anthropic per ragionamento impegnativo e lavoro agentico su orizzonti lunghi; Claude Opus 5 è proposto come modello meno costoso per coding serio, agenti e lavoro professionale. Entrambi offrono una finestra di contesto da 1 milione di token e un output massimo di 128.000 token: il punto di forza di Fable è quindi l'esecuzione di lunga durata, non un limite di contesto pubblicato più ampio.
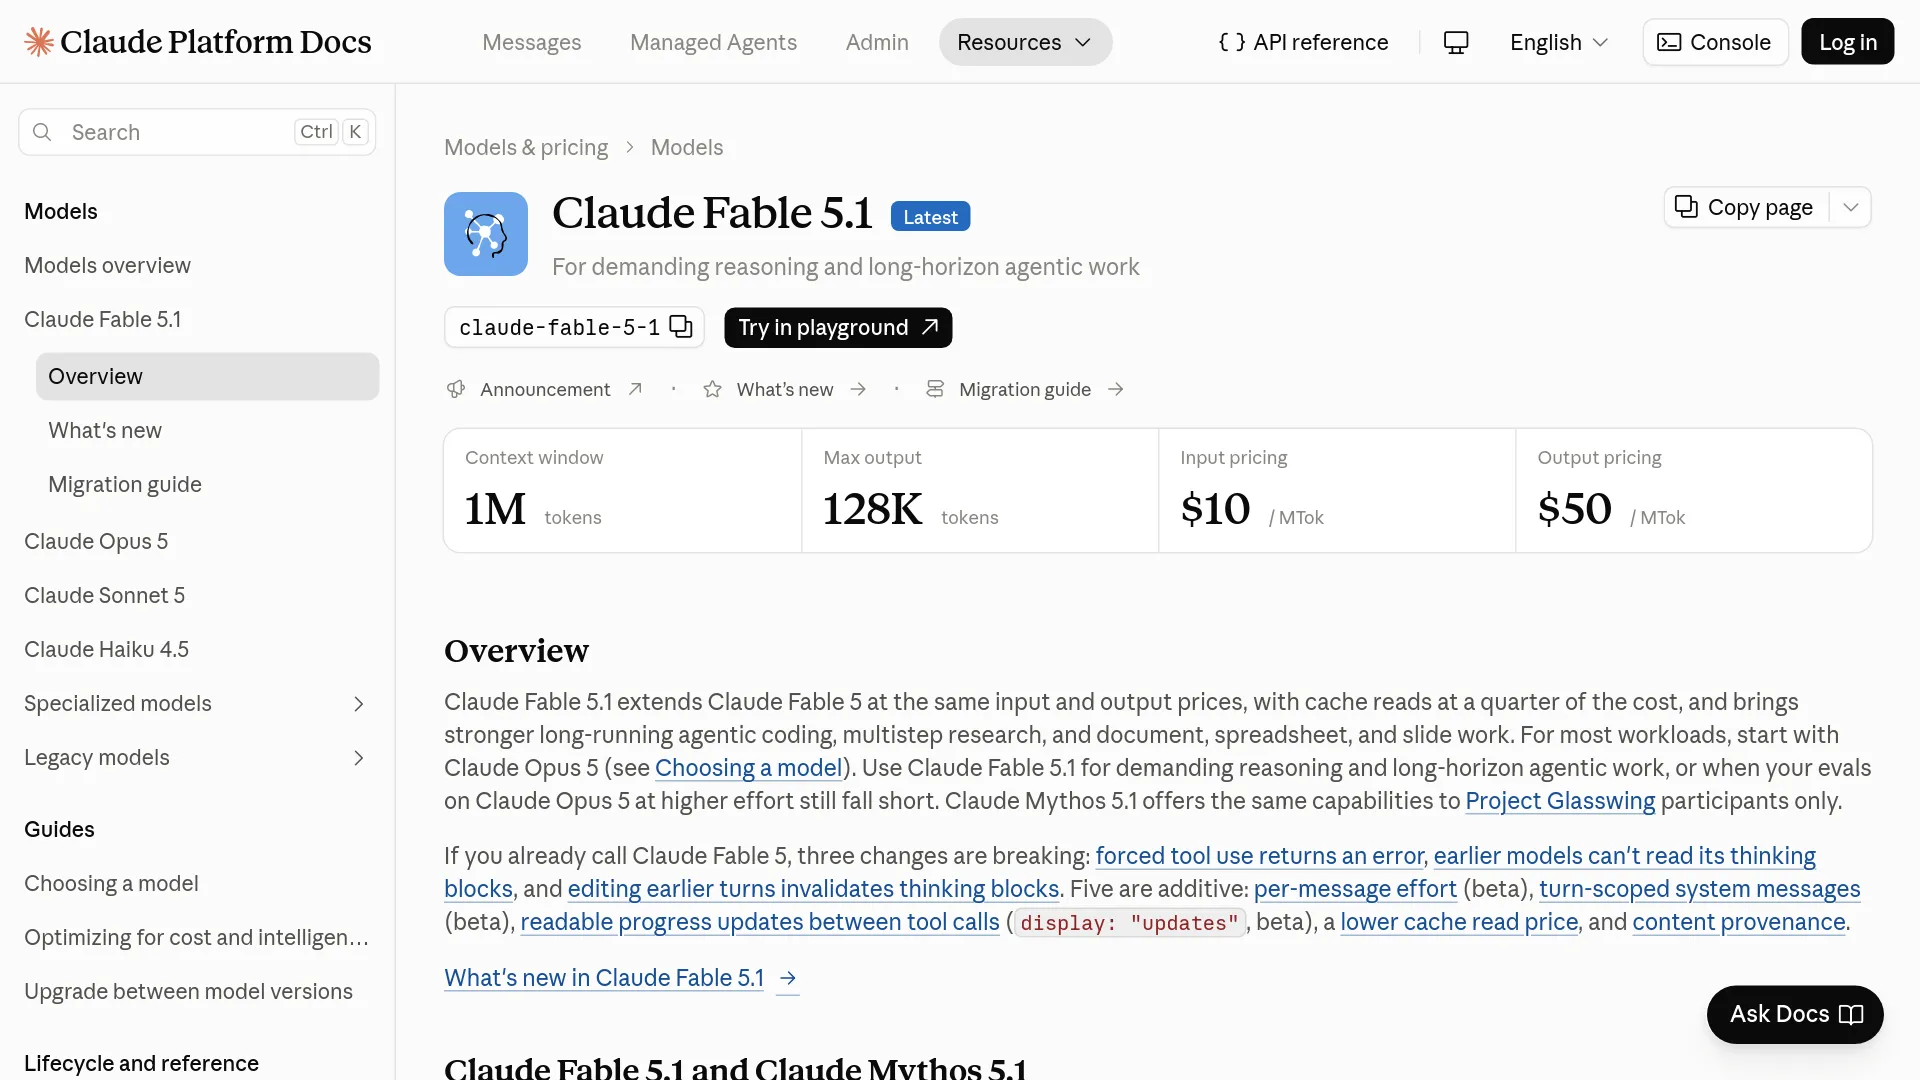
| Specifica | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| ID modello API | claude-fable-5-1 | claude-opus-5 |
| Finestra di contesto | 1 milione di token | 1 milione di token |
| Output massimo | 128.000 token | 128.000 token |
| Modalità di input | Testo e immagini | Testo e immagini |
| Modalità di output | Testo | Testo |
| Thinking | Adattivo, sempre attivo | Ragionamento regolato dall'effort |
| Controlli dell'effort | low, medium, high, xhigh, max | Livelli di effort configurabili |
| Posizionamento secondo Anthropic | Ragionamento impegnativo e agenti di lunga durata | La maggior parte dei workload e coding serio |
| Stato di rilascio | Attivo/più recente; rilasciato il 1 settembre 2026 | Modello Opus attivo; rilasciato il 24 luglio 2026 |
Per ID modello e disponibilità specifici del deployment, consulta la pagina del modello Fable 5.1 e la pagina prodotto Claude Opus 5.
I benchmark premiano Fable 5.1, ma non in ogni situazione
La tabella dei benchmark pubblicata da Anthropic attribuisce a Fable 5.1 un vantaggio su Opus 5 in ogni riga riportata per entrambi i modelli. Si tratta però di test condotti dal fornitore: sono indicazioni utili sulla valutazione di lancio, non una garanzia per la produzione.
| Valutazione Anthropic | Fable 5.1 | Opus 5 | Vantaggio Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 23.6 punti |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 3.5 punti |
| GDPval-AA v2 | 1,853 Elo | 1,824 Elo | 29 Elo |
| OSWorld 2.0, strict | 41.7% | 39.6% | 2.1 punti |
| Humanity’s Last Exam, con tool | 65.0% | 63.6% | 1.4 punti |
| AutomationBench | 31.4% | 26.9% | 4.5 punti |
| CursorBench 3.2.0 | 73.4% | 70.0% | 3.4 punti |
Anthropic dichiara che erano attive protezioni di produzione e che alcuni interventi potevano portare a punteggi pari a zero o instradare il lavoro verso modelli di fallback. Riporta inoltre un errore standard di circa 3.5–4.5 punti percentuali per modello su Terminal-Bench-Science 0.1. Uno scarto di 23.6 punti è quindi più significativo di una differenza di 1.4 punti su Humanity’s Last Exam.
Una valutazione di terze parti di CodeRabbit su 45 task con 105 punti di problema noti ha registrato per Fable 5.1 un recall del 61.0% e una precision del 37.3%, contro un recall del 55.2% e una precision del 39.3% per Opus 5; entrambi hanno prodotto 166 commenti elaborati, ma gli autori avvertono che le configurazioni erano differenti.
“Fable 5.1 is a specialist reviewer.” — descrizione di CodeRabbit del risultato della sua valutazione (CodeRabbit)
I prezzi API cambiano il confronto concreto
Fable 5.1 costa il doppio di Opus 5 per input e output non in cache, ma le sue letture cache costano la metà. Ne risulta un punto di pareggio nelle lunghe sessioni agentiche ripetitive; non significa che ogni richiesta a Fable 5.1 costi meno.
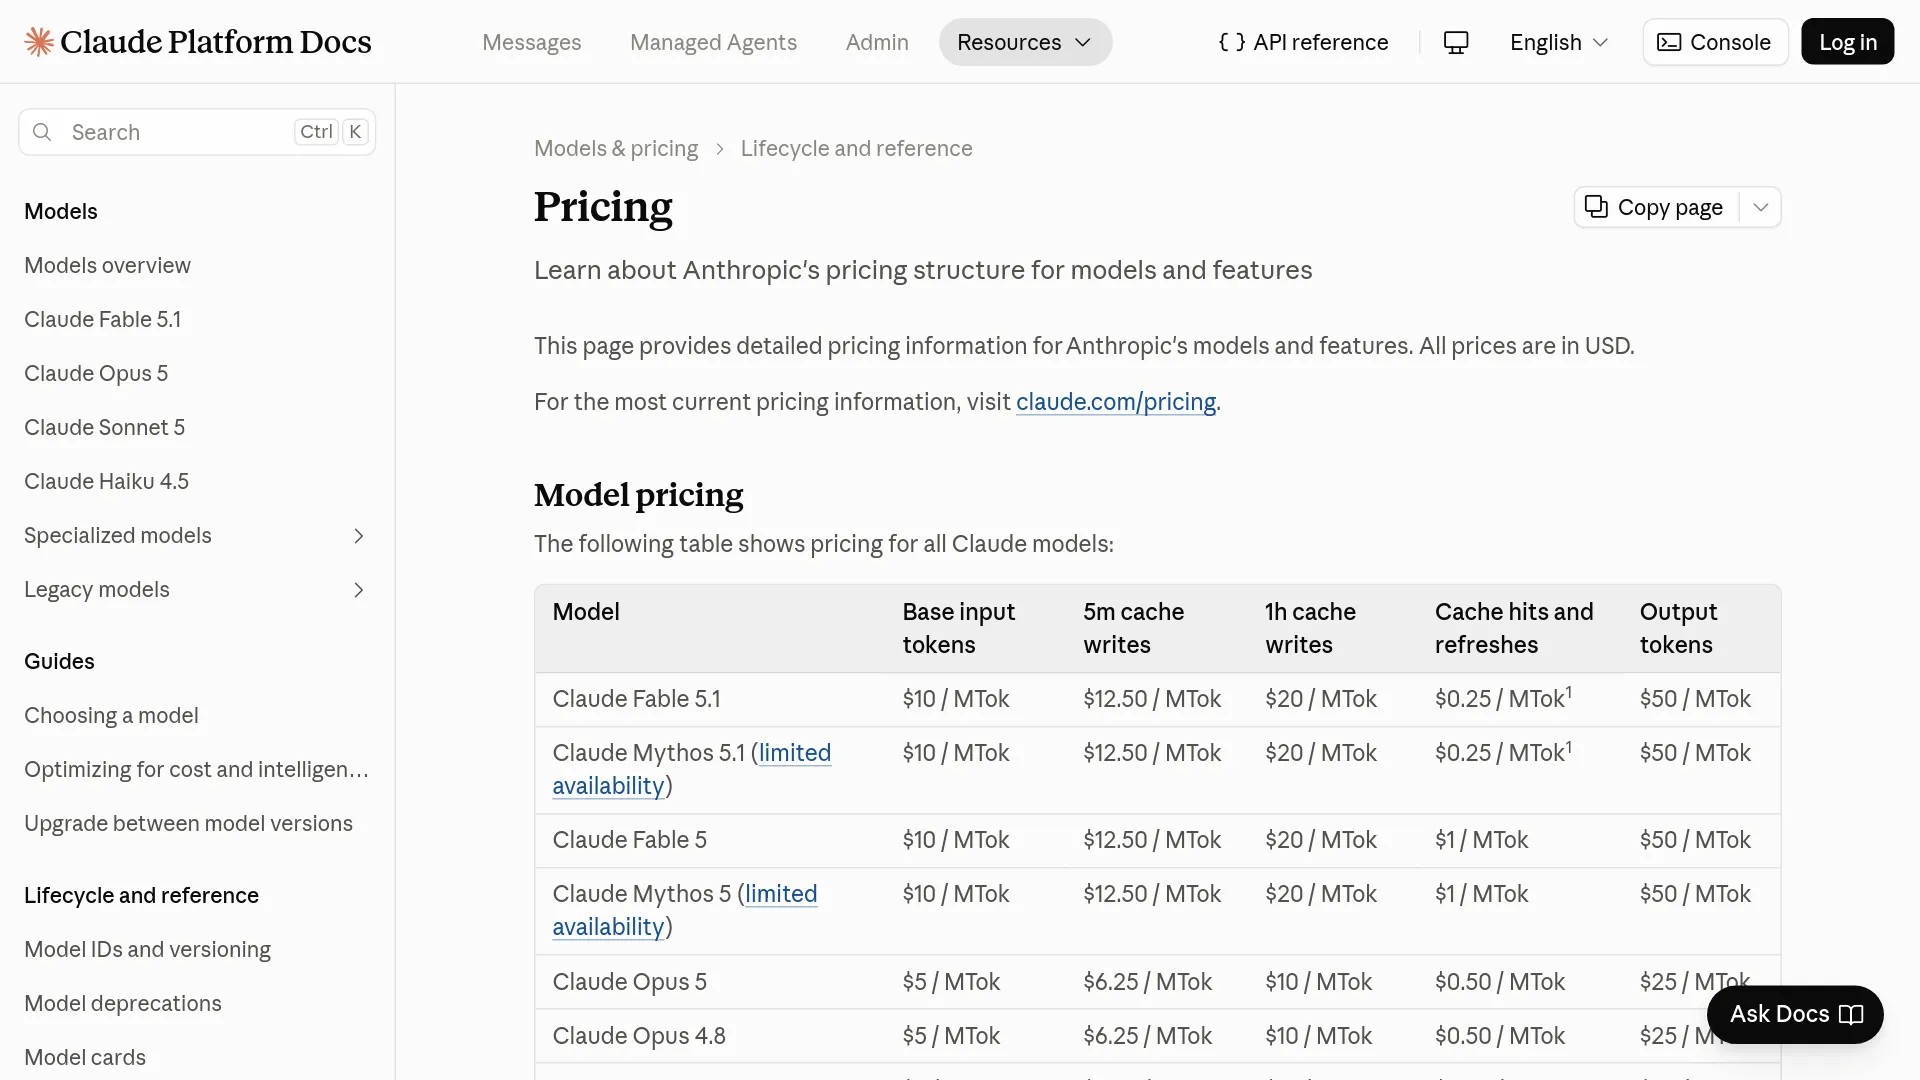
Le seguenti tariffe provengono dalla documentazione aggiornata sui prezzi API di Anthropic e sono espresse in USD per milione di token.
| Voce di fatturazione | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| Input base | $10.00 | $5.00 |
| Scrittura cache di 5 minuti | $12.50 | $6.25 |
| Scrittura cache di 1 ora | $20.00 | $10.00 |
| Lettura cache | $0.25 | $0.50 |
| Output | $50.00 | $25.00 |
| Input / output batch | $5.00 / $25.00 | $2.50 / $12.50 |
I prezzi di input e output di Fable 5.1 non cambiano rispetto a Fable 5. La novità alla base del risparmio pubblicizzato è la tariffa per la lettura cache: $0.25 per milione di token, in calo rispetto a $1.00 di Fable 5. Anthropic stima un costo tipico del workload inferiore di circa il 25% e fino a circa il 45% in meno per workload altamente agentici, ma si tratta di stime legate al tipo di attività, non di uno sconto universale.
Un calcolo per turno chiarisce il compromesso. Sia C il contesto in cache, I l'input nuovo e O l'output, tutti misurati in milioni di token. Escludendo i costi di scrittura della cache, Fable 5.1 costa 10I + 0.25C + 50O; Opus 5 costa 5I + 0.50C + 25O.
Le letture cache meno costose di Fable compensano le sue tariffe più alte per input nuovo e output soltanto quando:
0.25C > 5I + 25O
Con un prompt nuovo di 2.000 token e una risposta di 1.000 token, I = 0.002 e O = 0.001. Il contesto in cache deve superare approssimativamente i 140.000 token prima che, considerando solo le letture, l'aritmetica favorisca Fable. Includendo i costi di scrittura della cache, il punto di pareggio si sposta ancora più avanti.
Ecco perché attività brevi di estrazione, classificazione, riscrittura e chiamate di coding one-shot non dovrebbero passare a Fable 5.1 per ragioni di prezzo. Il prefisso riutilizzabile da scontare è minimo o inesistente, mentre ogni token generato costa il doppio rispetto a Opus 5.
Dove si inserisce ciascun modello nei workflow reali
La distinzione pratica è fra esecuzione circoscritta e persistenza su orizzonti lunghi. Opus 5 è più facile da giustificare quando il task è ben specificato o genera molto output; Fable 5.1 diventa più interessante quando un agente deve mantenere un piano, usare ripetutamente i tool, recuperare dagli errori e portare un contesto ampio attraverso molti turni.
Agenti di coding: conta il lavoro completato, non la posizione in classifica
Per il normale lavoro su repository, Opus 5 è il primo test più indicato: bug fix circoscritti, refactoring definiti, code review e task in cui il minor costo consente retry o effort più elevato. Fable 5.1 merita invece un pilota per modifiche multi-file, migrazioni, debugging a livello di sistema e sessioni di coding asincrone in cui un fallimento tardivo costa più di una risposta lenta.
I feedback della community evidenziano due rischi operativi diversi. In un'ampia discussione su r/ClaudeCode, l'utente u/CyCoCyCo ha scritto:
“The only way I’ve had success is to have it make goal prompts and run that end to end.” — u/CyCoCyCo su Reddit
È la testimonianza di un problema di prompting e workflow, non la prova che Opus 5 fallisca su ogni codebase. Nella stessa discussione, altri utenti hanno descritto problemi nelle attività più lunghe e ricche di contesto, fra cui deriva dalle istruzioni e fix che introducevano nuovi difetti.
Fable 5.1 presenta un diverso profilo di lamentele: in una discussione sul rilascio, alcuni utenti hanno segnalato un consumo insolitamente rapido di token o quota. Il dato è aneddotico e non dimostra un limite universale degli abbonamenti, ma è un motivo per monitorare l'utilizzo durante un pilota invece di giudicare il modello solo dalla qualità dell'output.
Un pilota sensato per un agente di coding registra:
- Task completati senza intervento umano.
- Bug riaperti o regressioni dopo che il modello dichiara il successo.
- Token totali di input, input in cache e output.
- Tempo effettivo e numero di chiamate ai tool.
- Tempo di correzione umano e costo dei run falliti nelle fasi finali.
Ricerca e documenti complessi: il caso per Fable è più netto
Fable 5.1 è il candidato più solido quando il lavoro coinvolge un insieme documentale molto ampio, chiamate ripetute ai tool, grafici visivi, ricerca multi-step o un deliverable che deve reggere diverse revisioni. Anthropic lo posiziona specificamente per documenti, fogli di calcolo, slide, diagrammi, tabelle e ricerca di lunga durata.
Opus 5 ha la stessa capacità di contesto da 1 milione di token ed è anch'esso descritto da Anthropic come capace di gestire documenti complessi e agenti sofisticati. Se il lavoro consiste in una singola analisi con un output generato sostanzioso, la tariffa più bassa di Opus può contare più del vantaggio di Fable sulla cache. Esegui un campione rappresentativo prima di trattare il vantaggio di Fable nei benchmark come un requisito di produzione.
Computer use e automazione aziendale: va valutata l'intera sequenza
Fable 5.1 supera Opus 5 nelle righe OSWorld e AutomationBench di Anthropic, ma questi compiti misurano una sequenza di azioni anziché una sola risposta. Per un agente browser o di processo aziendale, valuta se il modello raggiunge lo stato finale corretto, quanto spesso deve recuperare e se un'azione fallita compromette il resto dell'esecuzione.
L'unità rilevante è il costo per risultato completato, non soltanto il costo per milione di token. Un modello che evita retry ripetuti in un workflow lungo può risultare conveniente nonostante una tariffa maggiore; un modello che esaurisce il budget di utilizzo prima di raggiungere lo stato finale non lo è.
Dettagli di integrazione da controllare prima del passaggio
La documentazione di migrazione di Fable 5.1 descrive modifiche all'uso forzato dei tool, ai thinking block e alla validazione della cronologia conversazionale. I team che dipendono da un proprio router di messaggi dovrebbero verificarle prima di cambiare il modello predefinito.
| Modifica | Cosa può accadere | Azione di migrazione |
|---|---|---|
| Uso forzato dei tool | tool_choice: {"type":"any"} o la scelta di un tool nominato possono restituire HTTP 400. | Usa auto con istruzioni chiare per i tool oppure structured outputs, quando opportuno. |
| Portabilità dei thinking block | I modelli precedenti non possono leggere i thinking block di Fable 5.1; i turni di fallback possono eliminarli. | Verifica i percorsi di cambio modello e fallback. |
| Modifiche alla conversazione | La modifica di un messaggio precedente, del system prompt o dell'elenco dei tool può invalidare i thinking block successivi. | Tratta la cronologia come append-only oppure usa controlli supportati e circoscritti al turno. |
| Configurazione del thinking | Fable 5.1 usa adaptive thinking e non supporta la disattivazione del thinking nello stesso modo di Opus 5. | Controlla la spesa con le impostazioni di effort e ripeti i test sull'uso dei token. |
Il dettaglio sui fallback è importante nei router multi-modello. Una richiesta Fable 5.1 può proseguire con il proprio contesto di ragionamento, ma un fallback a Opus 5 non può consumare i thinking block di Fable 5.1. Se il router li rimuove silenziosamente, il fallback potrebbe ripianificare il lavoro, aggiungendo latenza e token. Testa sia il percorso di successo sia quello di errore con cronologie simili a quelle di produzione.
Una piccola valutazione vale più di una grande affermazione sul modello
Usa per entrambi i modelli gli stessi prompt, tool, contesto, policy di effort e test di accettazione; altrimenti il confronto tra modelli può trasformarsi in un confronto tra harness.
- Scenario circoscritto: esegui bug fix definiti, estrazione, scrittura strutturata e code review. Misura output utile, tempo di correzione e costo.
- Scenario di lunga durata: esegui una funzionalità multi-file, una migrazione, un task di ricerca o un workflow browser. Misura successo dello stato finale, recupero, regressioni e tempo effettivo.
- Scenario ad alta cache: ripeti un system prompt stabile, un set di tool e un prefisso di repository o documenti. Misura rapporto di cache hit e fattura totale, includendo scritture cache e output.
Inizia con Opus 5 al livello di effort che utilizzeresti davvero in produzione. Poi prova un effort più alto su Opus prima di spostare il task a Fable 5.1. Per Fable, testa almeno medium e high; non presumere che il nome di un effort corrisponda direttamente tra modelli. Anthropic afferma che le impostazioni di effort regolano il compromesso tra profondità e costo, mentre test di terze parti hanno rilevato che un ragionamento più intenso non migliorava automaticamente i risultati aggregati della code review.
FAQ: Fable 5.1 vs Opus 5
Quale modello è migliore per il coding?
Fable 5.1 supera Opus 5 nei risultati pubblicati da Anthropic per Terminal-Bench e CursorBench, ma Opus 5 è il punto di partenza più adatto per la maggior parte delle attività di coding circoscritte e sensibili al costo. Usa una valutazione su un repository rappresentativo per stabilire se la maggiore qualità di completamento di Fable compensa prezzo e latenza.
Fable 5.1 vale il doppio del prezzo API?
Non in automatico. Le sue tariffe di input e output sono il doppio di quelle di Opus 5, mentre le letture cache costano la metà; Fable diventa interessante sul piano economico quando il workload riutilizza ripetutamente un contesto ampio e produce un output relativamente contenuto.
Fable 5.1 ha una finestra di contesto più ampia?
No. Anthropic indica per entrambi i modelli una finestra di contesto da 1 milione di token e un output massimo di 128.000 token. Fable si distingue per il suo posizionamento sul ragionamento a orizzonte più lungo e sulle traiettorie degli agenti, non per una finestra pubblicata più grande.
Conviene aumentare l'effort di Opus 5 prima di cambiare modello?
Sì. Le linee guida di Anthropic raccomandano di valutare Opus 5 con effort più elevato prima di passare a Fable 5.1. Confronta il costo aggiuntivo in token con il miglioramento qualitativo, anziché eseguire ogni richiesta al massimo effort.
Posso fare fallback da Fable 5.1 a Opus 5 in sicurezza?
Puoi costruire questo fallback, ma non dare per scontato che lo stato conversazionale sia portabile. I modelli precedenti non possono leggere i thinking block di Fable 5.1 e la validazione della cronologia di Fable 5.1 può evidenziare router che modificano i turni precedenti; prova il fallback con schemi dei tool e cronologie di messaggi reali.
Dove possono accedere gli sviluppatori a Fable 5.1 e Opus 5?
Anthropic indica entrambi i modelli per i piani Claude e l'accesso degli sviluppatori tramite la propria piattaforma e integrazioni cloud marketplace. Gli ID modello esatti e la disponibilità possono variare in base al provider, quindi verifica l'identificatore specifico del deployment nella documentazione di Fable 5.1 o nella pagina prodotto di Opus 5.
La scelta pratica è una regola di routing, non un upgrade definitivo
| Decisione | Usa Opus 5 | Usa Fable 5.1 |
|---|---|---|
| Modello predefinito per traffico misto | Sì | Solo dopo una valutazione |
| Chiamate brevi one-shot | Sì | Nessun vantaggio di prezzo |
| Generazione con molto output | Sì | Di solito no |
| Prefissi ampi in cache | Confronta con attenzione | Possibile vantaggio di costo |
| Coding autonomo di lunga durata | Prima un pilota | Candidato solido |
| Refactoring strettamente delimitati | Di solito | Se Opus non supera i test di accettazione |
| Automazione browser o multi-step | Prima un pilota | Solido caso nei benchmark |
| Router di fallback personalizzato | Base di riferimento più semplice | Richiede test di migrazione |
Mantieni Opus 5 come riferimento, esegui entrambi i modelli sullo stesso set di task circoscritti e di lunga durata, e instrada verso Fable 5.1 soltanto quando migliora il lavoro completato per dollaro.
Per i dettagli sui costi specifici del modello, consulta Claude Fable 5.1 API pricing; per una panoramica più ampia del modello, consulta Claude Opus 5.