 AIREITER
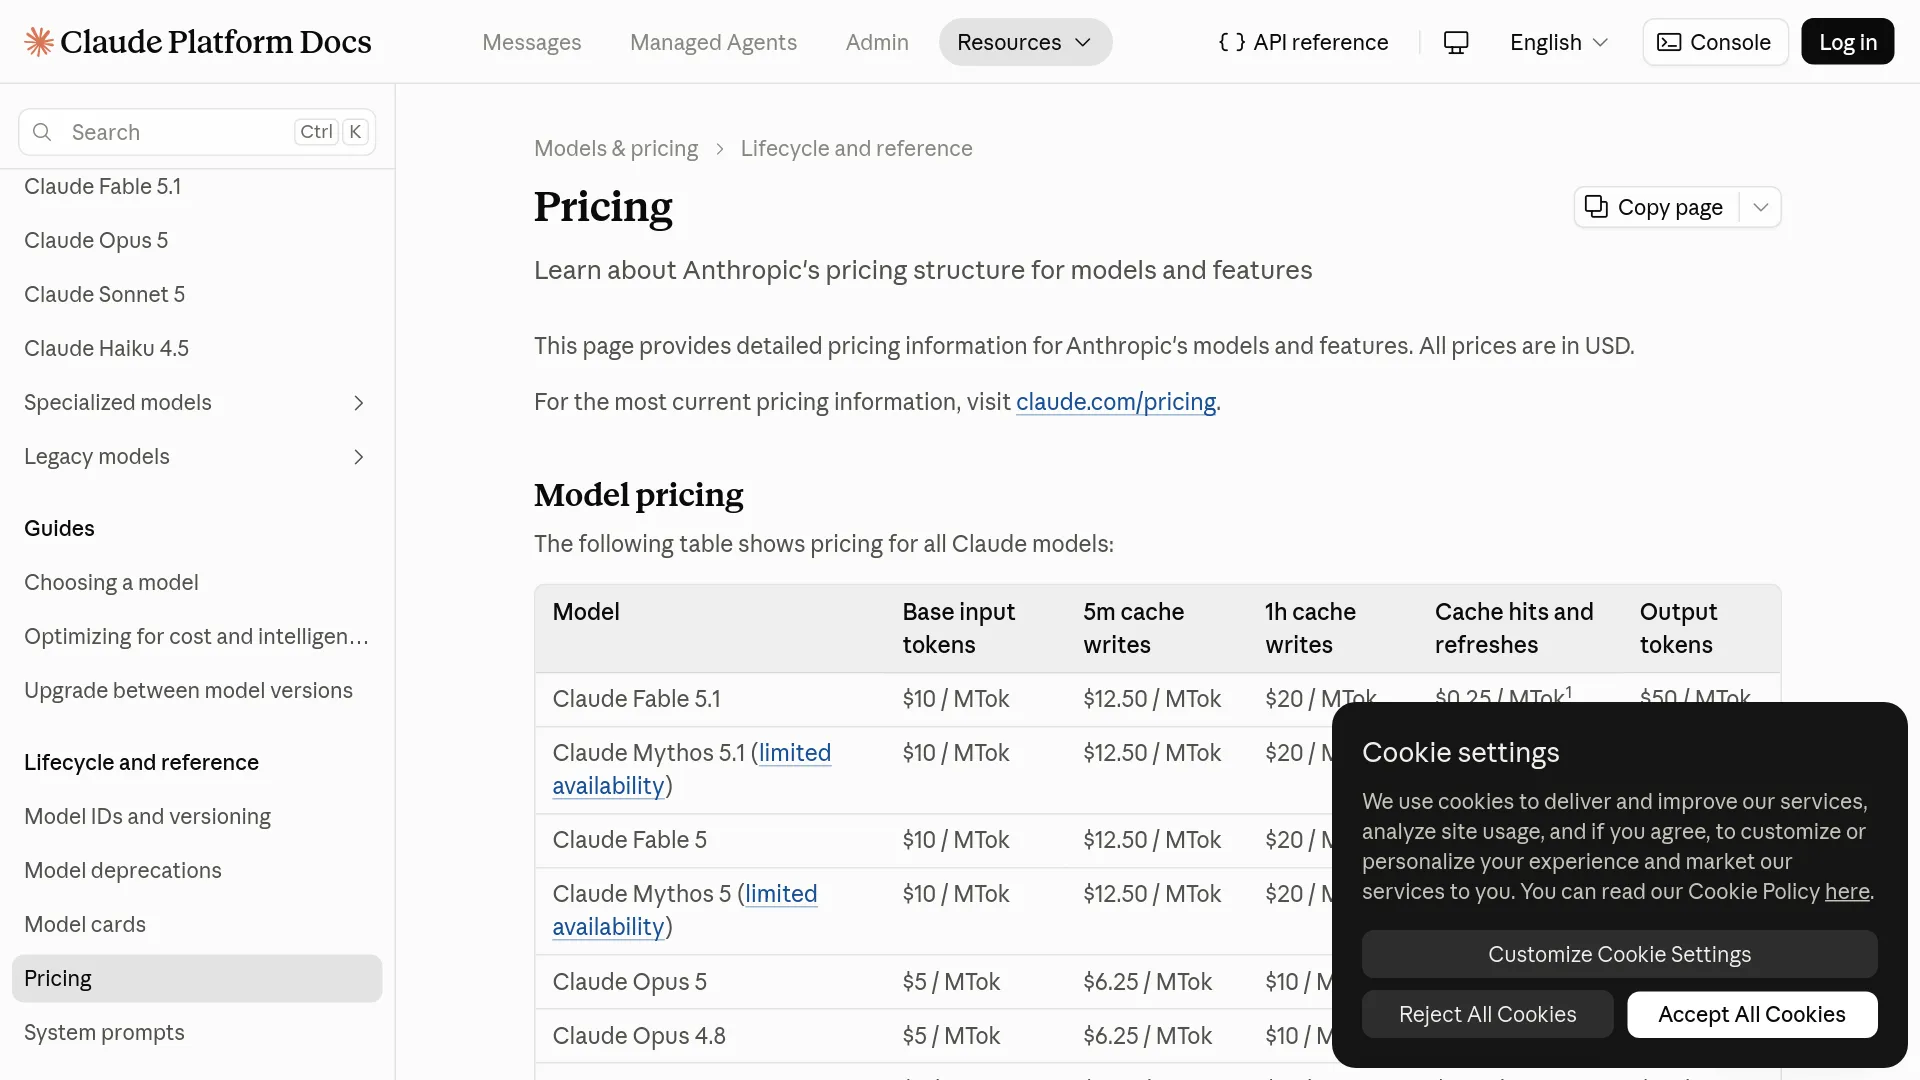
Rileggere 100 volte un contesto da 200.000 token costa $20 con la tariffa cache di Claude Fable 5 e $5 con Fable 5.1. È qui che sta la novità: input a $10 e output a $50 restano invariati, mentre il contesto riutilizzato costa il 75% in meno.
Listino API aggiornato di Claude Fable 5.1
Claude Fable 5.1 costa $10 per milione di token in input e $50 per milione di token in output. Le scritture in cache da 5 minuti e 1 ora restano rispettivamente a $12.50 e $20 per milione di token; le letture dalla cache scendono invece a $0.25 per milione di token.
Anthropic include il modello nell'annuncio ufficiale di Claude Fable 5.1 e nella documentazione aggiornata sui prezzi di Claude Platform. Il nome del modello API è claude-fable-5-1.
| Modello | Input / MTok | Scrittura 5 minuti / MTok | Scrittura 1 ora / MTok | Lettura cache / MTok | Output / MTok |
|---|---|---|---|---|---|
| Claude Fable 5.1 | $10.00 | $12.50 | $20.00 | $0.25 | $50.00 |
| Claude Fable 5 | $10.00 | $12.50 | $20.00 | $1.00 | $50.00 |
| Claude Opus 5 | $5.00 | $6.25 | $10.00 | $0.50 | $25.00 |
| Claude Sonnet 5 | $2.00 | $2.50 | $4.00 | $0.20 | $10.00 |
La tabella riporta prezzi in USD per milione di token, ossia MTok. La lettura cache di Fable 5.1 è un'eccezione al moltiplicatore standard Anthropic di 0.1×: $0.25 equivale a 0.025× della tariffa base di $10 per l'input.
Cosa cambia davvero rispetto a Claude Fable 5
Claude Fable 5.1 non introduce un taglio generale dei prezzi del 75%. Le tariffe per input, output e scrittura in cache rimangono quelle di Fable 5; soltanto la lettura cache passa da $1 a $0.25 per milione di token.
La distinzione è importante perché l'output viene fatturato $50 per milione di token. Un carico di lavoro che produce lunghe tracce di ragionamento, patch estese o risultati di tool ripetuti può quindi restare costoso, anche con un prompt riutilizzabile fortemente memorizzato nella cache.
Il risparmio si vede solo se un prefisso ampio e stabile genera cache hit in più turni del modello. Una richiesta singola con prompt breve ne trae poco vantaggio; un agente che rilegge lo stesso contesto per un periodo prolungato può invece ridurre la spesa sul lato input.
Quanto pesa davvero la cache a $0.25 per MTok
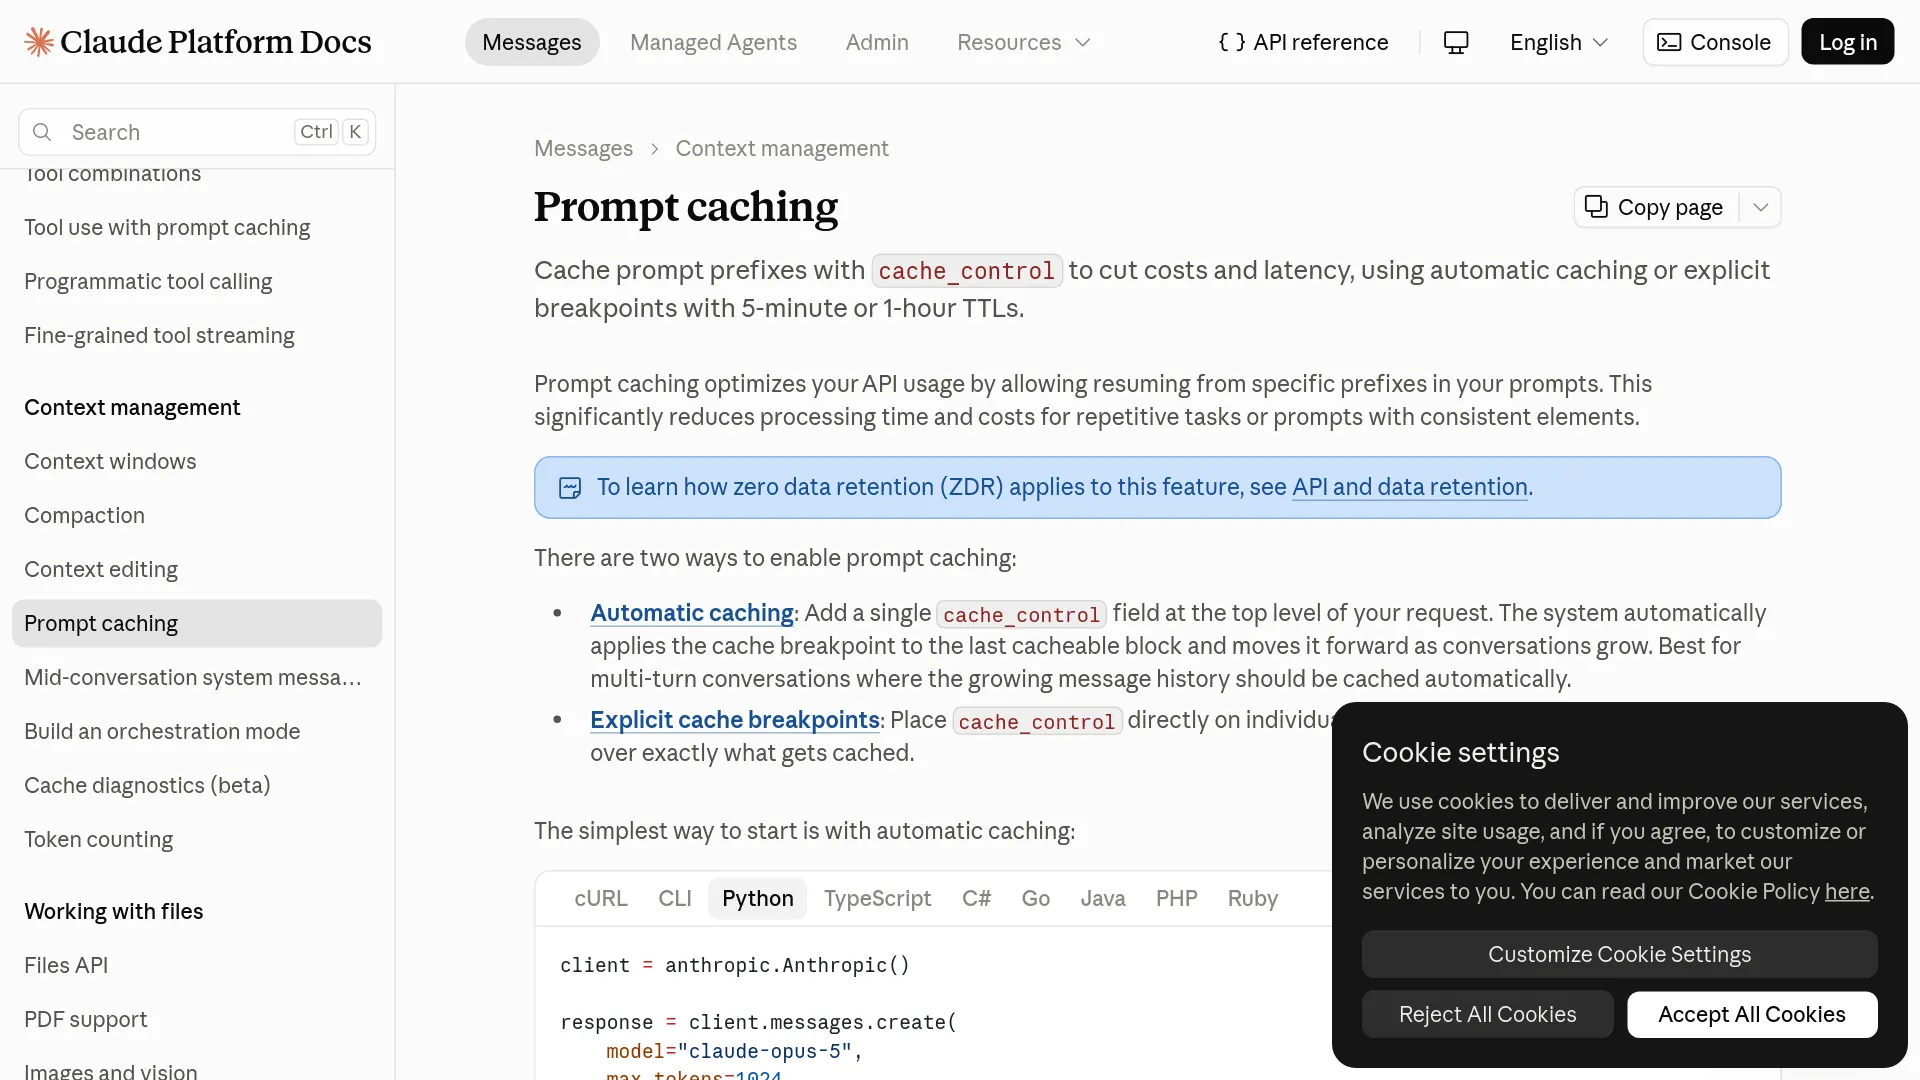
La documentazione sul prompt caching di Anthropic definisce queste operazioni:
| Operazione | Prezzo Fable 5.1 | Durata o condizione della cache |
|---|---|---|
| Input senza cache | $10.00 / MTok | Elaborato normalmente |
| Scrittura cache da 5 minuti | $12.50 / MTok | 1.25× del prezzo base dell'input |
| Scrittura cache da 1 ora | $20.00 / MTok | 2× del prezzo base dell'input |
| Lettura o rinnovo cache | $0.25 / MTok | 0.025× del prezzo base dell'input |
La durata predefinita della cache è di cinque minuti. Una lettura rinnova l'elemento senza una tariffa di rinnovo aggiuntiva; Anthropic supporta anche la durata di un'ora, con il prezzo di scrittura più alto. Fable 5.1 ha una lunghezza minima memorizzabile in cache di 512 token: i prompt più corti vengono elaborati senza caching, anziché generare un errore di cache.
Un breakpoint della cache copre il prefisso riutilizzabile fino a quel punto. Inserite prima della richiesta utente variabile i tool stabili, le istruzioni di sistema, gli esempi e il contesto di sfondo. Se nel prefisso in cache inserite un timestamp o istruzioni specifiche della richiesta, il contenuto variabile può causare un miss e una nuova scrittura.
Esempio pratico: 200.000 token riletti 100 volte
Supponiamo che un agente riutilizzi un prefisso di 200.000 token in 100 richieste successive. Il volume di letture dalla cache è pari a 20 milioni di token.
| Tariffa di lettura cache | Calcolo | Componente letture cache |
|---|---|---|
| Claude Fable 5 | 20 × $1.00 | $20.00 |
| Claude Fable 5.1 | 20 × $0.25 | $5.00 |
Il risparmio sulle letture dalla cache è di $15, ovvero il 75%. L'esempio esclude la scrittura iniziale in cache, i contenuti non memorizzati della richiesta, i token in output, i costi dei tool, le imposte, i modificatori regionali e i retry. È un confronto su una singola componente, non la promessa che l'intera esecuzione dell'agente costerà $15 in meno.
Una discussione tra utenti ha messo a fuoco lo stesso effetto sul carico di lavoro:
“Le letture cache ora costano il 75% in meno, ovvero $0.25 per milione di token. È una novità molto più importante...” — u/ProfessionalJackals, r/ClaudeAI
Una scrittura in cache mal gestita può annullare il risparmio
Per lo stesso prefisso di 200.000 token, una scrittura in cache da 5 minuti costa $2.50 e una da 1 ora costa $4.00 alle tariffe pubblicate per Fable 5.1. Se la cache scade prima della richiesta successiva, può essere necessaria un'altra scrittura.
Con questo prefisso, un successivo cache hit entro 5 minuti rende il caching più conveniente di due letture senza cache. L'opzione da 1 ora diventa più conveniente dal secondo riutilizzo successivo, perché la scrittura da $4.00 più due letture da $0.05 costa meno di tre letture senza cache da $2.00 ciascuna.
Scegliete la durata della cache in base al pattern di traffico:
- Usate la durata di 5 minuti se lo stesso prefisso viene riutilizzato dopo brevi intervalli interattivi.
- Usate la durata di 1 ora quando le richieste sono separate da pause più lunghe, ma appartengono ancora alla stessa sessione di lavoro.
- Evitate il caching per richieste una tantum o molto distanziate, se il prefisso non verrà riletto prima della scadenza.
- Controllate
cache_creation_input_tokensecache_read_input_tokensnei dati di utilizzo, invece di presumere che un blocco contrassegnato abbia prodotto un cache hit.
La fattura non finisce alla tariffa principale
I prezzi API di Claude Fable 5.1 sono basati sui token, ma la risposta visibile è solo una parte di una richiesta che usa tool. Anthropic specifica che definizioni dei tool, blocchi di uso dei tool, blocchi con risultati dei tool e lo speciale system prompt dei tool aggiungono token in input. I tool lato server possono inoltre comportare costi di utilizzo separati.
| Voce di costo | Cosa includere in un budget per Fable 5.1 |
|---|---|
| Input senza cache | System prompt, conversazione, file, schemi dei tool e contesto nuovo a $10 / MTok |
| Input in cache | Prefissi riutilizzati idonei a $0.25 / MTok quando riportati come letture cache |
| Output | Output visibile più token fatturabili di ragionamento/output a $50 / MTok |
| Web search | $10 per 1.000 ricerche, più i costi dei token per il contesto di ricerca |
| Batch API | Sconto del 50% sui prezzi dei token in input e output per job asincroni |
| Inferenza solo negli USA | Moltiplicatore 1.1× per i costi applicabili di input, output, scrittura cache e lettura cache |
| Instradamento cloud | AWS, Google Cloud e Microsoft Foundry possono applicare propri meccanismi di fatturazione pubblicati |
Sconti Batch, prezzi della cache e modificatori per la residenza dei dati possono sommarsi secondo la documentazione dei prezzi di Anthropic. Fast mode è una funzionalità separata in research preview per i modelli Opus supportati, non una scorciatoia per Fable 5.1.
Stimate i token di output, ragionamento, tool e contesto, non soltanto il testo finale. Con 500.000 token in output, la relativa componente costa $25 e può superare un risparmio di $15 sulle letture cache.
Una formula utile in produzione è:
costo stimato = input senza cache
               + scritture cache
               + letture cache
               + token di output/ragionamento
               + costi dei tool server
               + modificatori di instradamento o geografici
Accesso API e verifiche prima della migrazione
Usate l'ID modello esatto claude-fable-5-1 e verificate che il provider attivo lo esponga. L'annuncio ufficiale afferma che Fable 5.1 è disponibile attraverso la piattaforma Anthropic e le principali route cloud, ma la presenza di un modello nel catalogo Anthropic non garantisce disponibilità, limiti o fatturazione identici su ogni route partner.
Prima di modificare un'integrazione in produzione, eseguite queste verifiche in un ambiente di staging:
- Confermate l'ID del modello restituito dal catalogo live del provider o dalla documentazione specifica della route.
- Registrate input, scritture cache, letture cache, output e utilizzo dei tool su un set di test fisso.
- Testate le impostazioni
tool_choiceesistenti e il percorso di output strutturato. - Testate una conversazione multi-turno che includa blocchi di ragionamento precedenti.
- Testate il fallback da Fable 5.1 a un modello meno costoso, senza perdere silenziosamente lo stato necessario.
- Testate ogni codice che modifica messaggi precedenti, system prompt o definizioni dei tool tra un turno e l'altro.
- Dopo la migrazione, confrontate il costo per attività accettata, non soltanto la tariffa per token.
Anthropic segnala che i nuovi account API non possono modificare manualmente il contesto precedente mantenendo al tempo stesso la trascrizione del ragionamento precedente di Claude. Verificate questo comportamento nello staging; non presumete che ogni richiesta Fable 5.1 fallirà.
Quando vale la pena pagare di più per Fable 5.1
Scegliete Claude Fable 5.1 quando il lavoro ripetuto su contesti ampi genera abbastanza cache hit e un miglioramento sufficiente nelle attività accettate, secondo la vostra valutazione, da compensare le tariffe base più elevate. Restate su un modello più economico se il carico è una tantum, dominato dall'output, sensibile alla latenza o abbastanza semplice per Sonnet 5; Opus 5 rimane un'opzione dal costo nominale inferiore, con $5 in input e $25 in output per milione di token.
Usate un piccolo set di valutazione con criteri di accettazione noti. Confrontate queste misurazioni:
| Misurazione | Perché cambia la decisione |
|---|---|
| Esecuzioni riuscite | Un'esecuzione fallita più economica non equivale necessariamente a lavoro meno costoso |
| Token in output | L'output di Fable 5.1 costa cinque volte la sua tariffa base di input |
| Quota di letture cache | La tariffa di $0.25 si applica solo ai cache hit riportati |
| Turni dei tool | I turni aggiuntivi aumentano token, latenza e possibili costi dei tool server |
| Tempo di correzione umana | Un modello che richiede meno interventi può ridurre il costo totale dell'attività |
| Route e area geografica | La fatturazione dei partner e l'inferenza solo negli USA possono modificare la fattura |
Il prezzo API non va confuso con i limiti degli abbonamenti Claude Pro o Max. Il valore di $0.25 è una tariffa API per la lettura cache; l'annuncio di Anthropic non afferma che limiti dei messaggi o quote di utilizzo degli abbonamenti calino del 75%.
Domande frequenti
Una finestra di contesto da 1 milione di token significa 1 milione di token gratuiti?
No. La finestra di contesto è un limite di capacità. I token al suo interno vengono fatturati secondo le categorie del provider per input, cache e output.
Lo sconto della cache si applica a Claude Pro o Max?
No. Nessuna regola sui prezzi API va applicata a un piano in abbonamento senza una dichiarazione specifica per quel piano. La tariffa di $0.25 è il prezzo API per la lettura cache, non una modifica pubblicata ai limiti Pro o Max.
Come verifico che una richiesta abbia usato la cache?
Esaminate i campi di utilizzo della risposta, in particolare cache_creation_input_tokens e cache_read_input_tokens. Un marker cache-control da solo non dimostra che la richiesta abbia raggiunto la lunghezza minima o corrisposto a un prefisso già presente in cache.
Devo sostituire subito Claude Fable 5?
No. Eseguite una valutazione fissa in staging, misurate cache hit e token in output e confrontate il costo per attività accettata con il modello e la route attuali prima di spostare il traffico di produzione.