 AIREITER
Dal 16 agosto 2026 usare le API DeepSeek costa di più. Le tariffe fisse per token sono state sostituite da una fatturazione differenziata tra ore di picco e fuori picco per deepseek-v4-flash e deepseek-v4-pro. Fuori picco, input senza cache hit e output costano ora da 1,5× a 2,4× rispetto a prima; nelle fasce di picco il costo raddoppia. L'input servito dalla cache, invece, aumenta da 2,5× a 6,1× fuori picco e fino a 12,1× nelle ore di punta. Il dato che fa davvero la differenza nella bolletta è il cache-hit rate dei prompt.
Dal 16 agosto cambia la fatturazione
Il nuovo schema è entrato in vigore domenica 16 agosto alle 16:00 UTC, ovvero alla mezzanotte del 17 agosto a Pechino, secondo sia il thread dell'annuncio sia l'audit su 650 chiamate pubblicato su r/DeepSeek. La pagina ufficiale Models & Pricing riporta già le nuove tabelle: non è solo un annuncio, il cambiamento è attivo.
DeepSeek ha introdotto fasce di picco e fuori picco, con le prime fissate esattamente al doppio delle seconde. Le finestre di picco sono 01:00–04:00 UTC e 06:00–10:00 UTC: sette ore di picco al giorno e diciassette fuori picco. Versioni dei modelli (DeepSeek-V4-Flash-0731, DeepSeek-V4-Pro-0813), compatibilità API e specifiche pubblicate restano invariate sulla stessa pagina: è un intervento sui prezzi, non sui modelli.
Le nuove tariffe delle API DeepSeek
Tutti i prezzi indicati sono in USD per 1 milione di token e provengono direttamente dalla pagina ufficiale dei prezzi al 16 agosto 2026.
| V4 Flash | Fuori picco | Picco |
|---|---|---|
| Input, cache hit | $0.007 | $0.014 |
| Input, cache miss | $0.22 | $0.44 |
| Output | $0.66 | $1.32 |
| V4 Pro | Fuori picco | Picco |
|---|---|---|
| Input, cache hit | $0.022 | $0.044 |
| Input, cache miss | $0.66 | $1.32 |
| Output | $1.98 | $3.96 |
Le modalità di fatturazione restano per il resto invariate: ogni richiesta viene addebitata alla tariffa attiva nel momento in cui viene eseguita e DeepSeek si riserva esplicitamente il diritto di modificare di nuovo i prezzi.
Di quanto sono aumentate davvero le API DeepSeek?
Le precedenti tariffe fisse sono state confermate da tracker di terze parti fino al 31 luglio 2026: Flash a $0.14 per l'input senza cache hit, $0.0028 per cache hit e $0.28 per l'output; Pro a $0.435 / $0.003625 / $0.87 (TLDL, BenchLM). Ecco il confronto diretto tra le due strutture:
| Per 1M di token | Vecchia tariffa fissa | Nuova fuori picco | Nuova picco | Fuori picco vs vecchia | Picco vs vecchia |
|---|---|---|---|---|---|
| Flash input, cache hit | $0.0028 | $0.007 | $0.014 | 2.5× | 5.0× |
| Flash input, cache miss | $0.14 | $0.22 | $0.44 | 1.57× | 3.14× |
| Flash output | $0.28 | $0.66 | $1.32 | 2.36× | 4.71× |
| Pro input, cache hit | $0.003625 | $0.022 | $0.044 | 6.07× | 12.14× |
| Pro input, cache miss | $0.435 | $0.66 | $1.32 | 1.52× | 3.03× |
| Pro output | $0.87 | $1.98 | $3.96 | 2.28× | 4.55× |
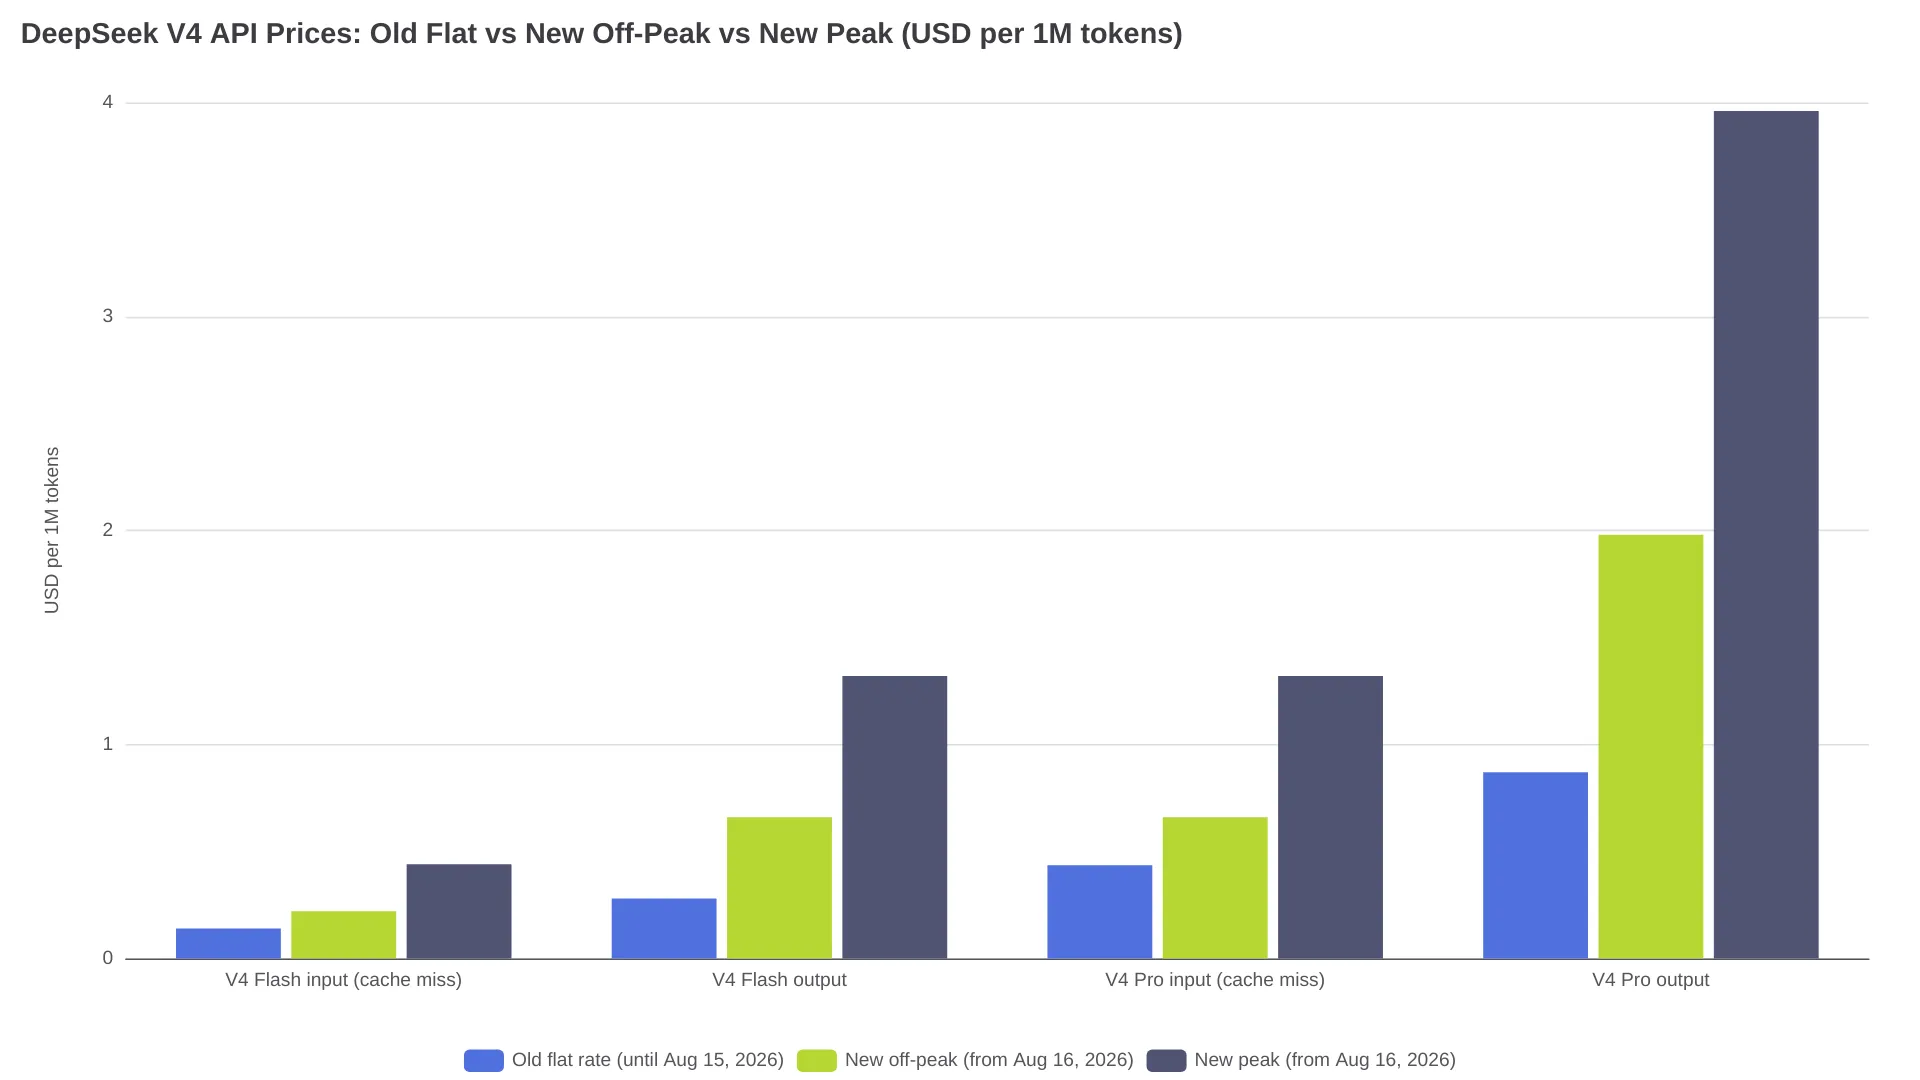
Il dato del «+1.114%» circolato su Reddit è corretto, ma riguarda un caso molto specifico: l'input cache hit di V4 Pro in fascia di picco ($0.003625 -> $0.044). Un carico senza cache, eseguito fuori picco, si avvicina piuttosto a un aumento di 1,5–2,3×. Il moltiplicatore effettivo dipende da dove si colloca il vostro utilizzo fra questi due estremi.
I carichi basati sulla cache sono i più penalizzati
I prezzi dei cache hit sono aumentati da 2,5× a 12×, contro 1,5×–4,7× per cache miss e output. Di conseguenza, più volume di input passava dalla corsia molto economica della cache, maggiore sarà l'incremento percentuale. Un utente di r/DeepSeek ha ricalcolato 650 chiamate API reali — 16 sessioni, 155,9M di prompt token e un cache-hit rate del 98,09% — con entrambe le tabelle, riconciliando il risultato con la fatturazione nella console DeepSeek con uno scarto entro il 2%:
"the better caching works for you today, the bigger your increase" - u/Swimming-Soup-1173, audit r/DeepSeek su 650 chiamate API
Per quel carico agent, il nuovo costo è risultato 2.7× più alto fuori picco, contro 1,5× per lo stesso carico senza cache hit. Un altro utente ha modellato un carico con contesto lungo che passa da $33 a $100 fuori picco o a $200 nelle ore di punta: un salto da 3× a 6×. Batch job, pipeline RAG e agent con prompt di sistema statici sono i profili più sotto pressione; il traffico di summarization one-shot rimane invece più vicino alla soglia fuori picco di 1,5–2,3×.
Le ore di picco nel tuo fuso orario
La pagina ufficiale indica solo le finestre UTC. Ecco la conversione per agosto, quando è in vigore l'ora legale:
| Fuso | Finestre di picco locali | La tua giornata 9-17 |
|---|---|---|
| Pechino (UTC+8) | 09:00–12:00, 14:00–18:00 | Picco, esclusa la pausa pranzo 12:00–14:00 |
| Europa centrale (UTC+2) | 03:00–06:00, 08:00–12:00 | Mattina in fascia di picco |
| Londra (UTC+1) | 02:00–05:00, 07:00–11:00 | Mattina in fascia di picco |
| USA Est (UTC-4) | 21:00–00:00, 02:00–06:00 | Interamente fuori picco |
| USA Ovest (UTC-7) | 18:00–21:00, 23:00–03:00 | Interamente fuori picco |
Le fasce di picco coincidono con la giornata lavorativa cinese, a eccezione della pausa pranzo: dalle 12:00 alle 14:00 ora di Pechino si applicano le tariffe fuori picco. I team statunitensi lavorano per intero fuori picco; quelli europei pagano il doppio per i batch del mattino — 08:00–12:00 CEST è fascia di picco — e dovrebbero spostarli al pomeriggio o durante la notte.
Il prompt caching conviene ancora?
Sì, senza dubbio: lo sconto si è ridotto, ma non è sparito. In precedenza l'input con cache hit costava circa 50× meno dell'input cache miss su Flash e 120× meno su Pro; ora è circa 30× più economico su entrambi i modelli, precisamente 31× per Flash e 30× per Pro fuori picco: $0.007 contro $0.22, $0.022 contro $0.66. Anche l'autore dell'audit che ha misurato l'aumento di 2,7× è arrivato alla stessa conclusione:
"Caching is still absolutely worth it" - lo stesso audit su r/DeepSeek
Nel suo caso, la cache continuava a ridurre i costi di circa 15× rispetto all'invio dello stesso contesto senza cache. Il caching resta best-effort, senza alcuna garanzia sul tasso di hit; le voci inutilizzate vengono in genere eliminate dopo un intervallo che va da ore a giorni (BenchLM). Prima di definire il budget, conviene quindi misurare: registrate i campi prompt_cache_hit_tokens e prompt_cache_miss_tokens dell'oggetto usage, come raccomanda BenchLM, per calcolare la quota effettiva di hit.
DeepSeek resta l'opzione economica?
Fuori picco sì; nelle ore di punta, per Flash, il vantaggio su GPT-5.6 si azzera praticamente. Di seguito i prezzi standard per 1M di token:
| Modello | Input | Output | Note |
|---|---|---|---|
| DeepSeek V4 Flash (fuori picco) | $0.22 | $0.66 | Contesto da 1M |
| DeepSeek V4 Flash (picco) | $0.44 | $1.32 | Supera il prezzo output di Luna |
| GPT-5.6 Luna | $0.20 | $1.20 | Prezzo ridotto dell'80% il 30 luglio |
| DeepSeek V4 Pro (fuori picco) | $0.66 | $1.98 | Ancora circa 6× sotto Terra |
| DeepSeek V4 Pro (picco) | $1.32 | $3.96 | Circa 3× sotto Terra |
| GPT-5.6 Terra | $2 | $12 | |
| Claude Sonnet 5 | $2 | $10 | Tariffa di lancio fino al 31 agosto, poi $3/$15 |
Fuori picco, l'output di V4 Flash a $0.66 costa il 45% in meno di GPT-5.6 Luna e 18× meno di Terra: DeepSeek resta l'opzione più economica per l'output ad alto volume. In fascia di picco, Luna — $1.20 per l'output e $0.20 per l'input — batte Flash su entrambe le tariffe standard. La cache-read rate di Luna ($0.02/M nel changelog dell'AI Price Index) è però più cara della fascia cache hit di Flash a qualsiasi ora; Flash continua inoltre a offrire contesto da 1M di token e concorrenza di 2.500 nella tabella delle specifiche ufficiali. Come ha sintetizzato un commentatore nel thread dell'annuncio: "DS4 is good but when cheap."
Cosa fare questa settimana
- Ricalcolate la vostra spesa prima di allarmarvi. Recuperate i log di utilizzo del mese scorso e calcolate: input cache hit × hit rate × prezzo hit + input cache miss × miss rate × prezzo miss + output × prezzo output. Applicate poi la tariffa di picco o fuori picco in vigore nella finestra di ciascuna richiesta. Gli estremi dell'audit definiscono l'intervallo: 1,5× senza cache hit, 2,7× con un hit rate del 98%.
- Spostate fuori picco il lavoro differibile. Cron job, valutazioni, elaborazione documentale: tutto ciò che non ha un utente in attesa può girare nelle 17 ore fuori picco. Per i team USA è quasi gratuito, perché la giornata lavorativa è già fuori picco; per quelli UE, conviene spostare i batch mattutini al pomeriggio.
- Continuate a generare cache hit. Mantenete la struttura dei prompt che già produce cache hit: la relativa fascia resta circa 30× meno costosa dell'input cache miss.
- Provate Flash sulle chiamate di routine. Pro costa 3× Flash praticamente su tutta la linea, 3,1× per i cache hit. Se non avete rivalutato Flash dopo l'aggiornamento post-training 0731, instradate verso di esso una quota del traffico ordinario: i compromessi nella scelta del modello sono trattati nel nostro confronto V4 Flash vs V4 Pro.
- Se cambiate provider, la migrazione può essere minima. Per i client compatibili con OpenAI, spesso basta modificare base URL e model ID. Host di terze parti e piattaforme relay applicano listini propri: DataLLM Lab ha documentato host che quotavano V4 Pro intorno a $1.74/$3.48 per 1M già prima dell'aumento. Confrontate quindi il prezzo effettivo, non quello esposto in vetrina.
La decisione, in una tabella:
| Il tuo profilo | Scelta consigliata |
|---|---|
| Fuso orario USA, traffico agent con forte uso della cache | Resta: le tariffe fuori picco e la fascia cache circa 30× più economica mantengono il costo input più basso per questo tipo di traffico |
| Fuso orario UE, batch job mattutini | Resta, ma riprogramma: l'esposizione al picco è autoindotta e si può evitare |
| Solo ore di picco, coding sensibile alla qualità su Pro | Rivaluta: l'output Pro in fascia di picco ($3.96) è ancora sotto Terra ($12), ma il divario è ora 3×, non più 14× come prima del 16 agosto |
| Carichi one-shot senza cache | Resta: l'aumento fuori picco di 1,5–2,3× è il più contenuto della tabella |
FAQ
Quando sono entrati esattamente in vigore i nuovi prezzi DeepSeek?
Il 16 agosto 2026 alle 16:00 UTC, ovvero alla mezzanotte del 17 agosto a Pechino, secondo il thread dell'annuncio e l'audit su 650 chiamate su r/DeepSeek. La pagina ufficiale dei prezzi mostrava le nuove tabelle nello stesso giorno.
Di quanto aumenterà la mia bolletta DeepSeek?
Un carico senza cache passa a circa 1,5× fuori picco, mentre un carico misurato con hit rate del 98% arriva a 2,7×; nelle ore di punta questi valori raddoppiano, fino a 12× per l'input cache hit di Pro. La tabella dei moltiplicatori qui sopra riporta tutte le coppie di tariffe.
Quali sono le ore di picco negli Stati Uniti?
USA Eastern: 21:00–00:00 e 02:00–06:00. USA Pacific: 18:00–21:00 e 23:00–03:00. Le normali ore lavorative statunitensi ricadono interamente nelle finestre fuori picco.
deepseek-chat e deepseek-reasoner sono ancora disponibili?
No. Gli alias legacy hanno raggiunto la data di ritiro il 24 luglio 2026, secondo la cronologia dei model ID di BenchLM; le nuove integrazioni devono chiamare deepseek-v4-flash o deepseek-v4-pro.
DeepSeek costa ancora meno di GPT-5.6 e Claude?
Fuori picco sì: l'output Flash costa il 45% in meno di GPT-5.6 Luna e 18× meno di Terra. In fascia di picco, l'output di Luna a $1.20/M è inferiore ai $1.32/M di Flash, quindi la risposta dipende dall'orario in cui gira il vostro traffico.