 AIREITER
Seed Audio 1.0 mérite d’être essayé dès maintenant si vous produisez de courts contenus audio en anglais ou en chinois, à une condition : passer par une passerelle tierce plutôt que par l’API officielle. Le modèle de ByteDance crée une scène sonore complète — dialogues, musique de fond et effets sonores — à partir d’un unique prompt. Sa capacité à gérer plusieurs intervenants tout en mixant la musique le distingue des outils spécialisés dans la synthèse vocale ou la musique. Trois limites restent toutefois déterminantes : 2 minutes maximum par génération, uniquement l’anglais et le chinois, et une API officielle encore accessible sur invitation, sans tarif public. Voici ce qu’il faut savoir.
Seed Audio 1.0 : un générateur de scènes sonores
La plupart des outils audio se concentrent sur une tâche : synthèse vocale, création musicale ou effets sonores. Seed Audio 1.0, dont le nom complet est Doubao-Seed-Audio 1.0, rassemble ces trois dimensions sur une même timeline et les génère en une seule passe. Avec un prompt tel que « une fiction radiophonique à suspense dans une supérette ouverte tard dans la nuit », il produit un fichier finalisé comprenant répliques, ambiance et nappe musicale déjà mixées.
Le modèle fonctionne selon trois modes. Le text-to-audio (T2A) construit une scène à partir d’une description écrite. Le text-and-audio-to-audio (TA2A) associe du texte à des extraits de référence afin d’orienter la voix et le style. Le TTS classique sert, lui, à produire une narration simple et propre. Le choix du mode dépend donc des éléments fournis en entrée.
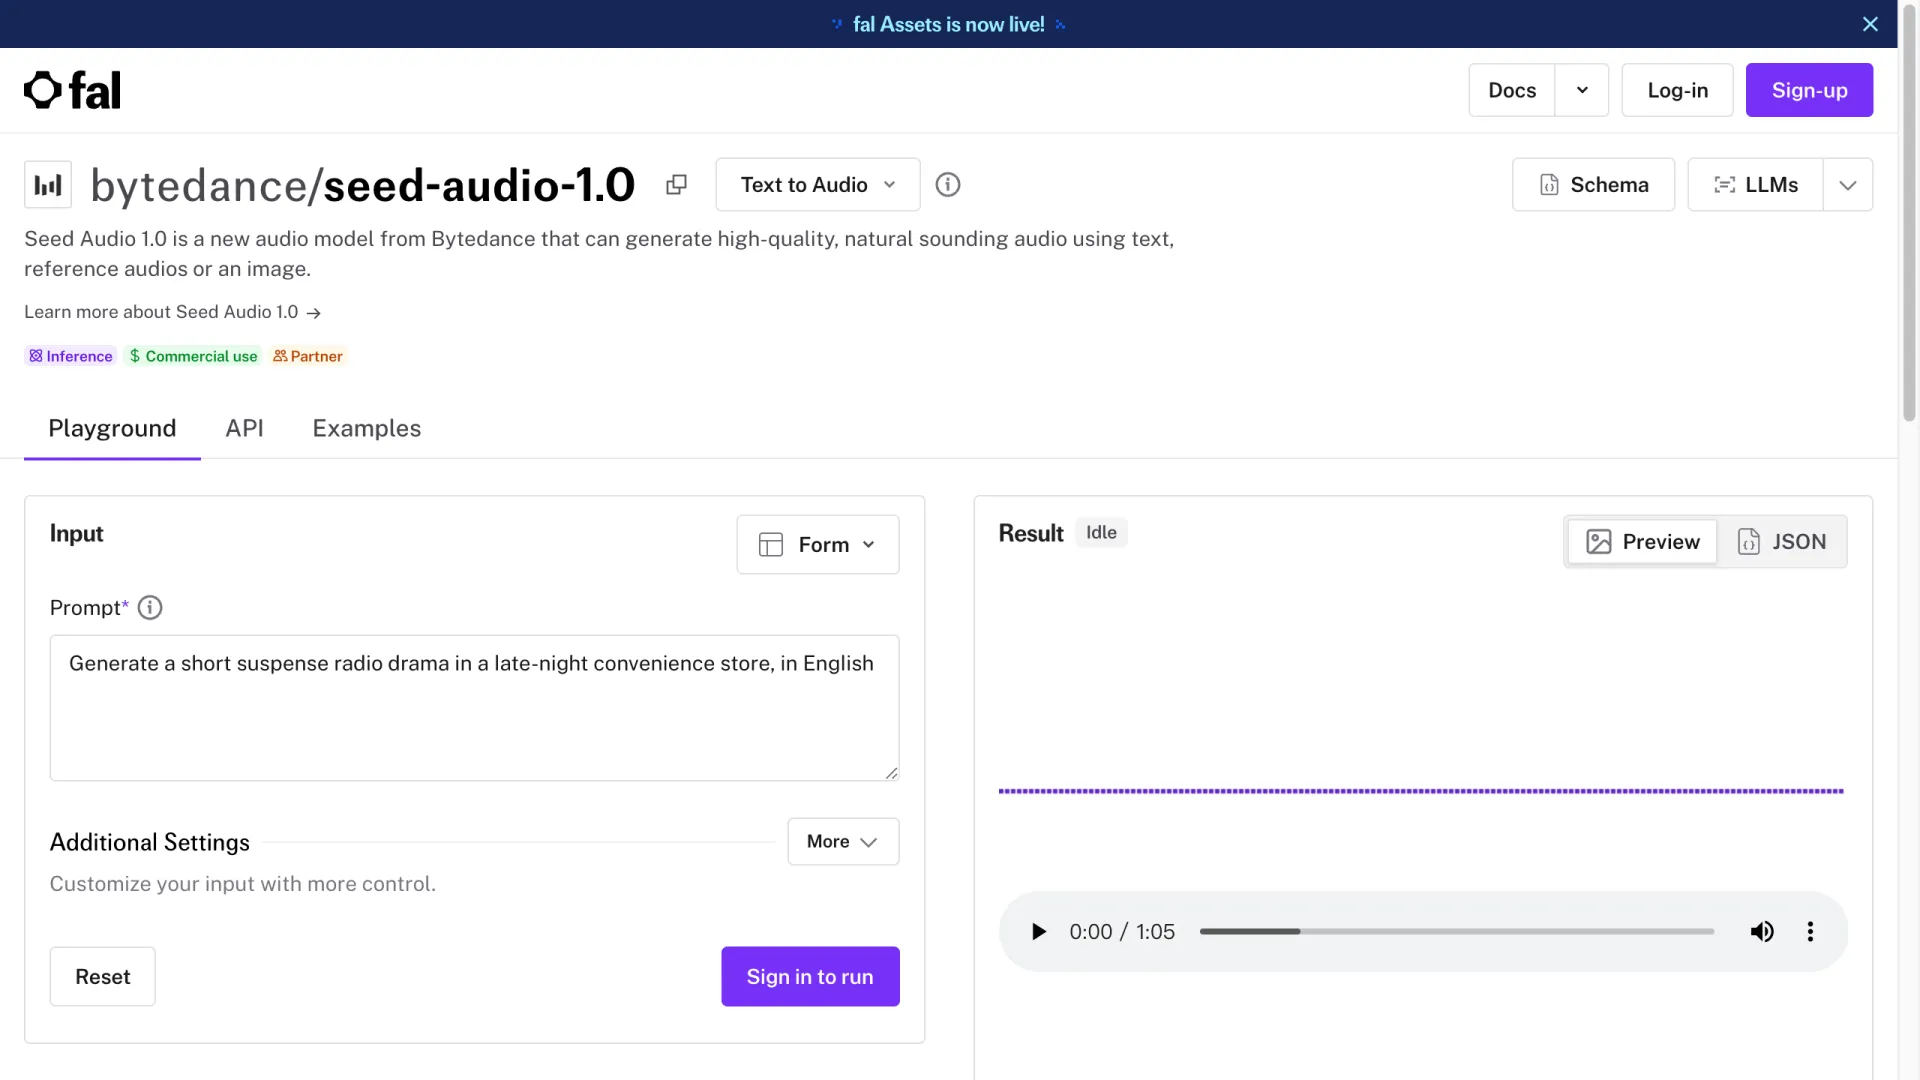
Un point mérite d’être clarifié : s’agit-il d’un outil de clonage vocal ? Seed Audio 1.0 peut faire interpréter plusieurs rôles à une même voix et reprendre le ton d’un extrait de référence, mais son résultat reste synthétisé et n’est pas rattaché à l’identité d’un locuteur réel précis. Il faut davantage y voir un stylisme vocal zero-shot qu’un clone sans consentement d’une personne nommée. Le modèle s’appuie sur les précédents travaux de ByteDance, Seed-TTS et Seed-Music, ce qui explique la réunion, dans un même modèle, d’une voix expressive et de la génération musicale.
Les spécifications à vérifier avant de l’adopter
Avant toute chose, vérifiez que votre usage reste compatible avec ses limites techniques. Voici les chiffres essentiels, recoupés entre les fiches de modèles fal et EvoLink :
| Caractéristique | Valeur |
|---|---|
| Durée maximale par génération | 120 secondes (2 minutes) |
| Limite de prompt textuel | ~1 500–2 000 caractères (les sources divergent ; à confirmer dans la console) |
| Audio de référence | Jusqu’à 3 extraits, de ≤30 secondes chacun |
| Langues | Anglais et chinois uniquement |
| Formats de sortie | WAV, MP3, PCM, OGG Opus |
| Fréquences d’échantillonnage | 48K / 24K / 16K / 8K |
| Réglages | Vitesse, hauteur, volume (pas de SSML) |
| Mode de facturation | Selon la durée générée |
La limite de 2 minutes est celle qui pèse le plus au quotidien. Pour un épisode de podcast complet ou une longue narration, il faut découper le script puis assembler les segments, avec un risque de dérive de ton d’un bloc à l’autre. Les notes de modèle de fal évoquent une mise à jour prévue qui porterait la durée d’une génération vers dix minutes, avec un contrôle explicite de la longueur et une prise en charge linguistique plus large. Si vous travaillez principalement en format long, cela peut justifier d’attendre.
Tarifs : aucun prix officiel pour le moment
Aucun tarif officiel n’est disponible à ce stade. En juillet 2026, Volcengine n’a toujours pas publié de prix à la seconde pour Seed Audio 1.0 : le modèle reste sur invitation dans Volcano Ark, et les grilles officielles arrivent généralement lors de la disponibilité générale. Les passerelles comme fal et EvoLink n’affichent pas non plus de tarif fixe ; elles facturent selon la durée de sortie générée (coût = secondes générées × tarif). Les nouvelles tentatives sont donc elles aussi facturées. Ignorez les montants exprimés en tokens qui circulent parfois : une tarification par tokens ne correspond pas à un modèle audio facturé à la durée.
Comment y accéder dès aujourd’hui
Deux voies existent, avec des contraintes très différentes en pratique.
La voie officielle passe par Volcano Ark, où Seed Audio 1.0 est disponible uniquement sur invitation. Il faut déposer une demande, attendre l’accès, puis utiliser la console de ByteDance. Ce sera la source de référence lorsque la disponibilité générale et les tarifs seront annoncés.
La solution la plus concrète est de passer par une plateforme tierce. fal héberge le modèle sous le nom bytedance/seed-audio-1.0, sans liste blanche : l’endpoint est accessible via son API avec une clé standard. EvoLink propose un accès comparable. C’est actuellement la manière la plus simple de générer avec le modèle sans attendre une invitation.
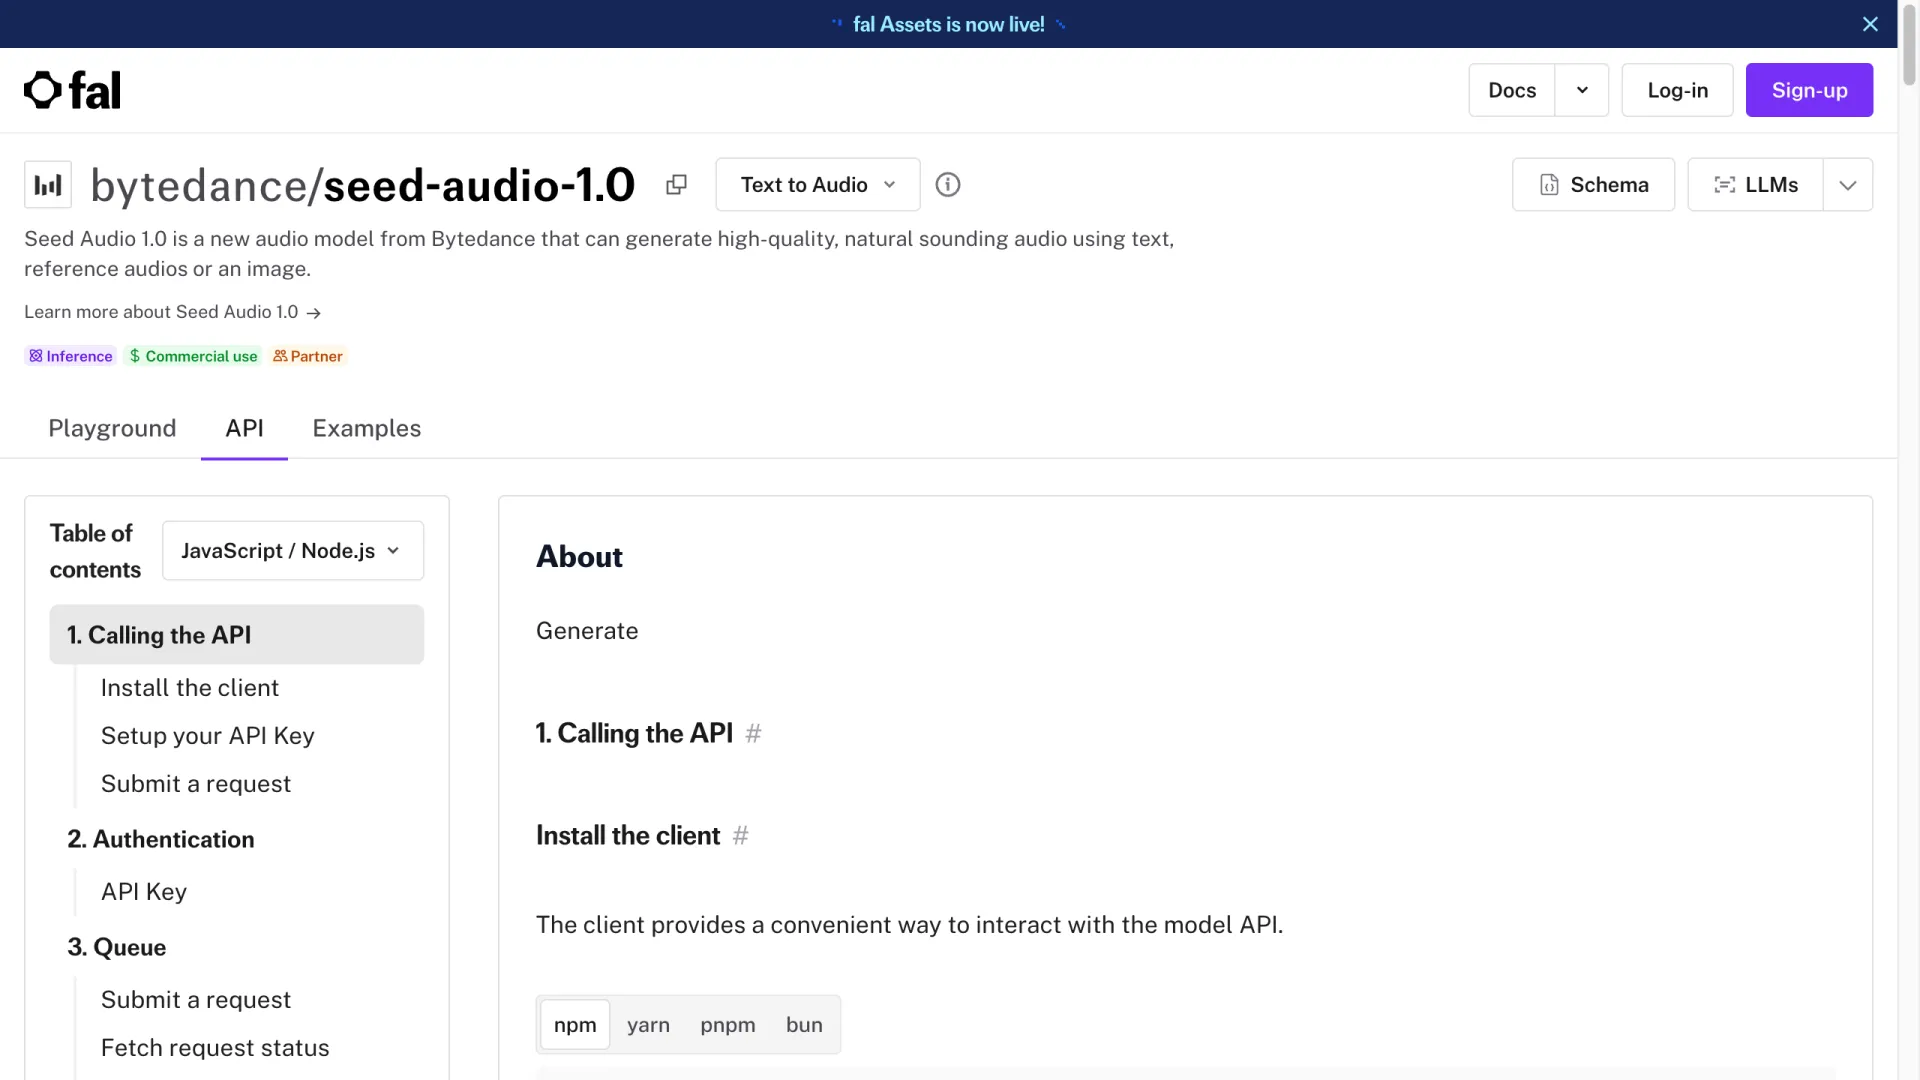
Le fonctionnement repose sur une API classique avec file d’attente : installez le client, configurez votre clé, envoyez le prompt puis interrogez le résultat. Si vous avez déjà intégré un modèle génératif hébergé de cette manière, rien ne devrait vous dérouter ; notre test de fal.ai détaille davantage l’expérience côté développeur.
Pour un premier essai utile, créez une courte scène à plusieurs voix qui sollicite simultanément dialogue, ambiance et rythme. Par exemple : « une fiction radiophonique à suspense de 30 secondes dans une supérette ouverte tard dans la nuit, en anglais ». Gardez ce premier extrait sous les 30 secondes : si le résultat ne convient pas, le coût reste limité pendant que vous apprenez à formuler vos prompts pour le modèle.
Seed Audio 1.0 face à ElevenLabs, Stable Audio et AudioCraft
La comparaison utile ne se joue pas sur la qualité d’un extrait isolé, mais sur le type de travail pour lequel chaque outil a été conçu.
| Outil | Point fort | Mixage de scène | Langues | Contrôle vocal |
|---|---|---|---|---|
| Seed Audio 1.0 | Scènes audio complètes (voix + musique + SFX) | Oui, en un passage | EN, CN | Stylisme zero-shot |
| ElevenLabs | Voix et clonage vocal | Voix uniquement | 30+ | Clonage le plus poussé |
| Stable Audio | Génération de musique et de sons | Piste unique | S/O (musique) | Par prompt |
| AudioCraft | Musique/SFX open source | Piste unique | S/O (musique) | Par prompt |
Pour la meilleure synthèse vocale pure ou un clonage vocal précis dans de nombreuses langues, ElevenLabs conserve l’avantage. Si votre besoin se limite à la musique, Stable Audio ou AudioCraft de Meta sont plus adaptés. La force de Seed Audio 1.0 est d’assembler dialogues, musique et effets dans une scène cohérente et modifiable : parmi ces outils, aucun autre ne le fait en un seul appel.
Ses points forts et ses limites
Ses atouts : les dialogues à plusieurs voix et le mixage en un passage de la musique avec les effets sonores constituent son principal intérêt. Les flux d’édition documentés — prolonger un extrait, retoucher une section, raccorder plusieurs prises, selon le guide d’utilisation de fal — en font aussi un outil de production plutôt qu’un simple générateur ponctuel.
Ses limites : le plafond de 2 minutes impose d’assembler les segments pour tout contenu long. La prise en charge exclusive de l’anglais et du chinois écarte une grande partie des usages vocaux internationaux. C’est un modèle de génération hors ligne, inadapté aux agents vocaux temps réel. Enfin, l’accès officiel reste conditionné à une invitation.
Faut-il déjà l’utiliser ?
Si vous créez des contenus courts en anglais ou en chinois — doublage, extraits de livres audio, bandes-son de vidéos courtes, prototypes de fictions audio — Seed Audio 1.0 mérite un essai dès aujourd’hui via une passerelle. Générer toute la scène en une fois évite d’avoir à superposer manuellement voix, musique et effets.
En revanche, mieux vaut attendre si vous avez besoin d’interactions en temps réel, d’une langue non prise en charge ou d’un long audio ininterrompu. La disponibilité générale et la mise à jour de durée annoncée changeront la donne. D’ici là, un modèle temps réel comme Qwen Audio 3 convient mieux aux usages en direct. Pour les autres, le bon réflexe est de « tester via une passerelle tout en conservant sa stack actuelle », pas de basculer entièrement.
FAQ
Seed Audio 1.0 est-il gratuit ?
Non. Il n’existe pas d’offre officielle gratuite : l’API Volcano Ark est accessible sur invitation et facturée selon la durée de sortie une fois l’accès obtenu. Les passerelles tierces appliquent leurs propres tarifs à l’usage.
Seed Audio 1.0 peut-il cloner ma voix ?
Il peut reproduire le style d’un extrait de référence et faire jouer plusieurs rôles à une voix, mais il génère une parole synthétique plutôt qu’un clone verrouillé d’une personne réelle précise. Il ne faut pas le considérer comme un outil de clonage d’identité prêt à l’emploi.
Quelles langues Seed Audio 1.0 prend-il en charge ?
Uniquement l’anglais et le chinois au lancement. Une prise en charge multilingue plus étendue figure sur la feuille de route d’une mise à jour prévue, selon les notes de modèle de fal.
Quelle peut être la durée de l’audio généré ?
Jusqu’à 120 secondes par génération actuellement. La mise à jour prévue porterait la durée d’une génération vers dix minutes, avec un contrôle explicite de la longueur.
Existe-t-il une API officielle pour Seed Audio 1.0 ?
Oui, sur Volcano Ark de Volcengine, mais elle reste pour l’instant accessible sur invitation. Pour un accès ouvert sans liste blanche, utilisez une passerelle comme fal, qui héberge bytedance/seed-audio-1.0.
Quelle différence entre Seed Audio et Seed Music ?
Seed-Music était le précédent travail de recherche de ByteDance consacré à la musique ; Seed Audio 1.0 réunit cette capacité musicale avec la voix et les effets sonores dans un seul modèle de génération de scènes.