 AIREITER
Qwen Audio 3.0 Realtime désigne l’offre audio conversationnelle temps réel actuelle de Qwen : vous parlez au modèle, il vous répond à voix haute, avec une latence suffisamment faible pour évoquer un appel téléphonique. Sur la plateforme Alibaba, cette fonction repose sur l’API Qwen3-Omni / Qwen3.5-Omni Realtime — avec des identifiants tels que qwen3-omni-flash-realtime — complétée par Qwen-TTS-Realtime pour la synthèse vocale seule et qwen3-asr-flash pour la transcription. Les modèles omni Realtime hébergés reconnaissent plus de 100 langues, gèrent le duplex intégral et les interruptions, pour un coût de quelques fractions de centime par minute de conversation.
Pour démarrer au plus vite, utilisez qwen3-omni-flash-realtime via WebSocket. Nous détaillons ci-dessous le rôle de chaque modèle, leurs tarifs, leur positionnement face à OpenAI Realtime et Gemini Live, ainsi que les premières étapes d’intégration. Chaque caractéristique, tarif et identifiant de modèle renvoie à sa source primaire, principalement la documentation Model Studio Realtime d’Alibaba et la fiche de modèle Qwen3-Omni. Le secteur évoluant vite, fiez-vous aux sources liées si un chiffre a changé.
Comprendre les noms des modèles audio Qwen
La gamme audio de Qwen a connu plusieurs générations. En connaître la filiation aide à choisir le bon modèle :
Qwen-Audio(2023) etQwen2-Audioétaient des modèles de compréhension audio : ils recevaient de l’audio et produisaient du texte, sans répondre à l’oral.- La génération actuelle intègre l’audio aux modèles omni.
Qwen3-OmnietQwen3.5-Omniacceptent du texte, des images, de l’audio et de la vidéo, puis génèrent à la fois du texte et une voix naturelle. - Le temps réel correspond à un mode de diffusion : ces mêmes modèles omni sont appelés via l’API Realtime, avec des identifiants se terminant par
-realtime.
Ainsi, « Qwen Audio 3.0 Realtime », quelle que soit la façon de l’écrire, renvoie à la famille Qwen3-Omni utilisée en temps réel. C’est cette pile technologique que couvre la suite du guide.
La pile audio temps réel Qwen en trois briques
Plutôt que de voir Qwen comme un modèle unique, mieux vaut raisonner en pipeline. Une application vocale en production s’appuie généralement sur trois modèles Qwen, utilisables ensemble ou séparément.
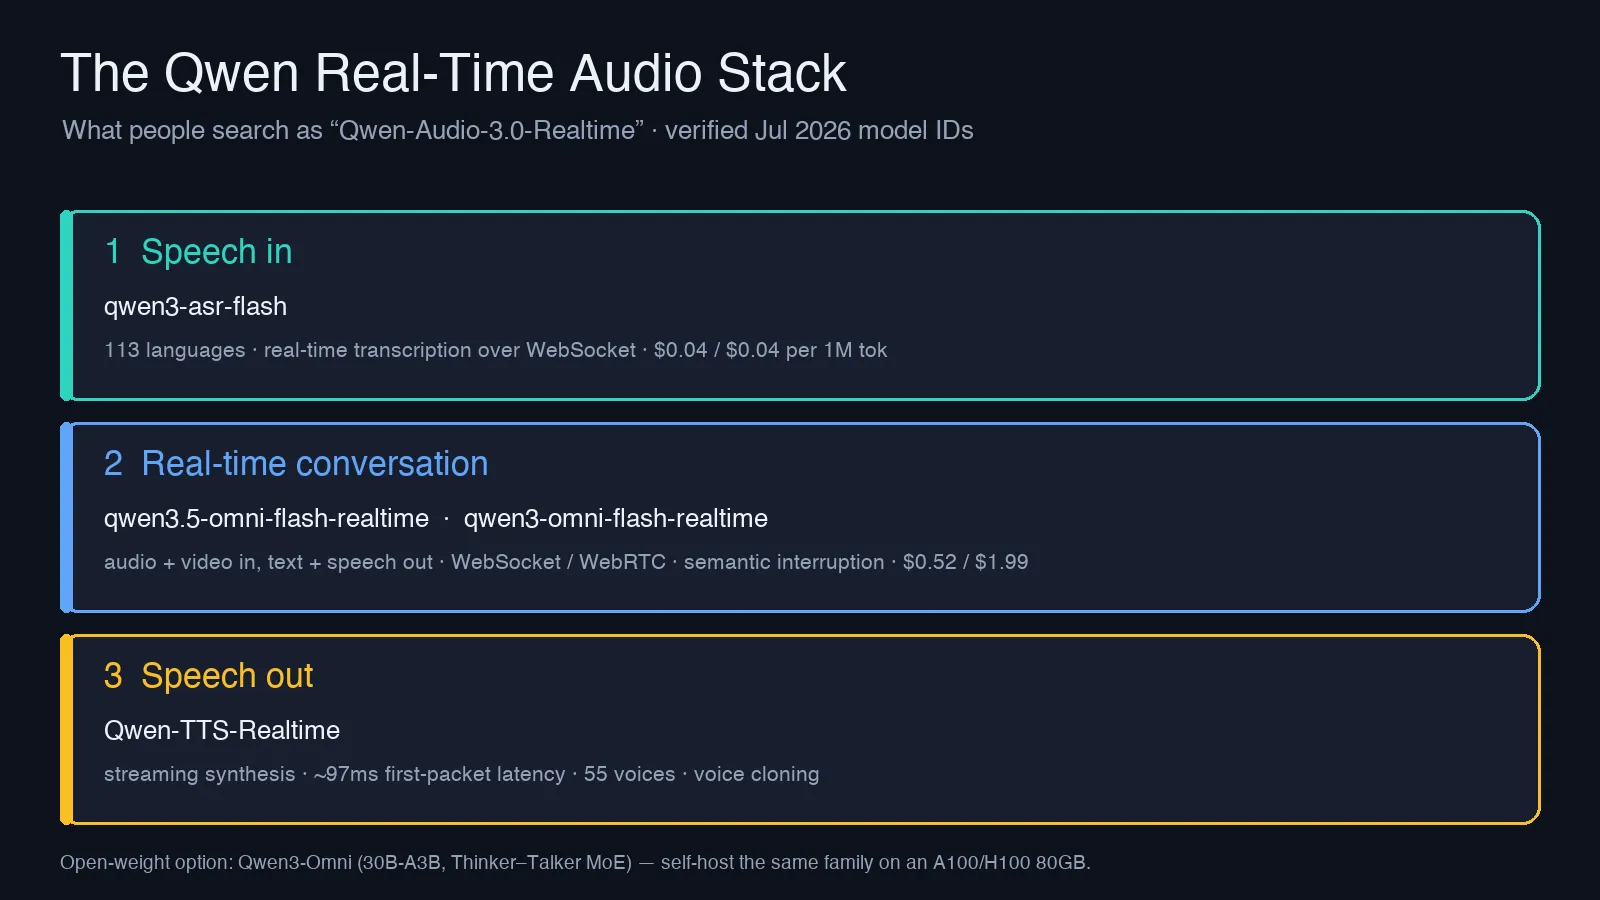
- Entrée vocale —
qwen3-asr-flash. Un moteur de reconnaissance vocale en streaming via WebSocket, pensé pour le sous-titrage en direct et les interfaces d’agents vocaux. Il transcrit un très grand nombre de langues et se positionne comme une solution économique de transcription. - Conversation temps réel —
qwen3.5-omni-flash-realtime,qwen3-omni-flash-realtime,qwen3.5-omni-plus-realtime. C’est le cœur du système : audio, et éventuellement images vidéo, entrent ; texte et parole synthétisée ressortent. La connexion persistante reste ouverte entre les tours de parole, sans être recréée à chaque requête. - Sortie vocale —
Qwen-TTS-Realtime. Un modèle de synthèse vocale dédié au streaming, adapté lorsque vous voulez uniquement convertir un texte en voix, par exemple pour lire la réponse générée par un LLM textuel.
Avec un modèle omni Realtime au centre du pipeline, il n’est souvent pas nécessaire d’appeler séparément un service ASR et un service TTS : il prend en charge la voix de bout en bout. Les modèles séparés restent utiles si vous souhaitez composer votre propre chaîne, par exemple avec un moteur STT maison et le TTS de Qwen.
Les caractéristiques qui comptent vraiment
Voici les données de la documentation Model Studio Realtime, et non des pages marketing.
| Caractéristique | API Qwen Realtime (famille omni) |
|---|---|
| Entrée audio | PCM, 16 kHz |
| Sortie audio | PCM, 24 kHz |
| Autres entrées | Images / images vidéo (JPG, jusqu’à 1080p, 256 Ko après encodage) |
| Reconnaissance vocale | 113 langues et dialectes (API hébergée) |
| Génération vocale | 36 langues et dialectes |
| Voix | 55 au total (47 multilingues, 8 dialectales), avec en plus le clonage vocal sur les modèles 3.5 |
| Connexions | WebSocket (authentification Bearer, VAD manuel ou côté serveur) et WebRTC (négociation SDP) |
| Durée maximale d’une session | 120 minutes via WebSocket |
| Fonctions supplémentaires | Interruption sémantique, appel de fonctions, recherche web autonome, contrôle vocal du volume / débit / émotion |
Quelques points méritent d’être soulignés. L’interruption sémantique permet au modèle de distinguer une véritable interruption d’un simple acquiescement tel que « hum-hum » : c’est ce qui sépare un agent vocal naturel d’un assistant agaçant. La prise en charge de WebRTC est importante pour les applications navigateur, car elle gère notamment l’annulation d’écho et la gigue. Enfin, le chiffre de 113 langues concerne l’API hébergée ; la version à poids ouverts couvre un ensemble plus restreint, comme indiqué plus loin.
Côté latence, le chemin de streaming dédié de Qwen-TTS-Realtime vise environ 97 ms de latence jusqu’au premier paquet, selon la documentation de streaming Qwen3-TTS. C’est la mesure qui détermine si la voix semble instantanée. Elle correspond au délai avant le premier fragment audio, et non à la réponse complète. Pour une conversation complète, l’architecture Thinker–Talker est conçue pour le streaming ; le rapport technique Qwen3-Omni décrit une architecture multi-codebook visant à réduire la latence au minimum, tandis que des tests communautaires situent la réponse audio-à-audio sous les 250 ms, avec duplex intégral et tours de parole interrompables. Les résultats réels dépendent de votre région, de votre réseau et de la charge : mieux vaut les mesurer sur votre propre trafic que s’en remettre à un chiffre unique.
Tarifs de l’audio temps réel Qwen : les chiffres utiles
Les prix temps réel hébergés de Qwen sont nettement inférieurs à ceux des API temps réel fermées. Les montants ci-dessous sont exprimés par million de tokens, entrée / sortie, tels qu’ils figurent dans le répertoire de modèles DashScope de Portkey, un agrégateur tiers qui reprend les tarifs d’Alibaba. Vérifiez le prix en vigueur dans la console Model Studio avant de vous engager :
| Modèle | Entrée / 1 M tokens | Sortie / 1 M tokens |
|---|---|---|
qwen-omni-turbo-realtime | $0.27 | $1.07 |
qwen3-omni-flash-realtime | $0.52 | $1.99 |
qwen3-asr-flash (transcription) | $0.04 | $0.04 |
Ce que cela représente par appel. L’audio consomme beaucoup de tokens : environ 427 tokens par minute d’audio. Prenons une conversation vocale de 10 minutes, durant laquelle l’utilisateur parle 5 minutes et le modèle répond 5 minutes. Avec qwen3-omni-flash-realtime, cela représente environ 2 135 tokens en entrée et 2 135 tokens en sortie, soit approximativement $0.001 en entrée + $0.004 en sortie ≈ un demi-centime pour un appel de 10 minutes. Même à grande échelle, l’audio temps réel reste peu coûteux ; le poste qui surprend est le temps de parole en sortie, les réponses vocales étant facturées environ 4 fois plus que l’entrée.
Avant d’établir votre budget, gardez aussi ces deux éléments en tête :
- Un quota gratuit existe, mais il dépend de la région. L’endpoint de Singapour, destiné à l’international, a proposé 1 million de tokens en entrée et 1 million en sortie gratuits pendant 90 jours ; l’endpoint américain ne l’a pas proposé. Les quotas évoluent : vérifiez l’offre actuelle dans la console Model Studio de votre région avant de bâtir votre plan dessus.
- Le niveau
qwen3.5-omniapplique des paliers tarifaires selon la taille des requêtes, et non un tarif fixe. Une seule requête avec un gros contexte peut donc tomber dans une tranche différente de plusieurs petites requêtes. Testez ce comportement avec la forme réelle de votre trafic avant de vous engager.
Face à OpenAI Realtime et Gemini Live
Parmi les fournisseurs de LLM généralistes de pointe, les trois options évidentes de parole-à-parole en temps réel à la mi-2026 sont Realtime API d’OpenAI, Gemini Live de Google et la famille omni Realtime de Qwen. Les fournisseurs spécialisés dans la voix, comme ElevenLabs, Deepgram, Cartesia et Hume, sont aussi très compétitifs sur le TTS et le STT ; la comparaison porte ici sur l’approche à modèle multimodal complet. Plutôt que de citer des prix concurrents qui changent chaque mois, voici comment orienter le choix :
- Coût. Aux tarifs par appel présentés plus haut, Qwen se situe dans le bas de la fourchette des modèles de pointe hébergés. À titre de comparaison, l’audio Realtime d’OpenAI s’est situé autour de $0.06 par minute en entrée et $0.24 par minute en sortie (détail des tarifs ici) ; sur cette base, le même appel de 10 minutes facturé environ un demi-centime avec
qwen3-omni-flash-realtimese rapprocherait de $1.50 chez OpenAI. Vérifiez les tarifs à jour des deux côtés avant de compter sur cet écart, car ils évoluent tous, mais la différence est importante. Qwen est également le seul des trois à proposer une version à poids ouverts, que vous pouvez auto-héberger afin de ramener le coût marginal vers zéro. - Ouverture. OpenAI Realtime et Gemini Live sont exclusivement des API fermées. Qwen3-Omni est publié avec ses poids ouverts : vous pouvez donc passer de l’offre hébergée à l’auto-hébergement sans réécrire votre application pour adopter le comportement d’un autre modèle.
- Qualité. Des analyses tierces indiquent que le niveau haut de gamme
qwen3.5-omni-pluségale ou dépasse Gemini 3.1 Pro sur certains benchmarks de compréhension audio. Prenez tout benchmark isolé comme une hypothèse de départ et testez sur vos propres données audio. - Écosystème. OpenAI et Google disposent aujourd’hui d’outils, de SDK et d’exemples communautaires plus riches. La documentation de Qwen est solide, mais vous vous appuierez davantage sur la spécification WebSocket/WebRTC brute.
En pratique : si le coût ou la possibilité d’auto-héberger sont prioritaires, Qwen est le choix le plus convaincant. Si vous recherchez l’expérience SDK la plus mature et acceptez de la payer, OpenAI et Google gardent l’avantage sur le degré de finition. Pour une analyse complète du coût des alternatives fermées, consultez les lectures associées ci-dessous.
Quelle variante choisir ?
| Votre besoin | À utiliser |
|---|---|
| Boucle vocale complète hébergée au coût le plus bas | qwen3-omni-flash-realtime |
| Meilleure qualité hébergée, sessions plus longues, clonage vocal | qwen3.5-omni-plus-realtime |
| Vous avez uniquement besoin de transcription | qwen3-asr-flash |
| Vous avez uniquement besoin de synthèse vocale | Qwen-TTS-Realtime |
| Les données doivent rester sur votre propre matériel | Auto-héberger Qwen3-Omni à poids ouverts (30B-A3B) |
Les niveaux 3.5 ajoutent le clonage vocal, un contexte plus long et des limites de dialogue supérieures — jusqu’à 100 tours et 600 secondes d’audio conservé — face au plus léger qwen3-omni-flash, limité à 8 tours. Pour un prototype, commencez avec Flash ; ne passez à Plus que lorsque vous butez sur une limite clairement identifiée.
Comment y accéder
En hébergé, la voie directe. Créez une clé API dans Alibaba Cloud Model Studio, puis ouvrez une connexion WebSocket avec authentification Bearer. Pour les applications navigateur, vous pouvez aussi négocier WebRTC via un POST SDP. Vous envoyez de l’audio PCM en streaming et recevez de l’audio PCM ainsi que du texte. Le SDK Python DashScope encapsule l’interface Realtime si vous préférez ne pas gérer le socket directement. La connexion minimale est courte (exemple schématique, gestion des erreurs omise) :
import os, json, base64, websocket

MODEL = "qwen3-omni-flash-realtime"
url = f"wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model={MODEL}"
ws = websocket.create_connection(
    url, header=[f"Authorization: Bearer {os.environ['DASHSCOPE_API_KEY']}"]
)

# 1. configure the session: voice, output format, server-side turn detection
ws.send(json.dumps({
    "type": "session.update",
    "session": {
        "voice": "Cherry",
        "output_audio_format": "pcm24",
        "turn_detection": {"type": "server_vad"},
    },
}))

# 2. stream microphone audio up as base64 PCM 16 kHz frames
ws.send(json.dumps({
    "type": "input_audio_buffer.append",
    "audio": base64.b64encode(pcm_frame).decode(),
}))

# 3. read events back; response.audio.delta carries PCM 24 kHz to play
while True:
    event = json.loads(ws.recv())
    if event["type"] == "response.audio.delta":
        play(base64.b64decode(event["audio"]))
Avec le VAD côté serveur, le modèle décide à quel moment l’utilisateur a cessé de parler. Passez en mode manuel si vous voulez maîtriser vous-même les frontières entre les tours de parole. Le flux d’événements est très proche de celui d’OpenAI Realtime : un client Realtime existant se porte donc avec peu de modifications. Avant la mise en production, vérifiez les noms exacts des champs, la liste des voix et l’hôte de l’endpoint régional dans la documentation Realtime : ils diffèrent entre les déploiements de Singapour et des États-Unis, et l’API évolue.
En auto-hébergement. La version à poids ouverts de Qwen3-Omni repose sur une architecture Thinker–Talker Mixture-of-Experts, avec 30B de paramètres au total et environ 3B actifs. Alibaba recommande vLLM plutôt que Transformers seul. Pour l’inférence BF16 du modèle complet de 30B, des guides de déploiement tiers estiment le minimum à une seule carte de 80 Go, A100 ou H100. Une carte de 24 Go telle qu’une RTX 4090 ne suffit pas pour les poids complets, même si les versions quantifiées abaissent ce seuil.
Le revers de la médaille est que le service temps réel est plus complexe que l’inférence par lots. Des utilisateurs en auto-hébergement indiquent devoir limiter le cache KV pour éviter les blocages sous charge concurrente, tandis que le débit de tokens sur une seule carte reste inférieur à celui de l’API hébergée. Les piles de serving optimisées pour le streaming réduisent fortement cet écart : des ingénieurs travaillant sur Red Hat AI et vLLM ont rapporté qu’en chevauchant les étapes du pipeline, la génération vocale d’un extrait de 3 secondes passe d’environ 8 secondes à près de 0.5. Le gain est réel, mais il exige davantage d’ingénierie. L’auto-hébergement supprime le coût par token, tout en ajoutant des coûts de GPU et d’exploitation : il devient pertinent à volume élevé et régulier, plutôt que pour des prototypes.
Pour la voix omni temps réel aujourd’hui, l’endpoint DashScope constitue la voie de référence. Si votre pile fait déjà passer plusieurs fournisseurs par une passerelle unique, un agrégateur peut se placer devant, mais vérifiez d’abord que les identifiants précis des modèles Qwen temps réel figurent dans son catalogue : de nombreux relais proposent les modèles texte et image sans le niveau audio temps réel.
Les limites à connaître avant de vous lancer
- Les sessions sont limitées à 120 minutes. Pour toute interaction plus longue, telle qu’une ligne de support ou un long cours particulier, prévoyez une logique de reconnexion qui conserve le contexte entre les sockets.
- La région influe sur le quota gratuit comme sur la disponibilité. Testez l’endpoint sur lequel vous allez déployer, et non simplement celui auprès duquel vous vous êtes inscrit en premier.
- L’offre hébergée et les poids ouverts ne sont pas identiques. L’API hébergée annonce une reconnaissance dans 113 langues et une génération dans 36 langues ; la version à poids ouverts de Qwen3-Omni couvre un ensemble plus restreint, avec 19 langues en entrée vocale et 10 langues en sortie vocale. Si une langue particulière est indispensable, validez-la sur la variante exacte que vous prévoyez de déployer.
- Le coût temps réel dépend du temps de parole, pas du nombre de requêtes. L’audio étant riche en tokens, un utilisateur bavard coûte davantage qu’un utilisateur concis. Modélisez votre facture selon les minutes de conversation, et non le nombre d’appels.
Questions fréquentes
Qwen 3 prend-il en charge l’audio ?
Oui. Les modèles Qwen3-Omni sont nativement multimodaux : ils acceptent l’audio, le texte, les images et la vidéo en entrée, puis peuvent répondre en texte ou à l’oral en temps réel.
Qwen peut-il générer de l’audio, et pas seulement le comprendre ?
Oui. À la différence du Qwen-Audio original, qui ne produisait que du texte, les modèles omni Realtime et Qwen-TTS-Realtime génèrent une sortie vocale, y compris avec des voix clonées au niveau 3.5.
L’audio temps réel de Qwen est-il gratuit ?
Un quota d’essai gratuit existe : historiquement, 1 million de tokens en entrée et 1 million en sortie pendant 90 jours sur l’endpoint international de Singapour. Au-delà, la facturation se fait au token. Qwen3-Omni, entièrement disponible à poids ouverts, est gratuit à exécuter si vous fournissez votre propre GPU.
Comment exécuter Qwen audio en local ?
Téléchargez Qwen3-Omni à poids ouverts (30B-A3B) et servez-le avec vLLM. Pour le modèle complet en BF16, il vous faudra environ une carte de 80 Go, A100 ou H100 ; les GPU grand public plus petits ne peuvent exécuter que les versions quantifiées, pas les poids complets.
Pour aller plus loin
Sources principales :
- Documentation de l’API Alibaba Model Studio Realtime
- Fiche de modèle et poids ouverts Qwen3-Omni (GitHub)
Tarifs des alternatives :