 AIREITER
Entre ultra, Fast mode et Ultrafast mode, la nomenclature d’OpenAI peut vite prêter à confusion. Un seul de ces trois termes correspond toutefois à une vitesse pouvant atteindre 750 tokens par seconde : Ultrafast mode. Annoncé le 13 août 2026, ce nouveau tier d’API fait tourner GPT-5.6 Sol sur des puces wafer-scale de Cerebras, à une vitesse jusqu’à 14 fois supérieure au traitement Standard. Il reste cependant accessible sur invitation uniquement, sans tarif publié. À ce jour, le tier le plus rapide que l’on puisse réellement acheter demeure donc Fast mode, facturé $10/$60 par million de tokens.
ultra, Fast mode et Ultrafast : trois termes à ne pas confondre
Les clients de GPT-5.6 Sol se retrouvent aujourd’hui face à trois appellations liées à la vitesse, mais elles recouvrent des réalités très différentes. Voici comment les distinguer.
| Nom | De quoi s’agit-il ? | Comment y accéder | Prix Sol (par 1 M de tokens) | Vitesse annoncée |
|---|---|---|---|---|
Réglage de raisonnement ultra | Un mode de raisonnement/travail qui mobilise des sous-agents et davantage de calcul sur une même tâche | Réglage Codex, et non un tier d’API acheté séparément | Pas de tarif dédié ; consomme rapidement les limites d’usage | Plus lent par conception |
| Fast mode | Tier de traitement API, renommé depuis Priority le 30 juillet 2026 | service_tier="fast" dans toute requête API | $10 en entrée / $60 en sortie (contexte court) | Jusqu’à 2,5x Standard |
| Ultrafast mode | Tier d’API propulsé par Cerebras pour GPT-5.6 Sol, présenté en aperçu le 13 août 2026 | Aperçu limité, réservé à certains clients | Non communiqué | Jusqu’à 14x Standard |
Ces options vont en réalité dans des directions opposées. ultra est le mode de travail à sous-agents qui sacrifie la vitesse au profit de l’exhaustivité, tandis qu’Ultrafast mode vise la vitesse brute de décodage sur le même modèle. Entre les deux, Fast mode est une accélération de latence achetable, documentée séparément sur la page Fast mode d’OpenAI.
Ce que livre réellement l’aperçu du 13 août
L’annonce officielle établit cinq faits précis. Ultrafast arrive d’abord dans l’API OpenAI, fonctionne uniquement avec GPT-5.6 Sol, promet jusqu’à 14x la vitesse du traitement Standard et jusqu’à 750 tokens de sortie par seconde, s’appuie sur Cerebras et est proposé en aperçu limité à un groupe sélectionné de clients, parmi lesquels Jane Street, Podium, Basis et Rogo.
En revanche, quatre informations essentielles pour un acheteur manquent à l’appel : le prix par token, l’identifiant du modèle, les limites de débit et un SLA de latence. L’annonce ne cite pas non plus de benchmark nommé.
OpenAI s’appuie sur une démonstration côte à côte : Ultrafast et Standard Sol doivent créer un simulateur d’entrepôt 3D à partir d’un seul prompt. La promesse est bien résumée par Alex Wang de Rogo : « Ultrafast makes complex financial research feel like a real-time interaction. »
De 2,5x à 14x : ce que change l’écart de vitesse
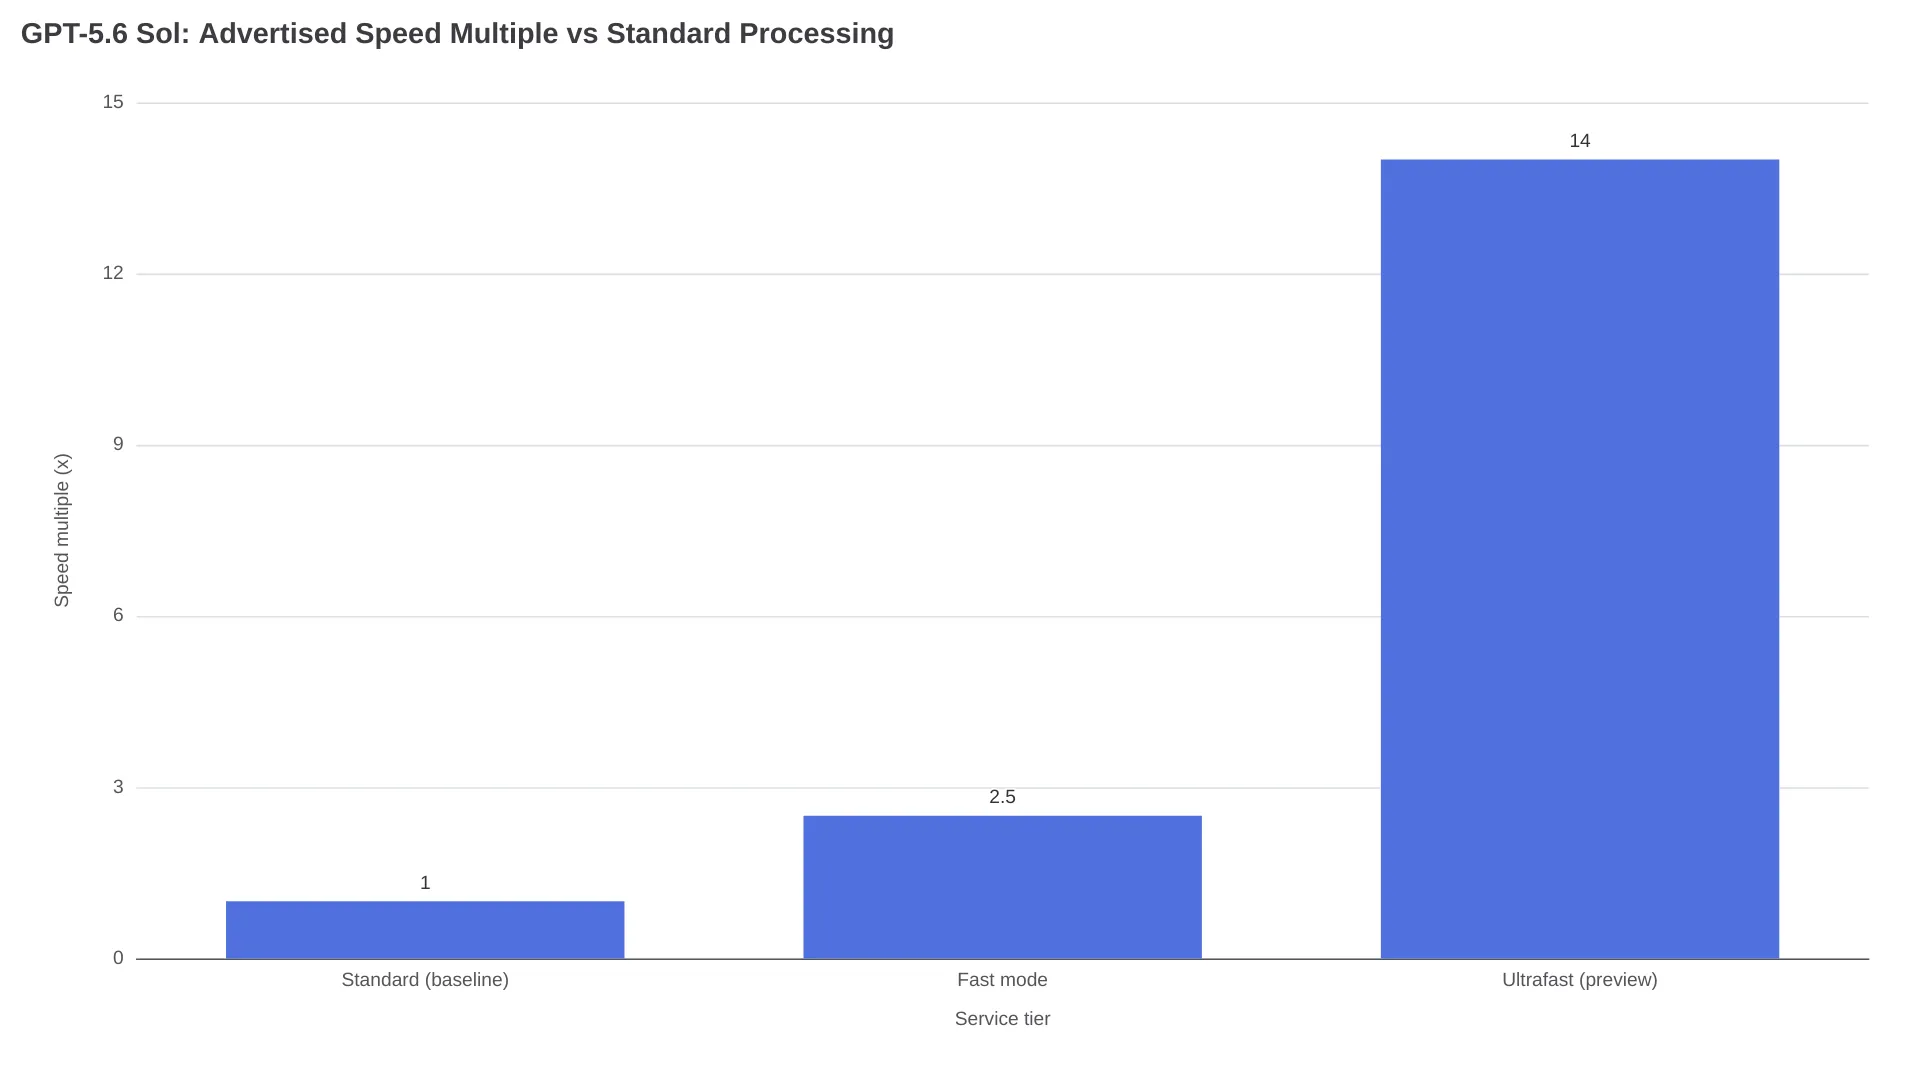
Une nuance méthodologique s’impose d’abord : les 750 tokens par seconde correspondent à un débit de sortie annoncé, alors que le chiffre de Fast mode est un plancher SLA. Les deux métriques sont liées, mais ne mesurent pas strictement la même chose. En divisant 750 par 14, on obtient un décodage Standard Sol d’environ 54 tokens par seconde. Une génération de 10 000 tokens prendrait donc approximativement 186 secondes en Standard, jusqu’à 125 secondes avec le plancher SLA Enterprise de Fast mode à 80 tokens par seconde, et environ 13 secondes avec Ultrafast.
| Charge de travail | Standard (~54 tok/s, calculé) | Fast mode (SLA ≥80 tok/s) | Ultrafast (750 tok/s annoncés) |
|---|---|---|---|
| Génération de 10 000 tokens | ~186 s | ≤125 s | ~13 s |
| Boucle d’agent de 5 tours, 1 000 tokens/tour | ~93 s | ≤63 s | ~7 s |
Des chiffres partagés sur r/AIToolsPerformance attribuent ces comparaisons à Artificial Analysis et Cerebras : Ultrafast serait 11x plus rapide que Claude Fable 5 et 5x plus rapide qu’Opus 4.8 en Fast mode ; un passage complet de Humanity's Last Exam, soit 2 500 questions, prendrait 11 heures 11 minutes, contre 78 heures 27 minutes pour Fable 5. Ces données sont toutes rapportées par des fournisseurs et n’ont pas encore fait l’objet d’une reproduction indépendante.
Le tarif qu’aucun client hors aperçu ne connaît
Le prix d’Ultrafast n’est pas public. L’annonce ne donne aucun tarif, un manque aussitôt relevé par la communauté. Comme l’écrit un contributeur de r/AIToolsPerformance : « What the blog doesn't say is price. Nobody outside the preview knows what it costs. »
La grille tarifaire connue de GPT-5.6 Sol, exprimée par million de tokens, reste aujourd’hui le seul point de référence :
| Tier | Entrée (ctx court) | Sortie (ctx court) | Entrée (ctx long >272k) | Sortie (ctx long) | Entrée en cache |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | non communiqué | non communiqué | non communiqué | non communiqué | non communiqué |
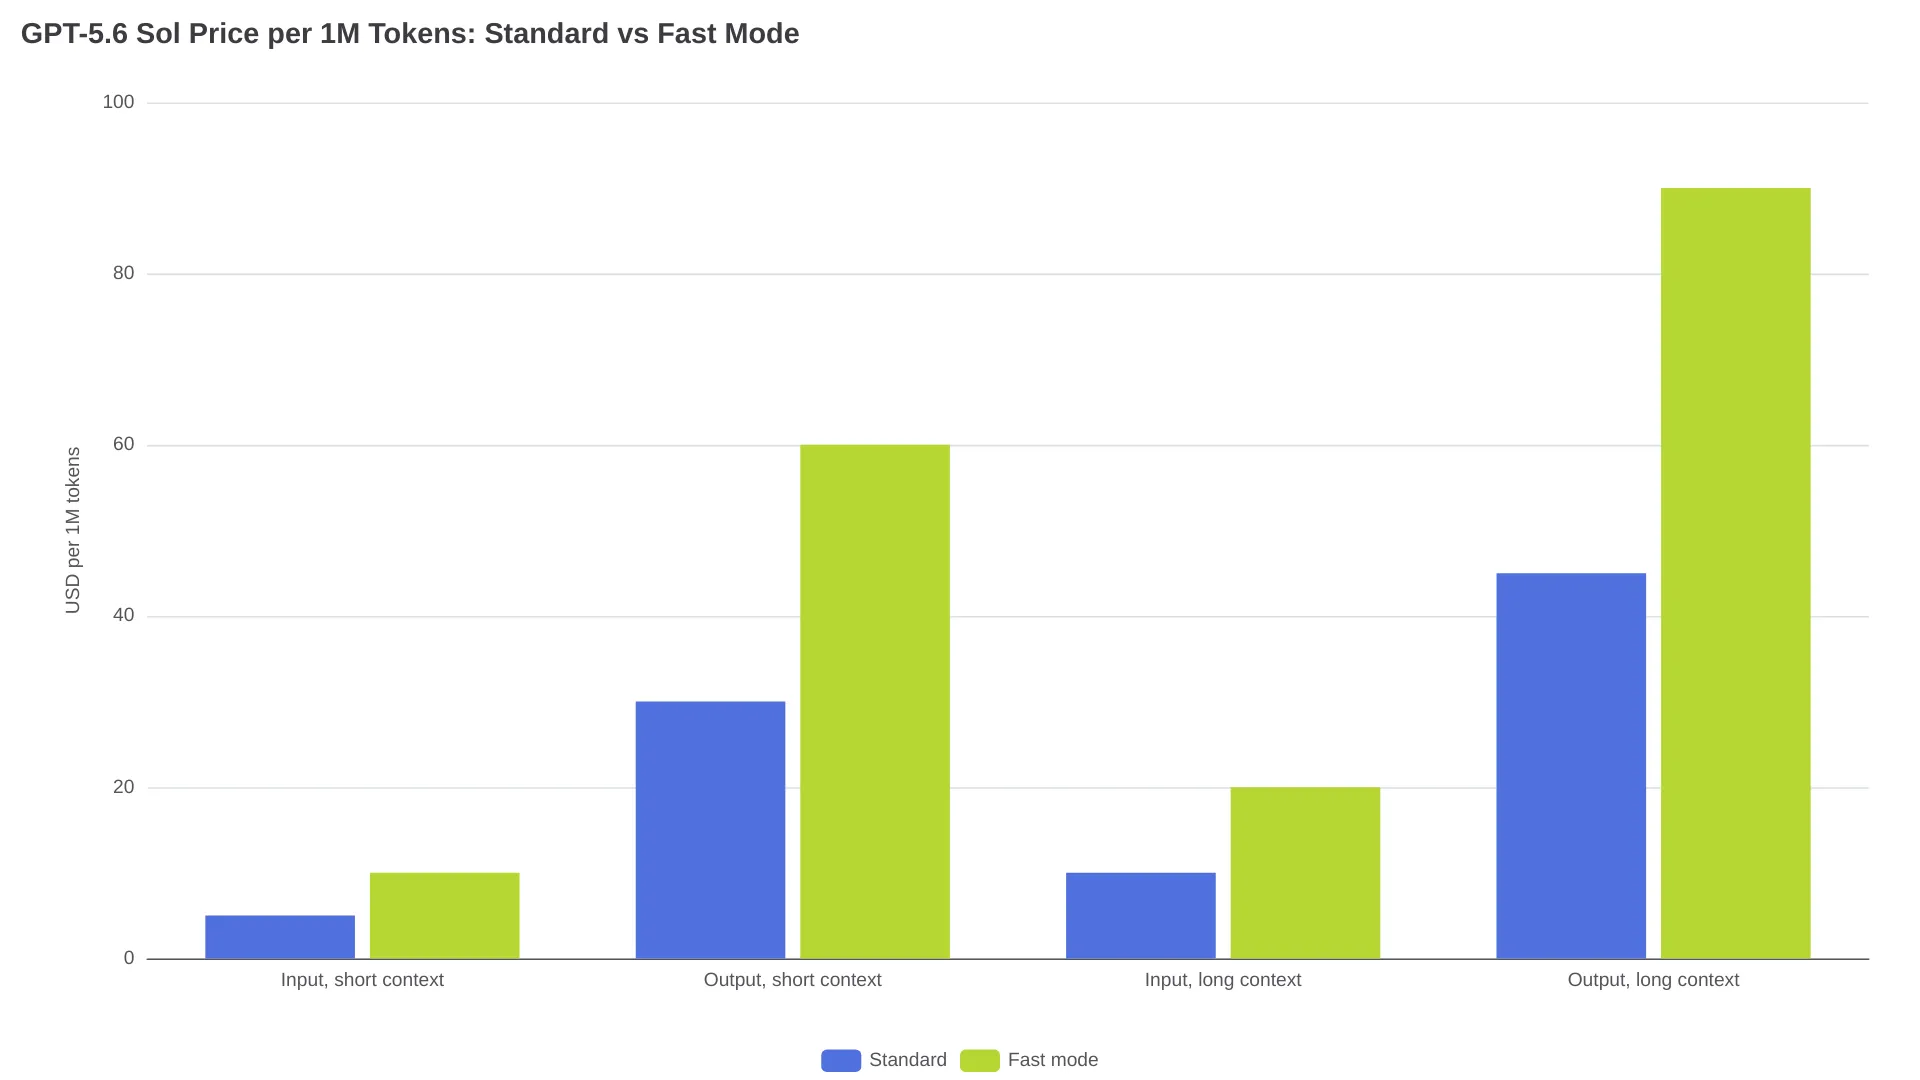
Fast mode coûte exactement 2x le prix de Standard pour Sol. Les informations publiques ne permettent pas d’extrapoler le prix d’Ultrafast à partir de ce ratio, les tarifs pouvant évoluer dans les deux sens : OpenAI a par exemple baissé les prix de Terra/Luna le 30 juillet. Les conditions de Fast mode comptent aussi dans tout calcul de budget de latence : au-delà de 1 million de tokens par minute, si le trafic augmente de plus de 50 % en moins de 15 minutes, les requêtes excédentaires basculent silencieusement vers Standard, renvoient service_tier="Default" et sont facturées au tarif Standard.
Accès à Ultrafast : la situation actuelle
L’accès à Ultrafast se fait sur invitation, et non via une liste d’attente publique. OpenAI indique que l’aperçu s’élargira « as capacity grows » et propose une inscription aux mises à jour d’accès sur la page d’annonce. Un article de juillet ne recensait qu’environ 20 organisations disposant de l’accès anticipé à Sol.
L’infrastructure ne sort pas de nulle part : le partenariat d’OpenAI avec Cerebras remonte au 14 janvier 2026 et réserve 750 MW de capacité wafer-scale. Sur ce même matériel, GPT-5.3-Codex-Spark dépassait déjà 1 000 tokens par seconde.
Obtenir des sorties rapides en attendant son invitation
Fast mode est déjà disponible pour tous les clients API, et son activation ne demande qu’un paramètre :
- Ajoutez
service_tier="fast"à une requête vers/v1/responsesou/v1/chat/completions. - Les anciennes valeurs
service_tier="priority"continuent de fonctionner. Les modèles existants affichent toujoursprioritydans les tableaux de bord d’utilisation, tandis que les modèles postérieurs à GPT-5.6 afficherontfast. - Pour l’activer par défaut sur un projet entier, allez dans Project settings -> Default Service Tier -> Fast.
| Modèle compatible Fast mode | Prix par 1 M (entrée / sortie) | SLA de latence |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 tok/s |
| GPT-5.6 Terra | $4 / $24 | >70 tok/s |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 tok/s |
Le plancher SLA de Luna est le plus élevé des trois. Les lectures de cache réduisent de 90 % le coût des entrées : $0.50/M sur Standard Sol, avec un TTL d’environ 30 minutes. Pour une session longue, conserver le cache est donc plus avantageux que d’envoyer de nouvelles requêtes, quel que soit le tier. Pour confronter ces tiers au trafic réel, l’endpoint API GPT-5.6 donne accès aux trois modèles via une seule interface.
FAQ
Ultrafast mode est-il disponible dans ChatGPT ou Codex ?
Non. Ultrafast arrive d’abord dans l’API OpenAI, et l’annonce ne donne aucune date de disponibilité pour ChatGPT ou Codex.
Faire tourner GPT-5.6 Sol sur Cerebras modifie-t-il la qualité des sorties ?
OpenAI présente Ultrafast comme le même GPT-5.6 Sol servi plus vite, et non comme un autre modèle. Une accélération de 5,6x sur GDP-Val sans baisse de qualité, rapportée par Cerebras, est pour l’instant la seule affirmation relative à la qualité ; aucun benchmark indépendant ne l’a reproduite.
Ultrafast mode dispose-t-il d’un SLA de latence ?
Aucun SLA n’est publié. Fast mode propose aux clients Enterprise un SLA p50 de >80 tokens/s et une disponibilité de 99,9 % ; Ultrafast ne comporte aucun SLA annoncé pendant l’aperçu.
Quels modèles prennent en charge Ultrafast mode ?
GPT-5.6 Sol uniquement. Terra et Luna prennent en charge Fast mode, mais ne font pas partie de l’aperçu Ultrafast.
Combien coûtera Ultrafast mode ?
Aucun chiffre officiel n’existe. Le surcoût publié de 2x de Fast mode par rapport à Standard Sol est le seul point de référence disponible.