 AIREITER
Lancé le 13 août 2026, MiniMax Music 3.0 réunit trois arguments majeurs : des poids ouverts sur HuggingFace, une API facturée 0,15 $ par morceau et des générations pouvant atteindre cinq minutes. Quelques zones restent toutefois floues : la documentation de l’endpoint mentionne encore Music 2.6, tandis que l’inférence en local peut nécessiter jusqu’à 24 Go de VRAM.
Music 3.0 : des morceaux de cinq minutes générés d’un seul tenant
Music 3.0 devient le modèle musical recommandé par MiniMax à la place de Music 2.6. Son évolution la plus visible est la génération, en une seule passe, de titres allant jusqu’à cinq minutes, avec composition, arrangement, interprétation et production. Selon MiniMax, cela corrige un défaut des versions précédentes : au-delà de la première section, elles avaient tendance à perdre la cohérence du genre, de l’instrumentation et des voix (blog officiel).
| Composant | Paramètres | Rôle |
|---|---|---|
| LLM global (issu de Qwen3.5-8B) | 8B | Prédit la structure musicale et la sémantique sur l’ensemble du morceau |
| LLM local | 0.6B | Ajoute les détails acoustiques fins à l’intérieur de chaque frame |
| Flow-matching + Flow-VAE | 2.4B + 123M | Transforme les états cachés en audio continu, et non en tokens discrets |
Sous le capot, une pile de quantification vectorielle résiduelle (RVQ) à 8 couches distingue la structure musicale globale — couche 1 et dictionnaire de 16 384 entrées — des détails acoustiques fins, gérés par les couches 2 à 8 avec 1 024 entrées chacune. Le LLM global conserve le contexte à l’échelle du titre, le LLM local prédit l’acoustique frame par frame, puis la pile de flow-matching produit l’audio final à partir d’états cachés fusionnés plutôt que de décoder uniquement des tokens discrets. Le blog affirme que cette approche atténue les artefacts dans les hautes fréquences et le phrasé rigide des anciens modèles de musique IA, mais MiniMax n’a pas publié de benchmark contrôlé face à Music 2.6, Suno ou Udio.
API Music 3.0 : prix, identifiants et limites de requêtes
La plateforme officielle de MiniMax propose deux identifiants de modèles Music 3.0, avec une facturation simple à l’usage :
| Identifiant du modèle | Prix par morceau | Limite de débit | Remarques |
|---|---|---|---|
Music-3.0 | 0,15 $ | 120 RPM | Contactez les ventes pour des limites plus élevées |
Music-3.0-free | 0 $ | 3 RPM | Palier d’essai gratuit |
Génération/édition de paroles Music-3.0 | 0,01 $ | — | Génération ou optimisation automatique des paroles |
Les deux modèles produisent un morceau complet par appel d’API, avec voix et jusqu’à cinq minutes de durée. L’endpoint est POST /v1/music_generation, le même que pour Music 2.6. Le jour du lancement, la documentation de référence de l’API affichait encore music-2.6 dans ses exemples indexés. Les développeurs devront donc potentiellement tester manuellement l’identifiant Music-3.0 en attendant la mise à jour de la documentation.
Lancer Music 3.0 en local avec ComfyUI : matériel requis
C’est la publication des poids ouverts qui a le plus suscité l’enthousiasme de la communauté. Ils sont disponibles sur HuggingFace via MiniMaxAI/MiniMax-Music3, ainsi que dans une distribution optimisée pour ComfyUI sur Comfy-Org/MiniMax-Music-3.
La fiche du modèle documente trois niveaux de configuration matérielle, confirmés par les premiers retours de la communauté :
| Mode | VRAM | Vitesse approximative | Qualité |
|---|---|---|---|
| Pleine précision | <24 Go (ex. RTX 4090) | La plus rapide | La meilleure |
| Déport sur CPU | ~22 Go de GPU + 32 Go+ de RAM | Modérée | Proche du niveau maximal |
| Streaming des couches | 8 Go de GPU + 32 Go+ de RAM | Lente | Limitée |
Pour démarrer en local, installez ComfyUI en version 0.33.0 ou ultérieure (confirmation dans le fil de la communauté ComfyUI), téléchargez les fichiers du modèle depuis l’un des dépôts HuggingFace ci-dessus, chargez le workflow ComfyUI de MiniMax-Music3, choisissez le mode de précision adapté à votre VRAM, puis lancez la génération. CUDA est pour l’instant le seul backend de calcul pris en charge ; aucune voie ROCm ou MPS n’existe encore (selon les retours de la communauté). Une PR d’intégration Diffusers est en cours, ce qui ouvrirait l’inférence Python native en dehors de ComfyUI.
Un utilisateur de Reddit sur r/comfyui indique avoir généré 140 secondes de musique country avec une AMD RX 7900 GRE (16 Go de VRAM, 32 Go de RAM) en environ 125 secondes. Sur r/StableDiffusion, un autre fil résumait sans détour le sentiment de la communauté :
« Aujourd’hui, je me suis désabonné de Suno grâce à Minimax Music. » — r/StableDiffusion
Les conditions de licence méritent une lecture attentive avant tout usage commercial. Le blog parle de « poids ouverts » et d’un modèle « prêt pour la production », sans publier le texte de la licence, les clauses d’usage commercial ou les conditions de redistribution. Le fichier LICENSE du dépôt HuggingFace fait autorité : vérifiez-le avant de livrer un travail générant des revenus.
Bien prompter Music 3.0 avec les Structured Captions
L’interface de contrôle de Music 3.0 repose sur les Structured Captions : des descriptions détaillées, organisées dans le temps, qui indiquent au modèle ce qui doit se produire dans chaque partie du morceau. D’après le blog officiel, une caption bien construite précise :
- Genre et sous-genre (par exemple, « progressive house / EDM »)
- Tempo et tonalité (par exemple, « 126 BPM, si bémol majeur »)
- Instrumentation (par exemple, « ténor masculin aérien, synthés side-chainés, basse club, réverbération de salle »)
- Interprétation vocale (par exemple, « ténor rauque avec ruptures en falsetto »)
- Progression émotionnelle (par exemple, « couplet aérien montant vers un refrain énergique »)
- Caractère de production (par exemple, « mix room vintage », « claviers brillants »)
Les paroles utilisent les balises de sections standard reconnues par la plupart des modèles de musique IA :
[intro]
[verse]
[pre-chorus]
[chorus]
[bridge]
[instrumental]
[solo]
[outro]
Un Prompt Enhancement System peut développer une demande simple, telle que « chanson pop entraînante avec voix féminine », en Structured Caption complète utilisant le vocabulaire de l’industrie musicale. Les non-musiciens peuvent ainsi accéder à un contrôle détaillé sans maîtriser le jargon. Les instrumentaux se génèrent sans paroles ; les morceaux vocaux exigent des paroles fournies par l’utilisateur ou l’optimiseur de paroles à 0,01 $ par morceau.
MiniMax Music 3.0 face à Suno et Udio
La vraie question est simple : vaut-il mieux payer 0,15 $ par morceau à MiniMax ou s’abonner à un acteur déjà établi ?
| Fonctionnalité | MiniMax Music 3.0 | Suno | Udio |
|---|---|---|---|
| Durée maximale d’un morceau | 5 min | ~4 min | ~2–4 min |
| Modèle tarifaire | 0,15 $/morceau (à l’usage) | 10 $/mois Pro (500 morceaux) | 10 $/mois Standard (~600 morceaux) |
| Option gratuite | API à 3 RPM + poids ouverts | 10 morceaux/jour | Crédits limités |
| Poids ouverts | Oui (HuggingFace) | Non | Non |
| Déploiement local | Oui (ComfyUI) | Non | Non |
| Usage commercial | Vérifier la licence HuggingFace | Inclus dans les offres payantes | Inclus dans les offres payantes |
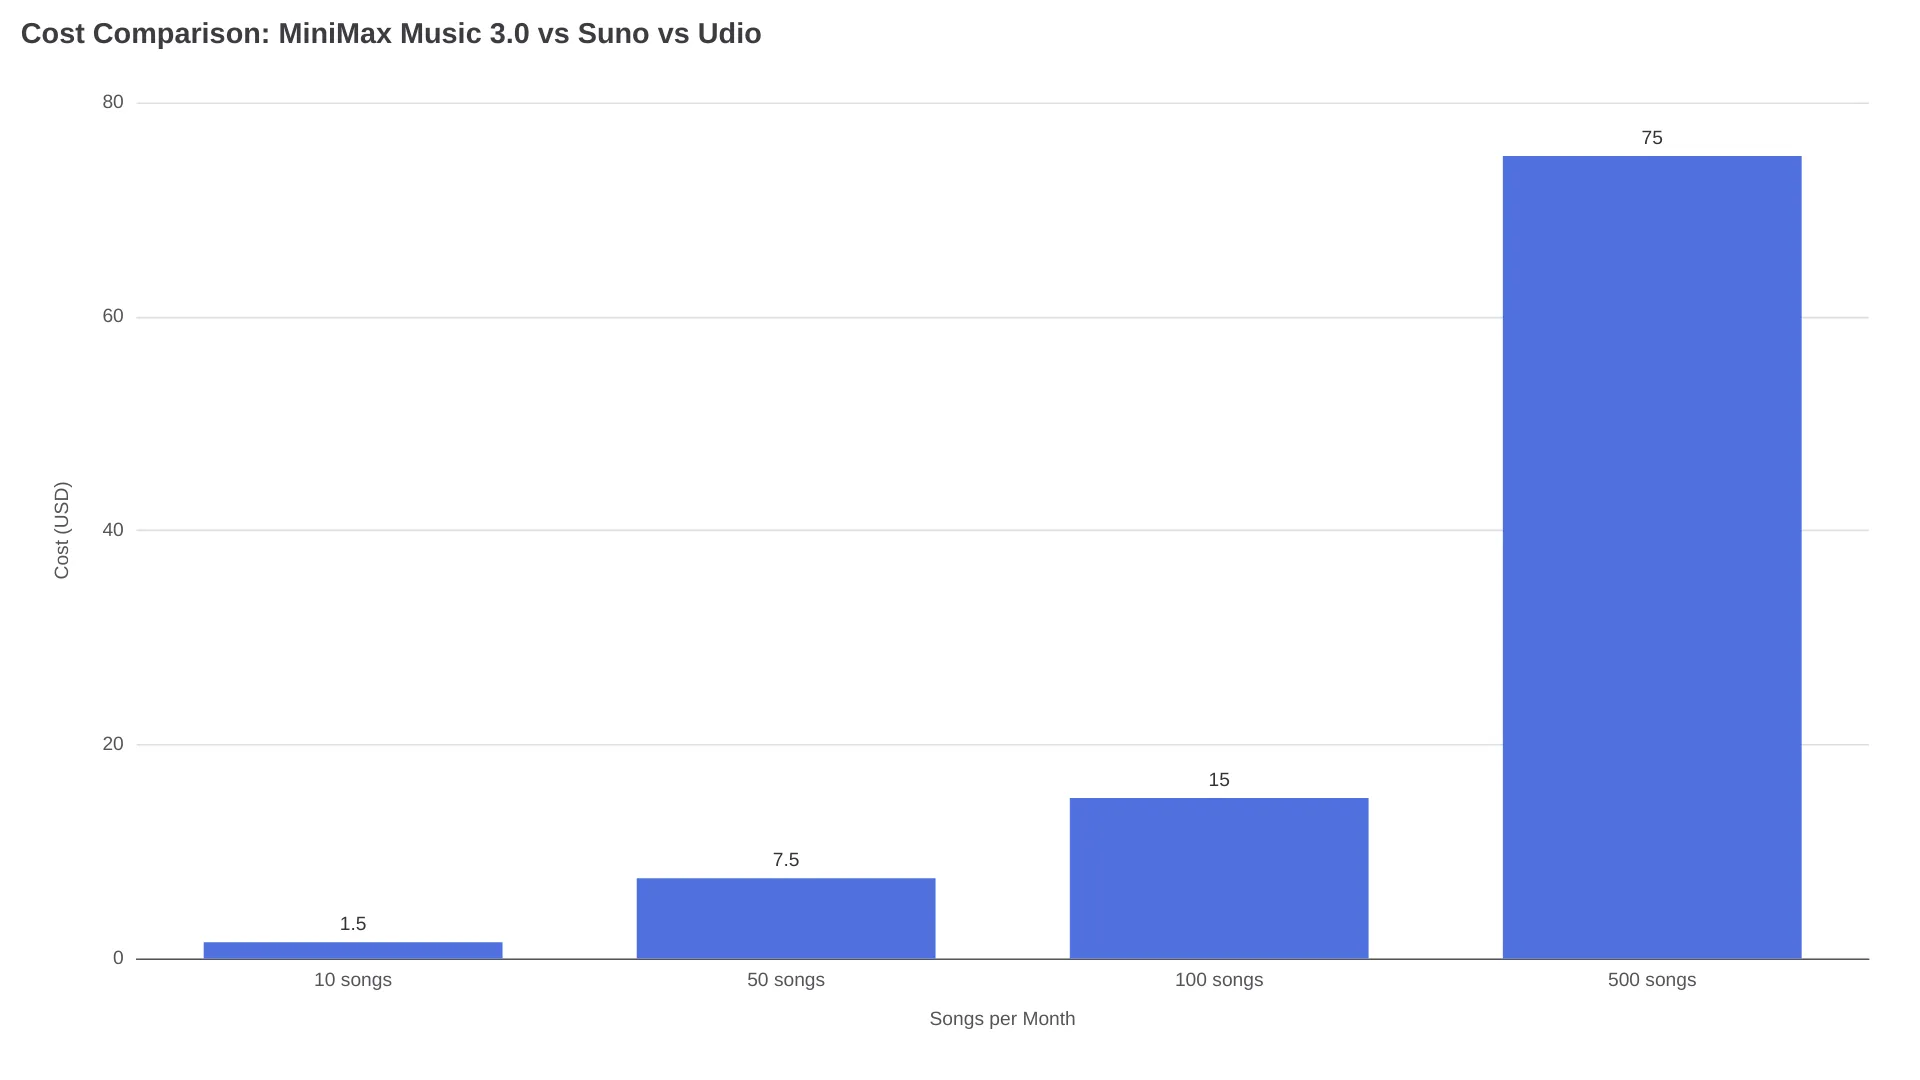
Le seuil de rentabilité se situe autour de 67 morceaux par mois. En dessous, la facturation à l’usage de MiniMax à 0,15 $ par morceau coûte moins cher que n’importe quel abonnement. Au-delà, Suno Pro ou Udio Standard, à 10 $ par mois pour plus de 500 morceaux, deviennent plus avantageux sur le seul critère du prix. Mais l’option locale à poids ouverts de MiniMax change la donne : les générations sont gratuites et illimitées si vous possédez déjà le GPU.
Les discussions sur r/SunoAI et r/comfyui placent Music 3.0 au niveau de Suno v4 pour le naturel des voix et le respect du prompt, avec des retours particulièrement positifs sur l’électro et la pop. Les avis sont plus partagés pour le rock, le metal et les styles acoustiques plus anciens : certains utilisateurs signalent un manque de clarté dans les mix denses. La prise en charge multilingue semble solide, avec du mandarin et de l’anglais dans les démos officielles, ainsi que du rap Bollywood testé par la communauté.
FAQ
MiniMax Music 3.0 est-il gratuit ?
Le modèle API Music-3.0-free génère des morceaux sans frais, dans la limite de 3 RPM. Il est également possible d’exécuter gratuitement le modèle à poids ouverts en local avec ComfyUI.
Music 3.0 peut-il créer des instrumentaux ?
Oui. La génération instrumentale ne nécessite pas de paroles ; la génération vocale demande des paroles fournies par l’utilisateur ou l’optimiseur de paroles à 0,01 $ par morceau.
Quel est l’identifiant API de Music 3.0 ?
Music-3.0 (120 RPM, 0,15 $/morceau) et Music-3.0-free (3 RPM), tous deux via POST /v1/music_generation. Attention : la documentation de l’API mentionne encore music-2.6 sur certaines pages.
Music 3.0 prend-il en charge des langues autres que l’anglais ?
Les démos officielles incluent le mandarin et l’anglais. Des tests communautaires montrent des générations réussies en hindi (test de rap Bollywood). Aucune liste officielle des langues prises en charge n’a été publiée.
Puis-je exploiter commercialement des morceaux MiniMax Music 3.0 ?
Consultez le fichier LICENSE de HuggingFace ainsi que les conditions d’utilisation de l’API. Le blog ne précise pas les droits d’usage commercial.
De combien de VRAM ai-je besoin pour exécuter Music 3.0 en local ?
Moins de 24 Go en pleine précision, ~22 Go avec déport sur CPU, ou 8 Go en mode streaming des couches. Consultez le tableau matériel ci-dessus.
Quelle option choisir selon votre usage ?
| Votre situation | Option recommandée | Coût |
|---|---|---|
| Tester ou prototyper quelques morceaux | API Music-3.0-free | 0 $ |
| Usage de production occasionnel (<67 morceaux/mois) | API Music-3.0 | 0,15 $/morceau |
| Génération en volume (>67 morceaux/mois) | Suno Pro ou Udio Standard | 10 $/mois |
| Vous possédez un GPU de 24 Go et voulez générer gratuitement sans limite | ComfyUI en local avec les poids HuggingFace | 0 $ (calcul uniquement) |
| Vous développez une application avec génération musicale programmable | API Music-3.0 via la plateforme MiniMax | 0,15 $/morceau |
Deux lacunes subsistent : le retard de la documentation de l’API, encore centrée sur Music 2.6, et les conditions de licence non détaillées pour les poids ouverts. Ces deux points devraient être clarifiés à mesure que la sortie se stabilise, mais aucun n’empêche l’API de fonctionner dès aujourd’hui.