 AIREITER
Pour un agent de code qui reste sous environ 150K tokens de contexte, Hy3 est le choix le plus judicieux : il coûte à peu près autant par token d'entrée et raisonne un peu mieux. Dès que les sessions s'allongent, que le dépôt prend de l'ampleur ou que la production exige une forte concurrence, DeepSeek V4 Flash prend l'avantage sur trois chiffres que Hy3 ne peut pas égaler : 1M de tokens de contexte, un tarif documenté de $0.0028 pour les cache hits et un plafond de 2,500 requêtes concurrentes. Voilà l'essentiel du choix entre hy3 et deepseek v4 flash. Cette analyse s'appuie sur les tarifs relevés le 14 juillet 2026 dans la documentation officielle de DeepSeek et les listings en direct d'OpenRouter, sur des benchmarks tiers, ainsi que sur les retours de développeurs qui utilisent les deux modèles quotidiennement sur Hacker News et Reddit.
Deux approches très différentes
Tencent a publié la version finale de Hy3 le 6 juillet 2026, après une préversion disponible depuis le 23 avril. Selon cette annonce, il s'agit d'un modèle Mixture-of-Experts comptant 295B de paramètres au total, dont 21B actifs. Son principe repose sur ce que Tencent appelle une réflexion hybride, rapide ou lente : le modèle décide requête par requête du niveau de raisonnement à mobiliser. La fenêtre de contexte atteint 256K tokens. Les poids sont ouverts sous licence Apache 2.0, et l'API est proposée via Tencent Cloud TokenHub.
DeepSeek V4 Flash est arrivé en avril 2026 comme déclinaison rapide de la famille V4. C'est lui aussi un MoE à poids ouverts — 284B de paramètres au total, 13B actifs selon Artificial Analysis — mais sous licence MIT et conçu avec une autre priorité : servir à bas coût jusqu'à 1M tokens de contexte. Il propose des modes thinking et non-thinking, le premier étant activé par défaut, et peut générer jusqu'à 384K tokens en sortie.
Les volumes de paramètres se ressemblent, mais les objectifs de conception divergent. Hy3 privilégie la qualité de raisonnement par token ; Flash mise sur la longueur du contexte, l'efficacité du cache et le débit. C'est de cette différence que découlent l'essentiel des écarts pratiques.
| Caractéristique (vérifiée le 2026-07-14) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| Paramètres | 295B au total / 21B actifs | 284B au total / 13B actifs |
| Fenêtre de contexte | 256K | 1M (384K maximum en sortie) |
| Raisonnement | Réflexion hybride rapide/lente | Modes thinking + non-thinking |
| Licence | Apache 2.0 | MIT |
| Sortie | 6 juillet 2026 (préversion le 23 avril) | Avril 2026 |
| API officielle | Tencent Cloud TokenHub | api.deepseek.com (formats OpenAI + Anthropic) |
Ce que disent vraiment les benchmarks
Dans l'Intelligence Index v4.1 d'Artificial Analysis, Hy3 obtient 41 points, contre 37 pour DeepSeek V4 Flash en mode raisonnement avec effort élevé. Quatre points sur cet indice représentent un écart réel, approximativement celui qui sépare Flash des modèles du niveau juste inférieur, sans pour autant marquer une différence de catégorie. Les deux restent dans la tranche des modèles très capables, mais pas à la frontière.
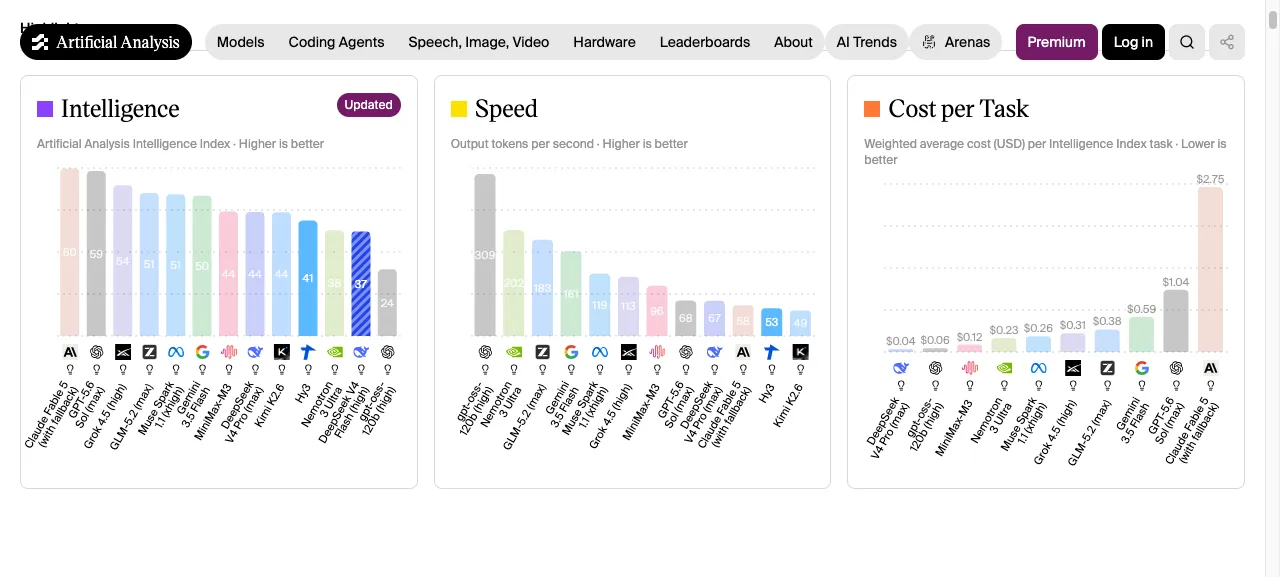
Deux réserves s'imposent avant d'accorder trop de poids à ce score.
D'abord, les benchmarks de code agentique dressent un portrait plus sévère des deux modèles. Un commentateur du fil de lancement sur Hacker News a retrouvé le résultat DeepSWE de Hy3 : 28 %, contre 52 % pour GPT-5.4 à effort maximal. Aucun de ces deux modèles chinois n'approche les meilleurs modèles pour le code agentique ; ils se confrontent surtout l'un à l'autre, pas au sommet du classement.
Ensuite, les tableaux de benchmarks publiés par les éditeurs doivent être lus avec le scepticisme habituel. Les chiffres de lancement de Hy3 ont immédiatement suscité des accusations de « benchmaxxing » dans le fil HN, tandis que les tableaux de DeepSeek ne couvrent que les évaluations que l'entreprise a choisi d'exécuter. Les données tierces ci-dessus constituent le meilleur point d'ancrage : Hy3 est un peu plus intelligent, mais l'écart reste assez réduit pour que le prix et le contexte renversent la décision.
Tarifs : le prix affiché ne raconte pas tout
Il faut distinguer deux grilles tarifaires, vérifiées le 14 juillet 2026. DeepSeek publie des prix exacts par token pour son API propriétaire. Tencent ne propose pas de grille anglaise équivalente pour Hy3 final — son communiqué situe le prix d'entrée de Hy3 preview autour de $0.18 par million de tokens sur TokenHub — ; la colonne Hy3 ci-dessous utilise donc les tarifs affichés par OpenRouter. Il s'agit d'un prix de marketplace, non d'un tarif de première partie.
| Par 1M tokens | Hy3 (marketplace OpenRouter) | DeepSeek V4 Flash (API de première partie) |
|---|---|---|
| Entrée | $0.14 | $0.14 (cache miss) |
| Entrée mise en cache | $0.035 | $0.0028 (cache hit) |
| Sortie | $0.58 | $0.28 |
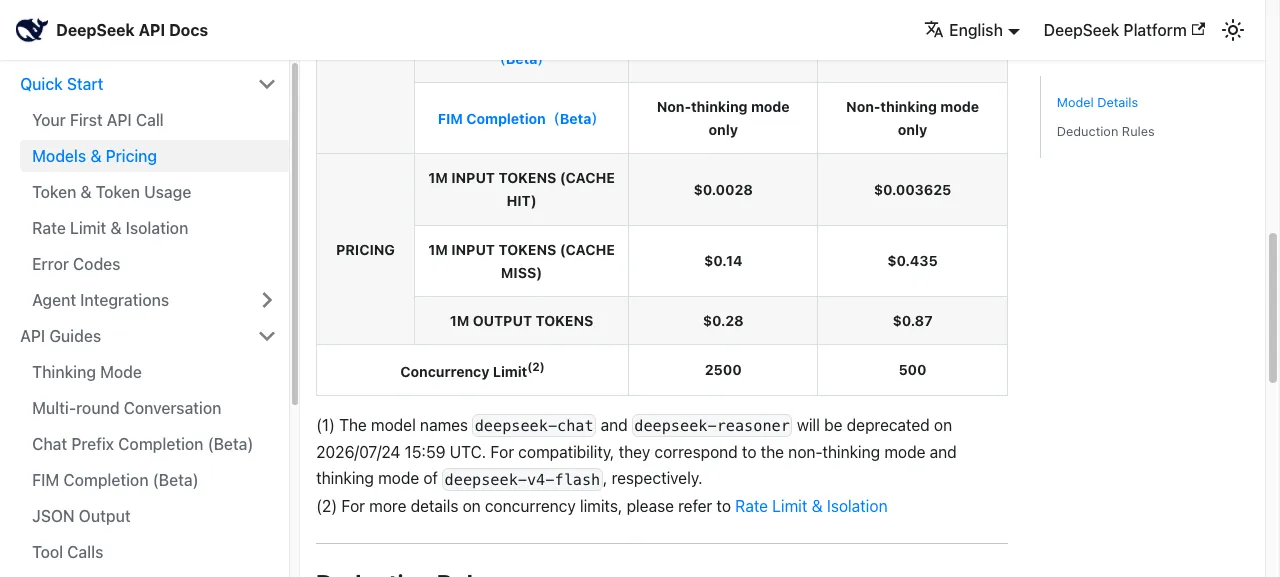
Le prix des tokens d'entrée est identique. Tout se joue dans les deux autres lignes.
Le facteur multiplicateur du cache
Chez DeepSeek, un cache hit coûte 50x moins cher qu'un cache miss, et 12.5x moins cher que le tarif de cache de Hy3 sur OpenRouter. Les deux tarifs de cache ne sont pas parfaitement comparables : DeepSeek affiche un prix d'API de première partie, tandis que Hy3 dépend des tarifs de lecture de cache appliqués par les fournisseurs sous-jacents d'OpenRouter. Ce sont néanmoins les tarifs réellement payés aujourd'hui. Pour les agents, aucun chiffre de cette page n'a davantage d'importance. À chaque tour, une boucle agentique renvoie le même contexte qui ne cesse de grossir : prompt système, définitions d'outils, contenu des fichiers et historique de conversation. Sur une session de 40 tours, la grande majorité des tokens d'entrée sont donc répétés. Avec 90 % de cache hits, le coût effectif d'entrée de Flash tombe de $0.14 à environ $0.017 par million de tokens. Celui de Hy3 descend à environ $0.045 : cela reste peu cher, mais presque 3x plus, et l'écart se creuse à mesure que les sessions s'allongent.
Les tokens de sortie pénalisent Hy3
Les deux modèles facturent leurs tokens de réflexion comme des tokens de sortie. À $0.58, le tarif de sortie de Hy3 est plus de deux fois supérieur aux $0.28 de Flash : chaque longue chaîne de raisonnement revient donc environ deux fois plus cher avec Hy3. Flash dispose aussi d'une option absente chez Hy3 : basculer en mode non-thinking pour les tâches mécaniques — mise en forme, extraction ou petites modifications — et éviter de payer pour un raisonnement inutile. Le comparatif deepseek-v4-flash-vs-deepseek-v4-pro explique concrètement ce changement de mode.
Une offre gratuite
Hy3 possède un vrai avantage : OpenRouter référence une variante tencent/hy3:free sans frais. Elle est limitée en débit, mais bien réelle. Pour tester le modèle avant de s'engager, c'est mieux que Flash, qui ne propose aucun palier d'API gratuit. Hy3 preview est aussi toujours listé à $0.063/$0.21, sous le prix de la version finale, si le checkpoint d'avril vous convient.
Le coût caché de la fenêtre de contexte
Les 256K de contexte de Hy3 semblent généreux, jusqu'à ce qu'un agent travaille sur une vraie base de code. Un utilisateur de r/hermesagent sur Reddit, qui exécute les deux modèles dans le même harness, les décrit comme « presque identiques, à part la taille du contexte, donc des compactages fréquents » pour Hy3. Or le compactage ne se résume pas à une gêne : chaque cycle consomme des tokens de sortie pour résumer, élimine des détails et invalide le cache du prompt, imposant de payer à nouveau le tarif cache miss pour le reconstruire.
L'écart devient structurel en auto-hébergement. L'attention creuse de l'architecture V4 — DeepSeek appelle ce mécanisme un lightning indexer — allège considérablement son cache KV par rapport à l'attention classique de Hy3. Il s'agit de retours isolés et non de benchmarks, mais les chiffres du fil HN sont éloquents : un commentateur faisant tourner les deux modèles sur une paire de DGX Sparks indiquait pouvoir loger 3M tokens de cache KV avec DeepSeek V4 Flash, contre environ 130K tokens pour Hy3 quantifié en FP4. Un autre estimait que, lorsque llama.cpp prendra totalement en charge l'indexer, le contexte complet de 1M de Flash ne devrait nécessiter qu'environ 6GB de RAM. Flash a aussi montré qu'il résiste bien aux quantifications agressives : plusieurs utilisateurs du même fil rapportent qu'il reste cohérent même en 2-bit, un résultat qui n'a pas encore été démontré pour Hy3.
Si votre usage reste largement sous les 200K tokens, toute cette section ne vous coûte rien et les quatre points d'intelligence supplémentaires de Hy3 sont gratuits. Dans le cas contraire, la taxe de contexte s'accumule : davantage de compactage, davantage d'invalidation de cache et davantage de mémoire par session.
Les retours des développeurs depuis le lancement
Le signal le plus utile ne se trouve pas dans les tableaux de benchmarks, mais dans la différence de comportement que les développeurs observent en faisant tourner les deux modèles dans des agents de code.
Dans ce même fil Hacker News, un utilisateur passé à DeepSeek V4 Flash et Pro comme outils quotidiens après avoir résilié son abonnement Anthropic, puis ayant testé Hy3, décrit Flash ainsi : très rapide, mais il « construit souvent un modèle mental complètement erroné et part dans la mauvaise direction », ce qui impose des corrections régulières et des compactages d'historique. Hy3, selon lui, « n'est pas aussi rapide, mais semble jusqu'ici rester beaucoup plus fiablement dans le bon axe » et se dégrade moins à mesure que le contexte grandit. D'autres participants du fil saluent aussi les connaissances générales et la qualité rédactionnelle de Hy3, supérieures à celles de Flash à cette taille de modèle.
Sur Reddit, les avis penchent davantage vers Flash pour le code brut. Une comparaison sur une même tâche dans r/LLMDevs classe « DeepSeek V4 Flash > Hy3 > GLM », tout en qualifiant Hy3 de « prometteur pour des workflows de code pratiques ». Dans r/opencode, le sentiment récurrent est que Flash est « largement suffisant » pour le travail agentique au quotidien.
Il faut aussi tenir compte de la fiabilité opérationnelle. La demande au lancement de Hy3 a dépassé la capacité de service de Tencent : des utilisateurs du fil HN ont signalé un rate limiting important, et une personne suivant les classements publics d'usage d'OpenRouter a noté que le modèle était passé du haut du classement aux 8e–9e places en un mois, attribuant directement cette baisse à ces limites. DeepSeek, à l'inverse, documente un plafond de 2,500 requêtes concurrentes pour Flash sur son API officielle, soit cinq fois la limite appliquée à V4 Pro. Pour le trafic de production, l'un des fournisseurs publie des garanties de capacité ; l'autre traîne un historique de congestion.
Quel modèle choisir selon le cas d'usage ?
- Agent de code, sessions sous ~150K tokens : Hy3. Son raisonnement est meilleur, il reste plus facilement sur la bonne trajectoire et son coût d'entrée affiché rejoint celui de Flash. Le seuil de 150K, plutôt que les 256K complets, laisse une marge avant que le contexte agentique ne déclenche les compactages.
- Sessions longues, grands dépôts, RAG sur de gros documents : Flash est généralement mieux adapté. Sa fenêtre de 1M, combinée à la remise de 50x sur le cache, le place dans une autre classe de coût ; la surcharge de compactage de Hy3 finit par effacer son avantage d'intelligence.
- API de production à fort volume : Flash. Il offre 2,500 requêtes concurrentes documentées, un historique de service plus stable et le mode non-thinking pour les appels massifs à bas coût.
- Rédaction, recherche et tâches de connaissances générales : Hy3. Les retours de la communauté comme les évaluations de connaissances d'AA le favorisent à cette taille.
- Déploiement local : Flash pour la plupart des configurations matérielles. Son cache KV efficient et sa robustesse à la quantification sont bien mieux étayés sur le terrain ; les recommandations de service de Tencent pour Hy3, citées dans le fil de lancement, évoquent huit GPU de classe H20.
- Évaluer avant de s'engager : le palier gratuit de Hy3 sur OpenRouter ne coûte rien à essayer. Faites-y passer vos propres tâches avant de croire n'importe quel tableau de benchmarks, y compris celui-ci.
Où les utiliser ?
DeepSeek V4 Flash : l'API officielle propose des endpoints au format OpenAI (api.deepseek.com) et Anthropic (api.deepseek.com/anthropic). Il s'intègre donc aux outils compatibles Claude en changeant simplement l'URL de base. Attention à la date de migration indiquée sur cette page tarifaire : les anciens noms de modèles deepseek-chat et deepseek-reasoner sont dépréciés le 24 juillet 2026 ; ils correspondent respectivement aux modes non-thinking et thinking de Flash. OpenRouter le propose à $0.09/$0.18, légèrement sous le tarif officiel, mais sans bénéficier du prix de cache hit de l'API officielle.
Hy3 : Tencent Cloud TokenHub est la voie de première partie. OpenRouter distribue la version finale, le checkpoint preview moins cher et le palier gratuit. SiliconFlow a proposé des promotions de lancement. L'auto-hébergement est possible sous Apache 2.0 si vous disposez des GPU nécessaires. Le guide de configuration de l'API Hy3 détaille l'obtention d'une clé et le premier appel.
FAQ
Hy3 est-il gratuit ?
En partie. OpenRouter liste un palier tencent/hy3:free limité en débit et sans frais, tandis que les produits grand public de Tencent, Yuanbao et ima, utilisent Hy3 gratuitement. L'accès API de production via TokenHub ou le palier payant d'OpenRouter est facturé au token.
Hy3 est-il le même modèle que Tencent Hunyuan ?
Oui. Hy3 est la troisième génération de la gamme Hunyuan de Tencent, désormais commercialisée par Tencent sous la marque « Tencent Hy ». La préversion est sortie le 23 avril 2026, suivie de la version finale le 6 juillet 2026.
Lequel est meilleur pour coder : Hy3 ou DeepSeek V4 Flash ?
Les retours de la communauté divergent selon la forme de la tâche. Les comparaisons Reddit sur une même tâche classent la sortie brute de Flash devant celle de Hy3, tandis que les utilisateurs d'agents en sessions longues jugent Hy3 plus fiable pour rester sur la bonne trajectoire. Les tâches courtes et bien cadrées favorisent la vitesse de Flash ; pour les sessions agentiques de plusieurs heures où une dérive coûte cher, Hy3 est préférable, tant que le contexte reste confortablement dans sa fenêtre de 256K.
Puis-je exécuter DeepSeek V4 Flash en local ?
Oui, et plus facilement que Hy3. Les poids sont sous licence MIT, le cache KV de l'architecture est inhabituellement léger et des utilisateurs rapportent une qualité exploitable même avec une quantification en 2-bit sur des machines dotées d'environ 96GB de RAM.
Pourquoi la comparaison de prix hy3 vs deepseek v4 flash est-elle si confuse ?
Parce qu'il existe au moins quatre grilles tarifaires : Tencent TokenHub, les listings OpenRouter pour Hy3 final et preview, ainsi que l'API officielle de DeepSeek avec son tarif distinct pour les cache hits. Comparez le coût effectif pour votre propre profil de trafic : les entrées mises en cache dominent les charges agentiques, et c'est là que le tarif de $0.0028 de DeepSeek est difficile à battre.
Verdict
Au regard des éléments tiers disponibles, Hy3 est le modèle le plus performant ; DeepSeek V4 Flash est le meilleur service. Pour les charges API en production, Flash est mon choix par défaut : son économie de cache, sa fenêtre de contexte et sa concurrence documentée se combinent d'une manière qu'une avance de quatre points en benchmark ne compense pas. Préférez Hy3 lorsque la qualité de raisonnement par prompt compte davantage que le passage à l'échelle — et commencez par son palier gratuit, puisqu'il permet de le confronter à vos tâches sans frais.