 AIREITER
Lancé par Google le 13 août 2026, Gemini 3.7 Flash se présente comme son modèle Flash le plus performant à ce jour pour les agents de code et les enchaînements d’outils en plusieurs étapes. Son principal argument : 65,3 % sur DeepSWE v1.1, contre 49,0 % pour 3.6 Flash, avec un tarif de lancement de 0,75 $/M de tokens en entrée et 3,75 $/M en sortie. C’est exactement deux fois moins que les tarifs standard de 3.6 Flash. Revers de la médaille : selon plusieurs sources, ces prix passeront à 1,50 $/7,50 $ en janvier 2027. Il reste donc environ quatre mois pour l’évaluer au tarif réduit.
Tarifs API : 0,75 $/3,75 $ jusqu’à fin 2026, puis un doublement
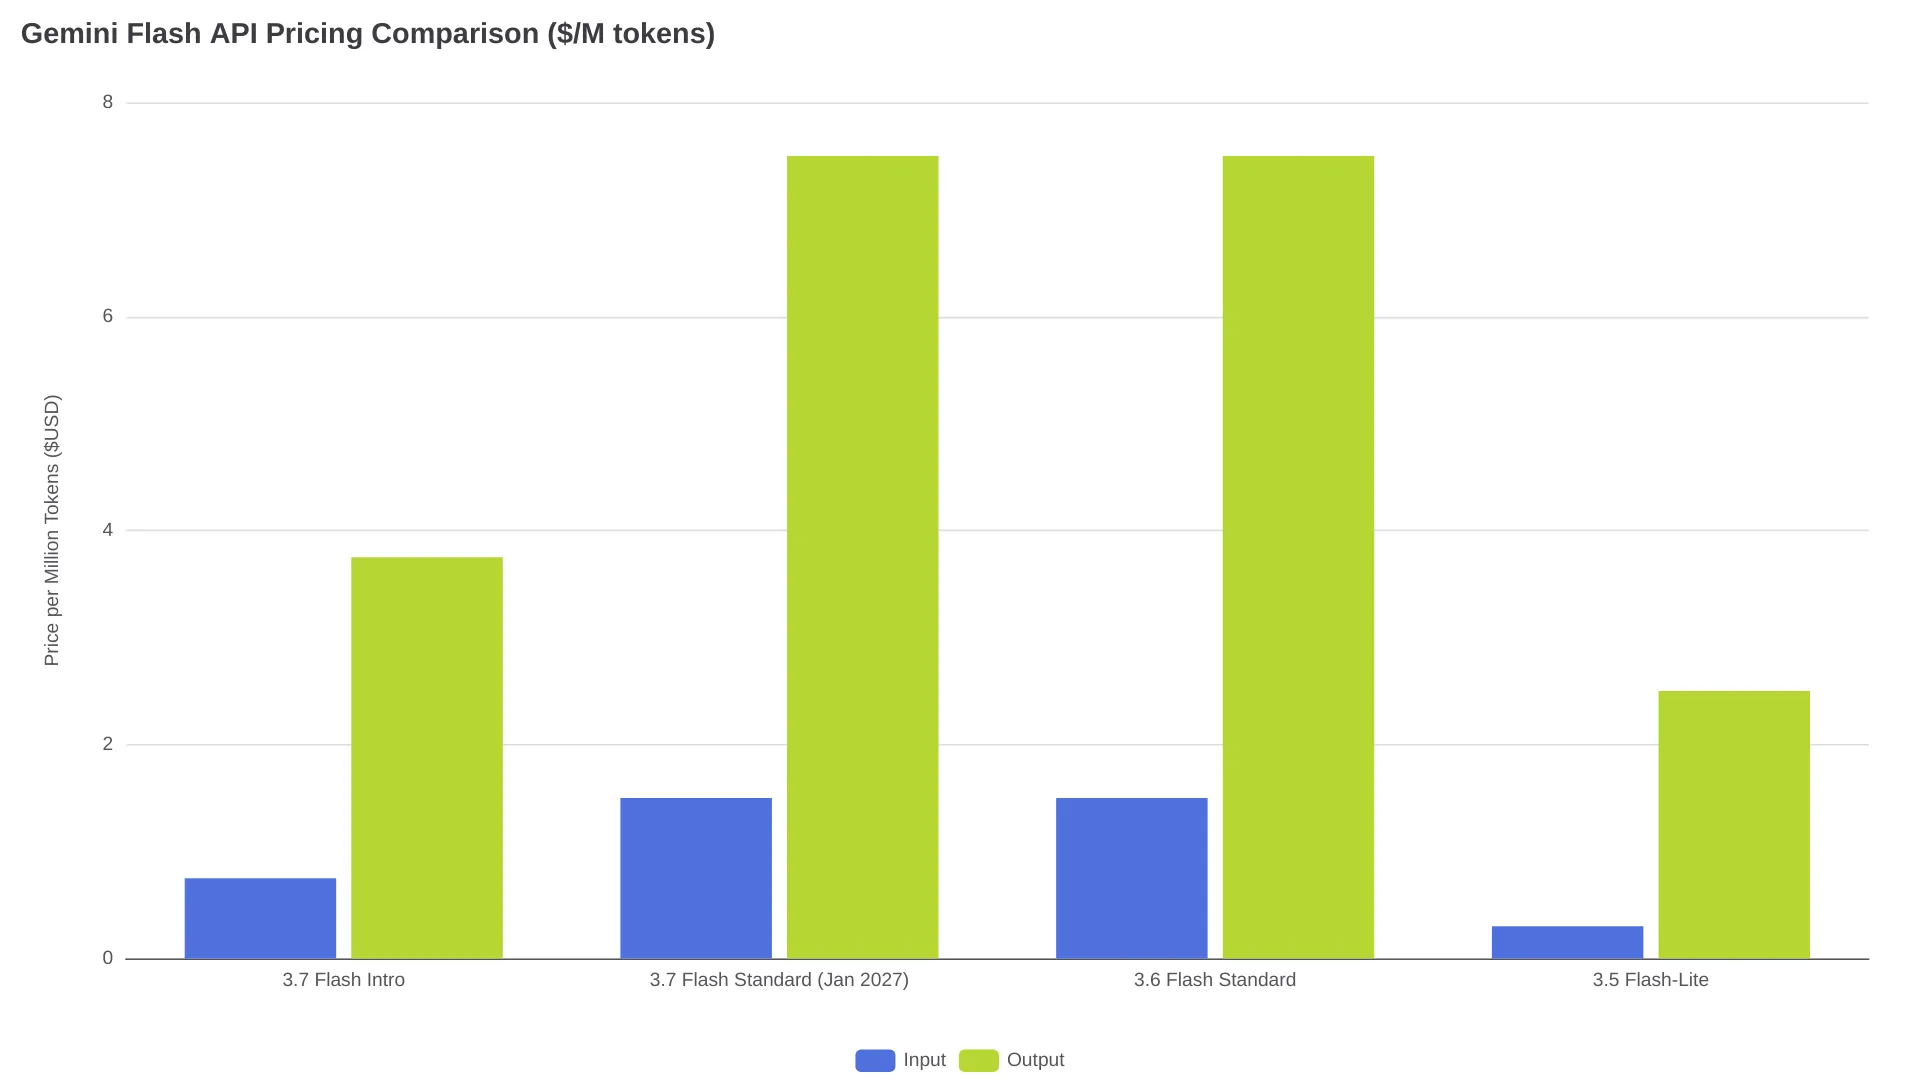
Gemini 3.7 Flash est facturé 0,75 $ par million de tokens en entrée et 3,75 $ par million de tokens en sortie, d’après l’annonce de lancement de Google DeepMind, corroborée par des retours de la communauté et des résultats de recherche indexés. À titre de comparaison, Gemini 3.6 Flash est proposé à 1,50 $/M en entrée et 7,50 $/M en sortie au tarif standard (AgentPedia). Le tarif promotionnel de 3.7 Flash correspond ainsi au palier Batch/Flex de 3.6 Flash, tout en s’appliquant au débit standard.
Les retours de la communauté attirent toutefois l’attention sur une précision importante : le tarif de lancement est valable jusqu’au 31 décembre 2026, puis les prix reviendraient à 1,50 $/M en entrée et 7,50 $/M en sortie. Un utilisateur de Reddit a relevé que « the displayed pricing fine print causes the price to double after four months » (r/GeminiAI).
| Palier tarifaire | Entrée ($/M tokens) | Sortie ($/M tokens) | Remarques |
|---|---|---|---|
| 3.7 Flash lancement (août–déc. 2026) | $0.75 | $3.75 | Rapporté par la communauté ; double en janv. 2027 |
| 3.7 Flash standard (à partir de janv. 2027) | $1.50 | $7.50 | Identique au tarif standard de 3.6 Flash |
| 3.6 Flash standard | $1.50 | $7.50 | Tarif GA actuel |
| 3.6 Flash Batch/Flex | $0.75 | $3.75 | Palier à débit réduit |
| 3.5 Flash-Lite standard | $0.30 | $2.50 | Palier Gemini Flash le moins cher |
Les tokens de réflexion sont inclus dans le prix des tokens de sortie. La mise en cache du contexte ajoute 0,15 $/M de tokens au palier standard, selon les tarifs publiés de 3.6 Flash relayés par AgentPedia. Le grounding avec Google Search et Google Maps fait l’objet d’une facturation distincte. Le modèle conserve la fenêtre de contexte de 1M de tokens et la sortie maximale de 64K de 3.6 Flash : aucune évolution des limites de contexte ne devrait donc casser les appels API existants.
Des gains nets sur les benchmarks de code
Les benchmarks communiqués par Google font surtout ressortir des progrès en ingénierie logicielle, programmation et traitement de documents. Les chiffres ci-dessous proviennent de l’annonce de lancement de Google, relayée par des publications communautaires le 13 août 2026.
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Écart |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 49.0% | +16.3 pts |
| FrontierCode 1.1 Main | 43.6% | 34.4% | +9.2 pts |
| WebDev Arena (Elo) | 1,588 | 1,538 | +50 Elo |
| GDP.pdf Document Processing | 34.0% | 22.0% | +12.0 pts |
| AutomationBench | 30.4% | ~17% | +13 pts |
| Long-Context Retrieval | 97% | — | — |
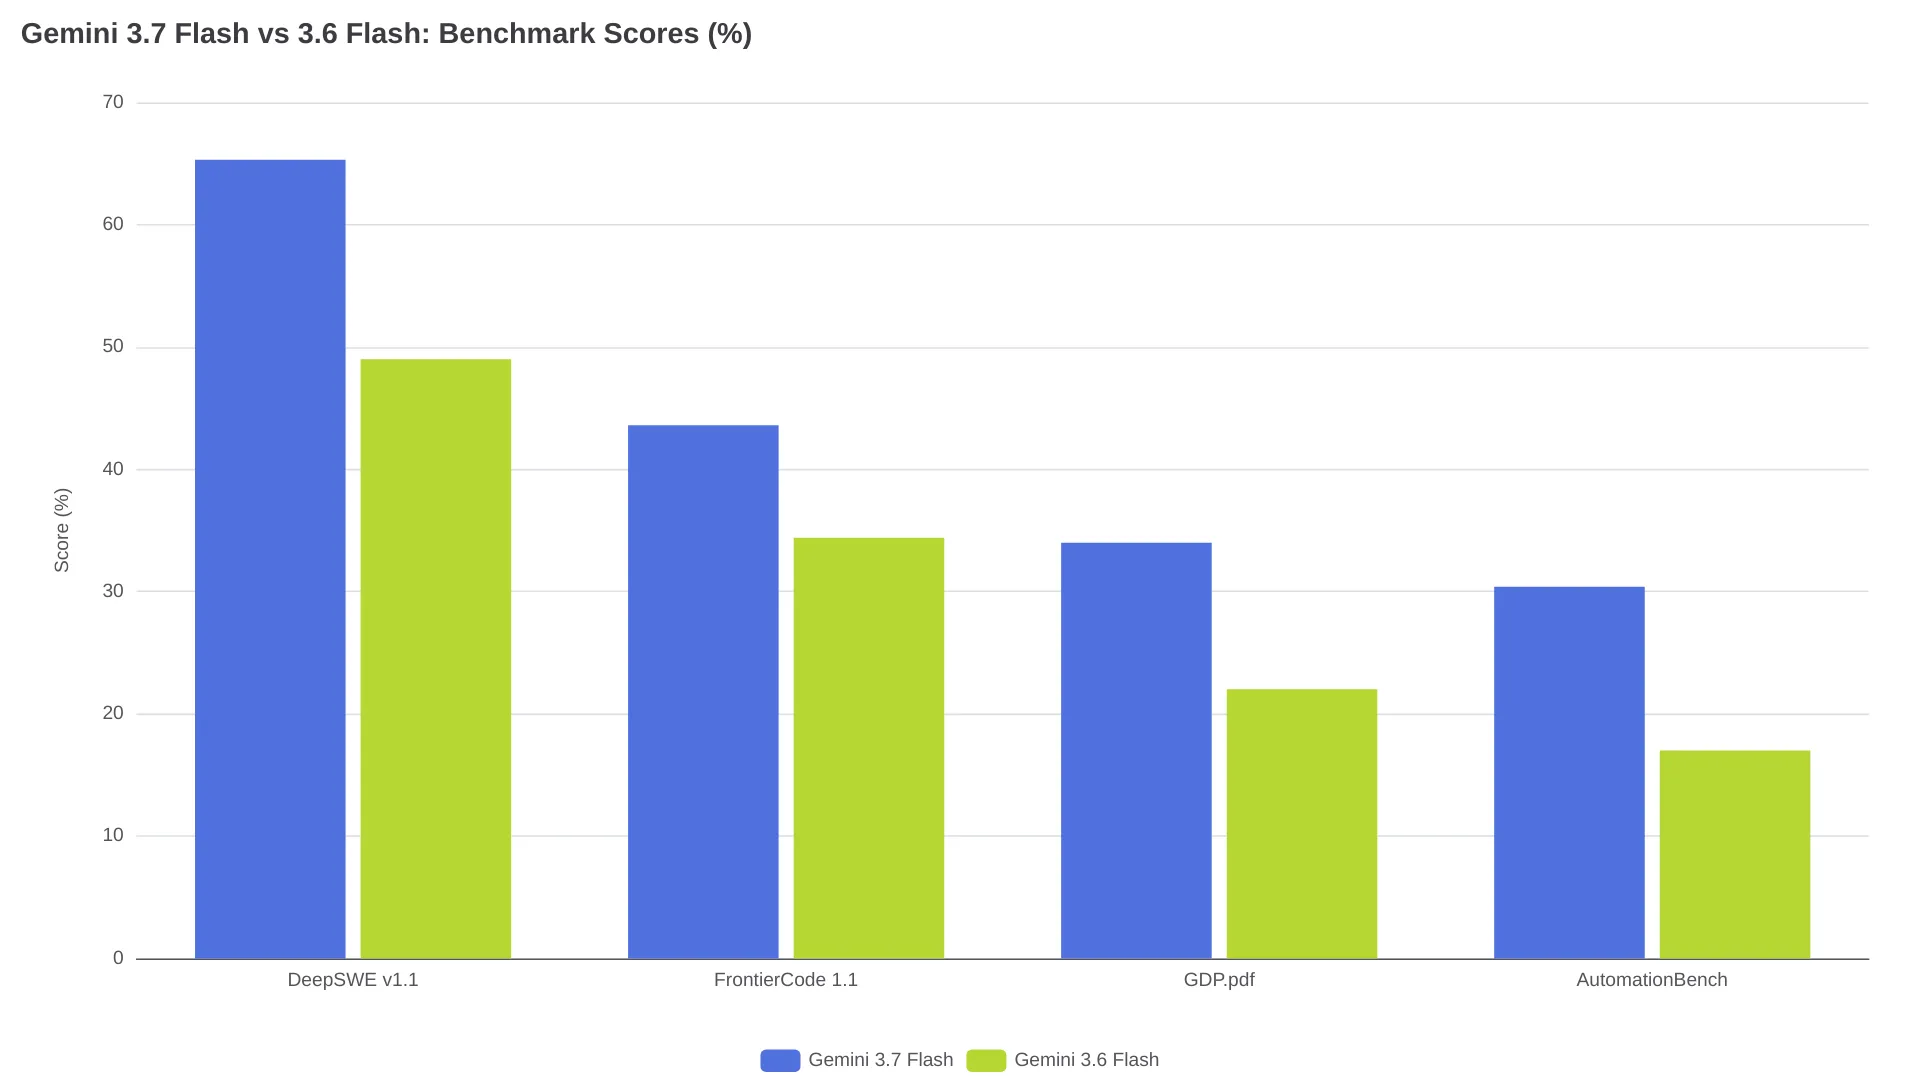
Le bond de 49 % à 65,3 % sur DeepSWE, soit +33 % en relatif, est le résultat le plus marquant. DeepSWE évalue l’ingénierie logicielle à l’échelle d’un dépôt : modifications multi-fichiers, exécution de tests et navigation dans une base de code. La communauté Reddit reste néanmoins partagée sur la capacité de ces résultats à se confirmer en production. Un utilisateur résume ainsi : « Assume benchmaxxed until proven otherwise » (r/GeminiAI). D’autres soulignent que 3.6 Flash utilisait le niveau de réflexion high dans la comparaison, tandis que certains modèles concurrents étaient réglés sur medium, ce qui gonfle les scores. Le résultat de 97 % en récupération sur long contexte a, lui, suscité un intérêt réel pour les workflows de code nécessitant de retrouver des éléments pertinents dans une grande base de code.
Face aux modèles de code concurrents : performances contre coût
Les premiers utilisateurs sur Reddit ont rapidement comparé le rapport performances/prix de 3.7 Flash avec des alternatives moins coûteuses. Le constat est nuancé : 3.7 Flash obtient de bons résultats, mais son coût par tâche est nettement supérieur à celui des modèles de code économiques.
Dans le fil consacré aux benchmarks, un commentateur estime que Gemini 3.7 Flash coûte environ 8x plus que GPT-5.6 Luna selon l’indicateur coût par tâche d’Artificial Analysis, alors que Luna affiche des scores de benchmark presque identiques. Un autre utilisateur indique que Gemini 3.7 Flash était auparavant environ 13x plus cher que DeepSeek V4 Flash, même si le prix de DeepSeek a depuis augmenté. Le même commentateur le formule sans détour : Gemini 3.7 Flash coûte « more than 300% extra » par rapport à Luna pour des résultats « nearly the same » (r/GeminiAI).
L’argument inverse est que Luna hallucinerait davantage, tandis que le raisonnement de DeepSeek V4 Flash « makes many mistakes » — des observations qui restent toutefois anecdotiques.
Là où 3.7 Flash est régulièrement salué, c’est sur la vitesse. Des utilisateurs rapportent que la plupart des réponses arrivent en 3 à 6 secondes, la réponse la plus longue observée — lors d’un test d’écriture créative — ayant pris environ une minute. Plusieurs commentateurs le qualifient de « blazingly fast ».
Spécifications, disponibilité et accès API
D’après les caractéristiques évoquées dans les discussions communautaires et la documentation de 3.6 Flash, Gemini 3.7 Flash reprend les mêmes limites de contexte et le même ensemble de fonctions que 3.6 Flash.
| Spécification | Valeur |
|---|---|
| Fenêtre de contexte | 1,048,576 tokens (1M) |
| Sortie maximale | 65,536 tokens (64K) |
| Niveaux de réflexion | Low, Medium, High |
| Modalités | Texte, images, vidéo, audio, PDF (entrée) ; texte (sortie) |
| Date limite des connaissances | Mars 2026 (3.6 Flash ; limite de 3.7 Flash non confirmée) |
| Prix des entrées mises en cache | $0.15/M tokens (standard, déduit de 3.6 Flash) |
Où y accéder :
- Gemini API / Google AI Studio — accès développeur
- Gemini app — déploiement auprès du grand public
- Gemini Spark — disponible pour les abonnés Google AI Pro et Google AI Ultra
- Vertex AI — devrait suivre le schéma de disponibilité de 3.6 Flash
L’identifiant de modèle API attendu est gemini-3.7-flash, conformément à la convention de nommage utilisée par Google pour 3.6 Flash. Avant tout déploiement, vérifiez la chaîne exacte dans la documentation Google AI for Developers et épinglez-la, plutôt que de vous reposer sur les alias gemini-flash-latest.
Faut-il migrer depuis 3.6 Flash ?
La réponse dépend de votre type de charge de travail et de l’impact que représente pour vous la hausse tarifaire de janvier 2027.
Migrez si votre application fait tourner des agents de code, des chaînes d’utilisation d’outils en plusieurs étapes ou des traitements intensifs de documents. Le passage de 49 % à 65,3 % sur DeepSWE est assez important pour modifier le nombre de boucles d’agent qui aboutissent dès le premier essai, et le tarif de lancement divisé par deux permet de l’évaluer à moindre coût. Les équipes déjà sur 3.6 Flash peuvent remplacer l’identifiant de modèle derrière un feature flag, sans revoir leurs hypothèses liées à la fenêtre de contexte.
Attendez si votre charge consiste surtout en classification, routage ou extraction à fort volume, et que Flash-Lite remplit déjà le besoin à 0,30 $/2,50 $. Le tarif de lancement de 3.7 Flash reste 2,5x supérieur au tarif d’entrée de Flash-Lite, et le doublement de janvier creuse encore cet écart.
Anticipez le changement de prix. Établissez vos budgets sur la base de 1,50 $/7,50 $ à partir de janvier 2027, et non du tarif promotionnel actuel. Si votre modèle économique ne fonctionne qu’à 0,75 $/3,75 $, le modèle deviendra 2x plus coûteux dans quatre mois.
FAQ
Le tarif de 0,75 $/3,75 $ de Gemini 3.7 Flash est-il permanent ?
Non. Les retours de la communauté indiquent qu’il s’agit d’un tarif de lancement, valable jusqu’au 31 décembre 2026. À partir de janvier 2027, les prix devraient doubler pour atteindre 1,50 $/M en entrée et 7,50 $/M en sortie, soit les tarifs standard de 3.6 Flash.
Gemini 3.7 Flash est-il disponible sur Vertex AI ?
La disponibilité sur Vertex AI n’a pas été confirmée indépendamment au lancement. Gemini 3.6 Flash était disponible via Vertex AI lors de sa disponibilité générale ; 3.7 Flash devrait donc suivre la même trajectoire. Consultez la console Google Cloud pour connaître la liste actuelle des modèles.
Comment 3.7 Flash se compare-t-il à Gemini 3.1 Pro ?
Des utilisateurs de Reddit rapportent que 3.7 Flash est compétitif avec les modèles de la gamme Pro, voire meilleur, sur certains benchmarks d’agents et de programmation, notamment en analyse documentaire agentique. Pour les boucles d’agents de code pures au tarif de lancement, 3.7 Flash offre un meilleur rapport coût-performances ; pour le raisonnement et la planification complexes, Pro reste le choix le plus solide.
Les tokens de réflexion sont-ils facturés séparément ?
Non. Les tokens de réflexion sont facturés comme des tokens de sortie, au tarif standard de sortie (3,75 $/M pendant la période de lancement). L’utilisation du niveau high augmente donc les coûts de sortie proportionnellement ; privilégiez medium ou low pour les charges à fort volume lorsque ce surcroît de raisonnement n’est pas nécessaire.