 AIREITER
Le 20 août 2026, Anthropic a sorti trois briques du mode bêta : la Claude Skills API, computer use et la Files API. Les en-têtes bêta ne sont plus requis, computer use peut désormais enchaîner plusieurs actions par tour, et un nouvel outil browser use fait son apparition. Cela ne résout toutefois pas le point central des skills : Claude les déclenche uniquement s’il décide qu’elles sont pertinentes. Le pinning des versions et la conception des mécanismes d’activation restent donc à votre charge.
Ce qui a réellement changé le 20 août
Vos intégrations bêta existantes continuent de fonctionner pendant la migration. Mais le billet d’annonce d’Anthropic apporte aussi plusieurs évolutions concrètes :
- Fin des en-têtes bêta. Le guide des skills actuel ne liste plus que deux prérequis : une clé Claude API et l’activation de l’exécution de code dans la requête. Les en-têtes bêta indispensables dans les tutoriels avant la GA ont disparu de la documentation.
- Plusieurs actions par tour. L’outil computer use peut désormais exécuter plusieurs actions lors d’un même appel au modèle — clic, saisie, touche clavier et capture d’écran — au lieu d’une seule. Le compte @ClaudeDevs d’Anthropic indique que les clients en accès anticipé ont constaté 20 à 40 % d’allers-retours en moins par tâche.
- Un outil browser use. Il associe les captures d’écran à la structure de la page afin que l’agent vise un champ ou un bouton précis plutôt que des coordonnées de pixels. Il cible notamment les portails web tels que ceux de dépôt de dossiers d’assurance.
- Une Files API plus dimensionnée. Chaque organisation dispose de 1 To de stockage, de limites de débit multipliées par 5 — 500 RPM selon le fil @ClaudeDevs — et d’une expiration automatique des fichiers.
- Une voie vers la conformité. Computer use est désormais éligible aux charges de travail réglementées par HIPAA dans le cadre du BAA d’Anthropic.
- Disponibilité cloud. La Skills API et la Files API sont également proposées via Microsoft Foundry. Les versions actualisées des outils computer use et browser use sont annoncées comme « coming soon » sur Vertex AI, sans date précisée.
Files API, Skills API et computer use : la boucle complète
L’exemple d’agent de gestion de sinistres d’Anthropic illustre le flux de bout en bout : récupérer un document d’ouverture via son identifiant de fichier avec la Files API, appliquer un skill contenant la procédure de déclaration avec la Skills API, remplir le portail de l’assureur via browser use et computer use, puis enregistrer la confirmation dans un fichier. Les documents sont importés une fois, puis référencés par file_id au lieu d’être renvoyés à chaque requête.
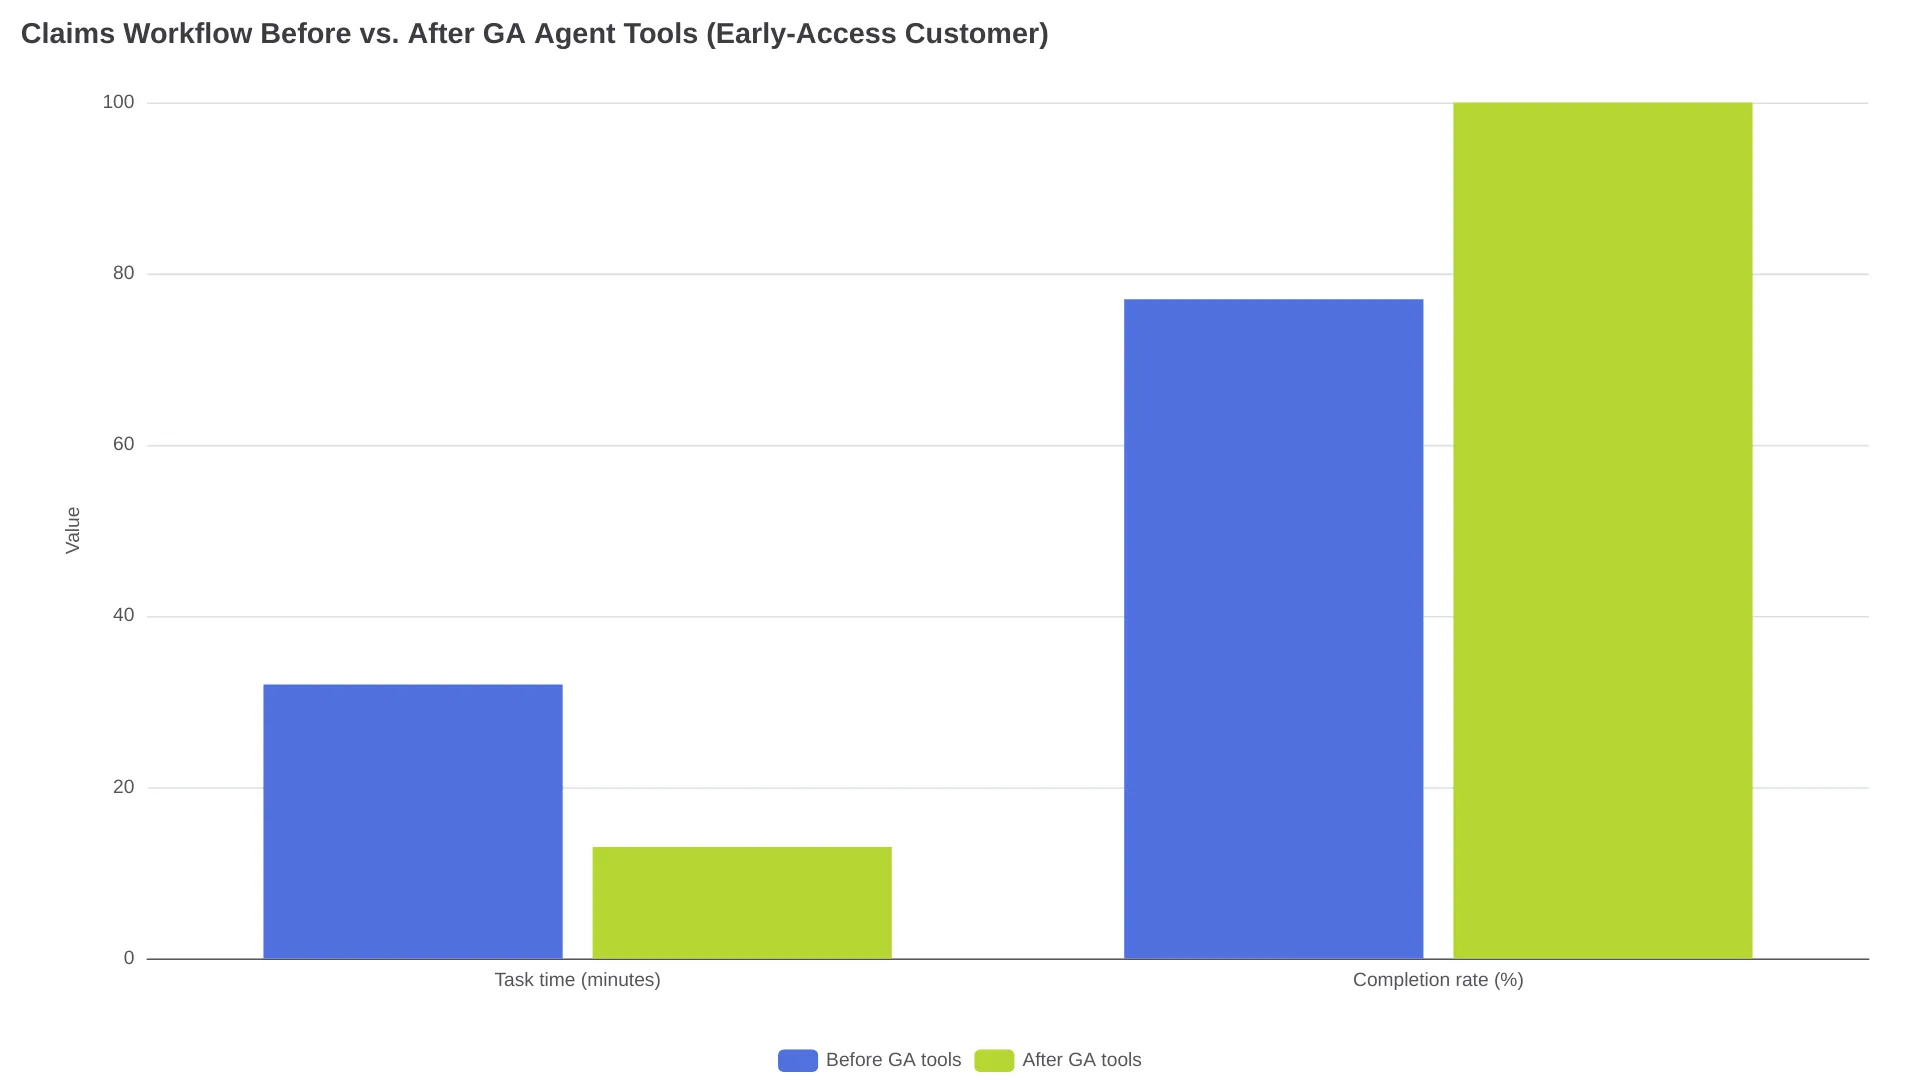
Les deux séries de chiffres publiées au lancement proviennent de l’écosystème du fournisseur. Dans son billet d’annonce, l’ingénieur de recherche Davide Locatelli a indiqué que le plus long workflow de sinistres était passé de 32 minutes à 13 minutes, avec un taux de réalisation de 100 %. De son côté, David Mlčoch, cofondateur d’Asteroid, a testé des workflows de computer use dans la santé pendant l’accès anticipé :
« 32 à 52 % d’appels au modèle en moins, 25 à 32 % de coût en moins par tâche, 100 % de réalisation sur chaque workflow, contre 77 % auparavant » — @MlcochDavid
Ajouter une skill à un appel Messages API
Une skill s’attache avec un seul paramètre : un objet container dans la requête Messages API, qui contient un tableau skills. Chaque entrée comprend un type — anthropic ou custom —, un skill_id et, facultativement, une version.
Voici les règles autour de ce paramètre, telles qu’elles figurent dans le guide officiel des skills :
- L’exécution de code doit être activée et prise en charge par le modèle. Les exemples du guide utilisent
claude-opus-5avec l’outilcode_execution_20250825etmax_tokens=4096. - Une même requête peut inclure jusqu’à 20 skills.
- Les skills s’exécutent dans le bac à sable d’exécution de code d’Anthropic : pas d’accès réseau, pas d’installation de packages à l’exécution, et un nouveau conteneur à chaque requête sauf si vous réutilisez un
container.idretourné entre plusieurs tours. Chaque réponse inclutexpires_at. - Vous n’hébergez jamais les fichiers des skills vous-même : Anthropic les exécute dans le conteneur.
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=4096,
    tools=[{"type": "code_execution_20250825"}],
    container={
        "skills": [
            {"type": "anthropic", "skill_id": "xlsx", "version": "20251013"},
            {"type": "custom", "skill_id": "skill_01...", "version": "skver_01..."},
        ]
    },
    messages=[{"role": "user", "content": "Build the Q3 revenue summary"}],
)
Les documents en entrée suivent le chemin inverse : importez-les d’abord via la Files API, puis référencez-les dans un bloc d’import du conteneur. La requête conserve le format standard de l’Anthropic Messages API ; elle fonctionne donc avec une clé directe comme avec un relais compatible Anthropic tel que l’API Claude d’AIReiter.
Les skills intégrées reposent sur des identifiants courts et lisibles — pptx, xlsx, docx, pdf — et sur des versions datées telles que 20251013 ou latest. Les skills personnalisées reçoivent des identifiants skill_01..., limités à votre workspace.
Déployer une Skill personnalisée sans se heurter aux limites
Une skill personnalisée est un répertoire dont le fichier SKILL.md à la racine contient un frontmatter YAML — name et description. Il peut être accompagné de scripts et de fichiers de référence. Voici le fichier minimal :
---
name: eu-claims-filing
description: Use when filing or amending EU insurance claims. Loads the
  carrier-specific submission procedure, required fields, and rejection
  codes before filling any portal form.
---

# EU claims filing procedure
1. Pull the intake document by file_id ...
L’import peut se faire sous la forme d’une archive ZIP ou de fichiers individuels — le SDK Python propose files_from_dir. Avant toute exécution, Anthropic applique les limites strictes répertoriées dans le guide des skills :
| Règle | Limite |
|---|---|
name | ≤64 caractères ; lettres minuscules, chiffres et tirets ; anthropic et claude sont réservés |
description | 1 à 1 024 caractères, non vide, sans balises XML |
display_name (facultatif) | ≤255 caractères |
| Taille du bundle | Moins de 30 Mo non compressés |
| Skills par requête | 20 |
| Workspaces par organisation | 100 par défaut |
La gestion s’effectue avec la CLI ant ou ses endpoints API sous-jacents, selon le même guide. Voici le parcours, du répertoire à une version épinglée :
ant skills create ./eu-claims-filing   # returns skill_01...
ant skills:versions create skill_01...  # returns skver_01... — pin this in production
Deux comportements surprennent souvent les équipes au départ : chaque nouvelle version est un instantané complet — vous devez renvoyer l’ensemble des fichiers, ceux qui sont omis ne sont pas conservés — et supprimer une skill supprime toutes ses versions.
Checklist de production : épingler, isoler, mettre en cache
En production, les difficultés viennent surtout des versions mutables, des permissions accordées à l’échelle du workspace et des échecs de cache. Le guide des skills est explicite sur ces trois points.
- Épinglez les versions. Avec
latest, ou sans version précisée, toute personne ayant accès au workspace peut modifier instantanément le comportement de votre agent déployé en important une nouvelle version. En production, épinglez les identifiantsskver_...; réservezlatestau développement actif. - Considérez le workspace comme la frontière de tenant. Toute clé API d’un workspace peut lire, invoquer et supprimer toutes ses skills personnalisées. L’isolation s’opère donc au niveau du workspace, et non de l’utilisateur ou de la session. Une application multi-tenant doit prévoir un workspace par tenant, sans oublier la limite par défaut de 100 workspaces.
- Gardez une liste de skills stable pour le cache. Modifier la liste des skills, y compris leur ordre, change le préfixe du prompt système et invalide le cache de prompt. Épingler les versions personnalisées protège également ce préfixe : sinon, une nouvelle importation de
latestdont la description a changé le réécrirait. Avec une facturation au token, une liste de skills fluctuante entre les requêtes fait discrètement disparaître les économies liées aux hits de cache. - Gérez
pause_turn. Les skills longues renvoientstop_reason: "pause_turn". Pour poursuivre, renvoyez le contenu retourné dans une requête ultérieure ; vous pouvez aussi modifier la conversation pour interrompre l’exécution. - Connaissez votre politique de rétention. Les Agent Skills ne sont pas couvertes par les dispositifs de zero data retention. Les définitions de skills et les données d’exécution suivent la politique de rétention standard d’Anthropic. Si la Compliance API est activée, l’Activity Feed journalise les créations et suppressions de skills et de versions, uniquement à compter de son activation.
- Interceptez les bonnes erreurs. Encadrez les appels afin de capturer
anthropic.BadRequestErroret distinguez les erreurs liées aux skills des autres erreurs de requête invalide. - N’attachez pas de skills inutilisées. La documentation le dit explicitement : inclure des skills qui ne servent pas nuit aux performances.
Le problème d’activation qu’aucune évolution API ne règle
La GA a renforcé l’infrastructure des skills, pas la manière dont Claude les sélectionne. Une inquiétude revient régulièrement dans les discussions ci-dessous : les skills se comportent comme des procédures déclenchées, et non comme un second prompt système.
« My problem with Claude Skills is that they are not skills. Nothing forces Claude to actually use them. Claude does whatever it wants... These are just md files. » — @Yampeleg, propos publiés avant la GA ; le mécanisme d’invocation n’a pas changé
Le fil r/ClaudeAI sur le fonctionnement réel des skills résume bien les correctifs pratiques :
« userstyle gets prepended every turn but skills only fire when claude decides to invoke based on the description. » — u/samxu01
« Skills must have a simple, clear metadata description that also focuses on an action that Claude is doing. » — u/Chadum
Ces échanges conduisent à quatre règles :
- Rédigez la description autour des formulations de déclenchement et de l’action à accomplir, pas autour d’une persona.
- Placez dans le corps les étapes, vérifications, règles et choix d’outils. Le test proposé par u/MartinMystikJonas : « If your skills define steps agent should do, things it should check, rules it should follow and tools it should use then it is useful. »
- Encodez ce que Claude exécute mal nativement, comme le recommande u/Actual_Committee4670.
- Placez les exigences permanentes dans votre prompt système ou dans CLAUDE.md — préfixés à chaque tour selon u/samxu01 — et réservez les hooks aux étapes du cycle de vie, par exemple avant un commit.
Réponses rapides
Faut-il encore des en-têtes bêta pour la Skills API ?
Non. Depuis la GA du 20 août 2026, les seuls prérequis sont une clé Claude API et l’exécution de code activée. Les en-têtes bêta ne figurent plus dans la documentation actuelle.
Les skills consomment-elles la fenêtre de contexte ?
Au départ, seules leurs métadonnées le font. D’après le guide des skills, Claude reçoit d’abord le frontmatter de chaque skill, copie les fichiers dans le conteneur, puis ne charge les instructions complètes que si la tâche l’exige. C’est la raison pour laquelle la documentation déconseille d’attacher des skills inutilisées.
Quelle différence entre une Skill et MCP ?
Une skill est un package d’instructions et de scripts exécuté dans le bac à sable de Claude, sans accès réseau. MCP connecte Claude à des systèmes externes actifs : c’est la distinction établie par Anthropic dans sa présentation des skills. Un workflow de sinistres peut employer les deux : un serveur MCP pour la base de données des contrats, une skill pour la procédure de déclaration.
Un même SKILL.md peut-il fonctionner dans Claude.ai, Claude Code et l’API ?
Le format SKILL.md est partagé, mais son déploiement diffère selon l’interface : skills importées dans le workspace pour l’API, répertoires .claude/skills dans Claude Code, et imports liés au forfait dans l’application Claude.ai.
La Skills API fonctionne-t-elle avec le zero data retention ?
Non. Les Agent Skills sont exclues des dispositifs de zero data retention ; les définitions de skills et les données d’exécution relèvent de la politique de rétention standard.
Quel mécanisme choisir selon le besoin
Le bon choix dépend du moment où le mécanisme doit être invoqué :
| Besoin | Mécanisme adapté |
|---|---|
| Une tâche spécialisée qui doit s’exécuter lorsqu’elle est déclenchée (« lors de la déclaration d’un sinistre, suivre ces étapes ») | Skill |
| Une règle qui doit s’appliquer à chaque tour, sans exception | Prompt système (API) / CLAUDE.md (Claude Code) |
| Une action à une étape du cycle de vie (après l’exécution d’un outil, avant un commit) | Hook |
| Une connexion active à un système externe | Serveur MCP |
| Un format de tâche ponctuel | Prompt simple |
Le 20 août a rendu le mécanisme de skills prêt pour la production ; cela n’a pas rendu les catégories de ce tableau interchangeables.
À lire également : tarification de l’API Claude par modèle et par token et enregistrer une skill Claude dans Claude Code.