 AIREITER
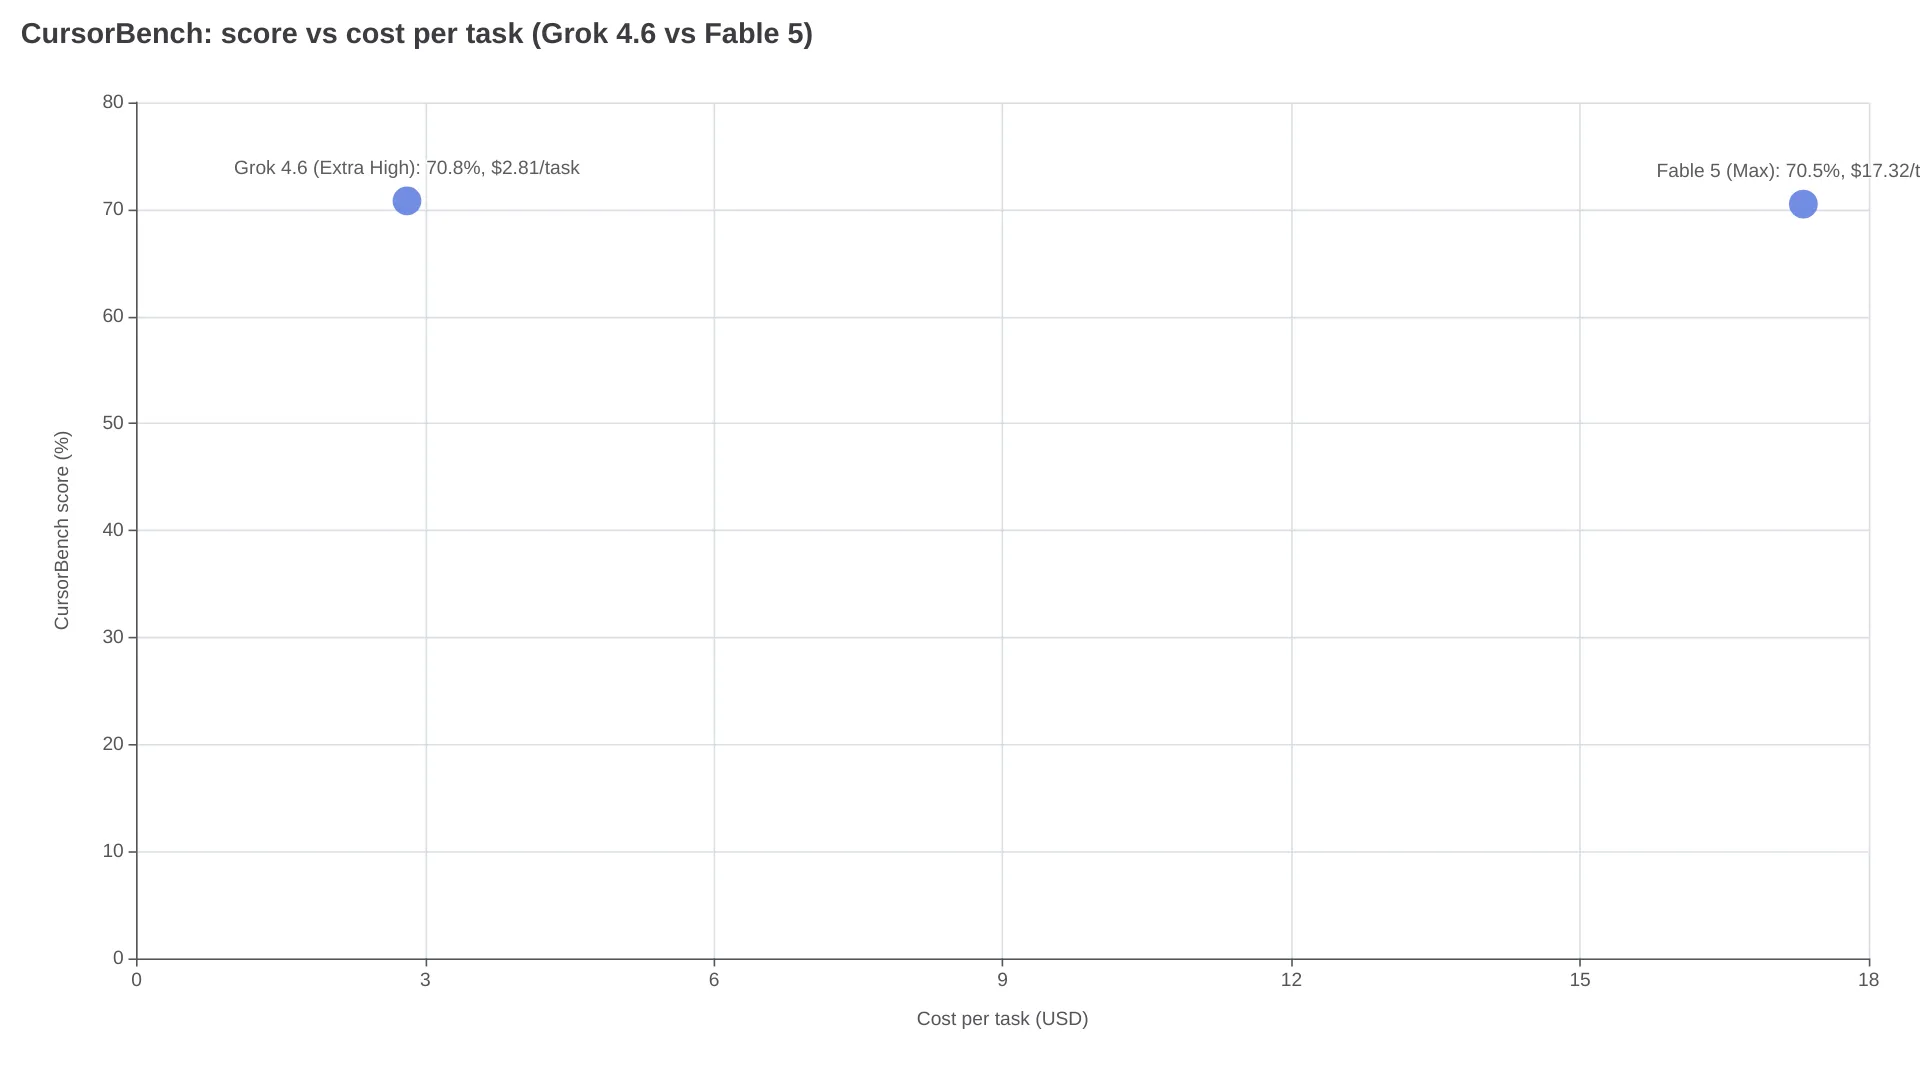
En CursorBench, Grok 4.6 Extra High alcanzó un 70,8% con un coste de $2.81 por tarea completada. Fable 5 Max obtuvo un 70,5% en el mismo arnés de agentes, pero cada tarea costó $17.32. En otras palabras: empate práctico en el benchmark de agentes de programación, con una diferencia de precio de 6x. Fable 5 solo mantiene una ventaja clara: sigue liderando el índice general de inteligencia de Artificial Analysis y ofrece el doble de ventana de contexto.
Cómo Grok 4.6 recortó distancia frente a Fable 5
Hace dos meses, esta comparativa tenía un ganador mucho más claro. En julio de 2026, Artificial Analysis situaba a Grok 4.5 en 56 puntos del Intelligence Index, frente a los 62 de Fable 5: seis puntos de diferencia. Grok 4.6, lanzado en agosto de 2026, sumó aproximadamente cinco puntos hasta ~59 —en un nivel similar a GPT-5.6 Sol— según los deltas de benchmark reportados. La ventaja de Fable 5 se redujo así a unos tres puntos.
En agentes de programación, la distancia se estrechó aún más. Fable 5 llegó a Cursor en junio de 2026 marcando un récord de 72,9% en CursorBench (r/accelerate), 8 puntos por encima del anterior mejor resultado. En el cara a cara publicado en r/cursor tras el lanzamiento de Grok 4.6, Grok 4.6 Extra High registró un 70,8% frente al 70,5% de Fable 5 Max. Bajo el mismo arnés de agente, es esencialmente un empate. Aun así, conviene no perder de vista esta observación de un usuario de Cursor que ejecutó la comparación:
"Grok 4.6 me hizo preguntarme cuánto de CursorBench depende del modelo y cuánto del arnés." - hilo de r/cursor, agosto de 2026
Los benchmarks miden toda la pila del agente —andamiaje de prompts, herramientas y reintentos—, no únicamente el modelo base. Además, el 72,9% de Fable 5 en su lanzamiento y el 70,5% de agosto proceden de configuraciones distintas, así que ambos datos deben leerse como una referencia orientativa.
El coste por tarea es el gran argumento de Grok 4.6
Los datos por tarea de esa comparación de agosto son los que mejor resumen la diferencia:
| Métrica (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Puntuación | 70,8% | 70,5% |
| Coste por tarea | $2.81 | $17.32 |
| Pasos por tarea | 46 | 72 |
Fable 5 necesitó un 57% más de pasos de agente para llegar prácticamente a la misma puntuación. Esos pasos adicionales, junto con los tokens de razonamiento que implican, encajan con la diferencia de coste. Por eso quienes han alternado entre ambos empiezan a cuestionar si el precio por token sigue siendo la métrica adecuada:
"$/token se está convirtiendo en una forma equivocada de comparar agentes de IA." - título de un hilo de r/grok, agosto de 2026
Los precios publicados por token explican parte de esa brecha. Fable 5 cuesta $10 por millón de tokens de entrada y $50 por millón de tokens de salida en la API de Anthropic. La tarifa publicada de la API de xAI para Grok 4.5 era de $2 / $6 por millón de tokens con prompts inferiores a 200K tokens; xAI no ha publicado una tabla de precios independiente para 4.6, aunque la comunidad de r/grok afirma que 4.6 ofrece "rendimiento de nivel Sol por una fracción del precio de la API". Para consultar todas las tarifas de Fable 5 por nivel, revisa el desglose de precios de la API de Fable 5.
En la práctica, hay dos factores que reducen esa ventaja. El precio de Grok prácticamente se duplica por encima de prompts de 200K tokens ($4 / $12 por millón en ese nivel, según las tarifas publicadas por xAI). Y si tu flujo de trabajo ya depende en gran medida de Fable 5, existen medidas estructurales para reducir el coste de tokens de Fable 5 antes de cambiar de modelo.
Las áreas en las que Fable 5 sigue por delante
| Área | La evidencia | Qué implica para ti |
|---|---|---|
| Índice de inteligencia | Fable 5 continúa en el puesto #1 del AA Intelligence Index: 62 frente a aproximadamente 59 de Grok 4.6 | Tras el salto de 4.6, sobreviven tres puntos de la antigua ventaja de seis puntos |
| Ventana de contexto | Fable 5 ofrece 1,000,000 tokens de contexto; Grok se queda en 500,000 | Un repositorio grande con el historial de la tarea puede caber en una sola pasada, y la ventaja de precio de Grok se reduce por encima de 200K tokens |
| Fiabilidad en las tareas más difíciles | En la prueba de desarrollo de TryAI, Fable 5 renderizó el Cubo de Rubik 3D al primer intento y produjo el mejor SVG; Grok 4.5 necesitó una segunda ejecución. Goldie Bench situó a Fable 5 por delante por 20-17 en 47 tareas de un solo intento, con victorias en desarrollos de shaders y física GPU por 0.8-1.6 puntos | Cuando la tarea es ambigua y solo hay un intento, se aprecia el techo de razonamiento de Fable 5 |
Velocidad, latencia y rendimiento
Estas son las cifras medidas por TryAI, con el mismo enrutamiento de proveedor, límite de 400 tokens y tres ejecuciones por tipo de prompt:
| Métrica | Grok 4.5 | Fable 5 |
|---|---|---|
| Tiempo hasta el primer token | 0.44 s | 3.47 s |
| Rendimiento | 110 tok/s | 28 tok/s |
| Coste por respuesta | $0.00002 | $0.00009 |
| Tasa de éxito | 100% | 100% |
Grok generó 110 tok/s: aproximadamente el doble que GPT-5.5 y Opus 4.8, y cerca de cuatro veces los 28 tok/s de Fable 5. Artificial Analysis aporta una cifra todavía más dura para Fable 5 con razonamiento de esfuerzo máximo: 113.68 segundos hasta el primer token de respuesta, frente a 8.68 de Grok. Sin embargo, una vez empieza el streaming, Fable 5 decodifica ligeramente más rápido (63.1 frente a 58.9 tok/s). En la práctica, Grok se siente más ágil en ciclos interactivos; Fable 5 concentra mucho razonamiento al principio y lo paga en tiempo total.
Acceso, suscripciones y herramientas para agentes
Fable 5 está disponible mediante la API de Anthropic, Claude Code y Cursor. Las suscripciones de tarifa plana Claude Pro cubren la mayor parte del uso fuera de la API. El ecosistema de Claude Code —CLAUDE.md, plugins, skills y servidores MCP— cuenta con años de madurez.
Grok 4.6 se ofrece a través de la API de xAI y Grok Build CLI (curl -fsSL https://x.ai/cli/install.sh | bash), mientras que X Premium incluye acceso al chat. Según ClockedCode, Grok Build lee sin configuración previa archivos CLAUDE.md, plugins de Claude Code, skills, servidores MCP, agentes y hooks existentes. También puede ejecutarse sin interfaz con la opción -p para CI y expone un Agent Client Protocol para integraciones. El ecosistema es más joven, pero su compatibilidad con Claude Code deja el coste de migración cerca de cero en configuraciones compatibles.
Una realidad de facturación aplicable a ambos: los suscriptores de Claude Pro y X Premium pagan tarifas planas, por lo que los límites de uso bajo tu carga real importan más que la tabla de precios.
Qué elegir según el caso de uso
| Tu situación | Elige | Por qué |
|---|---|---|
| Tareas de programación de alto volumen y bien definidas | Grok 4.6 | $2.81 por tarea frente a $17.32 con puntuaciones empatadas en CursorBench |
| Trabajo crítico para la corrección en un repositorio grande | Fable 5 | Ventana de contexto de 1M, índice de inteligencia #1 y mejor fiabilidad al primer intento |
| Sesiones de agente interactivas e iteración rápida | Grok 4.6 | 0.44 s hasta el primer token y 110 tok/s |
| Desarrollos ambiguos de un solo intento y razonamiento más exigente | Fable 5 | Ganó la tarea más difícil de TryAI y los cara a cara de Goldie Bench |
| Gasto de API con presupuesto limitado | Grok 4.6 | Los tokens de salida cuestan aproximadamente una octava parte de los de Fable 5 |
Mi conclusión: usa Grok 4.6 por defecto para trabajo acotado y repetitivo, y reserva Fable 5 para tareas en las que una respuesta incorrecta cuesta más que los tokens. Los equipos con volumen real deberían utilizar ambos y enrutar según el tamaño representativo de las tareas, la tasa de reintentos y el coste por tarea completada. Sale más barato que comprometerse en exclusiva con uno de los dos.
Preguntas frecuentes
¿Grok 4.6 es mejor que Fable 5 para programar?
En CursorBench están empatados: 70,8% para Grok 4.6 Extra High frente a 70,5% para Fable 5 Max en la comparación de agosto. Fable 5 conserva el liderazgo en el índice general de inteligencia de Artificial Analysis (62 frente a ~59) y gana las tareas de un solo intento más difíciles. Por tanto, cuál es "mejor" depende de si tu cuello de botella es el coste por tarea o el techo de corrección.
¿Grok 4.6 es más barato que Fable 5?
Sí: cuesta aproximadamente 6x menos por tarea de CursorBench completada ($2.81 frente a $17.32). La comparación por token se basa en la tarifa publicada de Grok 4.5 ($6 de salida frente a $50 por millón de Fable 5), porque xAI todavía no ha publicado una tarifa independiente para 4.6. Esa diferencia se reduce por encima de 200K tokens, donde el precio de Grok prácticamente se duplica.
¿Qué modelo tiene la ventana de contexto más grande?
Fable 5, con 1,000,000 tokens frente a los 500,000 de Grok. Para cargas de trabajo que mantienen una base de código completa en contexto, esa diferencia puede pesar más que la ventaja de precio de Grok.
¿Puede Grok Build usar mi configuración de Claude Code?
Sí. Grok Build lee automáticamente CLAUDE.md, plugins de Claude Code, skills, servidores MCP, agentes y hooks sin necesidad de migrarlos, y añade su propio directorio .grok/ para la configuración específica de Grok.
¿Los benchmarks de Grok 4.5 son una buena referencia para Grok 4.6?
No para medir capacidad. Grok 4.6 ganó unos cinco puntos en el Intelligence Index frente a 4.5, reduciendo una desventaja de seis puntos ante Fable 5 a aproximadamente tres, y empató con Fable 5 Max en CursorBench, donde 4.5 quedaba claramente por detrás. Las cifras de velocidad y precio por token de este artículo corresponden a mediciones de Grok 4.5, ya que todavía no se han publicado equivalentes para Grok 4.6.
La disyuntiva que ningún benchmark resuelve
Ningún benchmark de esta comparativa determina si la ventaja de coste se mantiene cuando el repositorio tiene 50,000 líneas, el ticket es ambiguo y un intento fallido implica una hora de depuración. El contexto de 1M de Fable 5 y su mayor techo de inteligencia existen precisamente para ese escenario: certeza costosa frente a los pasos baratos de Grok 4.6. La diferencia es lo bastante amplia como para que la mayoría de equipos mantengan ambos activos.
Lecturas relacionadas: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5