 AIREITER
Un agente de programación puede parecer barato hasta que supera un umbral de facturación por contexto o su presupuesto de razonamiento se come el límite de salida. Para decidir entre Grok 4.6 y Opus 5, apuesta por Grok 4.6 si priorizas el coste y trabajas por debajo de 200K tokens de prompt; Claude Opus 5 tiene más sentido si realmente necesitas una ventana de 1M tokens, 128K de salida o sus controles de agentes documentados.
La decisión depende primero de los límites de tu carga de trabajo
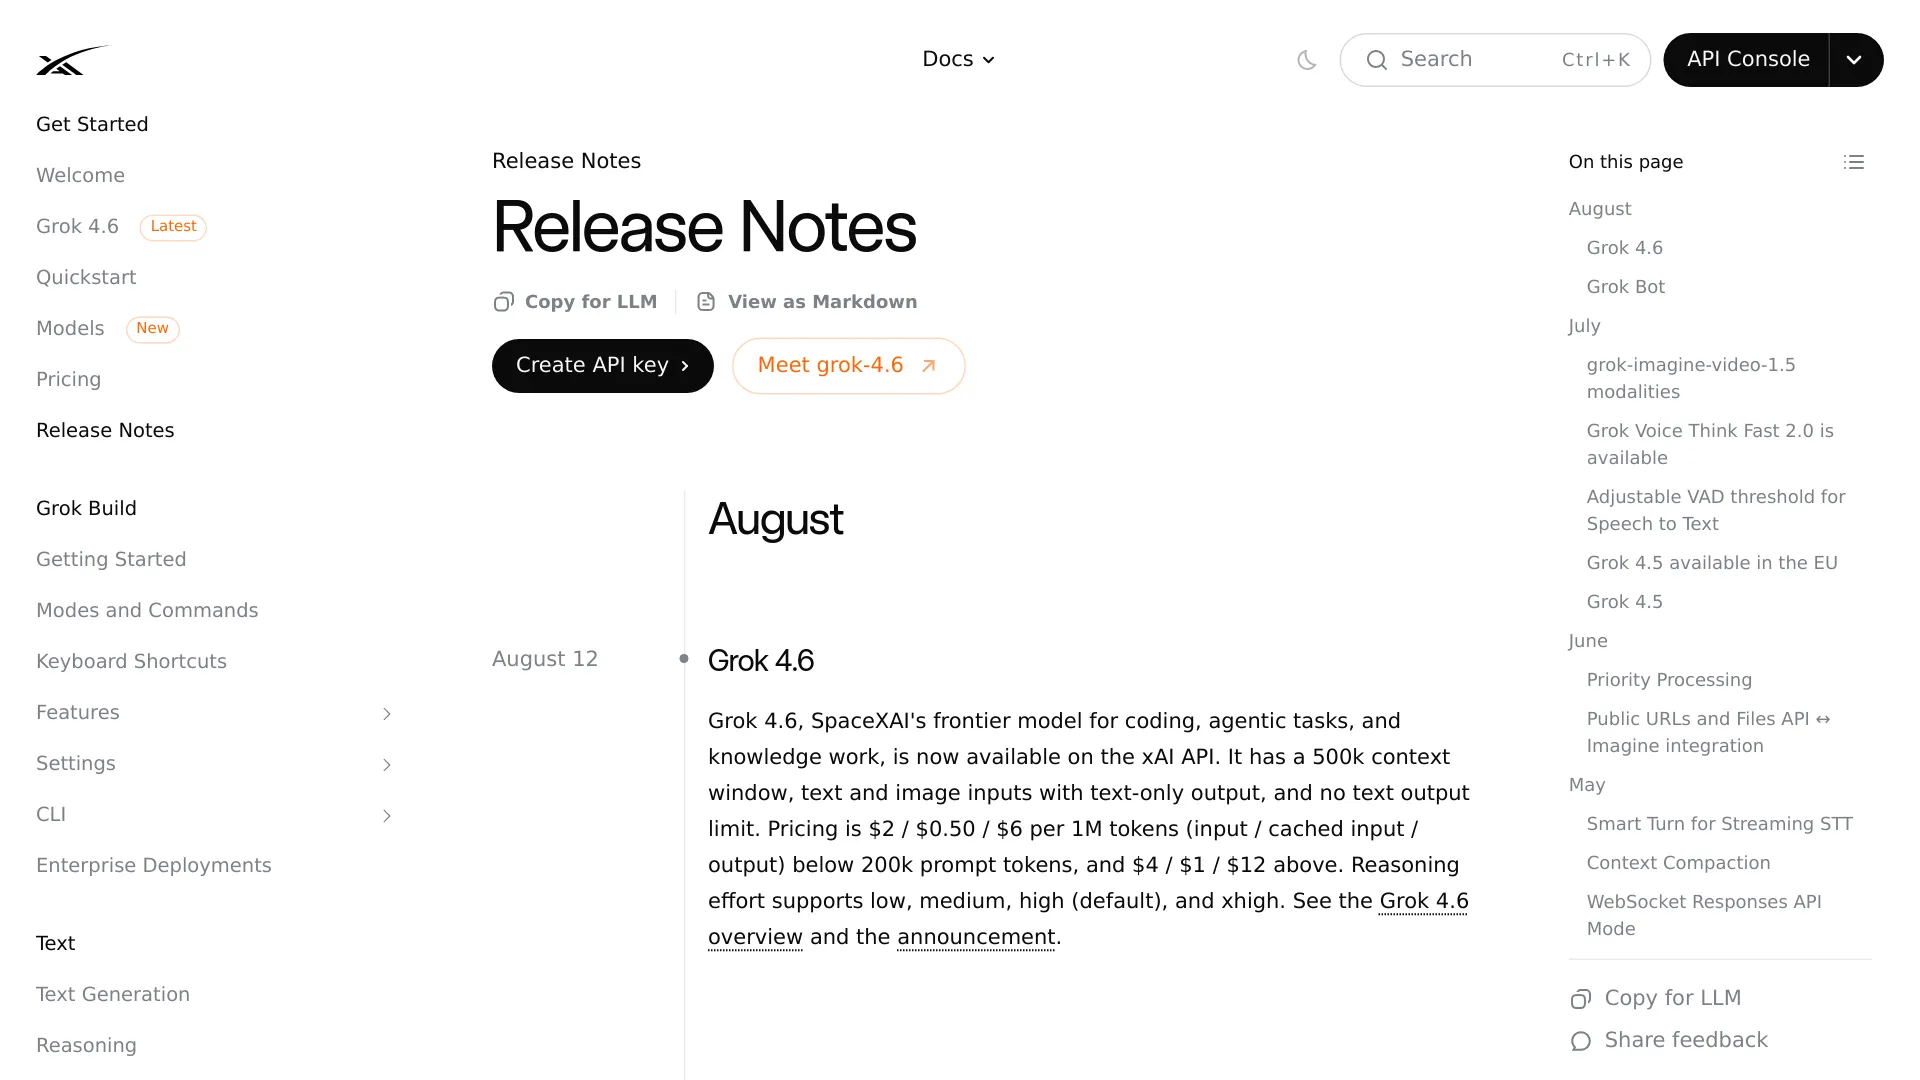
Grok 4.6 es la opción práctica por defecto para agentes de programación o trabajo de conocimiento que generan texto y se mantienen por debajo del umbral de precio de 200K tokens de prompt de xAI. En sus notas de la versión del 12 de agosto de 2026, xAI indica una ventana de contexto de 500K, entradas de texto e imagen, salida de texto y cuatro niveles de esfuerzo, desde low hasta xhigh. Las notas de la versión para desarrolladores de xAI son la fuente principal de especificaciones.
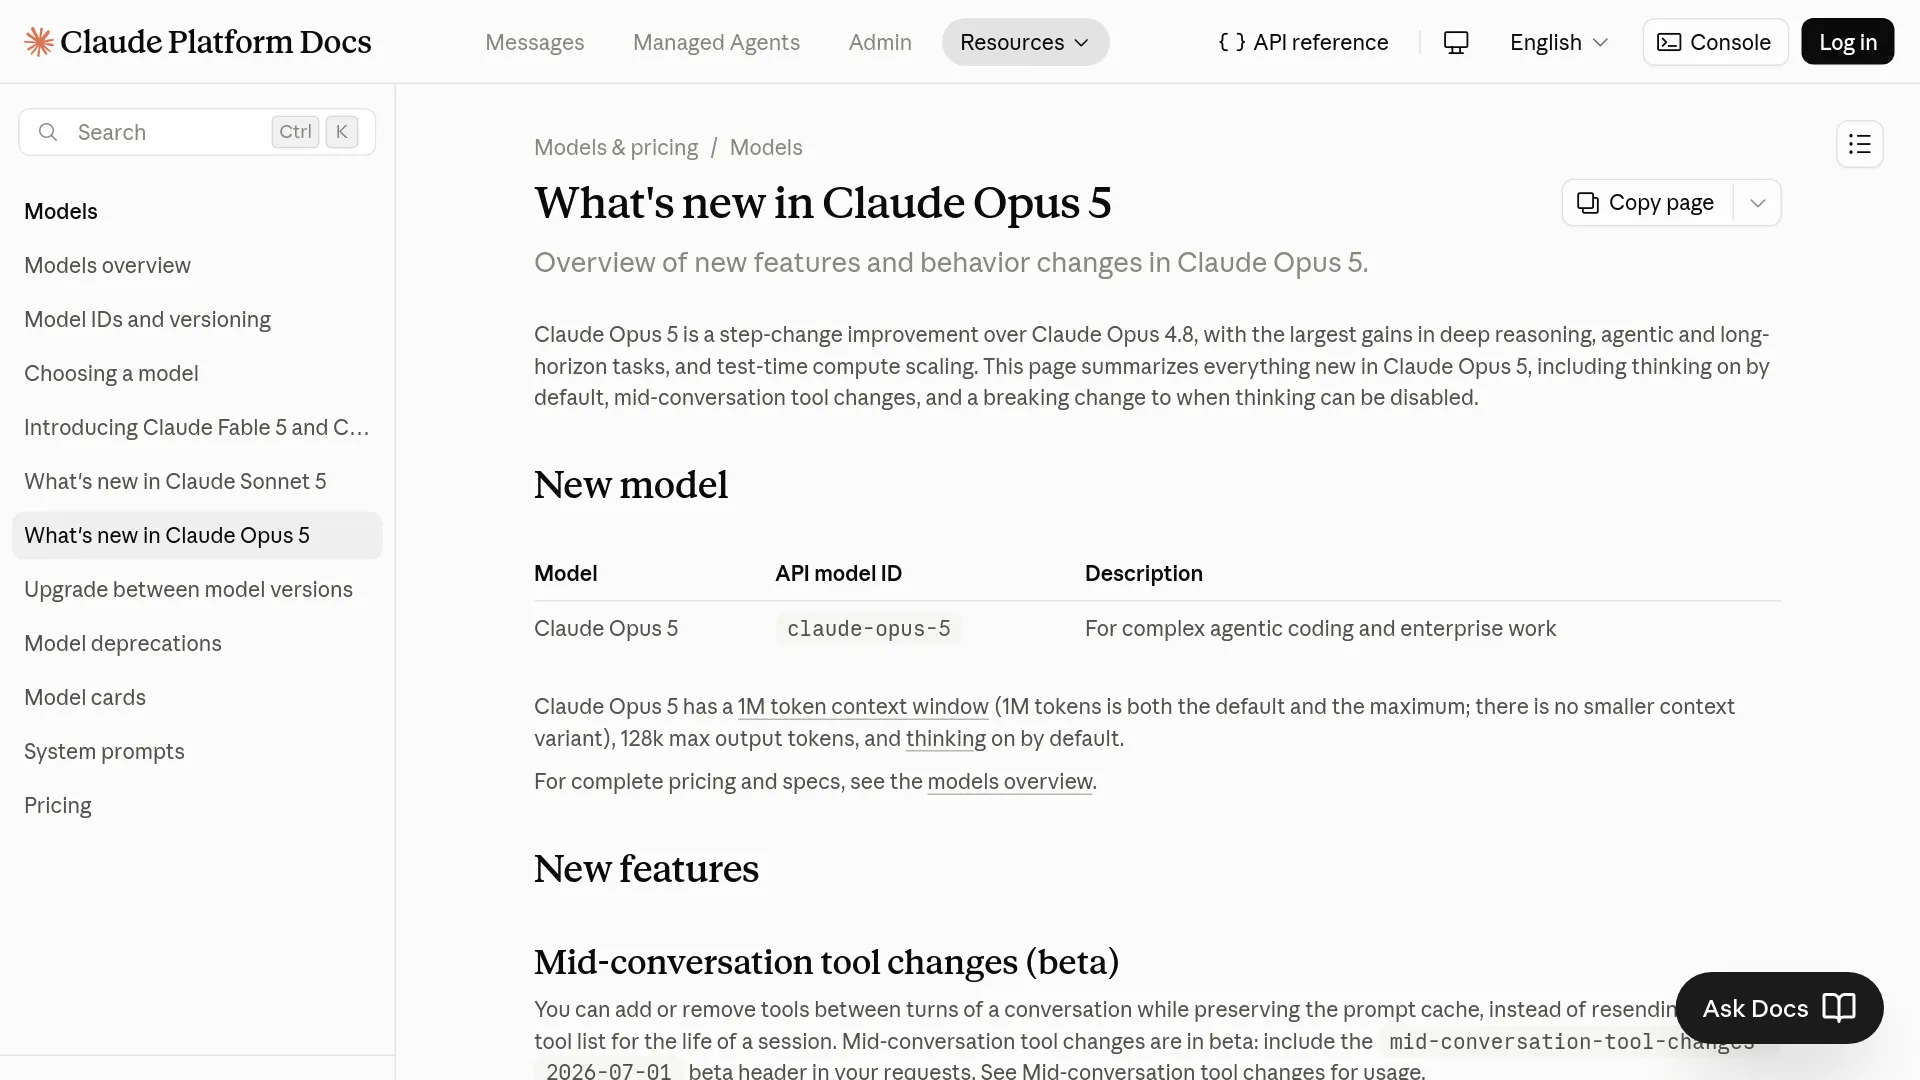
Claude Opus 5 encaja mejor cuando 500K tokens no bastan, el flujo necesita hasta 128K tokens de salida o la integración depende de las funciones de fallback y listas dinámicas de herramientas de Anthropic. Anthropic documenta una ventana de contexto predeterminada y máxima de 1M tokens, thinking activado por defecto y disponibilidad de claude-opus-5 en su API y los principales proveedores cloud. En este caso, la documentación de Opus 5 en Claude Platform pesa más que una pequeña diferencia en un leaderboard.
Las fuentes citadas no ofrecen un benchmark común que resuelva todos los casos de programación. Empieza por el tamaño máximo del prompt, la longitud de salida necesaria, el contrato de herramientas y el coste por tarea completada en tu propio entorno de pruebas.
Compara primero las condiciones de la API, no solo las puntuaciones
Grok 4.6 y Claude Opus 5 aceptan texto e imágenes, y generan texto. Las diferencias relevantes están en la capacidad de contexto, la facturación de prompts largos, el contrato de salida y los controles de integración.
| Propiedad de la API | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Ventana de contexto | 500K tokens | 1M tokens |
| Modalidades de entrada | Texto, imagen | Texto, imagen y flujos de trabajo con PDF/documentos descritos por Anthropic |
| Modalidad de salida | Texto | Texto |
| Salida máxima de texto | Las notas de la versión de xAI no indican un límite numérico | 128K tokens |
| Niveles de esfuerzo | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Esfuerzo predeterminado | high | high |
| Precio estándar de entrada | $2/M tokens | $5/M tokens |
| Precio estándar de salida | $6/M tokens | $25/M tokens |
| Regla para prompts largos | $4/M de entrada y $12/M de salida por encima de 200K tokens de prompt | La documentación de lanzamiento de Opus 5 no indica un umbral equivalente |
| Entrada en caché | $0.50/M por debajo de 200K; $1/M por encima de 200K | Prompt mínimo cacheable de 512 tokens, con precios de caché documentados por separado |
Grok 4.6 tiene tarifas unitarias publicadas más bajas, pero se duplican al superar los 200K tokens de prompt. Opus 5 cuesta más, aunque su contexto de 1M puede evitar la fragmentación o la sobrecarga de recuperación en flujos que lo requieran.
El umbral de 200K de Grok 4.6 cambia las cuentas
Grok 4.6 cuesta, según las tarifas listadas, $2 por millón de tokens de entrada y $6 por millón de salida por debajo de 200K tokens de prompt. Al superar los 200K, xAI indica $4/M para entrada y $12/M para salida; la entrada en caché pasa de $0.50/M a $1/M respectivamente. Ese corte importa más que la tarifa promocionada del tramo bajo. Las notas de la versión de xAI especifican ambos niveles.
Con las tarifas publicadas, 100K tokens de entrada sin caché y 20K de salida cuestan $0.32; 250K de entrada y 20K de salida cuestan $1.24 una vez aplicado el tramo superior. Son cálculos por solicitud, no estimaciones de una ejecución de agente, porque los reintentos, llamadas a herramientas, prefijos cacheados y contexto acumulado pueden dominar la factura.
Una discusión reciente en r/grok recoge resultados de CursorBench 3.2 específicos de una configuración: $2.81 por tarea y 46 pasos para Grok 4.6 Extra High, frente a $8.23 y 78 pasos para Opus 5 Max. Tómalos como resultados del entorno de pruebas que reporta el autor, no como una garantía neutral entre proveedores: la misma publicación sitúa a Grok 4.6 en el 26.0% de Terminal-Bench 3.0, por detrás de otros modelos mencionados.
Opus 5 afecta al diseño de la integración
Claude Opus 5 activa thinking de forma predeterminada. max_tokens es un límite estricto compartido entre el razonamiento oculto y la salida visible, por lo que migrar peticiones sin thinking desde Opus 4.8 puede exigir un presupuesto de salida mayor. Anthropic también señala que combinar thinking: {"type":"disabled"} con xhigh o max devuelve HTTP 400. Las notas de migración plantean dos opciones: reducir el esfuerzo al desactivar thinking o eliminar la configuración que lo desactiva.
Claude Opus 5 también reduce el prompt mínimo cacheable de los 1,024 tokens de Opus 4.8 a 512 tokens. Sus controles beta permiten cambiar herramientas durante una conversación sin invalidar la caché del prompt y ofrecen un modo gestionado fallbacks: "default". Esto es relevante si tu agente tiene permisos o conjuntos de herramientas cambiantes; para un endpoint sencillo de completado sin estado, no lo es.
Fast mode es una vista previa de investigación exclusiva de la API, con un precio de $10/M de entrada y $50/M de salida: el doble de la tarifa estándar de Opus 5. Anthropic indica que no está disponible a través de Amazon Bedrock, Google Cloud ni Microsoft Foundry, así que no debes dar por sentadas simultáneamente la portabilidad y la velocidad. El anuncio de lanzamiento de Anthropic fija el precio estándar en $5/M de entrada y $25/M de salida.
La evidencia en agentes de programación orienta, pero no declara un ganador universal
Anthropic afirma que Opus 5 con esfuerzo máximo alcanza cerca de un 70.0% en CursorBench 3.2 con un coste aproximado de $8.50 por tarea, a menos de 0.5 puntos porcentuales de la mejor puntuación reportada para Fable 5 y por aproximadamente la mitad de su coste. Son resultados representados por Anthropic y deben leerse como evidencia de evaluación del proveedor, no como una auditoría entre plataformas. El anuncio de Opus 5 describe su método Frontier-Bench como cinco intentos por tarea con una ejecución interna de Anthropic.
Una medición aparentemente independiente, aunque más acotada, resulta más útil para la revisión de código. CodeRabbit probó aproximadamente 100 patrones de error verificados de pull requests reales de código abierto, ejecutó cada configuración tres veces y evaluó comentarios de revisión tras filtrarlos. Con esfuerzo xhigh, su configuración de Opus 5 detectó el 55.2% de los problemas conocidos, frente al 61.1% de su línea base de producción; la precisión accionable fue del 39.3% frente al 35.2%, y además generó 92 nitpicks frente a 23. La evaluación de Opus 5 de CodeRabbit recomienda un rol concreto centrado en la precisión, en lugar de usar Opus 5 como única red de seguridad.
La conclusión práctica es clara: evalúa Opus 5 en más de un nivel de esfuerzo y mide recuperación, precisión, uso de tokens y ruido en las revisiones sobre tus propios pull requests. Para Grok 4.6, las notas de la versión actuales de xAI cubren el contrato de API y los precios, pero no publican un estudio de revisión de código directamente comparable. No deduzcas que gana en revisión de código a partir de una puntuación de agente de programación.
Qué modelo elegir según el despliegue
Grok 4.6 es la recomendación para agentes cuyos prompts habituales se mantienen por debajo de 200K tokens y donde la prioridad es un menor coste de API publicado. Define un presupuesto de evaluación alrededor de ese límite, porque un agente para repositorios puede cruzarlo tras las salidas de herramientas y los reintentos, aunque su primer prompt sea pequeño.
Claude Opus 5 es la recomendación para una sesión de repositorio, documentos o agente que necesite más de 500K tokens de contexto activo, hasta 128K de salida o los controles documentados de Anthropic para cambios de herramientas y fallback. Empieza con high y prueba después niveles de esfuerzo inferiores antes de asumir que max se justifica por sí solo.
En revisión automática de código, no elijas ninguno de los dos modelos basándote en un leaderboard general de programación. Ejecuta un conjunto etiquetado de pull requests, registra la recuperación de problemas y la carga de falsos positivos, y conserva una segunda vía de revisión para defectos de concurrencia, uso de API y validación. CodeRabbit identificó estas categorías como puntos más débiles en las configuraciones de Opus 5 que probó. Sus conclusiones por categoría son un motivo para probar el ajuste a la tarea, no una afirmación sobre todos los despliegues de Claude.
| Situación de despliegue | Elección predeterminada | Factor decisivo |
|---|---|---|
| Agente de programación sensible al coste por debajo de 200K tokens de prompt | Grok 4.6 | Sus tarifas listadas de $2/M de entrada y $6/M de salida |
| Sesión larga de repositorio o documentos con más de 500K de contexto | Claude Opus 5 | Ventana de contexto de 1M y límite de salida de 128K |
| Agente con herramientas que cambian dinámicamente | Claude Opus 5 | Los cambios beta de herramientas durante la conversación preservan la caché |
| Tarea con prompts frecuentes por encima de 200K tokens | Evalúa ambos | Grok 4.6 duplica sus tarifas de tokens listadas al cruzar el umbral |
| Canal de revisión de código | Evalúa ambos con PRs etiquetados | La recuperación, precisión, reintentos y ruido de revisión importan más que una puntuación destacada |
Preguntas frecuentes
¿Grok 4.6 es más barato que Opus 5?
Por debajo de 200K tokens de prompt, xAI lista Grok 4.6 a $2/M de entrada y $6/M de salida, frente a $5/M y $25/M en Opus 5. Los precios publicados de Grok 4.6 se duplican por encima de 200K tokens de prompt, así que compara el coste por tarea completada y no solo la solicitud inicial.
¿Qué modelo debería usar para programación?
Elige Grok 4.6 por sus menores tarifas de API publicadas cuando tu agente normalmente se mantiene por debajo de 200K tokens de prompt. Elige Opus 5 si necesitas contexto de 1M, salida de 128K o los controles de agentes de Anthropic; valida cualquiera de las dos opciones con el lenguaje, la estructura de repositorio y el ciclo de herramientas que realmente utilizas.
Siguiente paso para el despliegue
Ejecuta las mismas 20 a 50 tareas representativas con cada candidato, usando herramientas fijas, un límite de reintentos fijo y registro de tokens. Elige el modelo que alcance tu tasa de éxito requerida con el menor coste por tarea completada y conserva el otro como opción de enrutamiento para cargas donde su ventaja de contexto o plano de control sea decisiva.
Lecturas relacionadas: guía de precios de la API de Claude Opus 5, detalles del lanzamiento de Grok 4.6 y Grok 4.6 vs GPT-5.6.