 AIREITER
评估 Hy4 preview,不能只看每百万 token 的单价。腾讯已经公布人民币价目表,OpenRouter 也提供可直接调用的端点;但究竟该走哪条线路,还要结合缓存使用情况、工具调用支持,以及团队是否有能力运维一个需要八路分布式部署的模型来判断。
Hy4 preview API 怎么收费
腾讯云 TokenHub 对 Hy4 preview 的定价为:每百万输入 token CNY 6、每百万输出 token CNY 18、每百万缓存输入 token CNY 0.30。OpenRouter 的托管模型页面则显示,对应价格分别为 $0.834、$2.501 和 $0.042。
| 接入渠道 | 输入 / 100 万 token | 输出 / 100 万 token | 缓存输入 / 100 万 token | 模型 ID |
|---|---|---|---|---|
| 腾讯云 TokenHub | CNY 6 | CNY 18 | CNY 0.30 | 请在 TokenHub 中确认 |
| OpenRouter | $0.834 | $2.501 | $0.042 | tencent/hy4-preview |
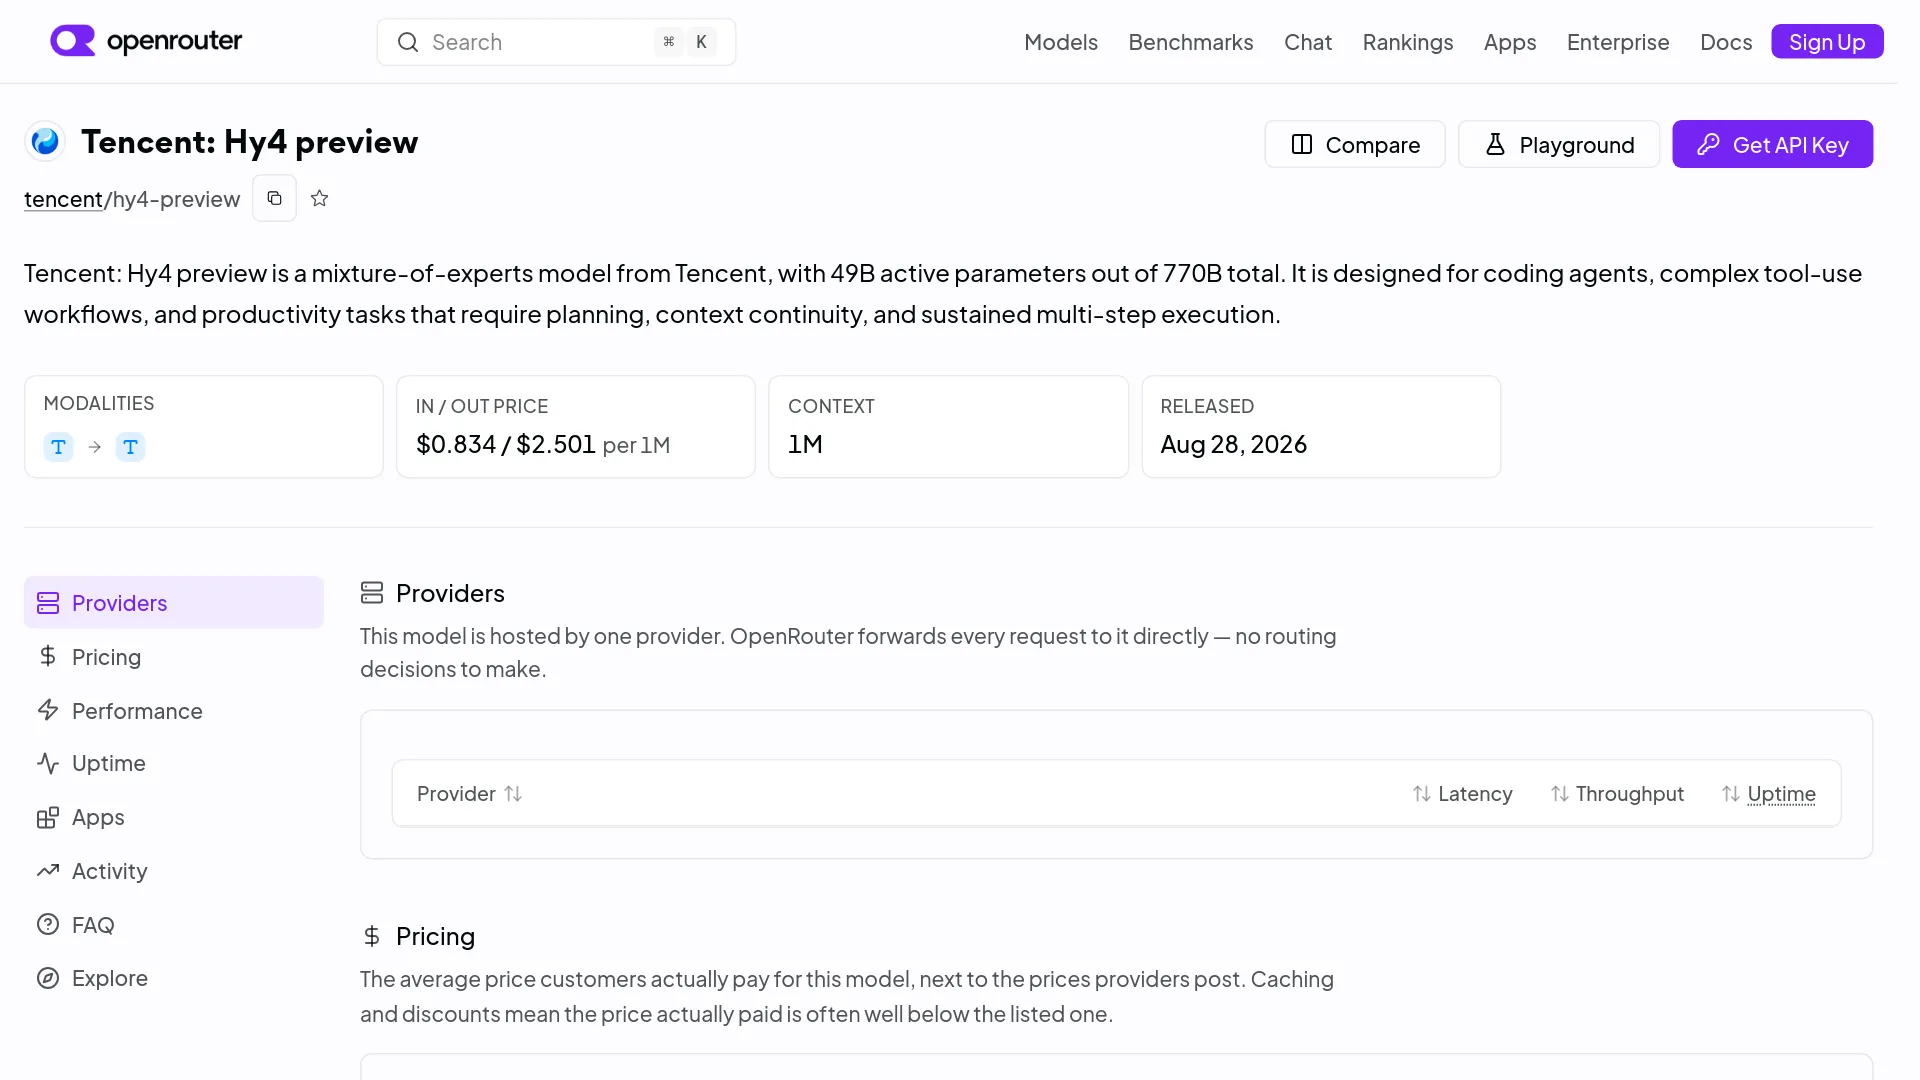
腾讯云 TokenHub 官方价格页面更新于 2026 年 8 月 28 日,是人民币价格最可靠的参考来源。托管模型 ID、准确的上下文上限、最大补全长度和端点功能,则应以 OpenRouter 模型页面为准。
将 OpenRouter 的各项价格分别除以腾讯的对应报价,三个计费项的结果都约为每 CNY 对应 $0.139。这反映的是两份公开价目表之间的隐含对应关系,并非市场汇率报价;税费、货币兑换费用、账户条款和实际路由仍可能影响最终账单。
按实际请求算一笔 Hy4 成本
以腾讯公布的价格计算,一次包含 100,000 输入 token 和 10,000 输出 token 的请求,费用为CNY 0.78:
- 输入:
0.1 × CNY 6 = CNY 0.60。 - 输出:
0.01 × CNY 18 = CNY 0.18。 - 合计:CNY 0.78。
如果这 100,000 个输入 token 命中缓存,同一请求的费用约为CNY 0.21:0.1 × CNY 0.30 + 0.01 × CNY 18。
按 OpenRouter 页面展示的价格,等价请求未使用缓存时为$0.10841,输入命中缓存后为$0.02921。这些数字严格基于上述 token 数量计算,未包含服务商层面的附加费用或账户调整。
输出越长,费用增长越快
在两份价目表中,输出 token 的单价都是新输入 token 的三倍。因此,即使稳定的系统提示词或代码仓库前缀已经缓存,较长的 Agent 推理轨迹、代码补丁和生成报告,仍可能成为成本的大头。
建议将新输入、缓存读取输入和输出分别记录。缓存命中只能降低提示词部分的费用,无法降低模型生成回复的成本。
这个价格对应什么能力
Hy4 preview 是一款 Mixture-of-Experts 模型,拥有770B 总参数规模的骨干网络、每个 token 激活 49B 参数以及1M-token 上下文窗口。腾讯将其定位于长周期软件开发、规划和生产力任务;不过,目前可获得的质量证据均为厂商自报,而非独立 API 基准测试。
| API 或模型信息 | 已确认细节 |
|---|---|
| OpenRouter 模型 ID | tencent/hy4-preview |
| 上下文 | 腾讯卡片标注为 1M token;OpenRouter 标注为 1,048,576 |
| 最大补全长度 | OpenRouter 为 64,000 token |
| 许可证 | 腾讯模型卡标注为 Apache License 2.0 |
| 已发布检查点 | Hy4 preview 和 Hy4 preview-FP8 |
| 官方本地运行时 | vLLM 和 SGLang |
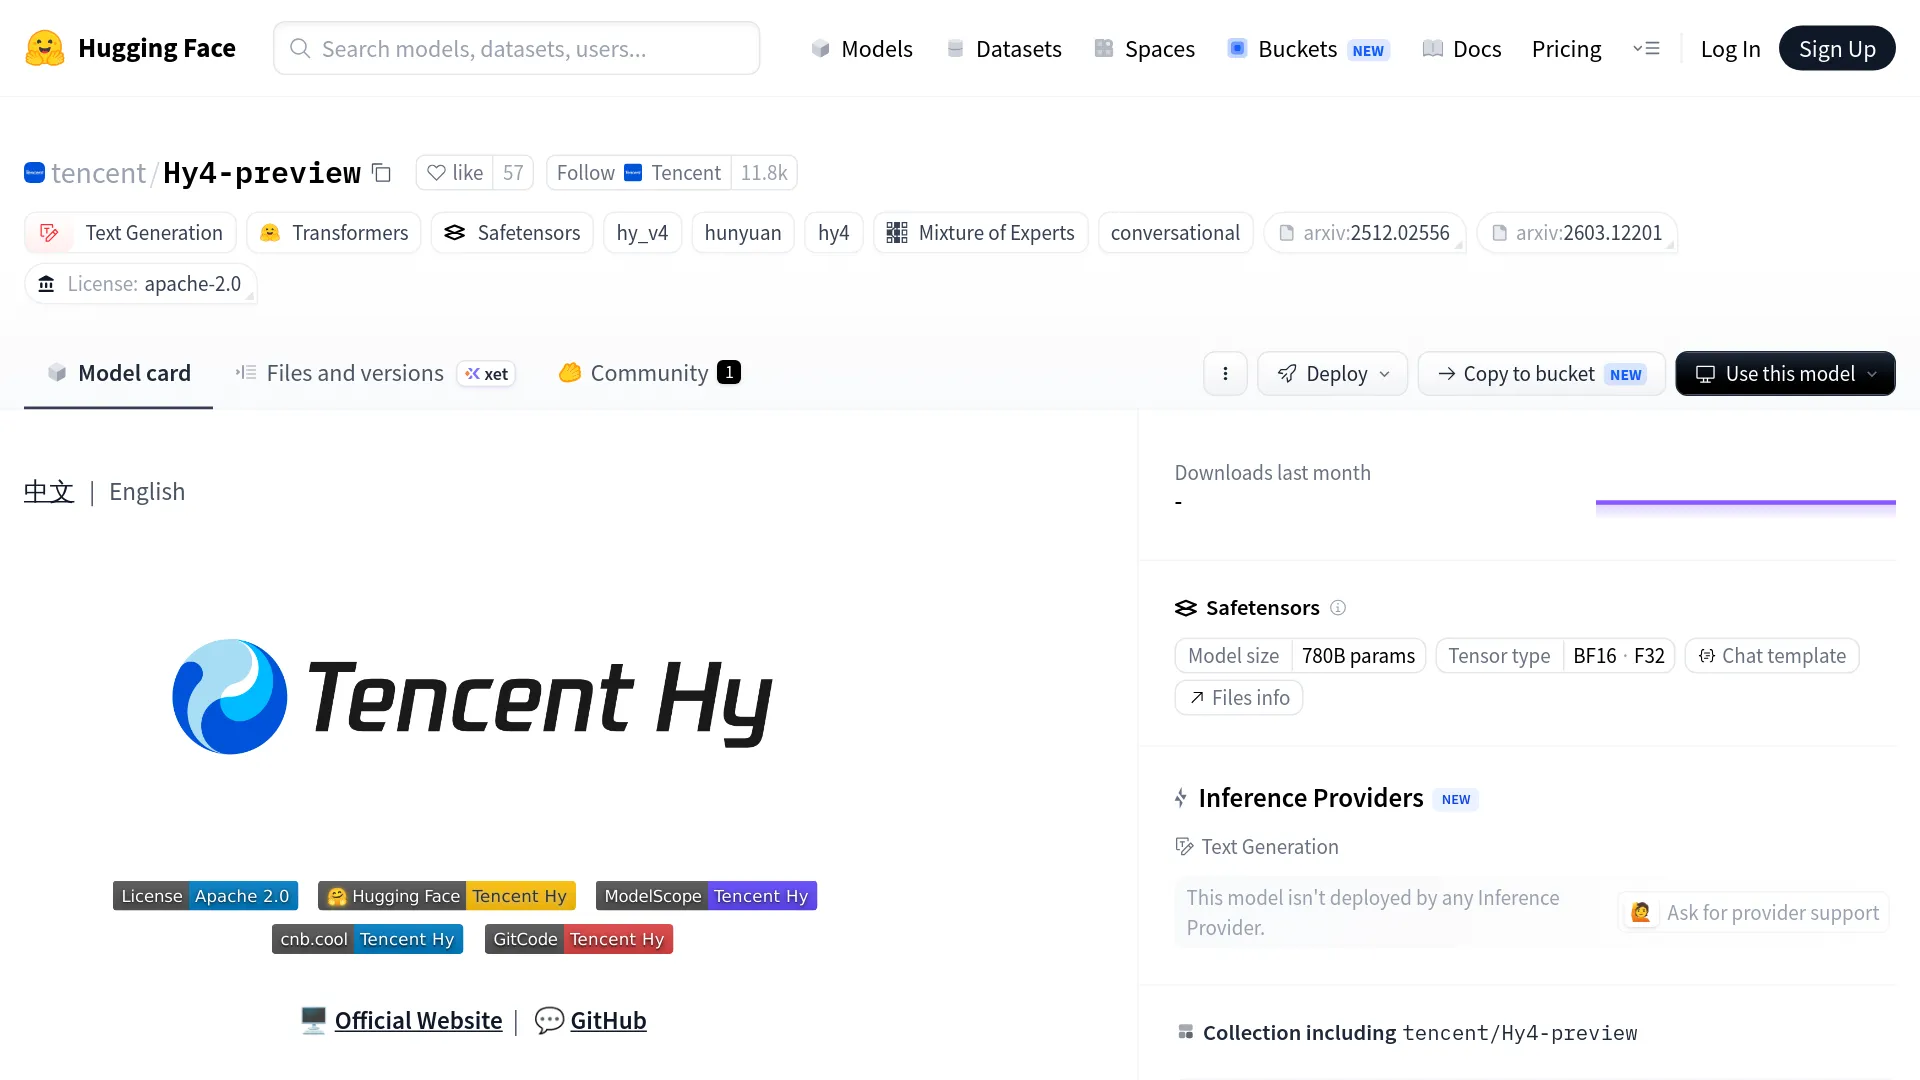
腾讯官方模型卡提供了权重、许可证和部署文档。其服务示例推荐使用 FP8 检查点,但没有量化说明 FP8 相比非 FP8 检查点在显存、吞吐量或质量上的差异。
Agent 场景要注意:OpenRouter 不提供工具调用或强制 JSON
OpenRouter 页面显示,该端点不接受 tools,也不支持通过 response_format 强制输出结构化结果。这是该接入线路的限制,并不代表所有本地 Hy4 部署都没有解析器支持。
腾讯提供的 vLLM 和 SGLang 示例包含 Hy4 工具调用及推理解析器。如果应用依赖原生函数调用或由 schema 强制约束的 JSON,在接入前应确认所选服务商的能力;必要时,也要准备外部编排或校验层。
选托管 API,还是本地部署?
对于评估阶段和大多数早期生产实验,托管访问能免去官方本地方案所需的存储、GPU 和运行时运维工作。只有团队本来就具备分布式 GPU 运维能力,或对数据控制有强需求时,本地服务才更合理。
| 决策因素 | 托管 API | 本地部署 Hy4 |
|---|---|---|
| 准备工作 | 服务商账户和 API 密钥 | 下载权重并搭建运行时 |
| 扩缩容 | 由服务商管理 | 官方示例采用 8 路张量并行 |
| 存储 | 无需本地保存权重 | Hugging Face 仓库标注约 1.56 TB |
| API 行为 | 取决于服务商 | vLLM/SGLang 配置由你控制 |
| 主要风险 | 预览版限制与线路变更 | 硬件、运行时兼容性和运维成本 |
什么情况下值得本地跑 Hy4
仅当你已经具备合适的多 GPU 基础设施、需要让提示词留在自有环境内、能够维护 vLLM 或 SGLang,并接受预览版模型的不确定性时,才适合自托管 Hy4。腾讯文档中,vLLM 示例使用 Python 3.12,SGLang 示例使用 transformers>=5.6.0;但这些命令只是示例,并非保证适用的最低要求。
一则早期社区讨论也说明,硬件问题应该排在跑分问题之前:
“I don't know who ... runs 780b models...” — u/_-_David,发表于 r/LocalLLaMA 的 Hy4 preview 讨论。
这只是用户反馈,并非容量测试数据。但它仍是一个实用的筛选条件:具备 1M 上下文,并不等于这个模型就适合在本地实际运行。
Hy3 仍是更省钱的基线方案
在腾讯当前的 TokenHub 价目表中,标准版 Hy3 是成本更低的选项:每百万 token 的输入 CNY 1、输出 CNY 4、缓存输入 CNY 0.25。Hy4 的新输入价格高出六倍,输出价格高出 4.5 倍;因此,只有确实需要更大的上下文,或它在高难度任务上的表现更好时,才有充分理由切换。
| 选择问题 | 适合选择 Hy4 preview 的情况 | 适合选择标准 Hy3 的情况 |
|---|---|---|
| 上下文 | 工作负载需要 1M-token 级别的上下文 | 提示词能够容纳在更小的当前限制内 |
| 预算 | 新增能力值得 CNY 6/18 的价格 | 更低的 token 成本最重要 |
| 稳定性 | 可以测试预览版线路 | 希望使用更简单、已经建立的基线 |
同一份 TokenHub 官方页面标注,Hy3 preview 将于 2026 年 8 月 31 日下线,因此不适合作为新的集成目标。
Hy4 preview 上生产前的检查项
- 记录服务商、模型 ID、货币、区域和价目表时间戳。
- 发送一个短请求,核验返回的模型和服务商。
- 使用稳定前缀重复请求,测试缓存计费是否符合预期。
- 测试应用实际需要的上下文长度,不要想当然地认定完整窗口下的质量。
- 单独测试长补全,因为输出才是昂贵的计费项。
- 如果应用需要工具调用和结构化输出,也应发送对应请求进行测试;OpenRouter 当前将两者均列为不支持。
- 记录新输入、缓存读取、输出、错误和重试。
- 在线路积累可用性和使用历史期间,保留备用方案与回归提示词。
OpenRouter 当前显示,Hy4 preview 的可用性和应用使用数据不足。这并不能证明其可靠性差,但也意味着可用于容量规划的公开服务历史很少。
Hy4 preview API 定价常见问题
Hy4 preview 的 API 价格是多少?
腾讯云 TokenHub 标价为每百万 token:输入 CNY 6、输出 CNY 18、缓存输入 CNY 0.30。OpenRouter 的托管页面显示,对应价格为 $0.834、$2.501 和 $0.042。
Hy4 preview 在 OpenRouter 上的模型 ID 是什么?
使用 tencent/hy4-preview。由于托管路由设置可能变化,请在自己的账户中确认实际返回的服务商和模型。
Hy4 preview 支持 1M-token 上下文窗口吗?
支持。腾讯模型卡标注为 1M token,而 OpenRouter 对其线路的标注是 1,048,576 token,上限补全长度为 64,000 token。
Hy4 preview 是开源的吗?
腾讯在官方模型卡中以 Apache License 2.0 发布了 Hy4 preview 检查点。对于可下载的检查点而言,“开放权重”是更准确的表述。
OpenRouter 端点支持工具调用吗?
所记录的 OpenRouter 页面显示不支持。它不接受 tools,也不支持通过 response_format 强制结构化输出;本地服务和其他服务商可能提供不同的行为。
一句话结论
若要进行可控评估和长上下文实验,可使用托管的 Hy4 preview 线路;只有当分布式 GPU 能力、数据控制需求和预览版风险都与工作负载匹配时,才应考虑自托管。