 AIREITER
在 2026 年 12 月 31 日之前,Gemini 3.8 Flash 的价格为每百万输入 token 0.75 美元、每百万输出 token 3.75 美元。但它在更高推理强度下可能消耗更多 token,让单个已完成任务的成本上升。更稳妥的做法,是先在多模态和专用智能体场景中测试,而不是把所有 Gemini 3.7 Flash 请求一次性迁移过来。
先看结论:Gemini 3.8 Flash 到底是什么
根据 Google 的发布公告,Gemini 3.8 Flash 于 2026 年 9 月 2 日发布,稳定版 API 模型 ID 为 gemini-3.8-flash。Google 将它定位为面向软件工程、自主智能体和多步骤企业工作流的模型。Google AI for Developers 模型页面将其列为稳定版,而 Google DeepMind 模型卡显示,它基于 Gemini 3.7 Flash 构建。
相比 Gemini 3.7 Flash,变化在哪里
Google 表示,Gemini 3.8 Flash 在困难任务上会进行更多推理步骤,并反复调用工具;同时也提醒,更高的推理强度可能消耗更多 token。Artificial Analysis 的数据显示,在高推理强度下,Gemini 3.8 Flash 的 Intelligence Index 得分为 59,Gemini 3.7 Flash 为 56;但单任务成本分别为 0.58 美元和 0.40 美元。(Google 发布公告;Artificial Analysis 对比)
先按工作负载做选择,再决定用哪个模型
当请求需要大上下文、多次工具调用或多模态证据时,Gemini 3.8 Flash 更有发挥空间。对于短小、重复性高的任务,它额外增加的推理循环未必能带来收益。
多模态任务和专用智能体,可以优先测试 Gemini 3.8 Flash
BenchmarkList 记录了以下成绩:Finance Agent v2 为 61.4%,HLE-Verified 为 54.9%,LVBench 为 87.8%,CharXiv-R 为 86.2%,LABBench2 为 86.2%。该网站区分了发布公告成绩、自报成绩和独立来源成绩,因此这些数字更适合作为参考信号,而不是一场口径完全统一的独立测试。(BenchmarkList 模型记录)
| 工作负载 | 需要关注的证据 | 判断 |
|---|---|---|
| 金融和结构化分析 | Finance Agent v2:61.4% | 适合开展受控试点 |
| 长视频或图表理解 | LVBench:87.8%;CharXiv-R:86.2% | 当纯文本模型不适合时,值得重点测试 |
| 生物学和科学工作流 | LABBench2:86.2%;BioMysteryBench human-difficult:56.5% | 需要专家参与复核 |
| 长文档和 PDF | 1,048,576-token 输入上限;支持 PDF 输入 | 适合检索和综合,但仍需验证召回效果 |
Google 的模型卡仍将幻觉、超时和偶发运行缓慢列为限制。(Gemini 3.8 Flash 模型卡)
简单、重效率的请求,继续使用 Gemini 3.7 Flash
分类、提取、打标签或生成短摘要的流水线,可能并不需要额外推理。Artificial Analysis 测得,Gemini 3.8 Flash 在低推理强度下单任务成本为 0.24 美元、耗时 0.8 分钟;高推理强度下则为 0.58 美元和 2.5 分钟。Gemini 3.7 Flash 在高推理强度下的对应数据为每任务 0.40 美元、2.2 分钟。
如果额外推理能够避免任务失败,就把 3.8 用在这类场景;如果只是增加输出和成本,则保留 3.7。
不要把它直接当成通用型自主编程冠军
BenchmarkList 记录的成绩包括:Terminal-Bench 2.1 为 89.4%,DeepSWE 1.1 为 73.7%,但 Terminal-Bench 4.0 只有 19.1%。此外,作为一项长时程计算机操作评测,OSWorld 2.0 的成绩为 59.0%。(BenchmarkList 编程和智能体测试结果)
对于需要识别隐藏状态、验证修改结果,并在工具调用失败后继续执行的终端或桌面智能体,切换之前,应该让 Gemini 3.8 Flash 和当前模型在同一套工作流上进行对测。
真正该算的是单任务成本,而不是每百万 token 价格
2026 年 Gemini 3.8 Flash API 价格
Google 的官方发布文章给出了以下直接 API 价格。首发优惠价持续到 2026 年 12 月 31 日,标准价格从 2027 年 1 月 1 日开始执行。(Google 发布公告)
| 时间段 | 输入价格 | 输出价格 | 实际含义 |
|---|---|---|---|
| 截至 2026 年 12 月 31 日 | 每 1M token 0.75 美元 | 每 1M token 3.75 美元 | 首发优惠价 |
| 自 2027 年 1 月 1 日起 | 每 1M token 1.50 美元 | 每 1M token 7.50 美元 | 输入和输出价格均翻倍 |
按首发价格计算,输出 token 的单价是输入 token 的 5 倍。Google 的文档还列出了 Batch API、Flex inference 和 Priority inference,但所引用的模型页面没有给出它们的具体数值价格。
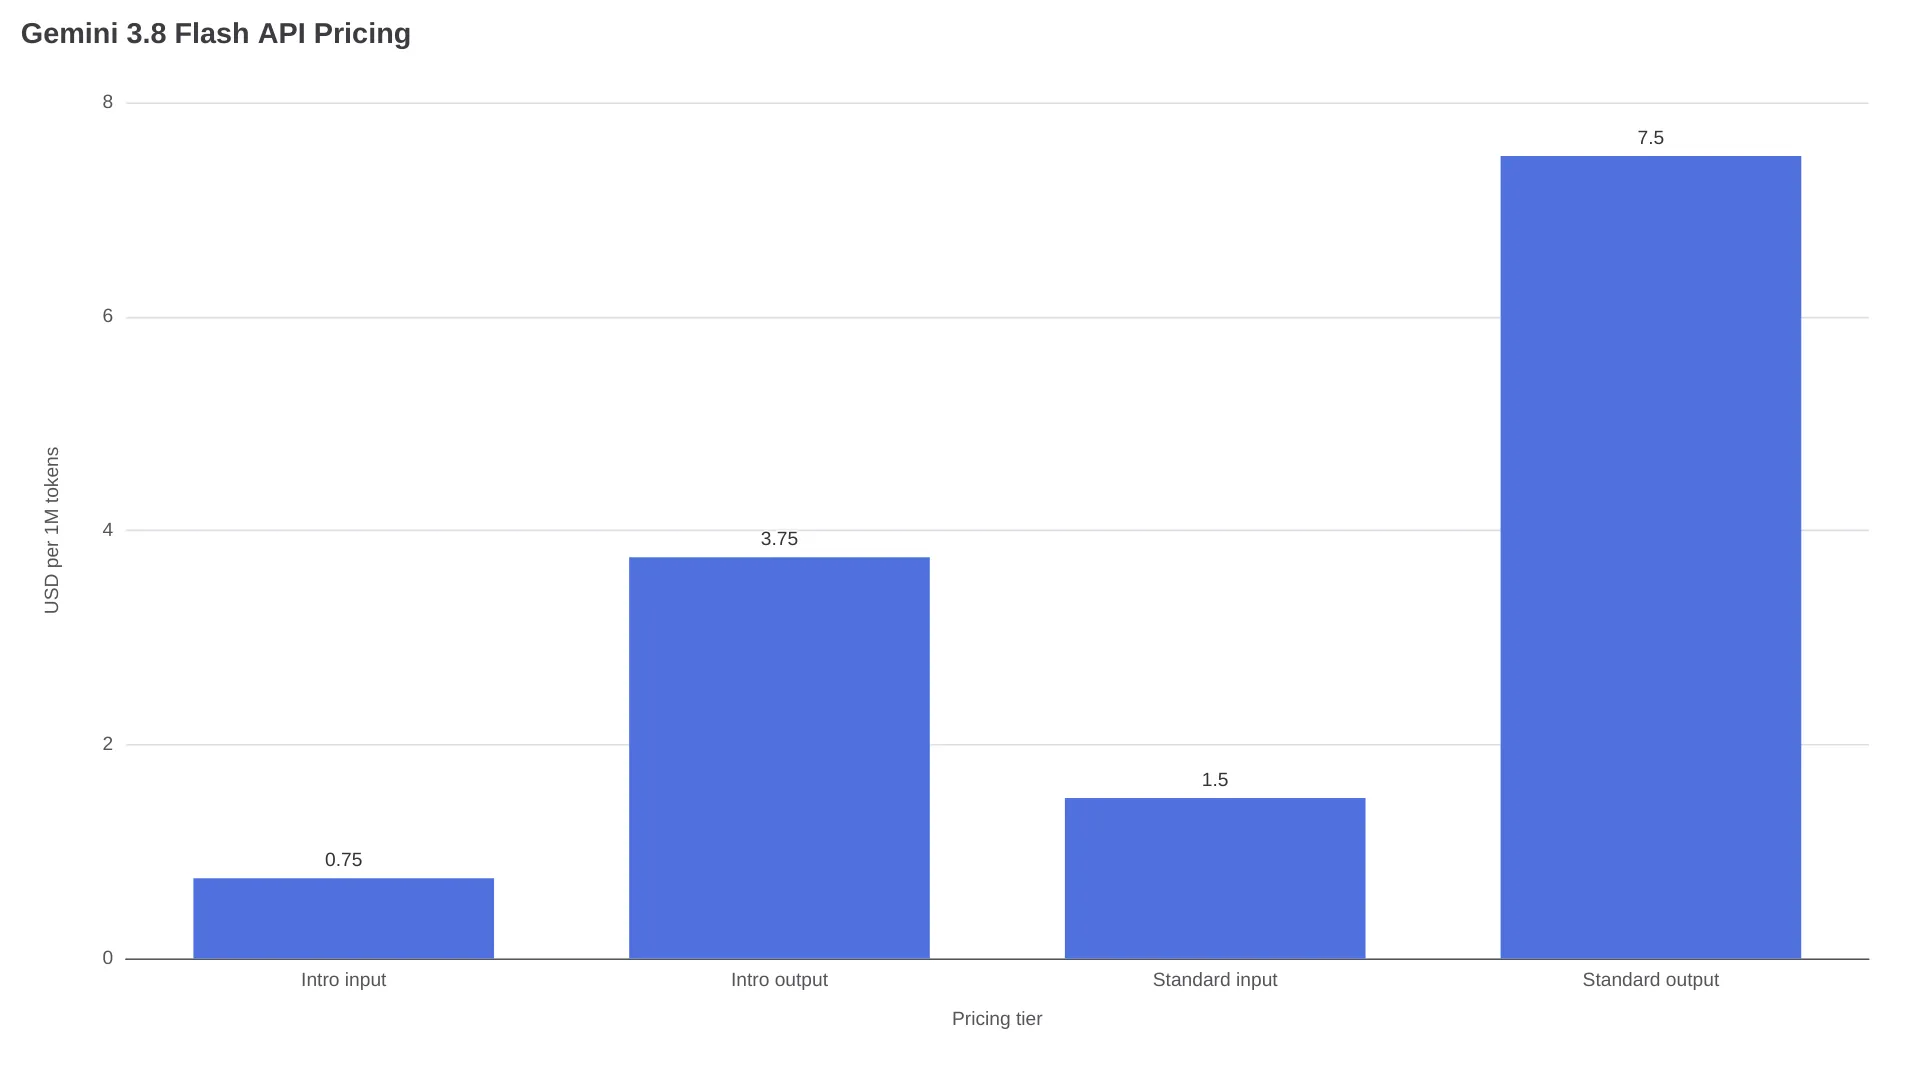
如果一个任务使用 2 million 输入 token 和 500,000 输出 token,按首发价格计算,成本为 3.38 美元:(2 × $0.75) + (0.5 × $3.75)。同样的 token 组合,从 2027 年 1 月 1 日起成本为 6.75 美元:(2 × $1.50) + (0.5 × $7.50)。
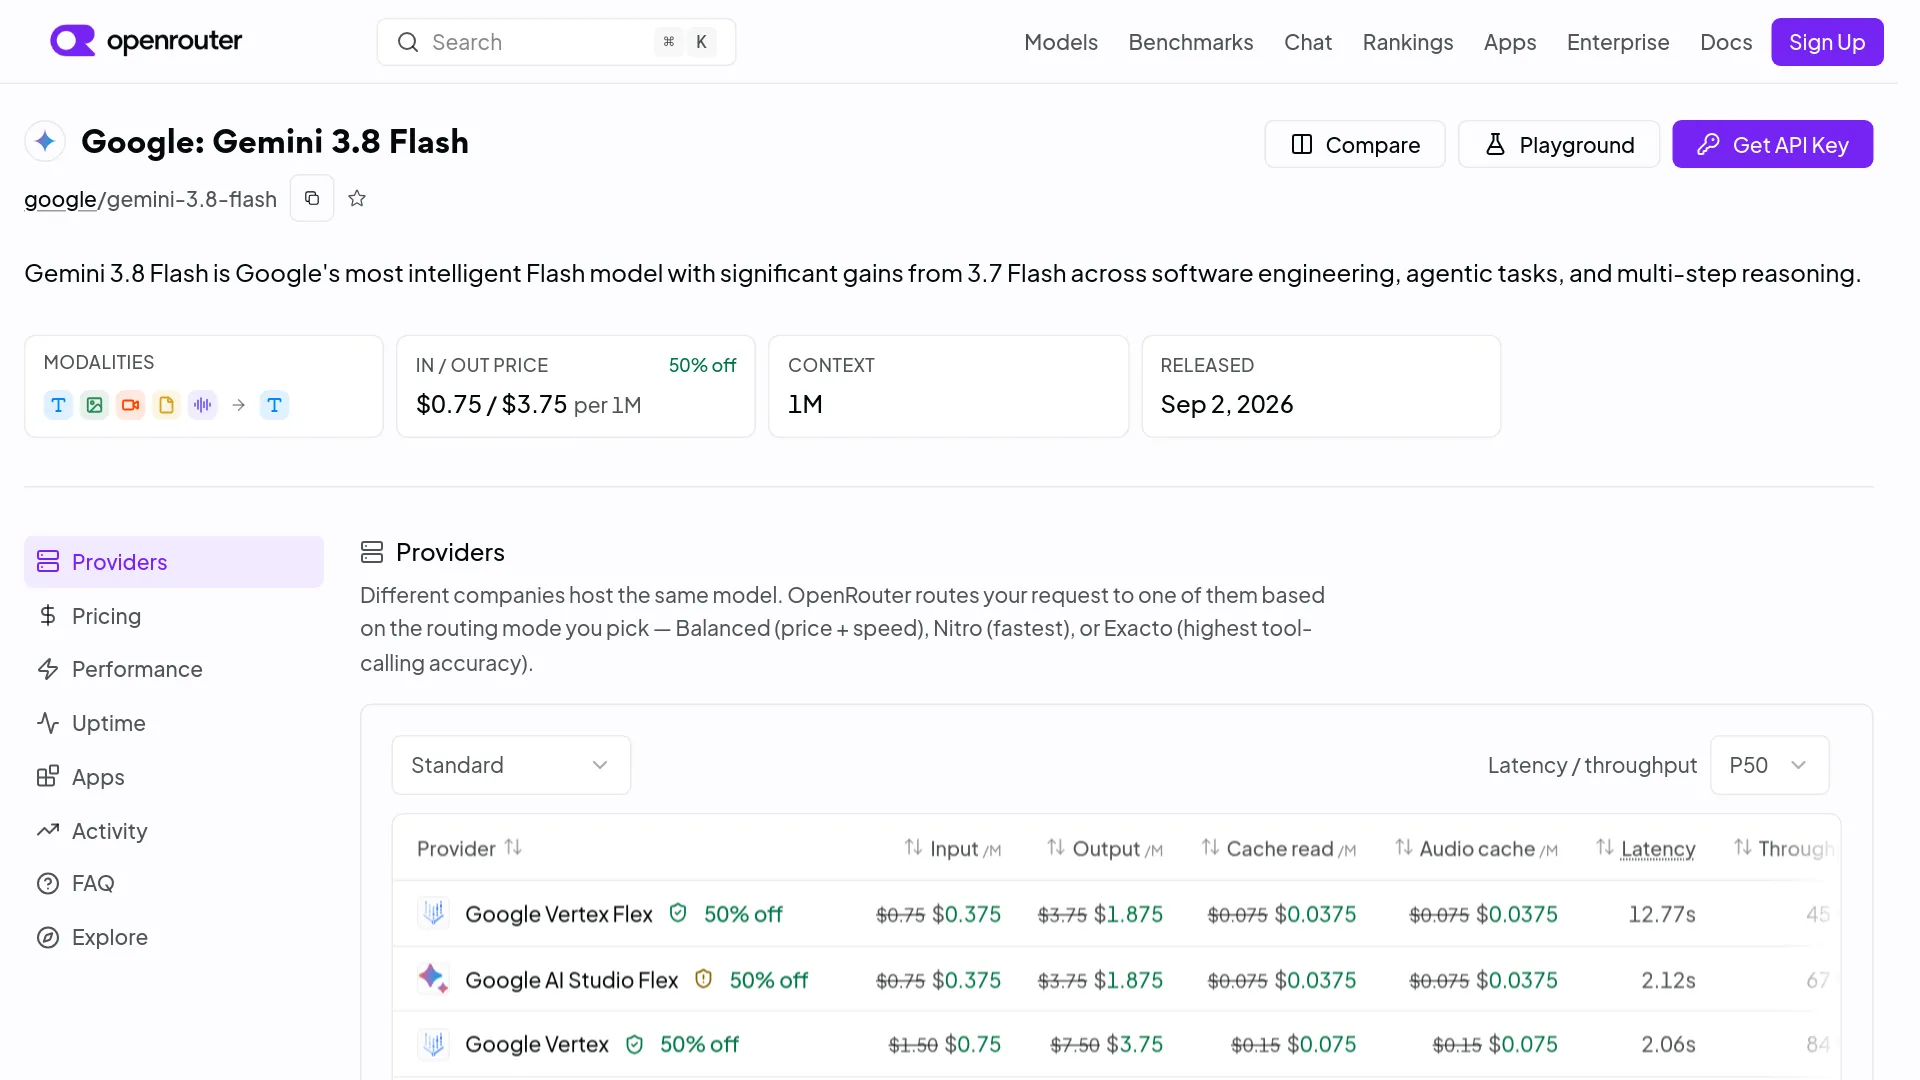
OpenRouter Gemini 3.8 Flash 页面另外列出了 Google Vertex 和 Google AI Studio 路由、缓存价格、延迟、吞吐量以及页面展示的折扣。将路由服务价格与 Google 直接价目表对比前,先确认服务商和计费路径。
为什么 token 更便宜,账单反而可能更高
Artificial Analysis 给出了 Gemini 3.8 Flash 在不同推理等级下的测量结果:
| 推理等级 | Intelligence Index | 单任务成本 | 单任务耗时 |
|---|---|---|---|
| 低 | 52 | 0.24 美元 | 0.8 分钟 |
| 中 | 57 | 0.41 美元 | 未列出 |
| 高 | 59 | 0.58 美元 | 2.5 分钟 |
Artificial Analysis 在所引用的分析中没有列出中等推理强度下的耗时。同一份分析称,Gemini 3.8 Flash 在 Intelligence Index 评测期间生成了 120 million 个输出 token,而可比模型的中位数为 71 million token。这是整个评测范围内的测量结果,并不代表每次 API 请求都会达到这一水平。但它清楚说明了,单看 token 价格并不足以制定生产预算。(Artificial Analysis 模型档案)
在内部对比时,应统计每个已完成任务的总输入 token、缓存输入 token、推理 token 和输出 token,再用 API 总支出除以成功完成的任务数,而不是发送的请求数。工具调用、重试和人工修正也要计入。
API 限制和能力
稳定版 API 支持什么
官方模型页面列出的最大输入限制为 1,048,576 token,最大输出限制为 65,536 token。Gemini 3.8 Flash 接受文本、图片、视频、音频和 PDF 输入,并返回文本。它支持缓存、代码执行、文件搜索、函数调用、Google Maps grounding、搜索 grounding、结构化输出、URL context,以及处于 Preview 状态的 computer use。(官方模型文档)
Thinking levels 包括 low、medium 和 high;不支持 minimal,使用后会返回错误。该模型不提供原生图像或音频生成,开发者文档也没有列出 Live API 支持。
可以在哪里使用,以及为什么 Cyber 不一样
Google 列出的 Gemini 3.8 Flash 使用入口包括 Gemini API、Google AI Studio、Android Studio、Stitch、Google Antigravity、Gemini Enterprise、Gemini 应用、Google Search 中的 AI Mode,以及 Google Sheets 中的 Gemini。(Google 发布公告)
Gemini 3.8 Flash Cyber 是独立的网络安全版本。Google 表示,Fairwind 会优先向可信防御方开放,包括政府机构、关键基础设施运营商和软件维护者。发布文章称,它在覆盖 20 种编程语言的内部漏洞发现基准测试中成功率超过 70%,在 CWE-Bench 修复测试中的 pass@1 为 47.2%;这些数据描述的是 Cyber,而不是通用版本。Google 的公告说明,Cyber 通过 Fairwind 提供访问,因此不要默认普通 Flash API 路由就能使用 Cyber。(Google Cyber 公告)
产品早期上线时,不同账号和入口的开放情况可能不同。一位 Reddit 用户表示:
“3.8 Flash 现在也出现在我的 Gemini 网页应用里了,看起来应该算正式上线。我人在澳大利亚,订阅的是 Pro,但 AntiGravity 和 iOS 应用里还没有。” —— u/DMAC80,r/GeminiAI
对于应用集成,请核对配置的 API 模型 ID,即 gemini-3.8-flash,以及集成能够获取的响应元数据;模型自我描述并不能证明你实际调用的是哪个端点。
现有证据还不能证明什么
| 已记录的限制 | 实际影响 |
|---|---|
| Artificial Analysis 报告称,在高推理强度下,模型生成第一个答案 token 需要 13.39 秒,但之后的输出速度约为每秒 304.6 token。(Artificial Analysis 模型档案) | 需要预留一段初始推理等待时间,但后续生成速度会很快。 |
| DeepMind 模型卡给出的知识截止时间为 2026 年 3 月,部分领域的知识截止时间为 2025 年 1 月。(Gemini 3.8 Flash 模型卡) | 处理时效性信息时,应使用搜索 grounding 或经过验证的检索结果。 |
| Computer use 仅处于 Preview 状态,开发者文档没有列出自托管选项,输出形式也不是图片、音频或视频,而是文本。(Google 开发者文档) | 如果业务需要这些能力,应保留独立的部署方案或模型兜底。 |
面向生产流量的低风险上线方案
- 选择 30–50 个能够代表生产流量的真实任务,其中包括长上下文案例和已知失败案例。
- 让 Gemini 3.8 Flash 分别以低、中、高 thinking levels 运行,并与当前模型进行对比。
- 记录总 token 数、缓存命中、工具调用轮次、重试次数、首 token 延迟、完成耗时、人工修正次数和任务接受率。
- 计算单个成功任务的成本,并将交互式流量与批处理流量分开统计。
- 在修改默认路由前,先让一小部分生产请求进入灰度测试。
- 如果额外推理没有改善已接受任务的成本,就让 Gemini 3.7 Flash 继续处理简单任务。
- 为 2027 年 1 月 1 日起每百万输入 token 1.50 美元、每百万输出 token 7.50 美元的价格做好预算。
第一次测试最好选择结果可核验的任务,例如带测试用例的多文件修改、答案已知的文档工作流,或带人工复核标签的多模态提取任务。
Gemini 3.8 Flash API 价格常见问题
Gemini 3.8 Flash 怎么收费?
Google 直接 API 的首发价格为每百万输入 token 0.75 美元、每百万输出 token 3.75 美元,持续到 2026 年 12 月 31 日。从 2027 年 1 月 1 日起,列出的价格将变为 1.50 美元和 7.50 美元。
Gemini 3.8 Flash 比 Gemini 3.7 Flash 更好吗?
在多项发布日的推理和智能体测试中,它的结果更强,其中包括 Artificial Analysis 高推理强度下 Intelligence Index 得分 59 对 56。但由于 3.8 可能生成更多输出 token,Gemini 3.7 Flash 在简单流量上的运营成本仍可能更低。
Gemini 3.8 Flash 适合编程智能体吗?
它是一个值得测试的候选模型,已报告的成绩包括 Terminal-Bench 2.1 的 89.4% 和 DeepSWE 1.1 的 73.7%。但它在 Terminal-Bench 4.0 上的成绩为 19.1%,因此长时程终端和桌面工作流仍需要单独评测。
Gemini 3.8 Flash 免费吗?
API 按列出的 token 价格收费。AI Studio 项目的当前条款,应与直接 API 价目表分开确认。
Gemini 3.8 Flash Cyber 是什么,谁可以使用?
Gemini 3.8 Flash Cyber 针对漏洞发现和自动修复进行了优化。Google 表示,Fairwind Program 会优先向可信防御方开放;它不是一个可以用普通 Gemini 3.8 Flash API key 访问的公共通用模型。
先在固定任务集上使用低或中等推理强度,测量每个已接受结果的成本;只有在更高推理强度能够避免可量化的失败时,再提高推理等级。