 AIREITER
百萬 Token 上下文,加上 $0 API 端點,乍看之下 Nemotron 3 Ultra 很適合直接當成預設選項。但實際情況沒這麼簡單:免費方案適合評估,真正上線時還得考慮供應商穩定性、資料處理方式,以及付費備援方案。
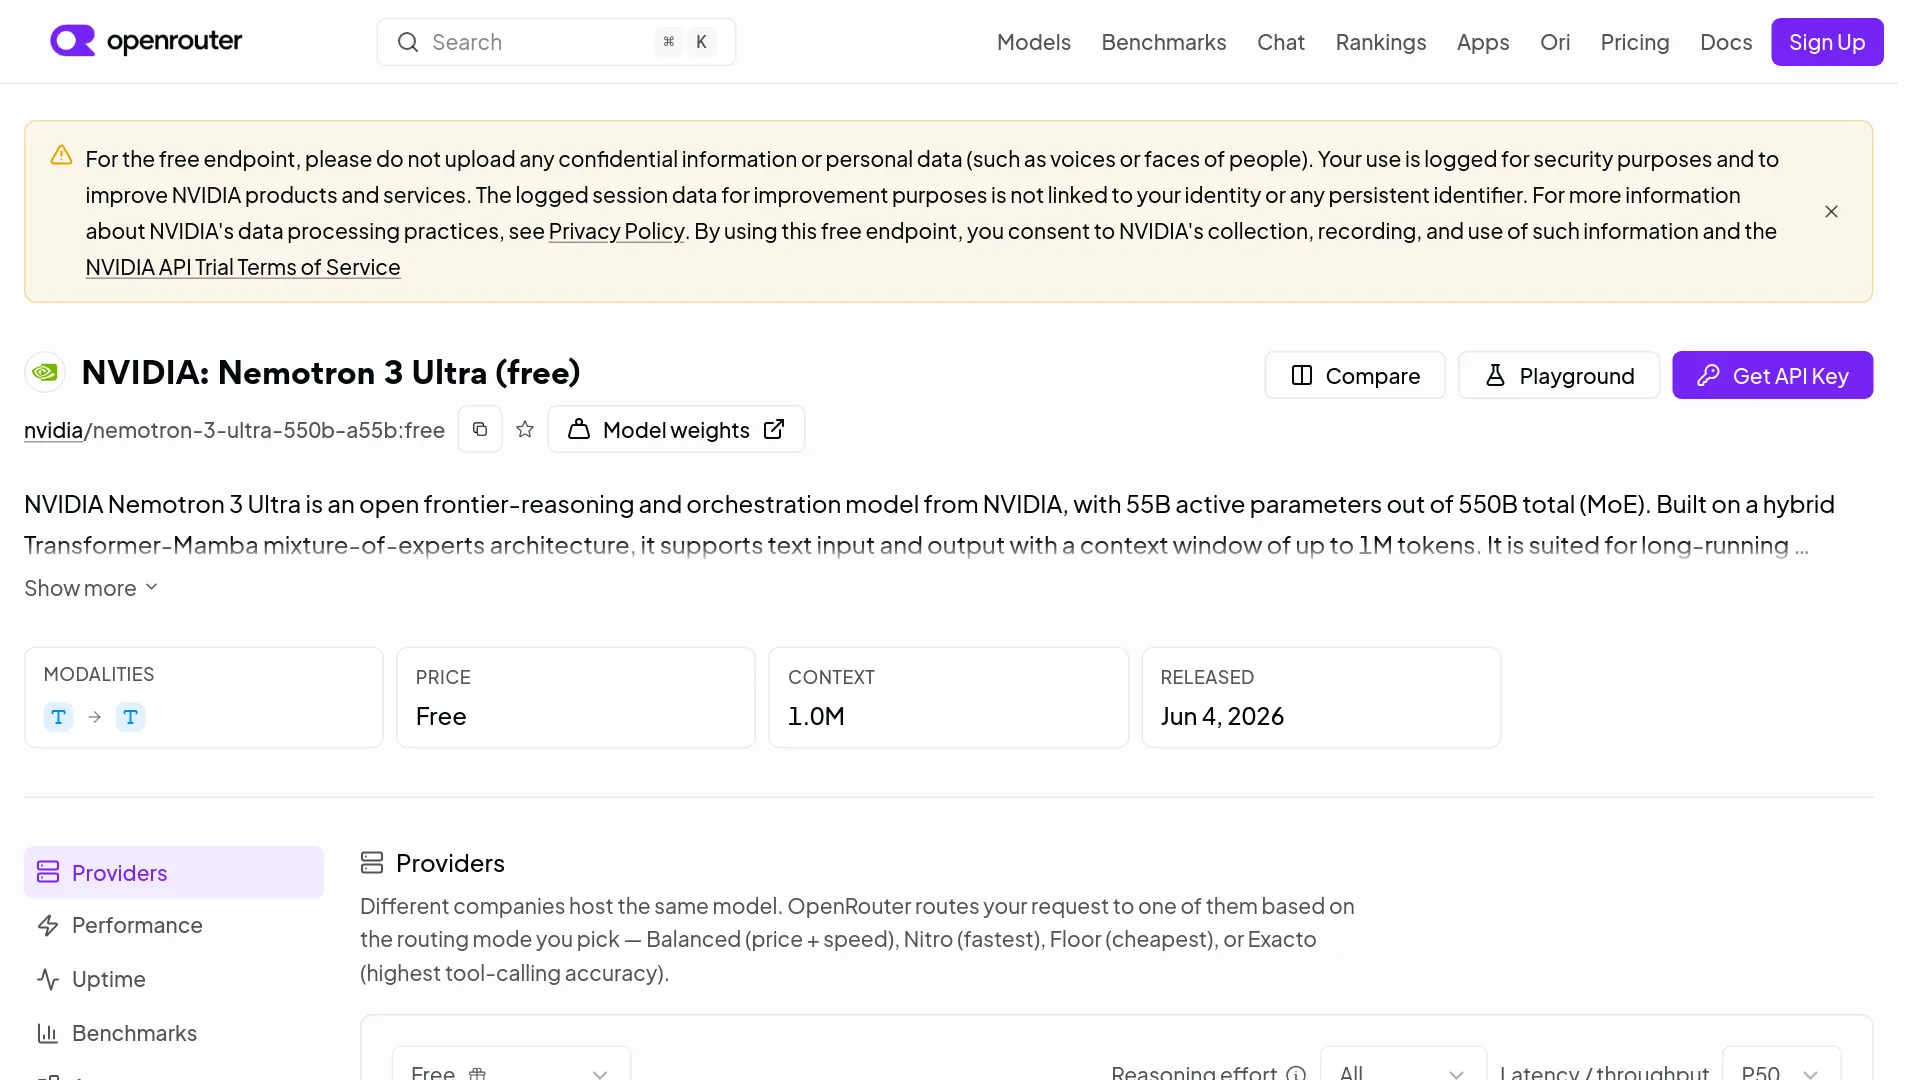
Nemotron 3 Ultra API 值得使用嗎?
如果你的工作涉及長時間運作的文字代理、大型文件分析,或需要超長上下文的程式開發流程,Nemotron 3 Ultra 值得拿來測試。不過,對於低延遲的日常聊天、在有記錄功能的免費端點上處理機密提示,或沒有備援方案的正式服務來說,它並不是理想的預設選擇。
NVIDIA 於 June 4, 2026 發表 Nemotron 3 Ultra。官方模型卡指出,NVFP4 checkpoint 為 version 1.0 GA,採用 OpenMDW 1.1 授權,可用於商業與非商業用途。
| 判斷重點 | 已確認數值 | 實際意義 |
|---|---|---|
| 模型規模 | 550B 總參數、55B 啟用參數 | 稀疏計算不代表完整權重很小 |
| 最大上下文 | 最高 1M tokens | 不同供應商路由可能設有更低限制 |
| 模態 | 文字輸入與輸出 | 不支援圖片或影片理解 |
| 官方 NVFP4 SWE-Bench Verified | 69.7 | 可作為程式開發代理評估的參考 |
| 官方 NVFP4 RULER 1M | 94.0 | 支持長上下文使用情境 |
| OpenRouter 免費價格 | $0 輸入、$0 輸出 | 適合試用,不代表有 SLA |
| OpenRouter 免費方案可用率快照 | 三天內成功率 84.07% | 能連線不代表每次都能正常使用 |
| 官方自行部署最低需求 | 4x B200-class 或 8x H100 | 不是一般工作站能負擔的部署方式 |
上表的基準測試數值來自 NVIDIA 模型卡,應視為原廠結果。OpenRouter 的可用率是會變動的供應商觀測值,不是永久保證。
五分鐘呼叫免費 Nemotron 3 Ultra API
最快的免費用法,是透過 OpenRouter 的 OpenAI 相容 Chat Completions 端點,搭配完整模型 ID nvidia/nemotron-3-ultra-550b-a55b:free。先建立 OpenRouter 金鑰,放進環境變數,再用小型請求測試,確認運作正常後才執行長上下文任務。
- 在 OpenRouter 建立 API 金鑰。
- 將金鑰匯出為
OPENROUTER_API_KEY。 - 使用免費模型 ID 呼叫
/api/v1/chat/completions。 - 評估期間記錄 HTTP 狀態、延遲,以及空白回應。
- 正式使用前,加入付費路由或其他模型作為備援。
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
    "messages": [
      {
        "role": "user",
        "content": "Return three risks in this migration plan as a numbered list."
      }
    ],
    "max_tokens": 500
  }'
使用 OpenAI Python client 時也能走同一個路由,只要修改 base_url 與 model:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="nvidia/nemotron-3-ultra-550b-a55b:free",
    messages=[
        {
            "role": "user",
            "content": "Inspect this plan and list the three highest-impact risks.",
        }
    ],
    max_tokens=500,
)

print(response.choices[0].message.content)
免費方案到底能保證什麼?
免費 Nemotron 3 Ultra 路由既不保證無限容量,也不保證正式環境可用。OpenRouter 清單標示免費端點會受到速率限制,但模型頁面沒有公布確切配額;其 September 19 快照顯示三天內可連線率為 100%,但成功可用率只有 84.07%,錯誤與空白回應都計為失敗。
在該快照中,OpenRouter 顯示 1M-token 上下文、65,536-token 最大完成長度、工具呼叫功能、2.28 秒中位延遲,以及每秒 29 tokens 的中位吞吐量。
此外,功能支援也會因供應商而異:OpenRouter 免費清單支援 tools 與 tool_choice,但不會強制套用 response_format。Segmind 的付費路由則在 每百萬輸入 tokens $0.625、每百萬輸出 tokens $2.75的方案中,提供 JSON Schema 輸出。若程式依賴嚴格 JSON,就必須直接測試選定的供應商,不能只根據基礎模型推定支援狀況。
不要透過 OpenRouter 免費路由傳送機密或個人資料。該清單說明,使用記錄會為了安全目的保存,也可能用於改善 NVIDIA 產品與服務。遇到 429、逾時或空白回應時,應採用有上限的指數退避,接著切換到付費路由;不要讓代理無限重試同一個動作。
550B A55B 在實務上代表什麼?
550B-A55B 的意思是,Nemotron 3 Ultra 總共儲存 5500 億個參數,但每個 Token 約啟用 550 億個參數。NVIDIA 將 LatentMoE routing、Mamba-2、特定注意力層與 Multi-Token Prediction 結合在一起。稀疏啟用能降低每個 Token 的計算量,但完整權重仍然必須儲存、分散到多張 GPU,或進行卸載;A55B 並不代表這是一個 55B 規模的部署。
NVIDIA 的研究發布頁面指出,模型上下文最高可達 1M tokens,並在一個相當特殊的工作負載上比較吞吐量:8,000-token 輸入加上 64,000-token 輸出。NVIDIA 宣稱其吞吐量是 GLM-5.1-754B-A40B 的 5.9 倍、Kimi-K2.6-1T-A32B 的 4.8 倍,以及 Qwen-3.5-397B-17B 的 1.6 倍。不過頁面沒有提供絕對吞吐量或硬體細節,因此不能把這些倍數直接換算成 API 延遲。
官方 BF16/NVFP4 表格更能幫助判斷部署方案:
| 基準測試 | BF16 | NVFP4 | 實務解讀 |
|---|---|---|---|
| SWE-Bench Verified | 71.9 | 69.7 | 在這項程式測試中,量化造成 2.2 分差距 |
| Terminal Bench 2.1 | 56.4 | 53.9 | 代理式終端工作同樣有所下降 |
| TauBench V3 average | 70.9 | 70.3 | 工具使用平均表現仍相當接近 |
| GPQA, no tools | 87.0 | 87.9 | NVFP4 並非在所有項目都較弱 |
| RULER 1M | 94.7 | 94.0 | 長上下文檢索能力仍接近 |
| OmniScience non-hallucination | 78.7 | 75.5 | 仍須重視事實正確性檢查 |
差異取決於任務:NVFP4 在 non-hallucination 測試中下降 3.2 分,但在 GPQA 上反而提升 0.9 分。
不要只看參數量,應該按任務選模型
Nemotron 3 Ultra 應該拿實際要上線的工作負載,與 DeepSeek V4、GLM 5.2 及 Qwen 3.8 Max 比較,而不是只看模型大小。本指南沒有採用同一套測試環境取得足以支持「誰是全面優勝者」的結果,因此最可靠的做法,是建立一套測試計畫,逐項確認各模型的能力邊界。
| 任務 | 建議先測 | 選擇前的依據與測試 |
|---|---|---|
| 百萬 Token 檢索或文件綜合 | Nemotron 3 Ultra | 官方 NVFP4 RULER 1M 為 94.0;以實際提示長度測試檢索準確率與 prefill 延遲 |
| 長時間運作的程式開發代理 | Nemotron 3 Ultra 或 DeepSeek V4 | Nemotron 在 SWE-Bench Verified 得分 69.7,在 Terminal Bench 2.1 得分 53.9;使用同一套測試環境比較儲存庫任務成功率與工具呼叫有效性 |
| 結構化輸出自動化 | GLM 5.2、Qwen 3.8 Max,或支援 schema 的 Nemotron 供應商 | OpenRouter 免費方案不會強制套用 response_format;應在確定的路由上測量 schema 遵循率與重試次數 |
| 大量短請求 | DeepSeek V4、GLM 5.2 或 Qwen 3.8 Max | 比較每個成功任務的成本與 p95 延遲;Ultra 的規模不會自動帶來優勢 |
| 使用 NVIDIA 硬體的開放權重部署 | Nemotron 3 Ultra | 在目標任務上比較 BF16 與 NVFP4,再計算持續運作時的利用率 |
DeepSeek V4 與 GLM 5.2 在 AIReiter 上都有專用 API,Qwen 3.8 Max 則以託管聊天模型形式提供:DeepSeek V4 Pro API guide、GLM 5.2 API review,以及 Qwen 3.8 Max API pricing。這些是用來評估的替代方案,不代表其中某個模型在所有任務上都勝出。
Nemotron 3 Ultra 能在本機執行嗎?
Nemotron 3 Ultra 可以自行託管,但這裡的「本機」指的是資料中心硬體或 DGX Station,不是筆電。NVIDIA 列出的標準部署最低配置為 4x GB200、4x B200、4x GB300、4x B300,或 8x H100。
NVIDIA 模型卡中的官方 vLLM 範例使用 4-way tensor 與 expert parallelism、FP8 KV cache、chunked prefill,以及 MTP speculative decoding。標準範例預設為 262,144 tokens;若要啟用 1,048,576 tokens,必須明確覆寫設定。因此,官方標示的上下文上限並不是預設服務配置。
NVIDIA 也提供特殊的單台 DGX Station 部署方式。這個方案在一顆整合式 GB300 GPU 上執行 NVFP4 checkpoint,透過提供最高 150 GiB 的一致性 CPU 記憶體來卸載專家權重。該做法需要 vLLM 0.22.0、針對 Blackwell 的 NVFP4 backend,以及 DGX Station 的記憶體架構,不能直接套用到一般單 GPU 電腦。
| 部署方式 | 適合情況 | 主要限制 |
|---|---|---|
| OpenRouter 免費 API | 評估提示與工具行為 | 速率限制、記錄功能,以及不穩定的可用率 |
| 付費託管 API | 在使用量足以支撐硬體前先上線 | 供應商在價格、精度、上下文與功能上可能有所不同 |
| 4x B200-class / 8x H100 自行託管 | 需要持續處理大量流量、資料控管或模型客製化 | 資本成本與分散式推論維運 |
| 單台 GB300 DGX Station 搭配卸載 | 你擁有完全相同的一致性記憶體系統 | 卸載延遲與硬體專屬性 |
Nemotron 3 Ultra API 常見問題
Nemotron 3 Ultra API 免費嗎?
是。OpenRouter 將 nvidia/nemotron-3-ultra-550b-a55b:free 的輸入與輸出 Token 都列為 $0,但該端點有速率限制,而且會記錄使用情況。
Nemotron 3 Ultra 真的支援一百萬 Token 嗎?
NVIDIA 指定的最大上限為 1M tokens,但不同供應商路由可能提供更低的預設值;NVIDIA 的 vLLM 範例預設為 262,144 tokens,除非操作者啟用 1,048,576。
API 支援工具與結構化 JSON 嗎?
模型支援工具,但是否強制套用結構化輸出取決於供應商:OpenRouter 免費方案不會強制執行 response_format,而 Segmind 則提供嚴格 JSON Schema 的文件說明。
我可以將 Nemotron 3 Ultra 用於商業用途嗎?
NVIDIA 表示,OpenMDW 1.1 授權允許商業與非商業用途。若涉及重新發布與部署義務,請查閱官方模型卡所連結的授權條款。
可以關閉推理嗎?
NVIDIA API 文件提供 enable_thinking=True/False。託管供應商可能以不同方式對應這項控制,因此請確認所選路由接受的參數,以及 Token 計算方式。
550B A55B 等同於密集型 55B 模型嗎?
不等同。每個 Token 約有 55B 參數會被啟用,但完整的 550B 參數仍然必須儲存、分散或卸載。
這是部署決策,不是基準測試獎盃
最適合的第一步,是使用非敏感提示與小型評估集測試免費 Nemotron 3 Ultra API。當錯誤率、schema 強制執行或可預期的容量開始變得重要時,再轉向付費端點;只有在實測利用率、隱私或客製化需求足以證明至少四張目前的高記憶體 GPU,或符合文件所述的 DGX Station 路徑值得投入時,才應考慮自行託管。
| 測試後的結果 | 下一步 |
|---|---|
| 品質不錯,但免費請求經常失敗或排隊 | 加入付費 Nemotron 路由與重試策略 |
| 長上下文檢索是主要優勢 | 測試最大的實際文件,並測量 prefill 時間 |
| 主要問題是 JSON 輸出失敗 | 改用支援 schema 強制執行的供應商,或比較 GLM/Qwen 路由 |
| 短任務的成本或延遲最重要 | 優先使用較小模型,將 Ultra 留給需要升級處理的請求 |
| 資料不能離開你的網路 | 在確定採用前,先編列官方多 GPU 部署的預算 |