 AIREITER
DeepSeek 在 2026 年 8 月 13 日正式推出 V4 Pro GA,公開了完整基準測試成績、採 MIT 授權的開放模型權重,並加入三種推理強度設定。對 API 使用者來說,最需要留意的是官方定價頁面已確認:自 2026 年 8 月 16 日 16:00 UTC 起,將改採尖峰/離峰計費。V4 Pro 的輸出 token 單價,將從每百萬 $0.87,上調至離峰 $1.98、尖峰 $3.96。
V4-Pro-0813 正式版上線:規格、跑分與開放權重一次到位
deepseek-v4-pro API 別名目前對應的模型已更新為 DeepSeek-V4-Pro-0813,可透過 DeepSeek App、網頁版及 API 使用。DeepSeek 於 8 月 13 日宣布推出此版本,並表示相較於 4 月 24 日的預覽版,其 Agent 能力已有顯著提升。
架構與核心規格:
| 項目 | DeepSeek-V4-Pro-0813 |
|---|---|
| 公開模型規模 | 1.7T 參數(模型卡;預覽版為 1.6T) |
| 上下文長度 | 100 萬 token |
| 最大輸出長度 | 384K token |
| 思考模式 | 非思考與思考模式,預設為思考模式 |
| 推理強度 | low、high、max |
| 新增解碼模組 | DSpark speculative decoding(7 個 speculative token) |
| API 相容性 | OpenAI ChatCompletions、Responses API、Anthropic API、Codex |
| 並發限制 | 500 |
| 授權條款 | MIT |
模型卡建議 Agent 類場景採用 temperature = 1.0 與 top_p = 0.95。在 high 及 max 推理強度下,最大輸出長度可達 384K token。
官方公布的 GA 基準測試
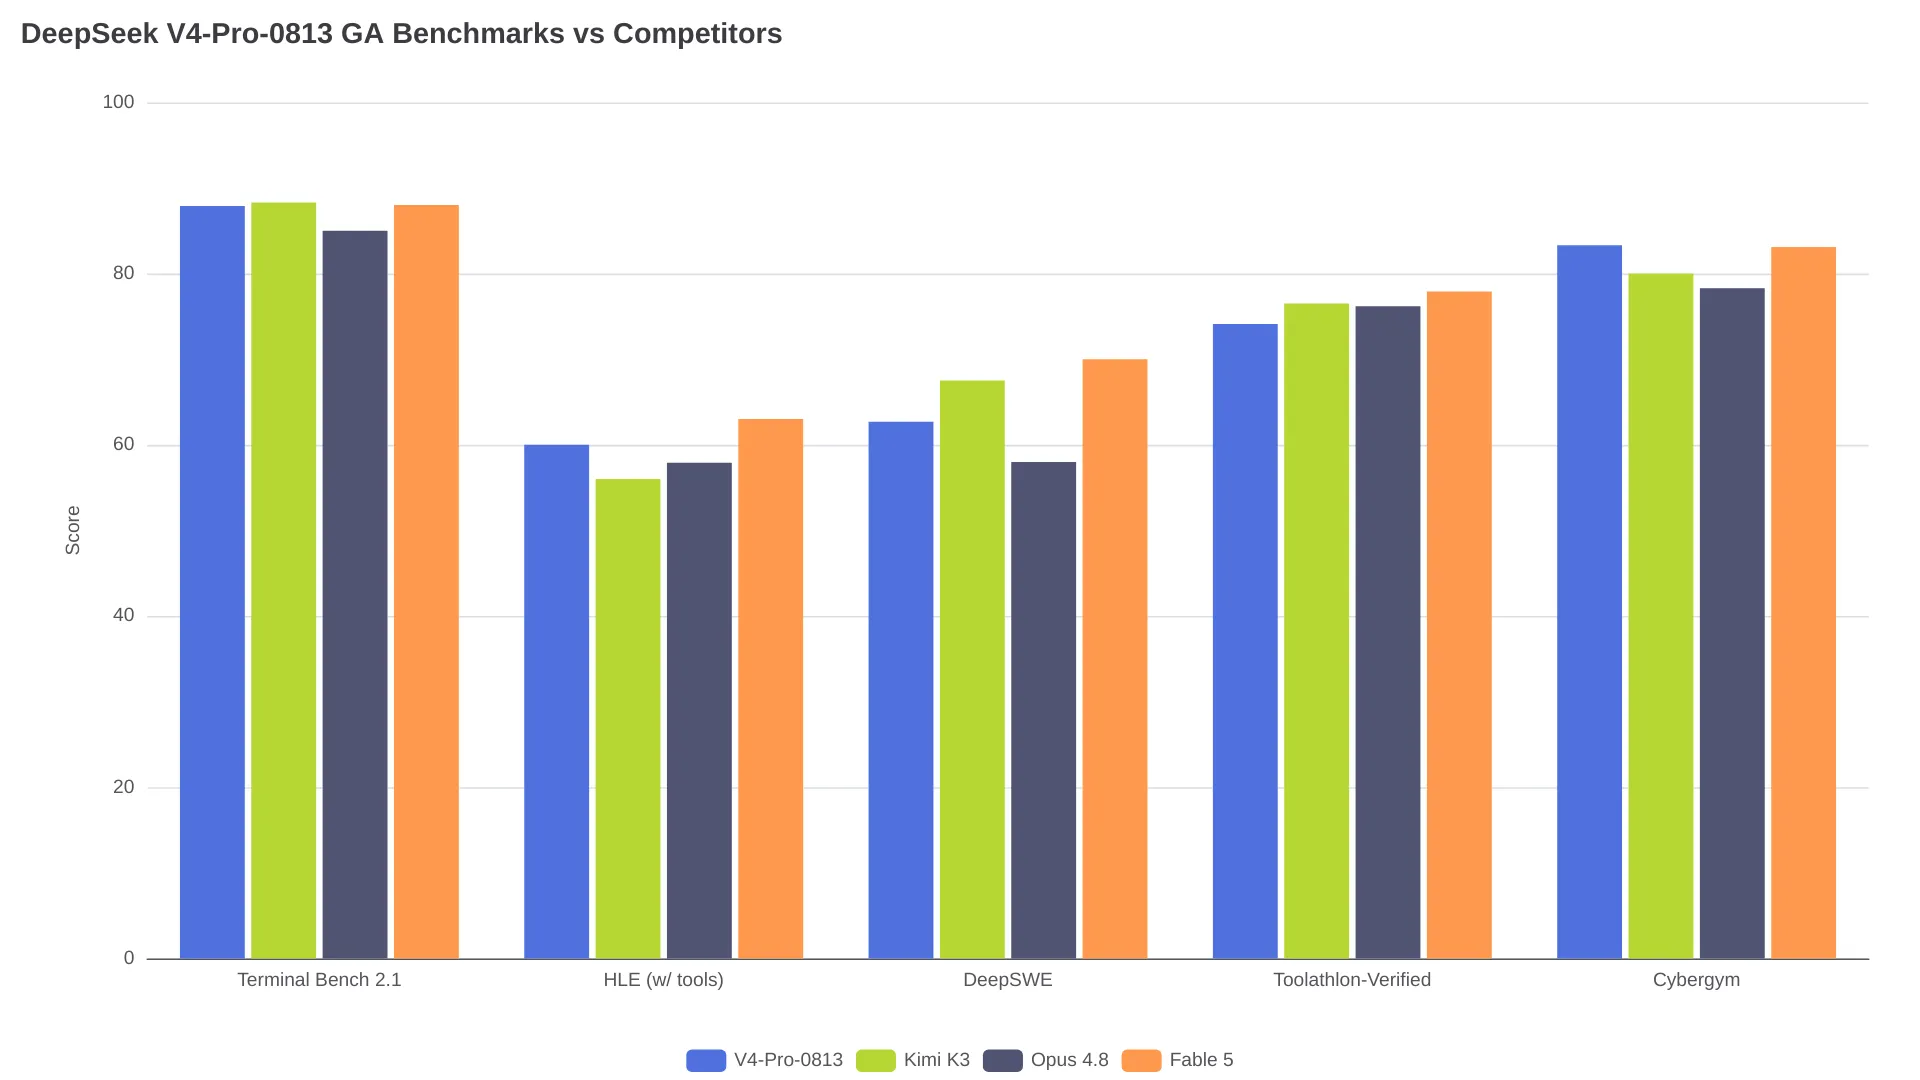
DeepSeek 在模型卡中公開了 10 項基準測試比較。程式碼 Agent 任務使用 DeepSeek Harness minimal mode,推理強度設為 max。最後兩列 DSBench 為 DeepSeek 內部測試集;以下分數皆取自該模型卡。
| 基準測試 | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE(無工具/有工具) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench(公開) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack(內部) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard(內部) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
相較於預覽版,GA 版進步幅度相當明顯:DeepSWE 從 12.8 升至 62.7,AutomationBench 則從 12.8 提升到 31.8。與競品相比,Pro-0813 在有工具的 HLE 項目拿下 60.0,高於 Kimi K3 的 56.0 與 Opus 4.8 的 57.9;但在 DeepSWE、Terminal Bench 及 Toolathlon-Verified,仍落後 Kimi K3 和 Fable 5。DSBench 兩項則是廠商內部基準,不宜與獨立維護的測試同等看待。
MIT 授權開放權重
0813 權重已在 Hugging Face 上線,採 MIT 授權,可透過 vLLM 與 SGLang 部署。模型卡也提供 vLLM 服務範例,使用 DSpark speculative decoding、FP8 KV cache,以及單一 4x GB300 節點。
「與目前最強的專有模型整體上具備廣泛競爭力。」—— DeepSeek V4-Pro 模型卡,Hugging Face
8 月 16 日起的完整費率:目前價格與尖離峰價格差多少?
定價頁面同時列出目前統一費率,以及自 2026 年 8 月 16 日 16:00 UTC 生效的尖峰/離峰費率。尖峰時段為 01:00–04:00 UTC 與 06:00–10:00 UTC,即北京時間 09:00–12:00 與 14:00–18:00;其餘時間均為離峰。離峰價格正好是尖峰的一半。
DeepSeek V4 Pro(DeepSeek-V4-Pro-0813)
| 計費項目 | 目前統一費率 | 離峰(8 月 16 日起) | 尖峰(8 月 16 日起) | 尖峰漲幅 |
|---|---|---|---|---|
| 輸入,快取命中 | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| 輸入,快取未命中 | $0.435/M | $0.66/M | $1.32/M | +203% |
| 輸出 | $0.87/M | $1.98/M | $3.96/M | +355% |
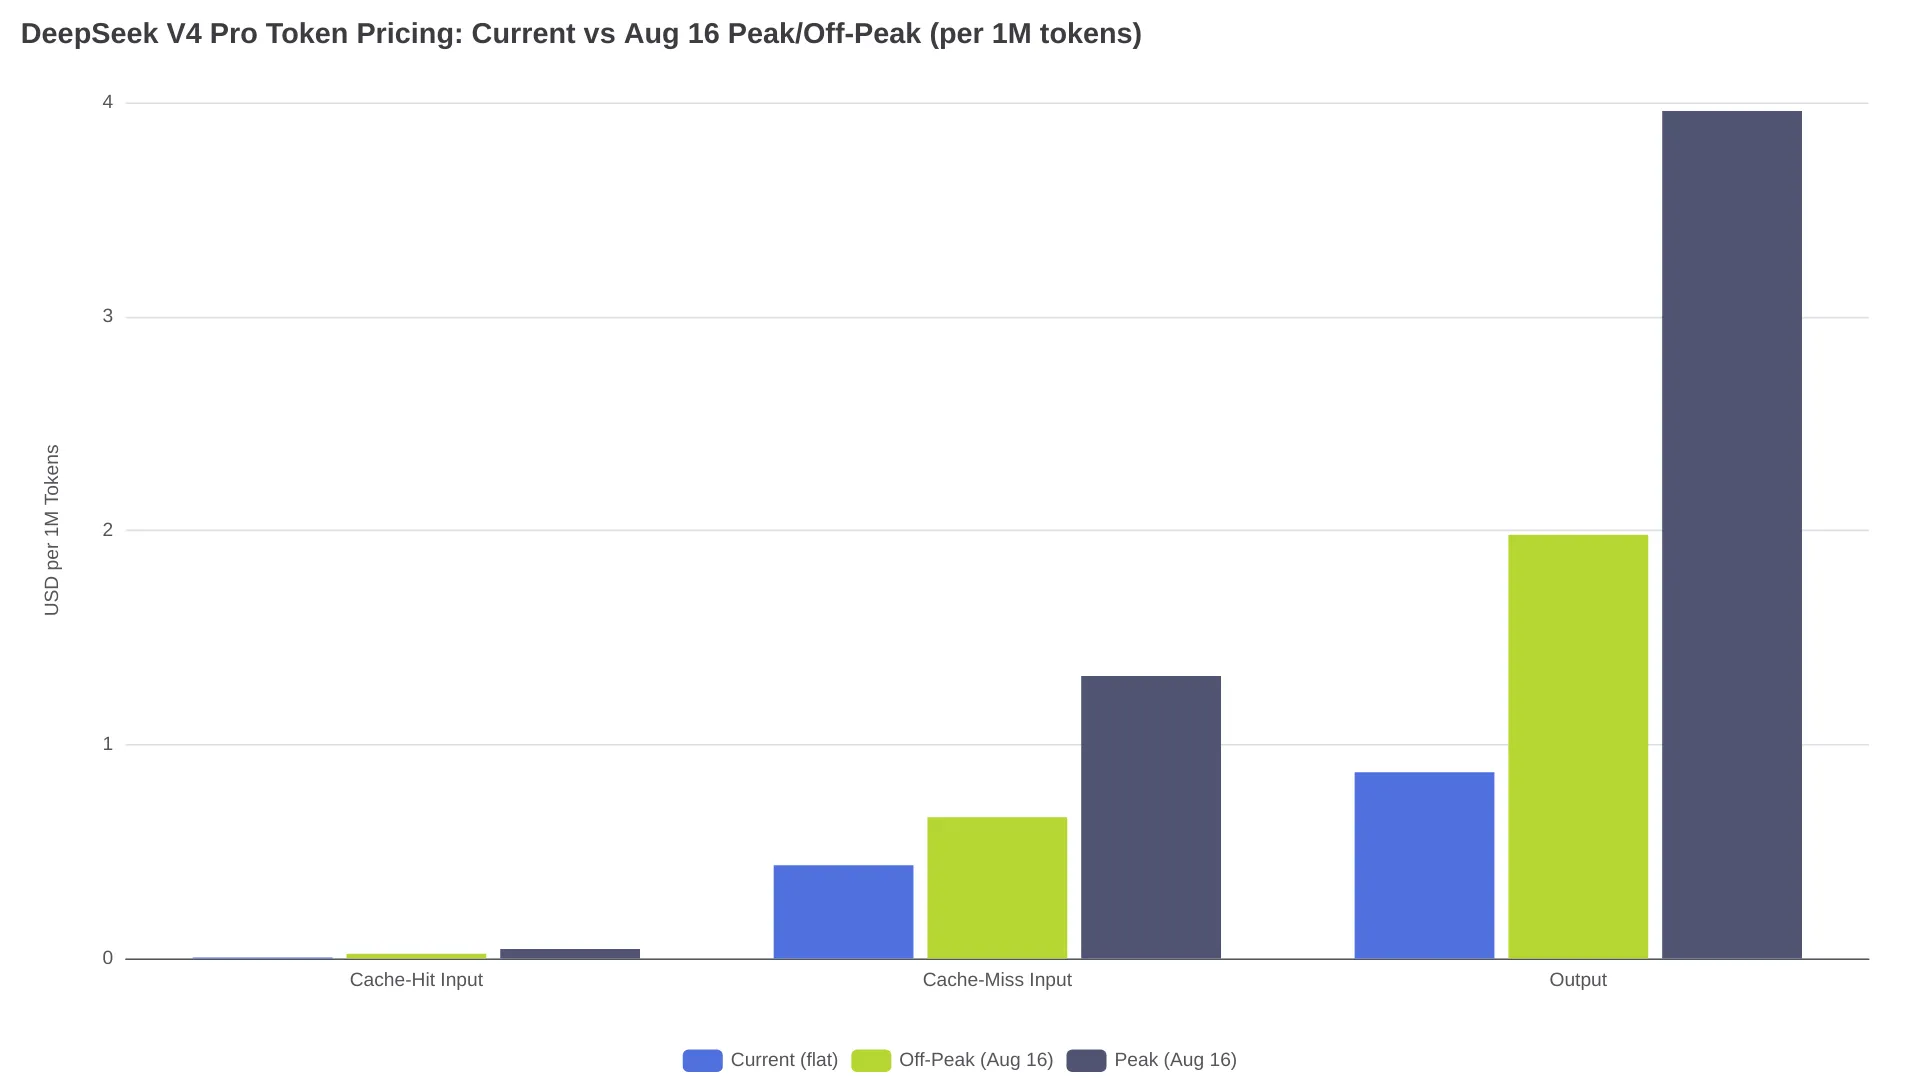
尖峰時段的輸出價格上漲至原本的 4.6 倍。對正式環境中的 Agent 工作流而言,更具影響的是快取命中費率:原先的 $0.003625/M 約比快取未命中便宜 120 倍;8 月 16 日後,兩種時段的價差都縮小為 30 倍,離峰為 0.022 對 0.66,尖峰則是 0.044 對 1.32,而快取命中的絕對成本也上升 6 至 12 倍。
DeepSeek V4 Flash(DeepSeek-V4-Flash-0731)
| 計費項目 | 目前統一費率 | 離峰(8 月 16 日起) | 尖峰(8 月 16 日起) | 尖峰漲幅 |
|---|---|---|---|---|
| 輸入,快取命中 | $0.0028/M | $0.007/M | $0.014/M | +400% |
| 輸入,快取未命中 | $0.14/M | $0.22/M | $0.44/M | +214% |
| 輸出 | $0.28/M | $0.66/M | $1.32/M | +371% |
並發限制為2,500 個並發請求,是 Pro 配額的五倍。
各地時區的尖峰時段
| 時區 | 尖峰區間 1 | 尖峰區間 2 |
|---|---|---|
| 北京(UTC+8) | 09:00–12:00 | 14:00–18:00 |
| 倫敦(UTC+1) | 02:00–05:00 | 07:00–11:00 |
| 紐約(UTC-4) | 21:00–00:00(前一天) | 02:00–06:00 |
| 舊金山(UTC-7) | 18:00–21:00 | 23:00–03:00 |
對美國團隊而言,尖峰多半落在夜間與傍晚;中國及東亞團隊則會直接碰上一般上班時段。
每天 10,000 次呼叫,V4 Pro 要花多少錢?
假設一個正式環境 Agent 每次呼叫都送出 50K token 的快取前綴,並產生 2K token 回覆。
| 成本項目 | 目前統一費率 | 離峰 | 尖峰 |
|---|---|---|---|
| 快取命中輸入(500M token) | $1.81 | $11.00 | $22.00 |
| 輸出(20M token) | $17.40 | $39.60 | $79.20 |
| 每日合計 | $19.21 | $50.60 | $101.20 |
| 30 日合計 | $576 | $1,518 | $3,036 |
實際工作負載通常會混合尖峰與離峰呼叫,因此成本會落在兩者之間。同樣的負載若改用 Flash,目前統一費率下為每日 $7.00,離峰約 $16.70,尖峰約 $33.40。Flash 尖峰成本 $33.40/日高於 Pro 目前的統一費率 $19.21/日,但 Flash 離峰的 $16.70/日仍低於後者。
遷移重點:模型 ID、推理控制與版本鎖定
舊端點退役與替代模型 ID
4 月 24 日的預覽公告指出,deepseek-chat 與 deepseek-reasoner 會在「2026 年 7 月 24 日 15:59(UTC)後完全退役且無法存取」。程式碼中若仍使用這些字串,應盡快更新。
| 舊端點 | 實際路由模型 | 替代方案 |
|---|---|---|
deepseek-chat | V4 Flash,非思考模式 | deepseek-v4-flash |
deepseek-reasoner | V4 Flash,思考模式 | deepseek-v4-flash(思考模式)或 deepseek-v4-pro |
不少團隊以為 deepseek-reasoner 提供的是 Pro 等級推理能力,但它實際上路由至思考模式的 Flash。改遷移至 deepseek-v4-pro 後,輸出品質與帳單金額都會有所不同。
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
Base URL 維持 https://api.deepseek.com 不變,請求結構也無須其他調整。
推理強度怎麼選
V4-Pro-0813 新增三種推理強度:low 適合簡單任務,high 適合日常 Agent 工作,max 則面向複雜問題。思考模式預設開啟,且思考 token 也會計入輸出費用。假如一段提示先產生 3,000 個思考 token,最後才輸出 200 token 答案,尖峰價格下會按 3,200 個輸出 token 計費,每次為 $0.0127;若只計最終答案,則僅為 $0.0008。DeepSeek 將 low 定位為簡單任務的設定,適合避免延伸思考徒增成本卻無實際效益。
版本鎖定
deepseek-v4-pro 是指向目前版本的別名,DeepSeek 日後推出新版時可能更新其指向。若正式環境需要可重現的行為,應確認所用供應商是否支援帶日期的模型識別碼。部分第三方閘道提供固定版本路由;在正式採用前,請先查閱供應商文件,確認各路由實際服務的模型版本。
API 協定相容性
兩款模型皆支援 OpenAI ChatCompletions 與 Anthropic API 格式。Anthropic 端點為 https://api.deepseek.com/anthropic。Responses API 與 Codex 相容性則是 GA 版本新增項目;如果遷移後遇到錯誤,建議兩種協定路徑都進行測試。
漲價後該選 Pro 還是 Flash?
V4-Pro-0813 在 10 項公開指標上均優於 V4-Flash-0731,但優勢幅度會隨任務複雜度而異:
| 基準測試 | Pro 0813 | Flash 0731 | 差距 |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 分 |
| DeepSWE | 62.7 | 54.4 | 8.3 分 |
| AutomationBench | 31.8 | 25.1 | 6.7 分 |
| Cybergym | 83.3 | 76.7 | 6.6 分 |
適合選 V4 Pro 的情況:
- Agent 迴圈會重複傳送固定且大型的前綴內容;雖然基礎費率提高,快取命中節省仍然有效
- 複雜推理、多步工具使用或大規模程式碼生成,需要 Pro 較大的參數規模
- 工作負載可接受 500 個並發請求的限制
適合選 V4 Flash 的情況:
- 任務較簡單、請求量高,或對延遲敏感
- 扇出型工作負載需要 2,500 個並發請求的上限
- 品質差距不足以合理化高出 3 倍的輸出價格
想進一步比較兩款模型,可參考我們的 DeepSeek V4 Flash vs Pro comparison。若想先試用模型而不管理 API 金鑰,V4 Pro chat page 與 V4 Flash chat page都可立即使用。
常見問題
V4-Pro-0813 權重可自行部署嗎?
可以。模型採 MIT 授權,已在 Hugging Face 提供下載,並支援 vLLM 與 SGLang 部署路徑;部署細節可參考上方的開放權重段落。
GA 版推出後,該從 V4 Flash 改用 V4 Pro 嗎?
對多數重視成本的工作負載來說,Flash 依然更划算。各項基準中,它與 Pro 的落差從 Agents' Last Exam 的 0.5 分,到有工具 HLE 的 8.5 分不等,但輸出價格僅為後者的三分之一。只有在複雜多步推理或大規模程式碼生成確實需要完整參數規模時,才建議改用 Pro。
如何降低漲價帶來的影響?
可從三個方向著手:將批次作業與可延後執行的 Agent 排到尖峰外,也就是 01:00–04:00 與 06:00–10:00 UTC;盡量保持提示前綴穩定以提高快取命中率;簡單任務則改路由到 Flash,或在 Pro 使用 low 推理強度。
尖峰/離峰計費也適用於 DeepSeek App 與網站嗎?
官方定價頁面記載的是 API token 計費。列出的時段適用於直接 API 呼叫;閘道供應商可能會照轉、加價,或採用不同費率。最新資訊請查看定價頁面。