 AIREITER
如果你的 AI Agent 每次都把工具呼叫、結果驗證、格式整理這類例行工作交給高階推理模型,成本很快就會失控。NVIDIA 推出的 Nemotron 3.5 Lightning,正是為這種場景而設計:它是一款總參數量 30B、每個 token 僅啟用 3B 參數的 mixture-of-experts 模型,主打最高 4 倍的 token 生成速度。不過,NVIDIA 自家的基準測試也顯示,它在 12 項可比較測試中有 11 項落後 Qwen 3.6 35B-A3B;它的定位從來不是追求最高推理能力,而是以更快、更省的方式處理 Agent 流程中大量重複的執行步驟。要注意的是,完整精度的 BF16 權重需使用 80 GB GPU,NVIDIA 也建議正式環境採用 NVFP4 checkpoint。
Nemotron 3.5 Lightning 的架構有何不同?
Nemotron 3.5 Lightning 採用 NVIDIA 標示為 nemotron_h 的混合式架構,交錯整合 Mamba-2 狀態空間層、MoE 路由與選擇性的注意力層。Mamba-2 可降低長上下文注意力機制帶來的記憶體與運算負擔,因此 Lightning 能支援 1M token 上下文長度;根據 model card 說明,單張 H100 80GB 實務上限為 256K。相較於純注意力模型,這避免了上下文愈長、成本以平方成長的問題。
| 規格 | 數值 |
|---|---|
| 總參數量 | 30B |
| 每個 token 啟用參數量 | 3B |
| 架構 | Mamba-2 + MoE + Attention 混合架構 |
| 上下文長度 | 最高 1M tokens(單張 H100 為 256K) |
| 精度選項 | BF16、NVFP4 |
| 授權 | OpenMDW v1.1(可商業使用) |
| 支援語言 | 英文、西班牙文、法文、德文、義大利文、日文與程式碼 |
| 預訓練語料 | 20T+ tokens |
| 推理模式 | 可透過 chat template 的 enable_thinking 切換 |
| 建議取樣設定 | Temperature 1.0、top-p 0.95 |
NVIDIA 將 Lightning 定位為 Nemotron 3 系列中規模最小的成員,並且專門針對 Agent harness 行為訓練,包括工具呼叫、輸出驗證、結果格式化與子 Agent 委派。複雜規劃交給 Nemotron 3 Ultra 這類前沿推理模型,Lightning 則負責日常執行,避免這些工作不必要地消耗高階模型的 token 預算。
跑分表現:Lightning 擅長什麼,又輸在哪裡?
HuggingFace model card 公開了 14 組基準測試數據,將 Lightning 與 Qwen 3.6 35B-A3B、Gemma 4 26B-A4B、Nemotron 3 Nano/Super 及 GPT-OSS 20B 進行比較。以下列出最值得作為選型依據的 10 項:
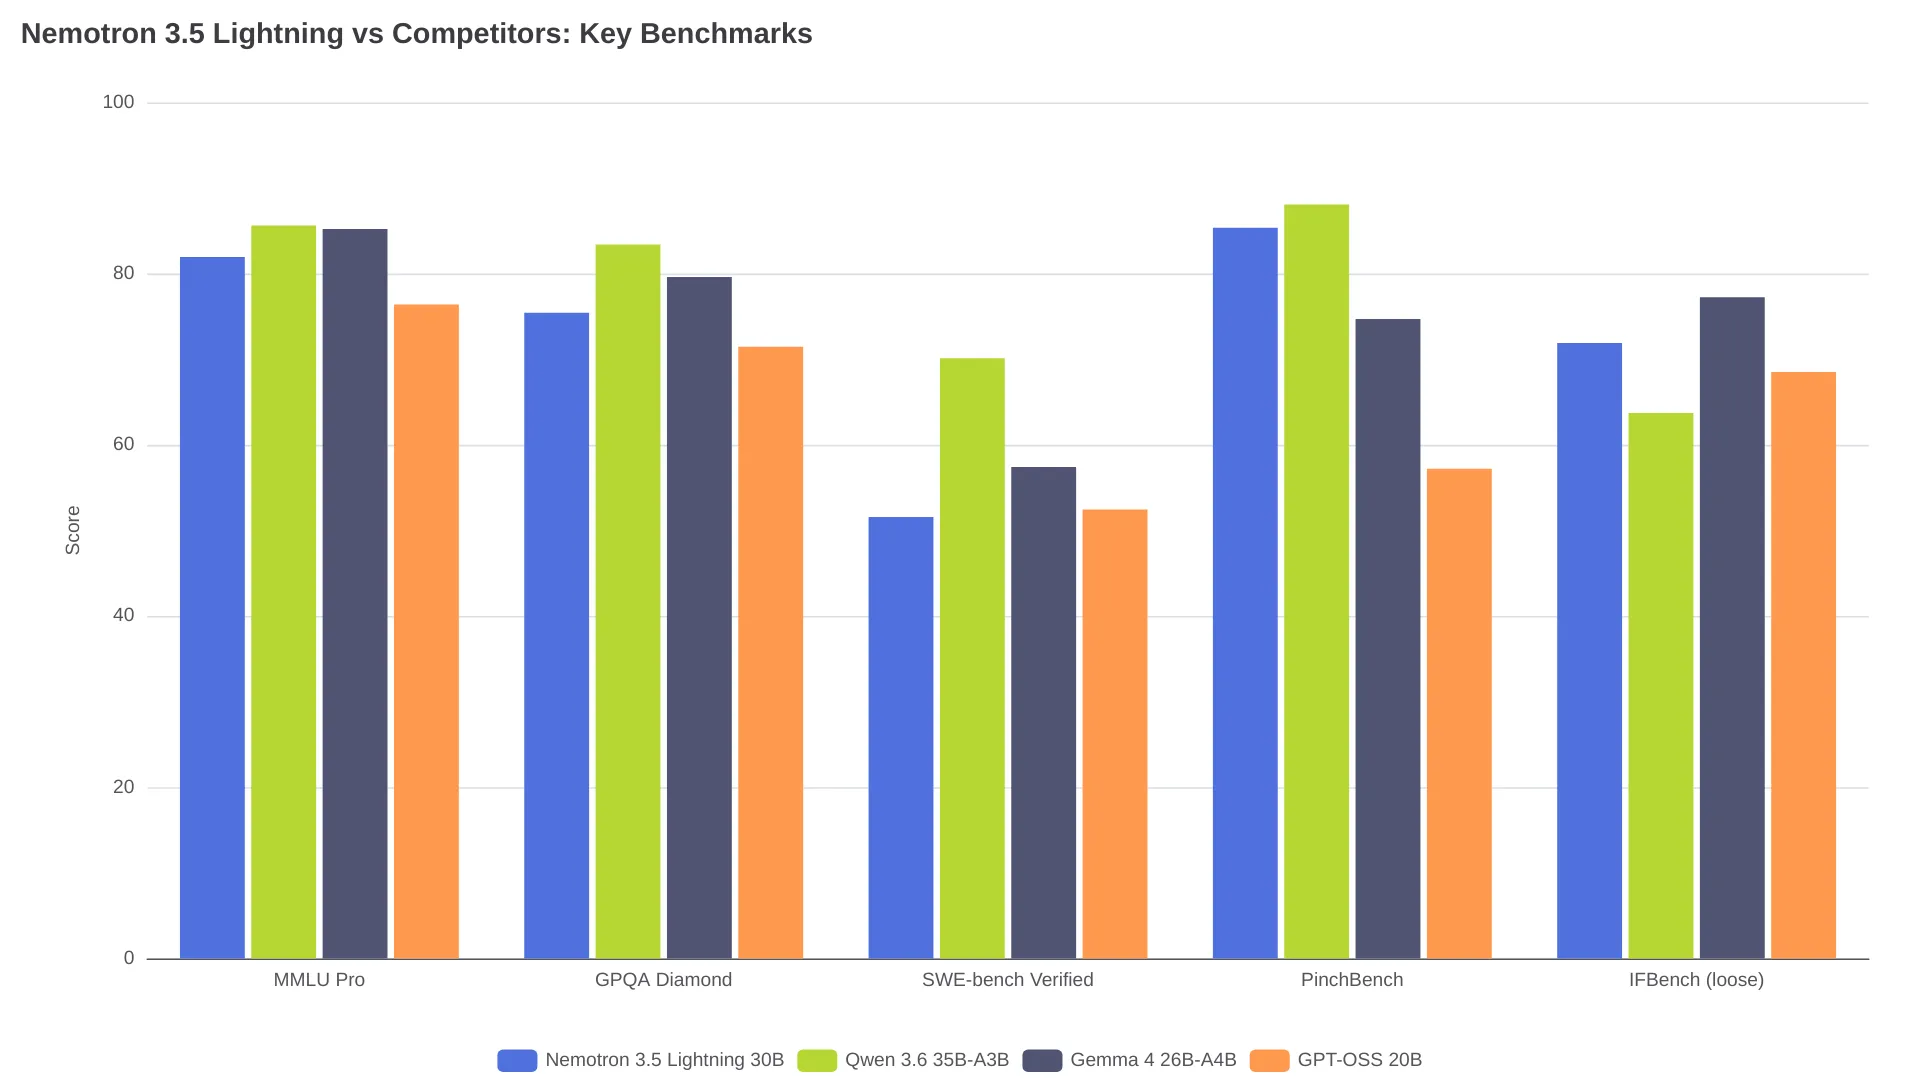
| 基準測試 | Nemotron 3.5 Lightning | Qwen 3.6 35B-A3B | Gemma 4 26B-A4B | GPT-OSS 20B |
|---|---|---|---|---|
| MMLU Pro | 81.94 | 85.63 | 85.20 | 76.40 |
| GPQA Diamond(無工具) | 75.44 | 83.40 | 79.61 | 71.46 |
| SWE-bench Verified | 51.56 | 70.12 | 57.40 | 52.44 |
| SWE-bench Multilingual | 39.33 | 63.40 | 43.40 | 41.93 |
| Terminal-Bench 2.1 | 24.58 | 44.38 | 37.22 | 15.17 |
| PinchBench | 85.37 | 88.07 | 74.70 | 57.20 |
| BrowseComp | 36.97 | 48.74 | 26.30 | - |
| IFBench(寬鬆模式) | 71.88 | 63.71 | 77.25 | 68.50 |
| AA-LCR | 52.00 | 61.06 | 57.56 | 32.88 |
| SciCode | 32.60 | 35.33 | 40.28 | 38.63 |
在 12 項可直接比較的結果中,Lightning 有 11 項落後 Qwen 3.6 35B-A3B。唯一的例外是 IFBench,也就是寬鬆模式下的指令遵循測試:Lightning 拿下 71.88 分,Qwen 為 63.71 分,領先 8 分。這也符合它面向 Agent 執行的定位:處理工具呼叫格式與輸出驗證時,嚴格遵從指令往往比純粹的推理上限更重要。
真正拉開差距的是速度。NVIDIA 的 PinchBench 評測,以 H100 GPU-hours 衡量 10,000 個 Agent 任務:Lightning 以約 16.5 GPU-hours 完成,準確率為 86%;Qwen 3.6 35B 約需 23.5 至 24 GPU-hours,準確率 87%;Gemma 4 26B 則需 25 至 26 GPU-hours,準確率為 73%。
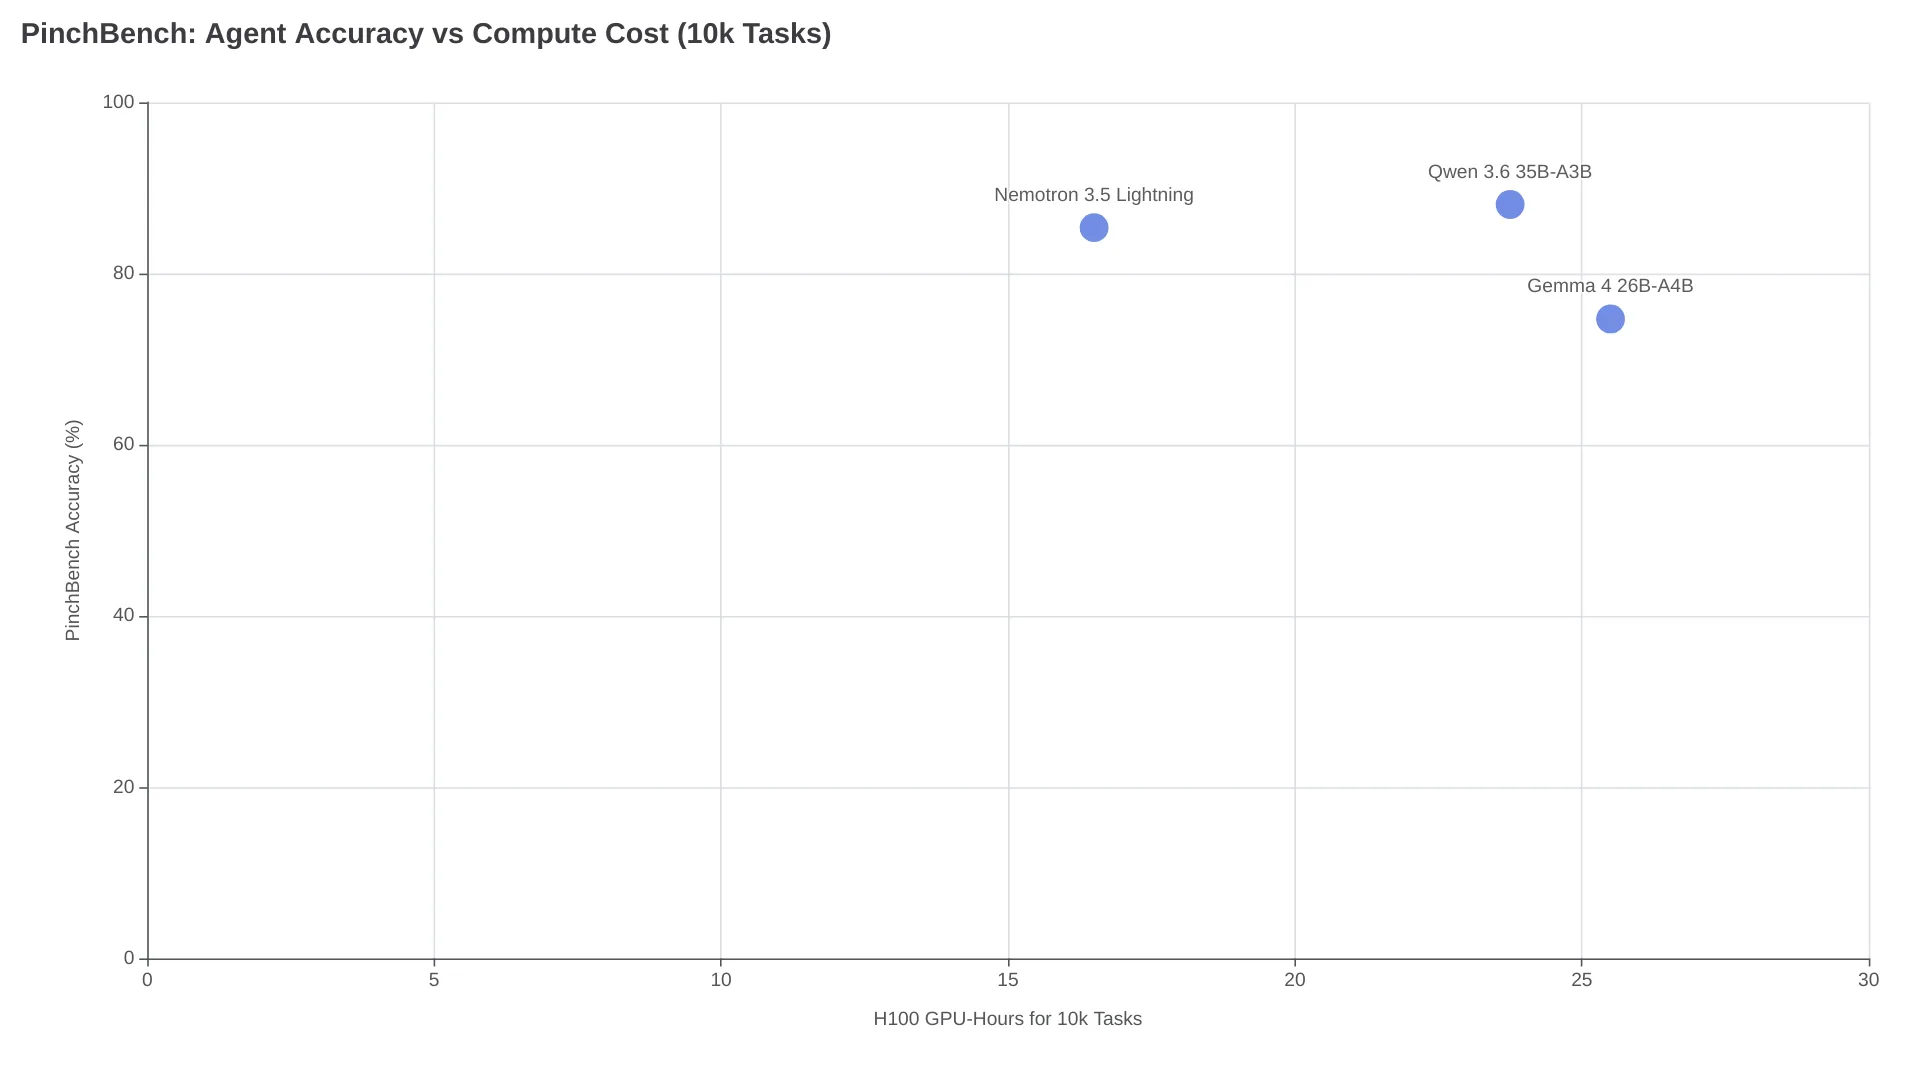
換句話說,Lightning 在近乎相同準確率下,約可節省 30% 運算量。若你要執行 10,000 個 Agent 步驟、並按 GPU 時數付費,這個差距相當實在。NVIDIA 另指出,Lightning 在 Artificial Analysis leaderboard 上的輸出速度約為 670 tokens/second,Intelligence Index 約為 23 至 24 分,讓它進入總參數低於 40B 的開放權重模型 Pareto 前緣。
r/LocalLLaMA 社群測試也得出相近的速度結論。一名 DGX Spark 使用者回報,NVFP4 checkpoint 在僅 target 模式下達到 78.5 tokens/second,開啟 speculative decoding 後為 90.7 tokens/second。另一名參與主要討論串的使用者認為,Lightning 品質介於 Gemma 4 26B 與 31B 之間,但更接近 26B;它的執行速度約為 Gemma 31B 的 2 倍,但會產生大量 thinking tokens,實務上可能抵銷部分速度優勢。早期的 GGUF Q4 轉換版本檔案約為 25 GB,並出現 unused-tensor 警告,意味著混合式 Mamba-2 架構可能尚未獲所有 GGUF 工具完整支援。
硬體需求與本機部署選項
BF16 checkpoint 是完整精度的參考權重,單卡部署需要 1x H100 80GB 或 1x A100 80GB,其分片 safetensors 檔案為 65.8 GB。NVIDIA 明確建議正式推論環境改用獨立發布的 NVFP4 版本。
| Checkpoint | 檔案大小(約) | 最低 GPU 要求 | 適用情境 |
|---|---|---|---|
| BF16 | 65.8 GB | 1x H100/A100 80GB | 微調、研究、建立量化版本 |
| NVFP4 | ~16 GB | RTX 5090、DGX Spark、Jetson(Blackwell/Hopper/Ampere) | 正式推論、Agent 部署 |
| GGUF Q4 | ~25 GB | 16 GB+ VRAM(社群製作) | llama.cpp、Ollama、LM Studio |
NVIDIA 為 Day-0 支援與四個本機推論專案展開合作:vLLM、SGLang、Ollama 與 llama.cpp;同時也提到 LM Studio 與 Unsloth。模型支援三種 speculative decoding 策略:
- DSpark - 建議用於 DGX Spark 與低並發資料中心推論
- DFlash - 另一種 draft model 選項,效果取決於工作負載
- MTP(Multi-Token Prediction) - 內建於模型,最適合中高並發情境
如果沒有本機硬體,Lightning 可透過build.nvidia.com 以 NIM microservice 方式使用,也已上架 OpenRouter。NVFP4 checkpoint 可運行於 GeForce RTX 5090、DGX Spark、OEM GB10 系統與 NVIDIA Jetson。
Agent 路由策略:Lightning 最有價值的使用位置
NVIDIA 的開源路由函式庫 NeMo Switchyard,會根據準確率、速度與成本,將 Agent 工作流程中的每個步驟分配給最合適的模型。需要規劃的任務會送往前沿推理模型,執行型工作則下放給 Lightning。NVIDIA 的內部測試聲稱,Switchyard 在維持「前沿級」任務完成表現的同時,成本可降至僅使用 Opus 4.8 的約 三分之一。分派給 Lightning 的工作包括 git pull、驗證工具輸出、格式化結果與例行 API 呼叫。
這不是只有概念驗證。CodeRabbit 曾在 Reddit 發布實際案例:他們針對程式碼審查路由,透過目標式 SFT 搭配 RLVR(reinforcement learning with verifiable rewards)後訓練 Nemotron 3.5 Lightning;在固定的 1,000 項任務評估中超越既有 baseline,而訓練成本低於 $100。NVIDIA 為這類流程提供 NeMo Automodel 與 NeMo Megatron Bridge(LoRA/SFT)、NeMo RL 與 NeMo Gym(強化學習),以及名為 Nemotron-RL Agentic Terminal Pivot 的開放資料集。
對於正在建置 Agent pipeline 的團隊,真正該問的是:能否把 Lightning 微調成足以處理大部分 Agent 步驟的模型,以每個 token 僅 3B 啟用參數的成本運行,只有少數真正需要的步驟才交給前沿模型?
Nemotron 3.5 Lightning 值得用嗎?
| 使用情境 | 建議 | 原因 |
|---|---|---|
| 高量 Agent 路由(工具呼叫、驗證、格式化) | Lightning NVFP4 | 3B 啟用參數、4 倍 token 速度、相近準確率下約少 30% 運算量 |
| 一般程式設計輔助 | Qwen 3.6 35B-A3B | SWE-bench Verified 為 70.12 對 51.56,差距 19 分 |
| 複雜推理/規劃 | Nemotron 3 Ultra 或前沿模型 | Lightning 的定位明確不是規劃模型 |
| 消費級硬體上的單 GPU 本機聊天 | RTX 5090 上使用 Lightning NVFP4 | 可以運行,但 GGUF 轉換仍不成熟;vLLM/SGLang 更可靠 |
| 針對狹窄 Agent 任務微調 | Lightning BF16 | 3B 啟用參數代表更低微調成本;OpenMDW v1.1 允許商業使用 |
| 大規模指令遵循 | Lightning | IFBench 為 71.88,Qwen 為 63.71,領先 8 分 |
Lightning 用高量執行場景下的極限準確率,交換速度優勢。每次 session 若有數百個 Agent 步驟,30% 的運算節省會持續累積;但此模型於 2026 年 8 月 11 日推出,生態系仍在發展中。Mamba-2 混合架構意味著 GGUF 工具可能尚未完整支援。在 NVIDIA 硬體上搭配 vLLM 或 SGLang,NVFP4 checkpoint 是目前最穩妥的部署路徑;若使用 Apple Silicon 或僅限 GGUF 的環境,建議等待社群轉換版本更穩定。
常見問題
Nemotron 3.5 Lightning 能在消費級硬體上運行嗎?
NVIDIA 僅支援在消費級硬體上使用 NVFP4 checkpoint。BF16 權重需要 80GB GPU,也就是 H100 或 A100。NVFP4 可運行於 GeForce RTX 5090、DGX Spark 與 NVIDIA Jetson。社群已有適用於 llama.cpp 和 Ollama、可在 16 GB+ VRAM 系統執行的 GGUF Q4 轉換版本,但早期版本曾回報與 Mamba-2 混合架構相關的 unused-tensor 問題。
Nemotron 3.5 Lightning 與 Qwen 3.6 35B 相比如何?
在已公開的 12 項基準測試中,Qwen 3.6 35B-A3B 有 11 項優於 Lightning,當中 SWE-bench Verified 與 Terminal-Bench 的差距尤其明顯。Lightning 在 IFBench 指令遵循測試取勝,且在 Agent 工作負載上以相近準確率達成約 30% 更快的任務完成速度。Qwen 是更強的通用模型;Lightning 則是更快的 Agent 執行模型。
Nemotron 3.5 Lightning 適合寫程式嗎?
若看純程式能力跑分,答案是否定的:SWE-bench Verified 為 51.56,Qwen 3.6 則是 70.12。不過,CodeRabbit 成功以低於 $100 的成本微調 Lightning,用於程式碼審查路由,並超越其 baseline。此模型的設計重點在於可客製化:針對你的程式碼庫慣例進行微調後,它能以每個 token 3B 啟用參數的成本處理例行程式工作。
Nemotron 3.5 Lightning 採用什麼授權?
模型以 OpenMDW v1.1(Open Model Data Weight)發布,NVIDIA 將其形容為「在可能範圍內盡量採取寬鬆授權」。授權允許商業使用,涵蓋權重、訓練資料與配方。完整授權條款請見 HuggingFace model card。