 AIREITER
GLM-5.2 的各種存取路徑,看起來都能吃下 OpenAI 格式的請求;但進到後端後,實際行為幾乎沒有哪兩條路徑完全一樣。自 6 月 16 日推出以來,GLM-5.2 API 對重視成本的程式開發與 Agent 工作流確實很有吸引力,但前提是你得自行包好三類故障:工具呼叫語意、重試風暴,以及快取計費。每百萬 token $1.40/$4.40 的牌價並不假,但一項任務真正跑完會花多少錢,往往是另一個數字;本篇要看的正是這個落差。
OpenAI 相容到底相容到哪裡?
官方 GLM-5.2 文件明確支援 OpenAI Python SDK:將 base URL 設為 https://api.z.ai/api/paas/v4/,模型填入 glm-5.2,基本聊天整合確實只要改三行。不過,這份相容性主要停留在請求格式,並不保證回應語意、OpenAI 選用控制欄位,或新版 Responses API 的介面都能對應。
| 文件列出的規格 | 內容 |
|---|---|
| 模態 | 文字輸入、文字輸出(不支援視覺) |
| 上下文視窗 | 1M tokens |
| 最大輸出 | 128K tokens |
| 文件列出的能力 | 思考模式、串流、函式呼叫、上下文快取、結構化輸出、MCP |
| 計量計費端點 | https://api.z.ai/api/paas/v4/ |
| Coding Plan 端點 | https://api.z.ai/api/coding/paas/v4 |
| Anthropic 相容端點 | https://api.z.ai/api/anthropic |
| 官方 SDK | zai-sdk(Python)、Java、OpenAI SDK |
第一道界線是:Z.ai 根本沒有 Responses API。正如 u/quinncom 所說:「Codex 只支援 Responses API 格式,而 Z.ai 沒有提供。」因此有人得透過 ZenMux 當轉譯層。第二道界線則在 Claude Code:雖可經由 Anthropic 相容端點運作,但 @armor_rust 的設定筆記指出兩個陷阱:要用 AUTH_TOKEN,而不是 API_KEY;後者會觸發信任確認,一旦拒絕,可能永久無法再通過。此外,訂閱制與隨用隨付的 base URL 也不一樣。完整設定步驟請見我們的 Claude Code 設定指南。
一位開發者的總結很到位:「API 相容性只到請求格式為止;工具呼叫仍必須做供應商專屬評估。」——@sebuzdugan
工具呼叫:短測能過,長迴圈可能失控
在短小、受控的工具迴圈裡,GLM-5.2 API 的回應符合文件承諾;但一旦進入長時間運行的 Agent 迴圈,重度使用者回報會出現損壞的呼叫序列,不斷打轉,直到你的客戶端上限機制把它攔下來。這兩種觀察都成立,差別完全取決於你準備建的是哪一類迴圈。
依照 Z.ai 文件與 GLM52.ai 的 27 請求 Docker 測試套件:最多可定義 128 個函式,函式名稱最多 64 個字元,並須符合 ^[a-zA-Z0-9_-]+$;參數採 JSON Schema;模型會以 JSON 字串回傳 arguments,應用程式必須自行驗證;文件中也只列出 tool_choice: "auto"。該測試在 Coding Plan 路徑上 27/27 通過:4/4 工具與參數完全吻合、3/3 正確拒絕不該呼叫工具的情況、4/4 在兩個頂層呼叫中正確處理兩筆訂單,中位延遲為 5.3 秒。
真正的坑在於 OpenAI 使用者習以為常、但 GLM-5.2 不一定支援的控制欄位。GLM52.ai 發送相互衝突的測試後,端點回傳 HTTP 200,卻直接忽略了控制指令:
| 送出的 OpenAI 風格控制項 | 觀察到的行為 |
|---|---|
tool_choice: "required" + 「不要使用任何工具」 | 停止,零次呼叫 |
| 強制指定函式物件 + 「永遠不要使用這個工具」 | 停止,零次呼叫 |
parallel_tool_calls: false + 兩筆訂單提示 | 仍然回傳兩次呼叫 |
strict: true | 曾被接受一次;沒有證據顯示會強制套用 schema |
HTTP 接受請求,不等於行為契約成立;而長迴圈正是這些接縫最容易裂開的地方。
一名累計跑了約 40 億 tokens 的開發者直言:「GLM 5.2 跑到 40 億 token 後,最大問題是不支援視覺、工具呼叫混亂,以及工具呼叫損壞致死(它就是會一路螺旋失控)。」——@RasputinKaiser。另外還有一則未獲回覆的個案,提到模型把第二次工具呼叫編進第一次呼叫的 arguments 裡。雖然只有單一案例,卻正是客戶端迴圈防護應處理的失敗類型。
實務上有效的防守方式,是別讓模型負責協調流程。一位開發者使用 NVIDIA NIM 並設定 tool_call: false,把完整迴圈交由 Agent framework 控制;其受限參考迴圈將模型步數上限設為四步、每回合最多四次呼叫,並在執行前驗證每一份 argument JSON。
串流與延遲:官方不太會主動告訴你的數字
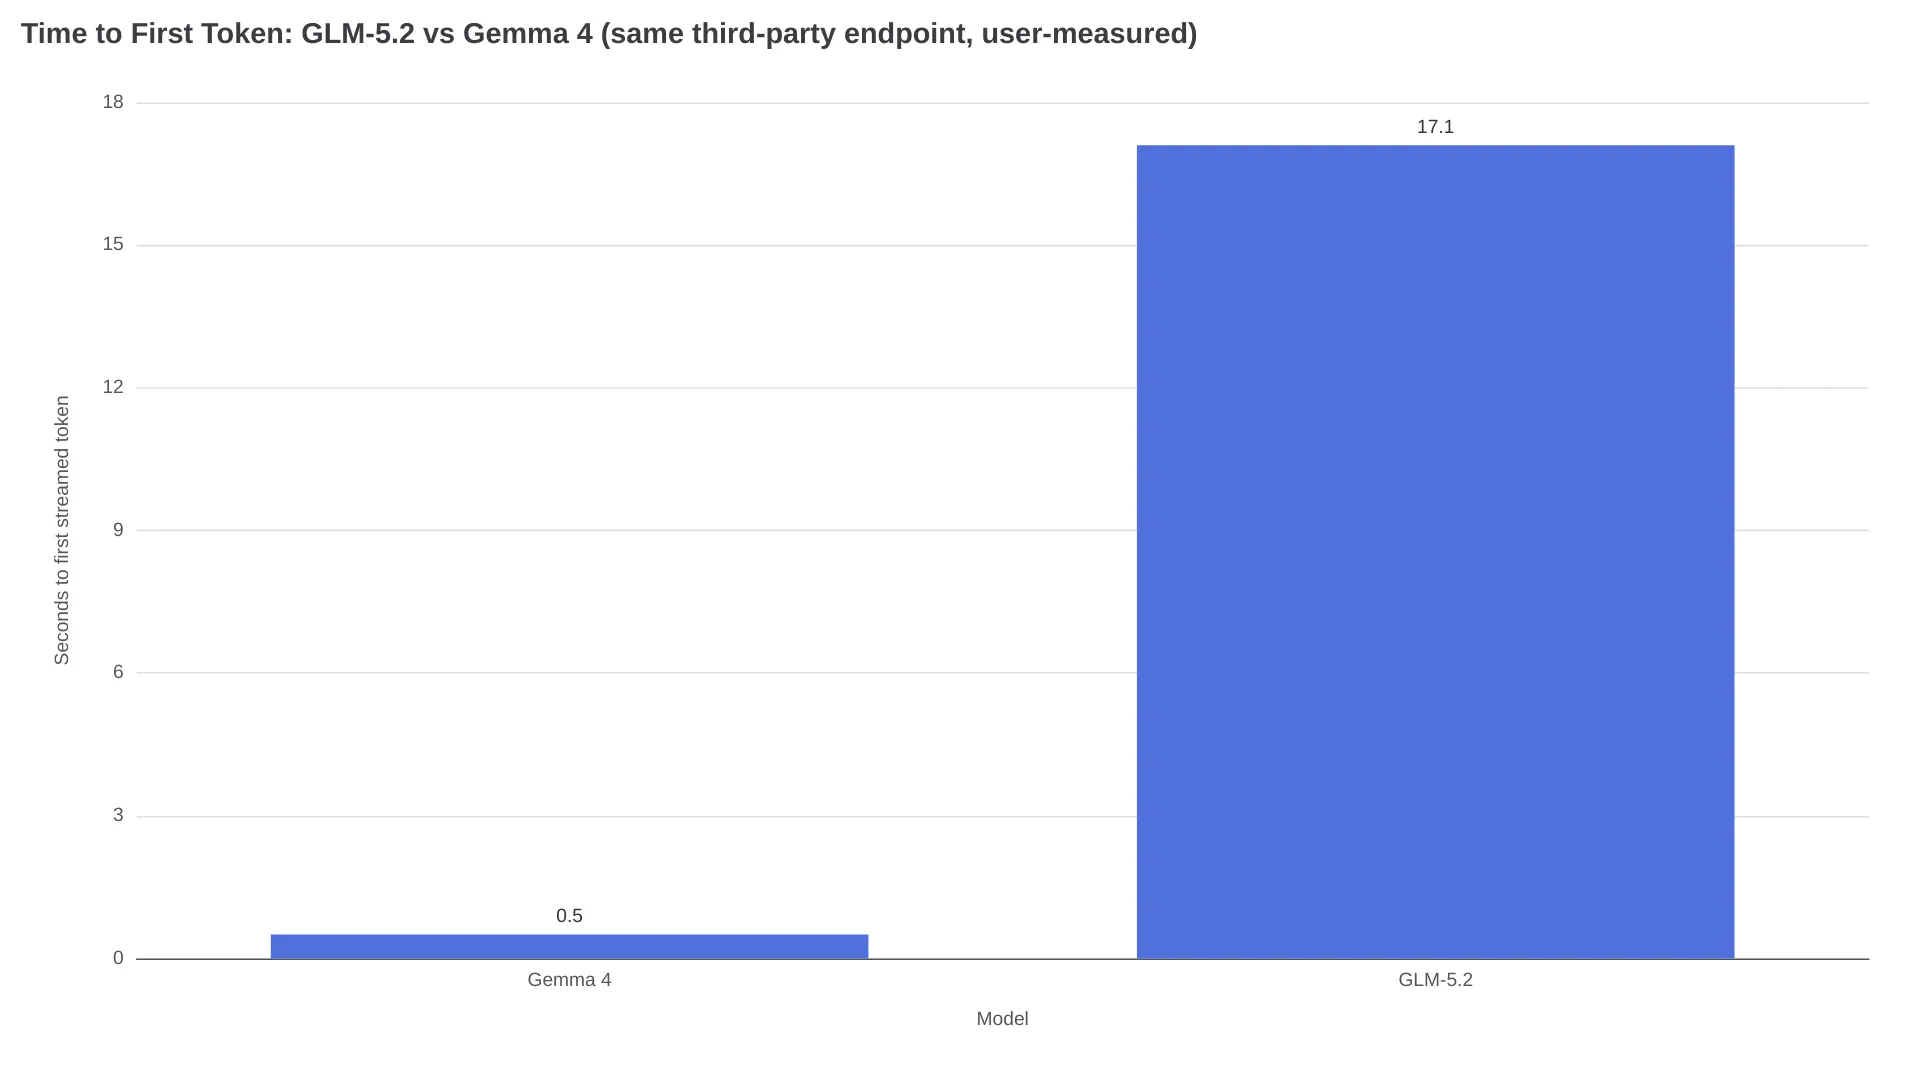
首 token 延遲是這套 API 最弱的一項實測指標。在 Sarvam 上進行的同端點對照測試中,GLM-5.2 的串流速度為每秒 148 tokens,Gemma 4 則為 260;首 token 時間則是 17.1 秒對 0.5 秒。換句話說,後者「快 33 倍開始生成」——@noctus91。
標榜的吞吐量也有同樣問題:
「所有 GLM 5.2 供應商都宣稱 200+ tok/s,但實際一用只有 50 tok/s。」——@tomgreenwald,他把這種現象稱為「供應商版 benchmaxxing」。
訂閱路徑還有兩種常見故障樣態:串流在中途死掉——一位 GLM Pro Coding Plan 使用者遇到「串流就這樣……停了」,最後徹底放棄;另一種則是規模一大就降速,「當上下文到 300k+ 時模型會變慢」——@mosh_Ontong。對照之下,DataLLM Lab 在自家 gateway 執行的九任務基準測試,平均每個完成任務為 12.3 秒。你的延遲故事多半由端點決定,不是模型本身。
限流與 429:重試不是例外,而是日常
Z.ai 的模型文件沒有公開 rate limit 表格,因此開發者只能透過 429 自己摸索。在 Coding Plan 路徑上,社群的共識是重試屬於正常操作,而不是例外處理。以下討論不能代表發生比例,但反覆出現的故障型態相當一致。
摘自 r/ZaiGLM 的限流討論串:
- 「現在 Coding Max Plan 幾乎每隔一個請求就碰到 429/529。沒有開併發……」——u/A-B-user
- 「對,幾乎每個請求都得重試,但結果非常好。」——u/hyeluoh
- 「glm52 如果只用單一併發就沒問題(超慢但沒有錯誤)。」——u/evia89
錯誤情況也與客戶端有關:同一把 API key 在 ZCode 可用,卻在 OpenClaw 丟出 429;另一位使用者將其解讀為「太忙」訊息。訂閱層還會讓問題更複雜:中國使用者回報 Coding Plan 會自動把 5.2 工作負載切換到 GLM-5.3,導致額度消耗更快;也有人指出第三方 Coding Plan 轉售商在少數幾次呼叫後就開始限流。
經得起實務驗證的工程做法包括:採用帶 jitter 的指數退避、所有會寫入的操作都使用 idempotency key、以任務而非單次請求為單位設定重試預算,以及準備可自動切換的 concurrency=1 降級模式。我們的 OpenRouter 429 排除指南裡的重試策略,原封不動就能套用在這裡。
Z.ai 尚未正面回應的快取計費問題
文件有列出上下文快取功能;我們在 7 月 13 日查看供應商頁面時,快取輸入價格約為每百萬 tokens $0.26,相較於新輸入的 $1.40。然而,在我們檢視的社群討論中,互動最高的一項 API 抱怨仍未釐清:某些路徑似乎把重複上下文當成新輸入計費。對於每輪都重送長 system prompt 的 Agent 迴圈,成本會因此成倍放大。
「GLM 5.2 的 cached tokens 沒有正常運作。重複上下文被算成一般輸入,而不是快取 token。」——@Da7_Tech,並稱這是「嚴重的計費/快取帳務問題」。
同一討論串中,一項 Claude Opus 4.8 在不到 1.5M tokens 內完成的任務,GLM-5.2 用了 53M tokens 仍未完成,五小時額度已到 100%;但應用程式本身的計數器只顯示約 1.67M。
兩個月後,同一名開發者仍總結道:「大量使用者抱怨 cache hit 看似會計入用量。若你也遇到,這個方案的價值就崩了。」截至 8 月下旬,這些討論串中都沒有出現官方回應。
在確認問題已修復前,請把快取輸入價格視為需要自行驗證的最佳情境:每次回應都記錄 usage 物件中的 cached_tokens,並每週與帳單核對。
Reasoning effort:同一個旋鈕,三種名稱
官方介面使用 thinking.type(enabled/disabled),以及可選 high、max 的 reasoning_effort;官方範例本身就使用 reasoning_effort: "max"。Z.ai 的發布指引表示,max 會優先推高能力,high 則平衡效能與 token 效率;程式碼任務建議使用 max。
這裡有兩個整合重點。第一,Coding 路徑預設就是 max:「預設為 max,所以除非想調低,否則不需要特別設定。」——r/ZaiGLM。推理 tokens 按輸出價格計費,這個預設會悄悄放大支出;而在 Coding Plans 上,記錄方案計費方式的使用者指出,max effort 呼叫在北京時間平日 14:00–18:00 期間會消耗3 倍額度,並且疊加五小時視窗和每週額度機制。
第二,這個旋鈕經常根本沒有送到後端。OpenCode 使用者表示,自訂供應商「目前不允許調整 reasoning effort」;有些客戶端又用第三種名稱 xhigh 呈現同一設定,而它們可能完全不會轉送該欄位——r/opencodeCLI。輸出冗長程度也會跟著這個設定走;一位每日做比較的開發者便提到,競爭模型「沒有 Opus-4.8 或 GLM-5.2 那麼冗長」。
同樣是 glm-5.2,不同端點可能像不同模型
glm-5.2 是同一個模型字串,卻可能指向實質不同的部署。8 月初端點準確率結果流傳時,Z.ai 的負責人請社群「也測試官方 GLM-5.2 API,作為額外參考點;它的分數可能超過 100%。」——@ZixuanLi_。他點名的是官方 API,而不是該報告測試的第三方端點。
實務上的漂移可能表現為:輸出 token 上限設得太低,讓推理在串流中途截斷;發布初期的吞吐量逐漸消退,也就是前文提到的「benchmaxxing」模式;或不同主機有不同上下文上限。舉例來說,Together AI 提供的 GLM-5.2 上限是 256K,官方 API 則依文件提供 1M,我們 7 月比較中的聚合平台也提供完整視窗。
價格差距比行為差異更大:相較於 Z.ai 的 $1.40/$4.40 牌價,我們 7 月供應商比較中 OpenRouter 列出 $0.42/$1.32;快取輸入價格則介於 Fireworks 的 $0.14 與 $0.26。請依工作負載挑選端點,再針對該精確端點重新測試;在一條路徑上通過的行為測試,不能直接推論到另一條路徑。
上線前先花 30 分鐘跑完這套測試
前面每一類故障,都能在正式導入工作負載前的半小時內發現。請針對你預計上線的確切端點、模型字串與 SDK,執行以下測試:
- 以衝突條件驗證工具契約。 同時送出
tool_choice: "required"和「不要使用工具」的指令;再以雙訂單提示搭配parallel_tool_calls: false。預期兩者都會被忽略;若你的協調邏輯依賴其中任何一項,請在這裡停止。 - 重試壓力測試。 以預定併發量發送 50 個請求,記錄 429/529 比率及重試成功率。若重試超過請求的大約三分之一——這是一條保守的營運門檻——請把併發降至 1 後重新測量。
- 檢查快取帳務。 將完全相同的 10K-token 前綴重送五次,累計 usage 回應中的
cached_tokens,再與儀表板計入輸入的費用核對。此處若不一致,你的成本模型就不成立。 - 以真實上下文長度測延遲。 在具代表性的上下文大小下,測量首 token 時間與串流中途卡頓,而不是只做 1K-token smoke test;否則你看不見 >300K 時的降速問題。
- 決定使用路徑。 Coding Plan 是為互動式程式開發工具打造;方案計費說明指出,它不授權用於網站、機器人或 SaaS 流量。因此產品後端應使用計量計費 API。
這項取捨沒有簡單答案:GLM-5.2 提供市場上一些最便宜、但仍具能力的程式開發 tokens;你付出的代價,是得自己承擔 wrapper 工程,而 Frontier API 通常把這些成本折進每 token 單價裡。
GLM-5.2 API 常見問題
GLM-5.2 可以搭配 OpenAI SDK 使用嗎?
可以,限於 chat completions:將 base_url 指向 https://api.z.ai/api/paas/v4/,模型使用 glm-5.2。不過 Z.ai 沒有 Responses API,因此 OpenAI 的新版介面與 Codex 都需要轉譯層。
GLM-5.2 API 支援串流、函式呼叫與結構化輸出嗎?
三者都列在文件支援能力中,另也支援上下文快取與 MCP。但要留意實際行為:串流穩定性會因端點而異,OpenAI 的工具控制欄位——除了 auto 以外的 tool_choice、parallel_tool_calls、strict——不會被遵守。
該用哪個模型字串與 base URL?
官方計量計費路徑使用 glm-5.2,base URL 為 https://api.z.ai/api/paas/v4/。Coding Plan 使用不同的 base URL,而 OpenRouter 上的模型名稱是 z-ai/glm-5.2。
為什麼 GLM-5.2 很慢,或輸出異常冗長?
Coding 路徑預設採用 max reasoning effort,而它會按輸出 tokens 計費。社群回報的持續吞吐量接近 50 tok/s,遠低於宣傳的 200+。在你先確認設定與端點前,延遲和冗長度通常不該先歸咎於模型本身的限制。
GLM Coding Plan 能供應我應用程式的 API 嗎?
不能。方案計費說明指出,該訂閱方案是提供互動式程式開發工具使用,排除網站、機器人與 SaaS 產品的服務用途。北京尖峰時段的額度倍率,也使它不適合穩定持續的流量。
每家供應商都提供 1M 上下文視窗嗎?
不是。官方 API 與多數聚合平台提供 1M,但 Together AI 將 GLM-5.2 限制為 256K;這已足以改變 repo 級工作流的架構設計。
延伸閱讀
- GLM-5.2 評測:熱潮兩個月後——模型品質、基準測試與適合的使用者
- GLM 5.2 API:最低成本存取、價格與免費金鑰——完整供應商價格矩陣
- GLM-5.2 vs GLM-5.3——8 月的後繼版本是否改變選擇