 AIREITER
GLM-5.2 在 Arena 的Code Arena 前端排行榜拿下第 2 名(1,595 Elo),在 FrontierSWE 上也只差 Claude Opus 4.8 一分,但仍有不少人正設法離開它。問題通常不是能力,而是使用體驗:自 2026 年 6 月推出後,開發者討論串反覆提到三個痛點——Coding Plan 額度常在任務做到一半時耗盡、尖峰時段容易出錯,以及長時間 Agent 循環會大量消耗 Token,讓 $1.40/$4.40 的表面價格看起來比實際便宜。至於哪個 GLM-5.2 替代方案最適合你,完全取決於你剛撞上的究竟是哪面牆。
快速結論:不同需求該換哪個 GLM-5.2 替代方案
先給結論,細節與依據放在後面:
- 額度消耗/每次 Agent 循環成本:DeepSeek V4 Flash,輸入 $0.14/M、輸出 $0.28/M,1M 上下文。
- Agent 循環不穩:Kimi K2.7 Code,輸入 $0.95/M、輸出 $4.00/M。
- 最困難任務的能力上限:Claude Opus 4.8,SWE-Marathon 分數是 GLM-5.2 的兩倍,但採用封閉模型價格。
- 自架部署或資料控管:Qwen3-Coder(Apache 2.0);如果你有 372–475 GB RAM,也可以直接使用 GLM-5.2 自己的 MIT 權重,跑 4-bit 版本。
- 模型本身沒問題,只是想換新:GLM-5.3,價格維持 $1.40/$4.40,Z.ai 已在發表當天確認。
GLM-5.2 的強項,以及實際運行成本
Z.ai 官方文件將 GLM-5.2 列為純文字旗艦模型,提供 1M Token 上下文、最高 128K 輸出,以及輸入 $1.40/M、輸出 $4.40/M、快取輸入 $0.26/M 的 API 價格。模型權重採 MIT 授權,於 2026 年 6 月 16 日發布;在 6 月 13 日推出時,最初只能透過 GLM Coding Plan 使用。模型卡上的成績包括:Terminal-Bench 2.1 為 81.0(Opus 4.8:85.0)、SWE-bench Pro 為 62.1(Opus 4.8:69.2),FrontierSWE 則是 74.4 對 75.1。
這些成績已經貼近閉源模型的頂尖水準,價格卻仍是開放權重模型的等級。真正讓使用者感到吃力的,是服務層面的成本與穩定性。GLM-5.2 上線前後,Coding Plan Pro 方案月費從低於 $35 調高到 $65,@bridgemindai 在調價當天就記錄了這次變化。不過,比起月費,大家對方案額度的抱怨更集中:
「GLM 5.2 會讓你的每週速率限制在一天內就用完。」——u/intl_spy,r/opencode
「我喜歡 GLM-5.2,但天啊,它真的超會吃 Token。」——@atomtanstudio
一名用 GLM-5.2 執行自我演化 Agent、並將它投入實際工作的開發者表示,自己單一週末就花了超過 $500;他也指出,中途切換模型會丟失 KV 快取,導致同一段上下文必須重新付費(@Xianbao_QIAN)。另一名使用者則直接說出了整個性價比問題的上限:
「GLM 5.2 很棒,但我的 $200/月 Codex 訂閱,能帶來的使用量還是比 $200 的 GLM 5.2 API 額度多。它是很好的輔助模型……但絕對稱不上替代品。」——@mweinbach
尖峰時段的容量問題也不能忽略。自 GLM-4.5 時期就訂閱方案的@gengdaJ形容,晚間伺服器會「直接爆掉」,最後只能退回較舊的模型。這就是為什麼搜尋「GLM-5.2 替代方案」的人,很多其實並不討厭這個模型。
替代方案價格比較:依你遇到的症狀挑模型
以下價格全部取自各供應商官方定價頁面,資料擷取於 2026 年 8 月。Kimi K3 與 MiniMax M3 的價格是未命中快取時的輸入價格;命中快取的價格會低得多。
| 模型 | 上下文 | 權重/授權 | API 價格($/1M,輸入/輸出) | 適合在這種情況換機 |
|---|---|---|---|---|
| GLM-5.2(基準) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | 開放(依 Layer3 Labs 資料為 MIT) | $0.435 / $0.87 | 想在相同上下文長度下,以更低成本處理高難度推理 |
| DeepSeek V4 Flash | 1M | 開放 | $0.14 / $0.28 | 主要問題就是額度消耗太快 |
| Kimi K2.7 Code | 256K | 開放(Modified MIT) | $0.95 / $4.00 | Agent 循環穩定性比上下文長度更重要 |
| Kimi K3 | 1M | 封閉 | $3.00 / $15.00 | 既要 Kimi 的穩定性,也不能放棄 1M 上下文 |
| MiniMax M3 | 1M | 封閉 | $0.30 / $1.20* | 多模態輸入,或大量且對價格敏感的工作 |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | 權重免費;託管價格依服務而異 | 目標是自架部署或微調 |
| Grok 4.6 | 500K | 封閉 | $2.00 / $6.00 | 重視速度,且只需要大但仍容易管理的上下文 |
除了這七款模型,下面還會介紹兩條升級路線:適合總是在最困難任務上失敗的團隊的 Claude Opus 4.8,以及同家族、同價格升級的 GLM-5.3。
\* MiniMax M3 的這個級距適用於輸入 ≤512K Token;超過該門檻後,價格會加倍。根據 Z.ai 的發布公告,GLM-5.3 與 GLM-5.2 價格完全相同,因此不納入成本比較。
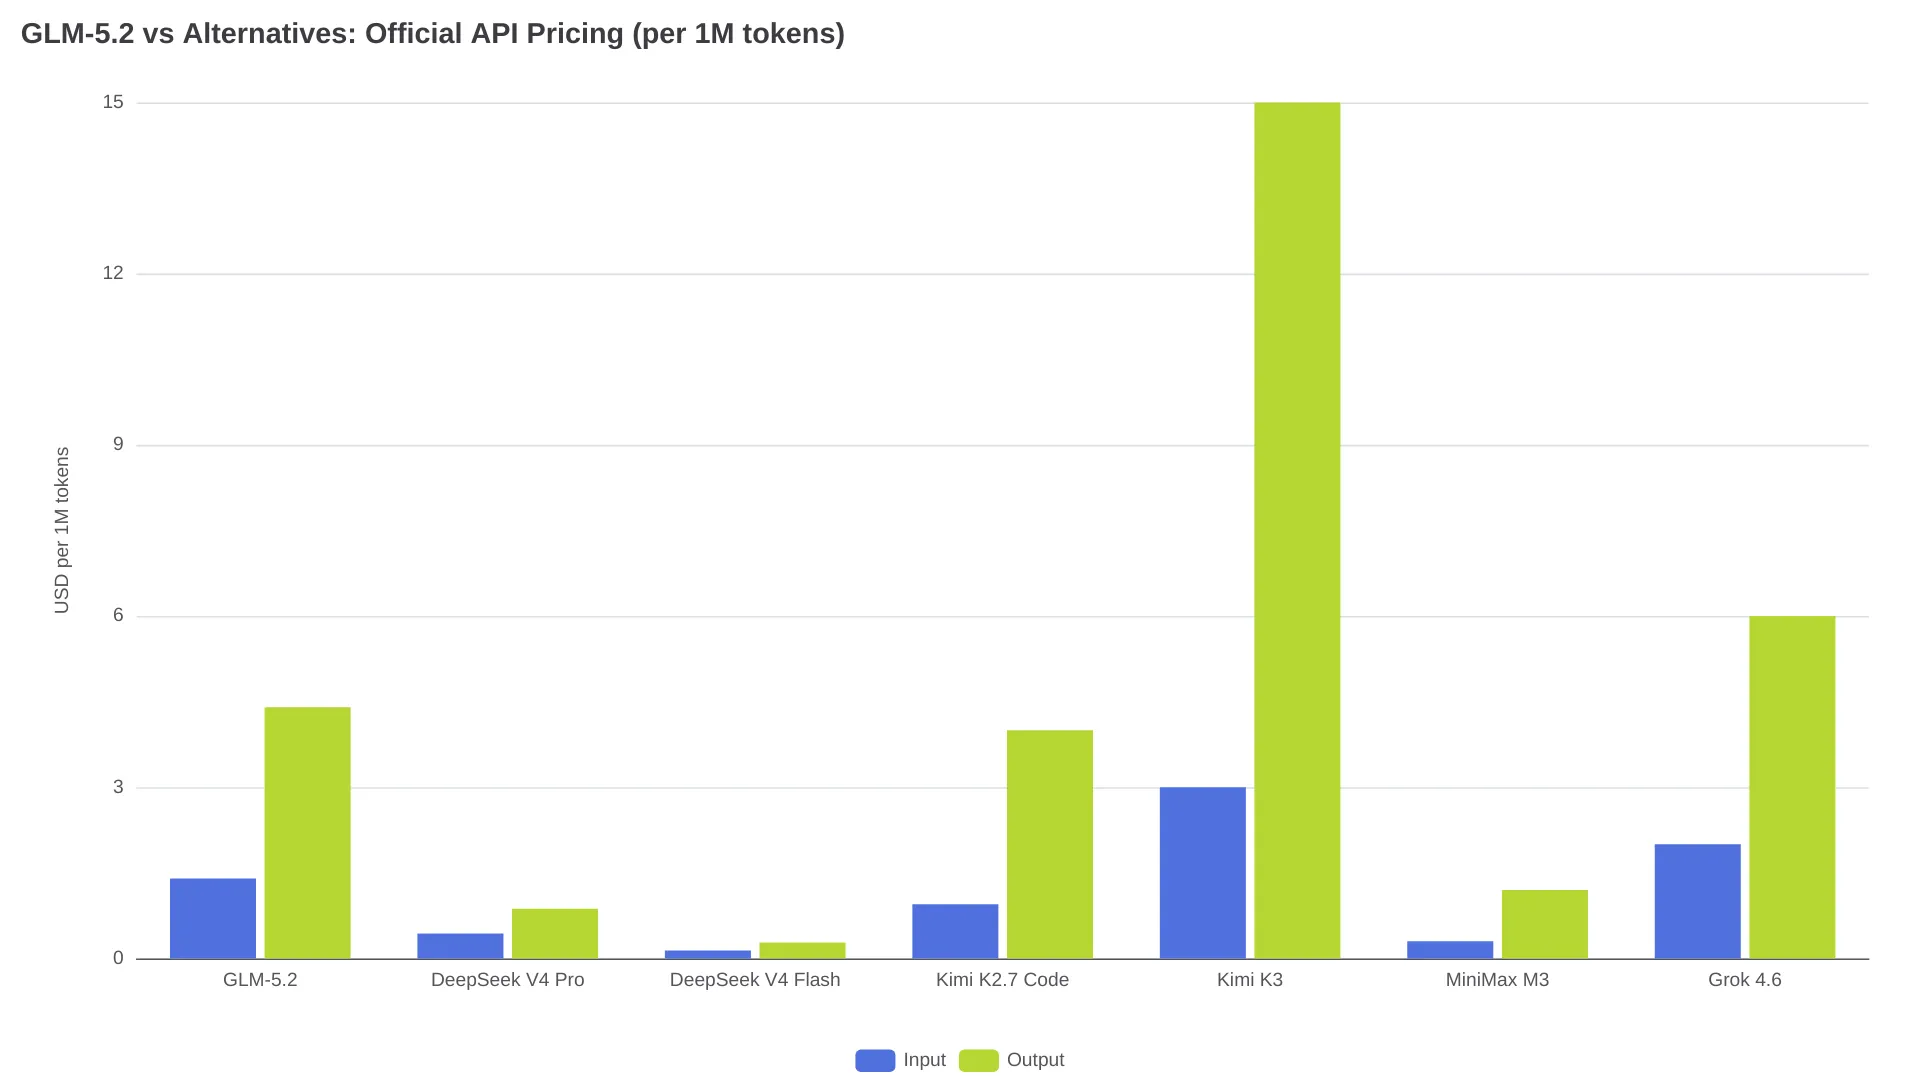
按症狀挑模型:你該換去哪裡
額度燒太快:把 Agent 循環交給 DeepSeek V4 Flash
直接算價格就很清楚了。未命中快取時,GLM-5.2 的輸入價格 $1.40/M 是 DeepSeek V4 Flash $0.14/M 的 10 倍;輸出則是 $4.40 對 $0.28,差距達 15.7 倍。對 Agent 循環中的實作階段——修改檔案、修正測試、產生樣板程式碼——這個差距會隨每一輪操作累積。DeepSeek 同樣提供 1M Token 上下文,最高輸出 384K。若要處理更難的推理工作,V4 Pro 的價格是 $0.435/$0.87,在維持大幅折扣的同時,定位也更偏向高難度任務;我們的GLM-5.2 與 DeepSeek V4 Pro 比較整理了兩者各自的優勢,而V4 Flash 對決文章則聚焦於預算型方案。
OpenCode Go 訂閱者最後普遍採用的不是整套切換,而是分工:用 GLM-5.2 做規劃與審查,再交給便宜的模型處理大量執行工作。u/narkeeso寫道:「我只用 OpenCode Go 的 GLM 5.2 做規劃」;同一個生態系的 u/Endoky 則說,自己「只在需要升級處理或做規劃時使用 GLM 5.2」。
Agent 循環不穩:改用 Kimi K2.7 Code
如果問題出在服務而不是模型能力,我們檢視的討論串中,最常被點名的替代方案就是 Kimi。一名使用者原本以中文發表的總結如下:
「模型能力大概差不多,但無法穩定提供服務,才是我選 Kimi 而不是 GLM 的原因。」——@wonjder
Kimi K2.7 Code 是針對程式開發的專門選擇:輸入 $0.95/M、輸出 $4.00/M(命中快取時為 $0.19/M),上下文為 262,144 Token。它只有 GLM-5.2 四分之一的上下文長度,這正是換機時最需要接受的取捨。它支援文字、圖片與影片輸入,也補上了 GLM-5.2 純文字模型缺少的多模態能力。如果 256K 放不下你的程式庫,Kimi K3 可用 $3.00/$15.00 的價格提供 1M 上下文。但要注意,K3 的 $15 輸出價格是 GLM-5.2 的 3.4 倍,因此它買的是穩定性,不是省錢。Kimi K2.7 Code 與 GLM-5.2 比較則提供了基準測試細節。
想要更高的困難任務上限:Claude Opus 4.8
在 SWE-Marathon(編譯器建置、核心工作、多小時自主執行任務)中,Opus 4.8 得分 26.0,GLM-5.2 則是 13.0;在 NL2Repo 中,兩者分別為 69.7 與 48.9,資料來自 Z.ai 的模型卡。同一份模型卡也指出,GLM-5.2 仍是兩個排行榜中排名最高的開放模型,但任務越長,差距就越明顯。Opus 是閉源模型,不能自行架設,價格也更高;GLM-5.2 與 Opus 比較會進一步說明什麼情況值得支付這筆溢價。
自架部署或資料控管:Qwen3-Coder,或直接使用 GLM 自家權重
Qwen3-Coder 與 Qwen3.8 Max 採用 Apache 2.0 授權,提供 1M Token 上下文,也有適合單張 GPU 伺服的精簡版本;Layer3 Labs與glm5.app都將它們列為自架部署首選。若需求是微調或私有部署,在這些替代方案中,它們是最實際的選擇;我們的Qwen 3.8 Max 開放權重介紹整理了這個模型家族。
比較出人意料的選項,是直接自架 GLM-5.2,畢竟 MIT 授權允許這麼做。但硬體門檻並不友善:BF16 權重需要 1.51 TB 空間,即使使用Unsloth 的 GGUF 版本進行 4-bit 量化,載入仍需要 372–475 GB 記憶體。實際上,4-bit 版本已經是多 GPU 伺服器等級,完整 BF16 則是叢集規模;本地工具支援也還很新,llama.cpp 直到 2026 年 7 月 24 日才加入 GLM-5.2 的 indexer 支援(PR #25407)。自架 GLM-5.2 是為了資料主權,不是為了方便;如果手上沒有叢集,Qwen 的精簡版本才是更接近工作站等級的選擇。
多模態與低成本吞吐量:MiniMax M3
MiniMax M3 提供 1M 上下文與多模態輸入,價格為輸入 $0.30/M、輸出 $1.20/M(≤512K 的級距;超過該門檻後兩項價格都會加倍,預算必須預留)。若從團隊預算來看,MiniMax 的Token 方案每月 $20/$50/$120,涵蓋公司旗下的 M3、M2.7、影像與語音產品線,額度以 5 小時滾動時段及每週時段計算。
速度優先:Grok 4.6
Grok 4.6 的價格為輸入 $2.00/M、輸出 $6.00/M,提供 500K 上下文。xAI 的 API 頁面宣稱具備業界領先的程式開發與工具呼叫能力,但沒有公開基準測試表,因此這類說法仍應視為產品定位,而非已驗證的結論。不過,使用者回饋確實提供了一些訊號:@bourneliu66認為,在他的「三大模型」中,Grok 已取代 GLM 的位置;依他的說法,Grok 更強、更快,也更便宜。在接受這個排序之前,還是應該用自己的工作負載驗證。
一切正常,只是想用最新 GLM:GLM-5.3
根據Z.ai 的公告,GLM-5.3 於 2026 年 8 月 18 日加入 API,價格與 GLM-5.2 相同。如果你搜尋替代方案的原因不是遇到實際痛點,而只是擔心錯過升級,GLM-5.2 與 GLM-5.3 比較整理了兩代真正的差異。
拆分模型堆疊:保留 GLM-5.2,但把它降級使用
前面提到的討論串中,反覆出現的落點並不是全面遷移,而是把 GLM-5.2 降級成規劃器與審查者,再交由便宜的模型執行。這符合 GLM-5.2 的定位:Z.ai 將它鎖定在長時間運作的工程 Agent 工作,但在預算型模型中,它的每 Token 成本也是最高。
這種拆分架構有兩個關鍵機制。第一是 KV 快取遺失:在執行中途切換模型,甚至切換到同一模型的另一家供應商,都會讓上下文重新計費。第二是供應商差異:r/opencodeCLI的使用者表示,Fireworks、NeuralWatt 與 OpenCode Go 提供同一模型時,速度可能有很大落差。
使用單一 OpenAI 相容端點,就能處理這套架構的營運面:兩個階段都沿用同一套GLM-5.2 API請求格式,供應商效能下降時可以重新路由,帳單也集中在一起。但這不代表上下文變免費;不同模型或不同供應商之間無法共用快取,這正是單一週末花掉 $500的成本來源。因此,應該在任務邊界切換,而不是執行到一半才切換。如果你是在 Claude Code 裡建立這種分工,我們的在 Claude Code 使用 GLM-5.2 指南涵蓋了相關設定。
30 秒決策表
| 你的症狀 | 建議選擇 | 需要放棄什麼 |
|---|---|---|
| 每週額度一天就用完 | DeepSeek V4 Flash | 相較 GLM,部分 Agent 程式開發的細節打磨 |
| Agent 循環因供應商錯誤中斷 | Kimi K2.7 Code | 1M 上下文(改為 256K) |
| 最困難的多小時任務失敗 | Claude Opus 4.8 | 開放權重、低價格與自架能力 |
| 需要把權重部署在自己的硬體上 | Qwen3-Coder | GLM 在前端程式開發上的 Elo 領先 |
| 一般工作太會吃 Token | MiniMax M3 | 輸入超過 512K 後,價格會加倍 |
| 受法規或採購限制 | 自架 Qwen 或 GLM 權重 | 託管服務的便利性 |
| 想要最新的 GLM | GLM-5.3 | 什麼都不用放棄;價格相同 |
常見問題
整體而言,最好的 GLM-5.2 替代方案是哪個?
DeepSeek V4 Pro 是最接近全方位替代品的選擇:1M 上下文、開放權重,每 Token 便宜 3–5 倍。如果你更在意長時間 Agent 執行的穩定性,而不是基準測試差距,Kimi K2.7 Code 會是更好的選擇。
DeepSeek 的程式開發能力比 GLM-5.2 好嗎?
在高難度演算法推理方面,glm5.app 的比較將 DeepSeek V4 Pro 排在前面;但在長程、多檔案的 Agent 工作上,GLM-5.2 的 1M 上下文,以及長程 Agent 訓練(Z.ai 所宣稱的專長)仍讓它保持優勢。實際使用可以簡單理解為:DeepSeek 負責執行,GLM 負責規劃。
最便宜的 GLM-5.2 替代方案是哪個?
DeepSeek V4 Flash:輸入 $0.14/M、輸出 $0.28/M,命中快取時輸入價格為 $0.0028/M,對重複使用的上下文來說幾乎等於免費。
哪些替代方案也提供 GLM-5.2 的 1M Token 上下文?
DeepSeek V4 Pro 與 V4 Flash、Kimi K3、MiniMax M3,以及 Qwen3.8 Max 都標示提供 1M Token 上下文。Kimi K2.7 Code(256K)與 Grok 4.6(500K)則沒有。
不換模型,能不能直接在本機執行 GLM-5.2?
技術上可以(MIT 權重已經公開),但 4-bit 版本需要 372–475 GB RAM,而 llama.cpp 到 2026 年 7 月 24 日才合併支援。對大多數團隊而言,託管 API 仍是唯一實際可行的路線。
GLM-5.2 替代方案的訂閱費每月多少?
MiniMax Token 方案每月 $20–$120。根據Digital Applied 的價格整理,Kimi 的 Code CLI 月費 $19 起,Z.ai Coding Plan 月費 $18 起;6 月調價後,Z.ai Pro 方案為 $65。